
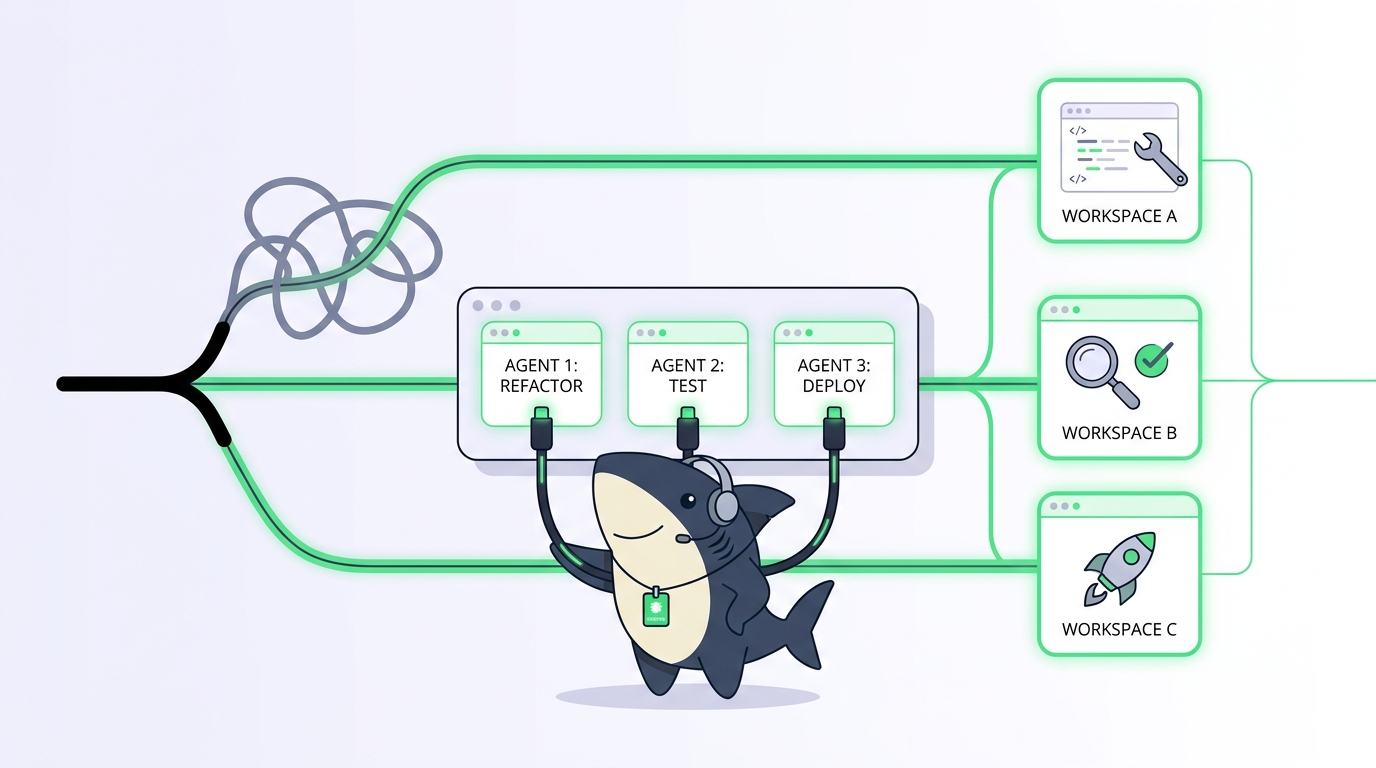
Aponte dois agentes de IA de programação para o mesmo checkout e eles vão acabar com a sua tarde. Um reescreve um arquivo que o outro está no meio da edição. Um troca a branch debaixo do outro. Ambos rodam npm install no mesmo node_modules e te deixam com um lockfile que ninguém escreveu. A falha é silenciosa até não ser mais, e aí você está fazendo bisect de uma bagunça que nenhum dos agentes consegue explicar.
Git worktrees são a solução padrão. Um worktree dá a cada agente seu próprio diretório de trabalho e sua própria branch em cima de um repositório compartilhado, então o trabalho em paralelo deixa de colidir. Este guia percorre os comandos reais, as pegadinhas que aparecem na prática e a disciplina de limpeza que ninguém comenta. Depois mostra onde scripts de worktree feitos à mão param de escalar, e como o Sharkly executa cada Task em seu próprio worktree automaticamente, para que os resultados voltem a um único registro compartilhado em vez de se espalharem por terminais.
Se você roda um único agente, ainda não precisa de nada disso. No momento em que roda dois, o isolamento deixa de ser opcional.
TL;DR
Um git worktree é um segundo diretório de trabalho vinculado ao mesmo repositório, com sua própria branch e seu próprio index. Dê a cada agente de IA de programação seu próprio worktree e eles podem editar, compilar e testar em paralelo sem sobrescrever uns aos outros nem brigar pela branch atual. Os comandos são simples; o custo operacional (instalações por worktree, limpeza, disco, coordenação) é o que cresce. O Sharkly gerencia esse custo preparando um worktree isolado para cada Task automaticamente e devolvendo cada resultado à Task para revisão.
Por que um único checkout não comporta dois agentes
Um checkout git normal tem exatamente um diretório de trabalho, um index e um HEAD. Isso funciona bem para uma pessoa fazendo uma coisa. Desmorona no instante em que dois agentes trabalham ao mesmo tempo, porque esses três elementos são estado compartilhado.
Imagine dois agentes no mesmo repositório. O Agente A está refatorando o módulo de autenticação em uma branch chamada auth-refactor. O Agente B recebe a tarefa de corrigir um bug de logging e roda git checkout -b fix-logging. Esse único comando move o HEAD de todo o checkout. As alterações não commitadas do Agente A agora estão em cima da branch errada, seu próximo commit cai no lugar errado e seu build começa a falhar por motivos que ele vai passar vinte minutos "depurando". Nada quebrou. O estado simplesmente saiu do trilho, sem alarde.
Fica pior com arquivos. Os dois agentes compartilham um diretório de trabalho, então quando o Agente B regenera um arquivo de configuração ou roda o formatador de novo, as edições abertas do Agente A são sobrescritas no disco. Agentes de programação não mantêm um modelo mental de "o outro está no meio de algo". Eles leem o arquivo, agem e gravam de volta. Dois escritores, um arquivo, nenhum lock. Você tem o clássico problema de lost update, só que os escritores são autônomos e rápidos.
É essa a dor pela qual a palavra-chave "git worktrees" continua aparecendo. As pessoas não pesquisam sobre worktrees porque branching é interessante. Elas pesquisam porque tentaram rodar agentes em paralelo e se deram mal. Se esse é o seu caso, o lado da execução paralela é abordado em profundidade no nosso guia sobre rodar vários agentes do Claude Code em paralelo; este artigo é a primitiva de isolamento por baixo disso.
O que um git worktree realmente é
Aqui vai a definição, a que vale memorizar:
Um git worktree é um diretório de trabalho adicional vinculado ao mesmo repositório, com sua própria branch, seu próprio index e seu próprio HEAD, compartilhando um único banco de objetos.
Essa última parte é o truque inteiro. Um worktree não é um clone. Clones duplicam todo o armazenamento de objetos: cada commit, cada blob, cada tag copiado para um segundo .git. Worktrees compartilham um único armazenamento de objetos e adicionam apenas um segundo diretório de trabalho leve. Seus commits ficam visíveis de todos os worktrees no momento em que são feitos, porque há apenas um histórico por baixo. O que difere em cada worktree é o checkout: qual branch está ativa, o que está em stage, o que está modificado no disco.
Para agentes, isso se encaixa perfeitamente no problema. Cada agente recebe um worktree. Cada worktree tem sua própria branch e seus próprios arquivos. Eles não podem sobrescrever uns aos outros porque estão literalmente em diretórios diferentes, e não podem arrancar a branch debaixo um do outro porque cada worktree fixa seu próprio HEAD. Os conflitos vão para onde pertencem: no momento do merge, de propósito, sob revisão, em vez de no meio da edição por acidente.
Os comandos de worktree que você realmente vai usar
Comece em um repositório normal. Todos os comandos abaixo são executados de dentro dele.
Criar um worktree com uma nova branch. Este é o que você vai usar mais:
git worktree add -b fix-logging ../myproject-fix-logging main
Isso cria um diretório em ../myproject-fix-logging, cria uma nova branch fix-logging a partir de main e faz o checkout dela ali. Aponte um agente para esse diretório e ele tem um lugar limpo e isolado para trabalhar.
Criar um worktree para uma branch existente:
git worktree add ../myproject-auth auth-refactor
Listar o que você tem aberto:
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
Uma linha por worktree, com seu caminho, o commit em checkout e a branch. Quando você está rodando uma frota de agentes, essa lista é sua fonte da verdade sobre quem está onde.
Remover um worktree quando o trabalho foi integrado ou abandonado:
git worktree remove ../myproject-fix-logging
Fazer prune dos metadados obsoletos depois de excluir um diretório de worktree manualmente (agentes e scripts fazem isso mais do que você gostaria):
git worktree prune
Essa é toda a superfície. Cinco comandos. A dificuldade não está nos comandos.
As pegadinhas que realmente machucam
Os comandos são simples. A realidade operacional é onde as tardes se perdem. Estes são os modos de falha que aparecem quando agentes de verdade rodam em worktrees de verdade.
Arquivos não rastreados e ignorados pelo git não vêm junto. Um worktree faz checkout dos arquivos rastreados na branch que você pediu. Ele não copia seu node_modules, seu .env, seu venv, seu cache de build nem qualquer outra coisa que o git ignora. Então um worktree novo de um projeto Node não é executável até você rodar a instalação nele. Cada worktree paga pela sua própria instalação de dependências, seu próprio arquivo de ambiente, seu próprio build. Agentes que presumem que "o repositório está configurado" vão falhar no primeiro comando em um worktree novo até você tratar a configuração explicitamente.
Você não pode fazer checkout da mesma branch duas vezes. O git se recusa a ter uma branch em checkout em dois worktrees ao mesmo tempo, e faz bem. Se dois agentes precisam da main em checkout, um deles tem que criar uma branch. Isso é um recurso, não uma limitação, mas surpreende quem esperava que worktrees fossem cópias soltas.
O disco cresce rápido. O armazenamento de objetos é compartilhado, então o histórico é barato. Os diretórios de trabalho e suas instalações não são. Dez worktrees de um projeto com um node_modules de 900 MB são 9 GB de dependências duplicadas. Em um notebook rodando alguns agentes, você sente isso na hora do almoço.
Worktrees sujos resistem à remoção. git worktree remove se recusa se o worktree tiver alterações não commitadas, o que te protege de jogar fora um trabalho que o agente não terminou. Quando você realmente quer que ele vá embora, git worktree remove --force. Mas agora a decisão de saber se aquele trabalho não commitado importava é sua, para cada worktree, manualmente.
Diretórios excluídos deixam fantasmas. Apague uma pasta de worktree com rm -rf e o git ainda vai listá-la até você rodar git worktree prune. Scripts que criam worktrees mais rápido do que os limpam acumulam entradas obsoletas, e as entradas seguram locks que bloqueiam a reutilização de nomes de branch. A limpeza não é opcional; ela só é fácil de esquecer até o git worktree list virar um cemitério.
Caches aninhados de agentes não são seus para apagar. Alguns runtimes mantêm seus próprios caches de worktree, por exemplo em ~/.claude/worktrees. Não aponte seus próprios scripts de limpeza para eles. Deixe a ferramenta dona do cache gerenciá-lo.
Nenhuma dessas coisas é difícil isoladamente. O problema é que elas se acumulam. Dois worktrees você gerencia na mão. Com cinco, você escreve um script. Com doze agentes rodando em dois repositórios, o script vira um pequeno pedaço de infraestrutura com bugs próprios, e você é o plantonista dele.
Onde os scripts param de escalar
O percurso honesto é mais ou menos assim. Você começa com uma função de shell que embrulha o git worktree add, joga um agente no novo diretório e roda a configuração. Funciona. Você adiciona um esquema de nomes para os diretórios não colidirem. Você adiciona um comando de limpeza. Aí os requisitos se acumulam.
Você quer saber qual agente está em qual worktree agora, e em que estado está sua branch. Seu git worktree list não sabe nada sobre agentes; ele sabe sobre diretórios. Você improvisa um arquivo de mapeamento. Você quer que as instalações de dependências por worktree não atropelem seu disco, então adiciona lógica de cache. Você quer que a saída de um agente, seu diff e os resultados dos testes cheguem a algum lugar onde um humano possa revisar, em vez de ficarem presos em um terminal que fecha. Agora você está escrevendo um coletor de resultados. Você quer que dois agentes não peguem a mesma tarefa da fila. Agora você está escrevendo um lock.
Em algum momento você reimplementou uma camada de orquestração com scripts de shell, e não é trabalho de ninguém mantê-la. É exatamente nessa fissura que vive a conversa sobre alternativa ao vibe kanban, e é por isso que os times partem para uma camada de gerenciamento de verdade quando o número de agentes passa de um limite. O worktree nunca foi a parte difícil. Coordenar muitas execuções isoladas e trazer seus resultados de volta para um só lugar é que é.
Como o Sharkly executa cada Task em seu próprio worktree
O Sharkly é uma plataforma tudo-em-um de comando e gerenciamento de Agentes. Ele não substitui o Claude Code, o Codex ou as outras ferramentas de execução que seus agentes já usam; ele adiciona a camada compartilhada de Task, Computer, contexto e revisão ao redor delas. O isolamento por worktree é parte integrante dessa camada, então você para de fazê-lo à mão.
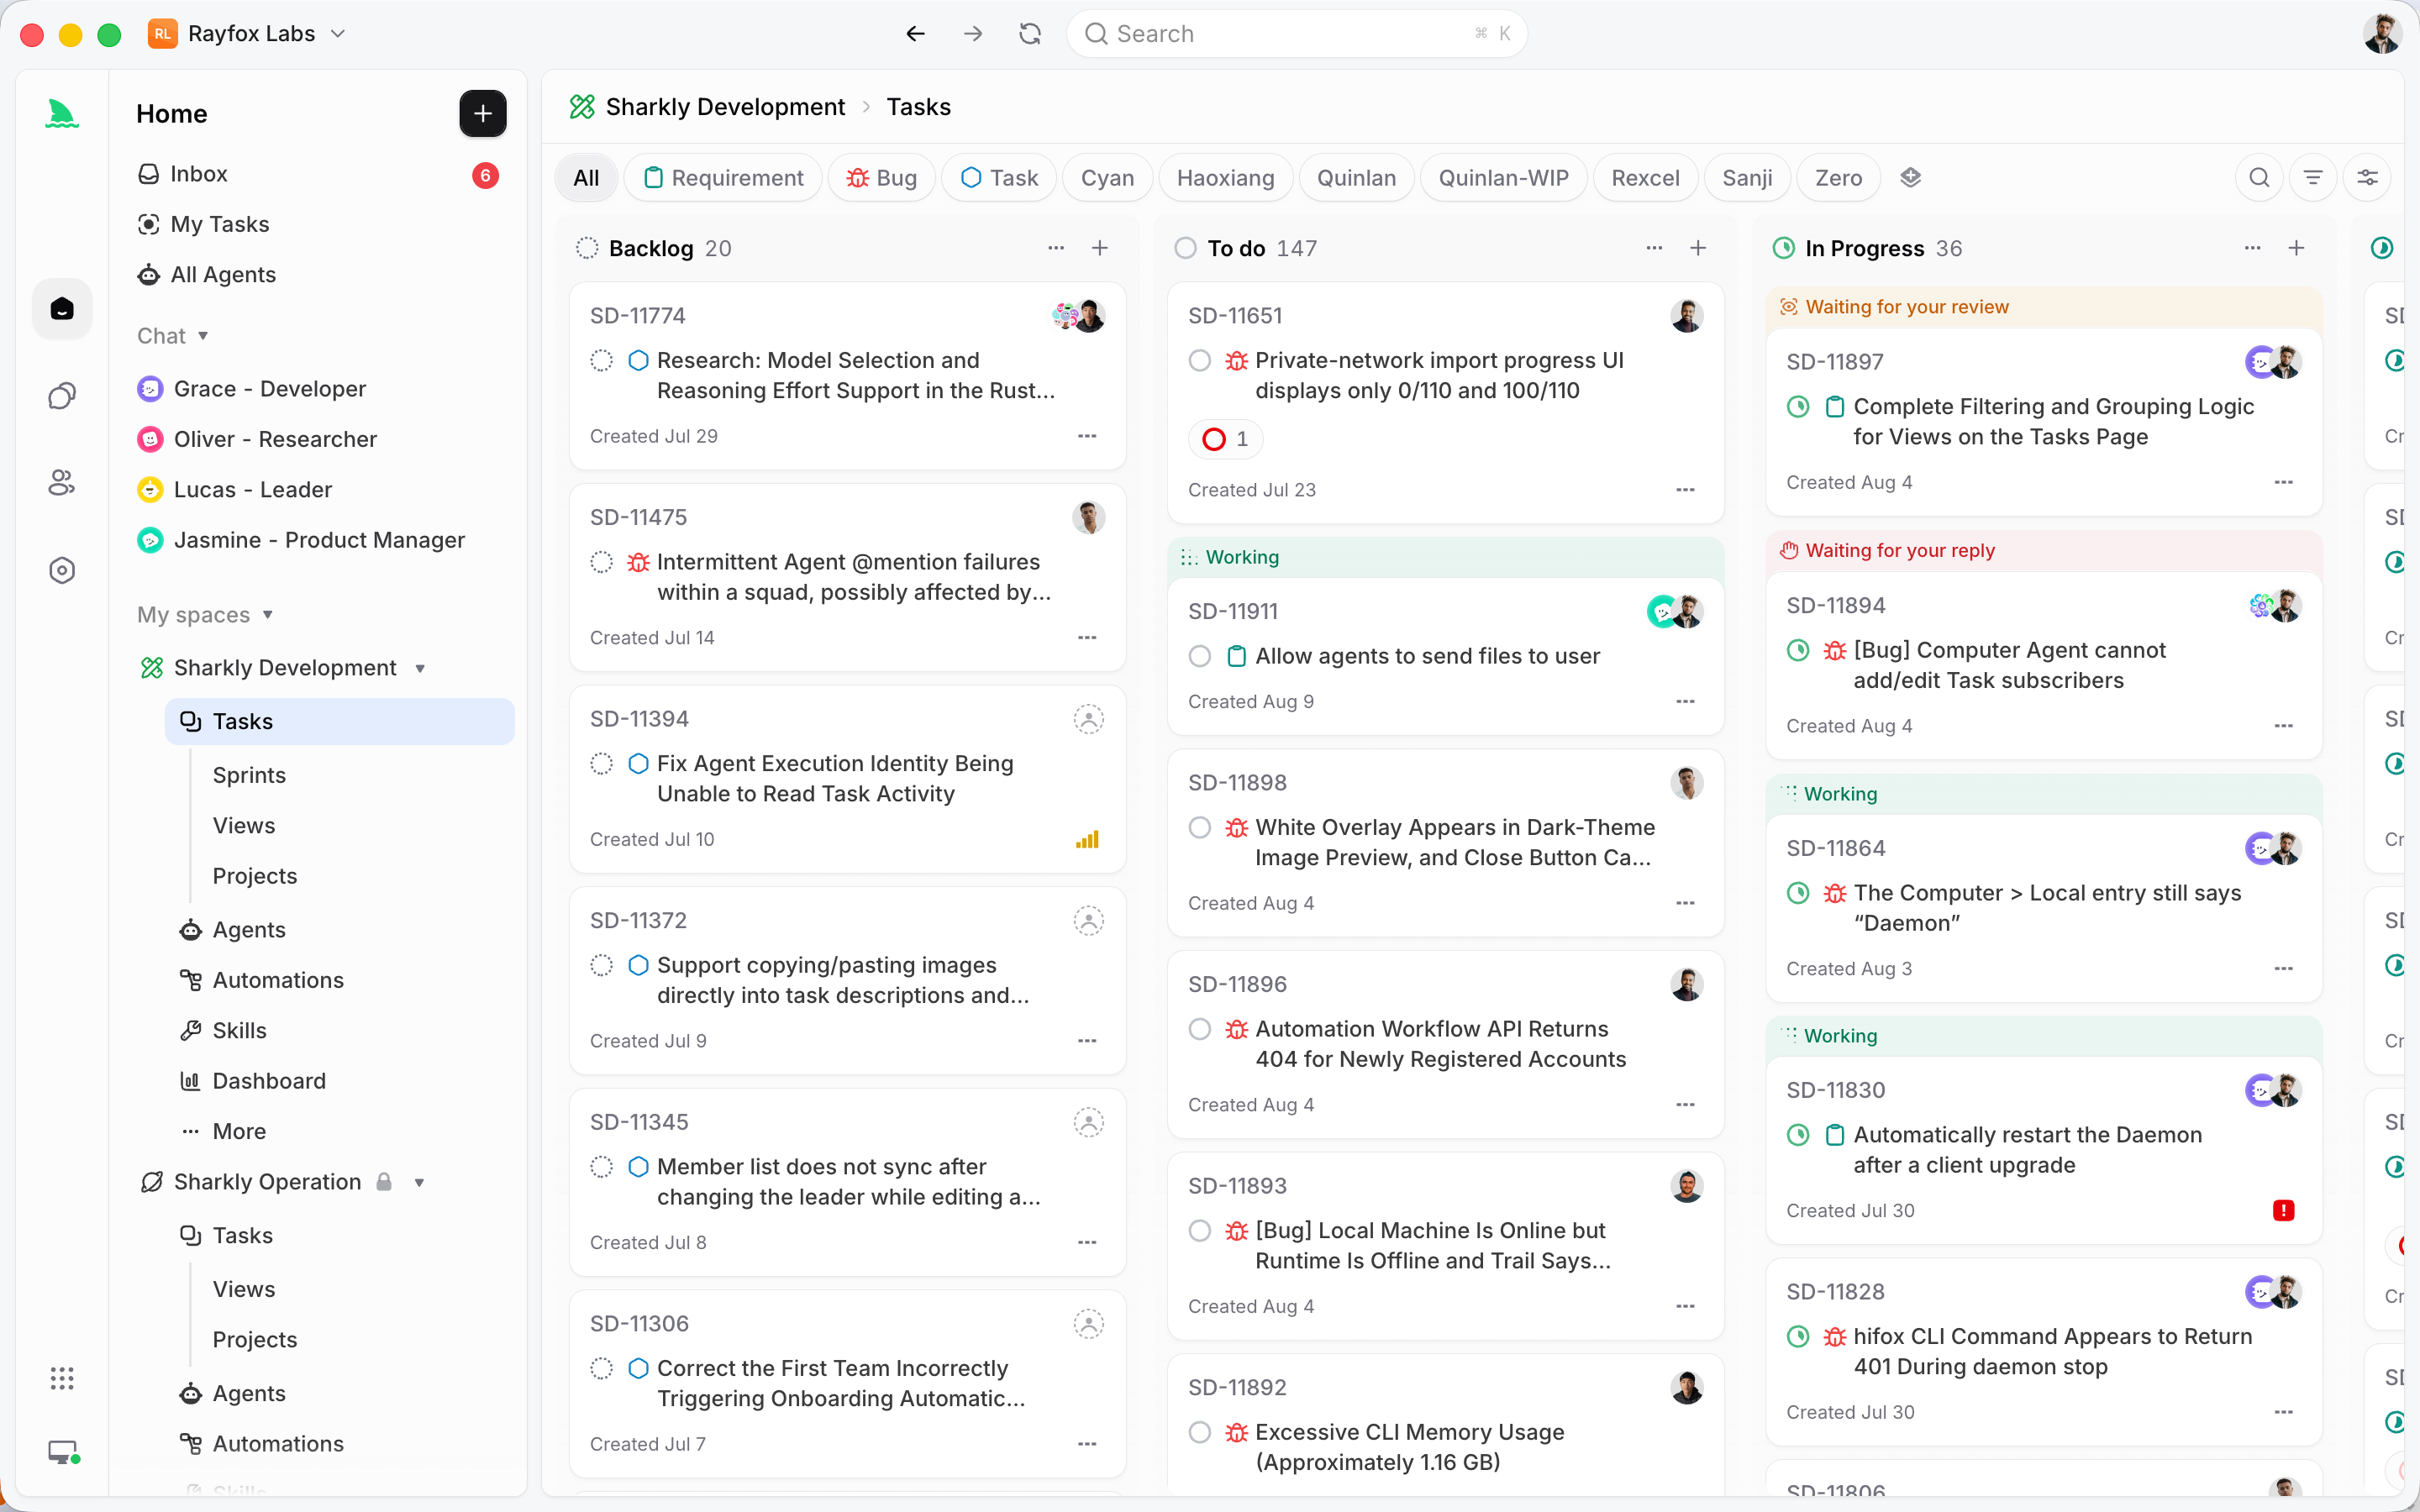
O mecanismo é direto. Cada Task recebe um diretório isolado. Para trabalho baseado em repositório, o Sharkly prepara um worktree novo por execução a partir dos seus dados de repositório em cache, então várias Tasks podem trabalhar sobre a mesma fonte sem nunca escrever em um checkout compartilhado. Você não roda git worktree add. Você não escreve um esquema de nomes, um job de limpeza nem um arquivo de mapeamento. Você atribui uma Task, e o isolamento já está lá.
Essa é a separação de responsabilidades que deixa tudo tranquilo. O Agent define como o trabalho deve ser conduzido. O Computer fornece o host e os recursos locais. O Runtime realiza a sessão do agente propriamente dita. A Task permanece como o registro compartilhado do time. Como cada execução está em seu próprio worktree, frontend, backend, uma correção de bug e nova cobertura de testes podem avançar ao mesmo tempo sem pisar uns nos outros, exatamente o paralelismo que a abordagem manual buscava.
E os resultados têm para onde ir. Execução, bloqueios, resultados e discussão de acompanhamento voltam todos para a linha do tempo da Task. Em vez de o diff de um agente ficar em um terminal que você precisa lembrar de verificar, o resumo da alteração, a saída da verificação e os limites conhecidos voltam para a Task, onde uma pessoa os aceita, pede alterações ou decide o merge. Contexto, progresso, bloqueios, resultados e revisão humana permanecem visíveis da solicitação à entrega, em um só lugar compartilhado em vez de divididos entre prompts privados e sessões de terminal. Se você é novo nesse modelo, atribuir sua primeira Task a um agente de IA de programação é o caminho mais curto.
Você mantém as ferramentas que já usa. O uso de modelos continua pelas assinaturas ou chaves de API configuradas nessas ferramentas; o Sharkly adiciona o isolamento, a coordenação e a revisão ao redor delas.
Worktrees manuais versus uma camada de gerenciamento
As duas abordagens usam a mesma primitiva. A diferença é quem carrega o peso operacional.
| Preocupação | Git worktrees manuais | Worktrees gerenciados pelo Sharkly |
|---|---|---|
| Isolamento por agente | Você roda git worktree add por execução |
Cada Task recebe um worktree novo automaticamente |
| Configuração por worktree | Você scripta instalações e arquivos de ambiente | Tratada como parte da preparação da task |
| Limpeza e prune | Sua responsabilidade, fácil de esquecer | Gerenciada; a limpeza segura nunca toca caches protegidos |
| Qual agente está onde | Um arquivo de mapeamento que você mantém | Visível na Task, sem arquivo paralelo |
| Resultados e diffs | Presos em cada terminal | Voltam para a Task para revisão |
| Reivindicação de tasks / locks | Você escreve o lock | As tasks são reivindicadas de um plano compartilhado |
| Coordenação de disco | Manual | Gerenciada entre os Computers conectados |
Use worktrees manuais quando você é um desenvolvedor rodando um ou dois agentes e quer controle total do shell. Essa configuração é genuinamente boa, e vale a pena aprender porque a mecânica te ensina o que qualquer camada acima está fazendo. Use uma camada de gerenciamento quando o número crescer, quando mais de uma pessoa precisar ver o trabalho ou quando perder os resultados de um agente em um terminal fechado já tiver custado algo a você. Isso espelha a regra de decisão honesta do nosso guia de orquestração de agentes de IA: não adicione maquinário de coordenação até o trabalho paralelo ser real, e não continue fazendo isso à mão quando ele for.
O contrato humano-agente continua valendo
O isolamento muda onde o trabalho acontece, não quem decide. Worktrees permitem que agentes pesquisem, executem, testem e reportem em paralelo sem colisões. As pessoas ainda definem a direção, concedem autoridade e aceitam o resultado. A automação para onde o julgamento do time é necessário. Um worktree novo por agente é o que torna essa fronteira aplicável: o trabalho de cada agente chega como uma alteração distinta e revisável em sua própria branch, não como uma edição impossível de rastrear misturada em um checkout compartilhado. Você revisa branches, não caos. Para uma visão mais ampla do que essa mudança significa no dia a dia, nosso explicador sobre agentic coding estabelece o contexto, e O que é o Sharkly cobre a plataforma de ponta a ponta.
Algumas abordagens comprovadas para worktrees manuais
Se você vai continuar no manual por enquanto, estes hábitos evitam a maior parte da dor:
- Nomeie os diretórios de worktree com o nome da branch ou da task, não sequencialmente.
myproject-auth-refactordiz o que é;myproject-wt3não diz nada. - Mantenha os worktrees como irmãos do checkout principal, não aninhados dentro dele. O aninhamento confunde ferramentas que percorrem a árvore e infla suas regras de ignore.
- Automatize a configuração por worktree como um único script que o agente roda primeiro, para que um worktree novo seja executável em um passo em vez de falhar por falta de instalação.
- Faça prune em uma agenda, não por capricho. Um
git worktree prunediário mais uma revisão dogit worktree listmantêm as entradas fantasmas sob controle. - Nunca apague um cache aninhado de runtime como
~/.claude/worktreespelos seus próprios scripts. Deixe o runtime cuidar dele. - Faça commit ou stash antes de remover. O
--forceexiste para quando você tem certeza, não como padrão.
Conclusão
Git worktrees são a primitiva de isolamento que torna seguros os agentes de IA de programação em paralelo. As ideias centrais valem a pena guardar:
- Um checkout tem uma branch, um index, um
HEAD, e não comporta dois agentes ao mesmo tempo. - Um worktree adiciona um segundo diretório de trabalho sobre o mesmo histórico compartilhado, então cada agente recebe sua própria branch e seus próprios arquivos.
- Os cinco comandos (
add,list,remove,prunee--forcequando você realmente quer) são simples. - O custo operacional (instalações por worktree, disco, limpeza, coordenação, coleta de resultados) é o que cresce.
- Worktrees manuais são adequados para um ou dois agentes; uma camada de gerenciamento ganha seu lugar conforme o número e as apostas aumentam.
- O Sharkly prepara um worktree novo para cada Task automaticamente e devolve cada resultado à Task para revisão humana.
Aprenda primeiro os comandos manuais; eles te ensinam o que qualquer camada acima está fazendo. Quando a contabilidade começar a custar mais do que o trabalho, o Sharkly tira o worktree, a coordenação e a revisão das suas costas. Conecte um Computer, crie um Agent e atribua a ele algo entediante.
FAQ
O que é um git worktree em termos simples? É um segundo diretório de trabalho vinculado ao mesmo repositório, com sua própria branch em checkout e suas próprias alterações em stage e fora dele. Ele compartilha um único histórico de commits com o checkout principal, então é muito mais leve que um clone. Para agentes de IA, significa que cada agente ganha um lugar privado para trabalhar sem tocar nos arquivos de ninguém.
Por que agentes de IA de programação precisam de worktrees? Porque dois agentes compartilhando um checkout vão sobrescrever os arquivos um do outro e mudar a branch um do outro. Um worktree por agente move os conflitos para o momento do merge, onde são visíveis e revisáveis, em vez de para o meio da edição, onde corrompem o estado silenciosamente. Veja nosso guia para rodar vários agentes do Claude Code em paralelo para a configuração paralela completa.
Um worktree é a mesma coisa que um clone? Não. Um clone copia todo o banco de objetos para um repositório separado. Um worktree compartilha um único banco de objetos e adiciona apenas um novo diretório de trabalho e um checkout de branch. Commits feitos em qualquer worktree ficam visíveis instantaneamente em todos eles, e o uso de disco é muito menor.
Dois worktrees podem fazer checkout da mesma branch? Não. O git se recusa a fazer checkout de uma branch em dois worktrees ao mesmo tempo, para te proteger de escritas conflitantes na mesma branch. Se dois agentes precisam dessa branch como base, um deles tem que criar uma nova branch a partir dela.
Como limpo worktrees com segurança? Faça commit ou stash de qualquer trabalho primeiro, depois git worktree remove <path>. Se você excluiu um diretório de worktree na mão, rode git worktree prune para limpar os metadados obsoletos. Nunca aponte scripts de limpeza para o cache do próprio runtime, como ~/.claude/worktrees.
Quando devo parar de gerenciar worktrees na mão? Quando você estiver coordenando mais do que alguns agentes, quando mais de uma pessoa precisar ver o trabalho ou quando um resultado perdido em um terminal fechado já tiver custado tempo. Nesse ponto, uma camada de gerenciamento que isola e rastreia cada execução se paga. Nosso guia de orquestração de agentes de IA cobre quando dar esse salto.


