
Argon ou Carbon? Execute a maioria das tarefas de agentes no Gemini 4 Argon e direcione apenas as mais complexas para o Gemini 4 Carbon. O próprio Google afirma isso: o Argon continua sendo o padrão para a maior parte da engenharia de software, enquanto o Carbon é voltado para trabalhos mais pesados. Ambos custam US$ 2 na entrada e US$ 10 na saída por milhão de tokens até 30 de novembro de 2026, mas o Carbon consome mais tokens por tarefa.
TL;DR
- Comece no mais econômico por padrão e escale com base em evidências. Inicie cada tarefa no modelo rápido. Escale para um modelo superior apenas quando houver uma regra objetiva indicando alta complexidade ou se ela já tiver falhado uma vez.
- O mesmo preço por token não significa o mesmo custo por tarefa. O Carbon lê mais contexto, raciocina por mais tempo e realiza mais verificações; logo, uma única tarefa consome mais tokens.
- Quatro sinais indicam uma tarefa complexa: horizonte longo, muitos arquivos, impacto na segurança e falha na primeira execução.
- Monitore duas métricas por tarefa: custo e taxa de aprovação na revisão. Faça o roteamento com base nesses dados, e não em leaderboards.
- Defina o modelo como uma configuração, não como uma decisão a cada prompt. No Sharkly, cada Agent tem um modelo padrão (Default model), e você pode substituí-lo para uma execução individual ao atribuir a tarefa.
Por que perguntar “qual modelo é o melhor” é a abordagem errada
O Gemini 4 Carbon teve sua disponibilidade geral (GA) anunciada em 10 de novembro de 2026, sob o identificador gemini-4-carbon. O artigo de lançamento do Google traz algo que comunicados desse tipo raramente fazem: recomenda não usar seu modelo mais recente para a maior parte do trabalho: “O Argon continua sendo a escolha ideal para a maioria das tarefas de engenharia de software e trabalho intelectual”.
O Carbon, segundo a mesma publicação, foi “desenvolvido para tarefas que testam os limites da inteligência de um modelo” e consome “mais tokens que o Argon para explorar minuciosamente, raciocinar em profundidade e executar ciclos estendidos de verificação”.
Esse posicionamento reflete com precisão como uma equipe opera agentes. Você tem uma fila de tarefas com diferentes níveis de complexidade, e cada uma merece o modelo mais econômico capaz de passar pela revisão. Definir um único “melhor modelo” para o time inteiro significa pagar caro demais em tarefas simples ou sofrer com desempenho insuficiente nas complexas.
Se quiser entender primeiro o panorama completo sobre o Carbon, nosso artigo Gemini 4 Carbon para agentes de código detalha o modelo, enquanto o guia do Gemini 4 Argon apresenta a opção padrão.
A regra de roteamento: comece no econômico, escale no complexo
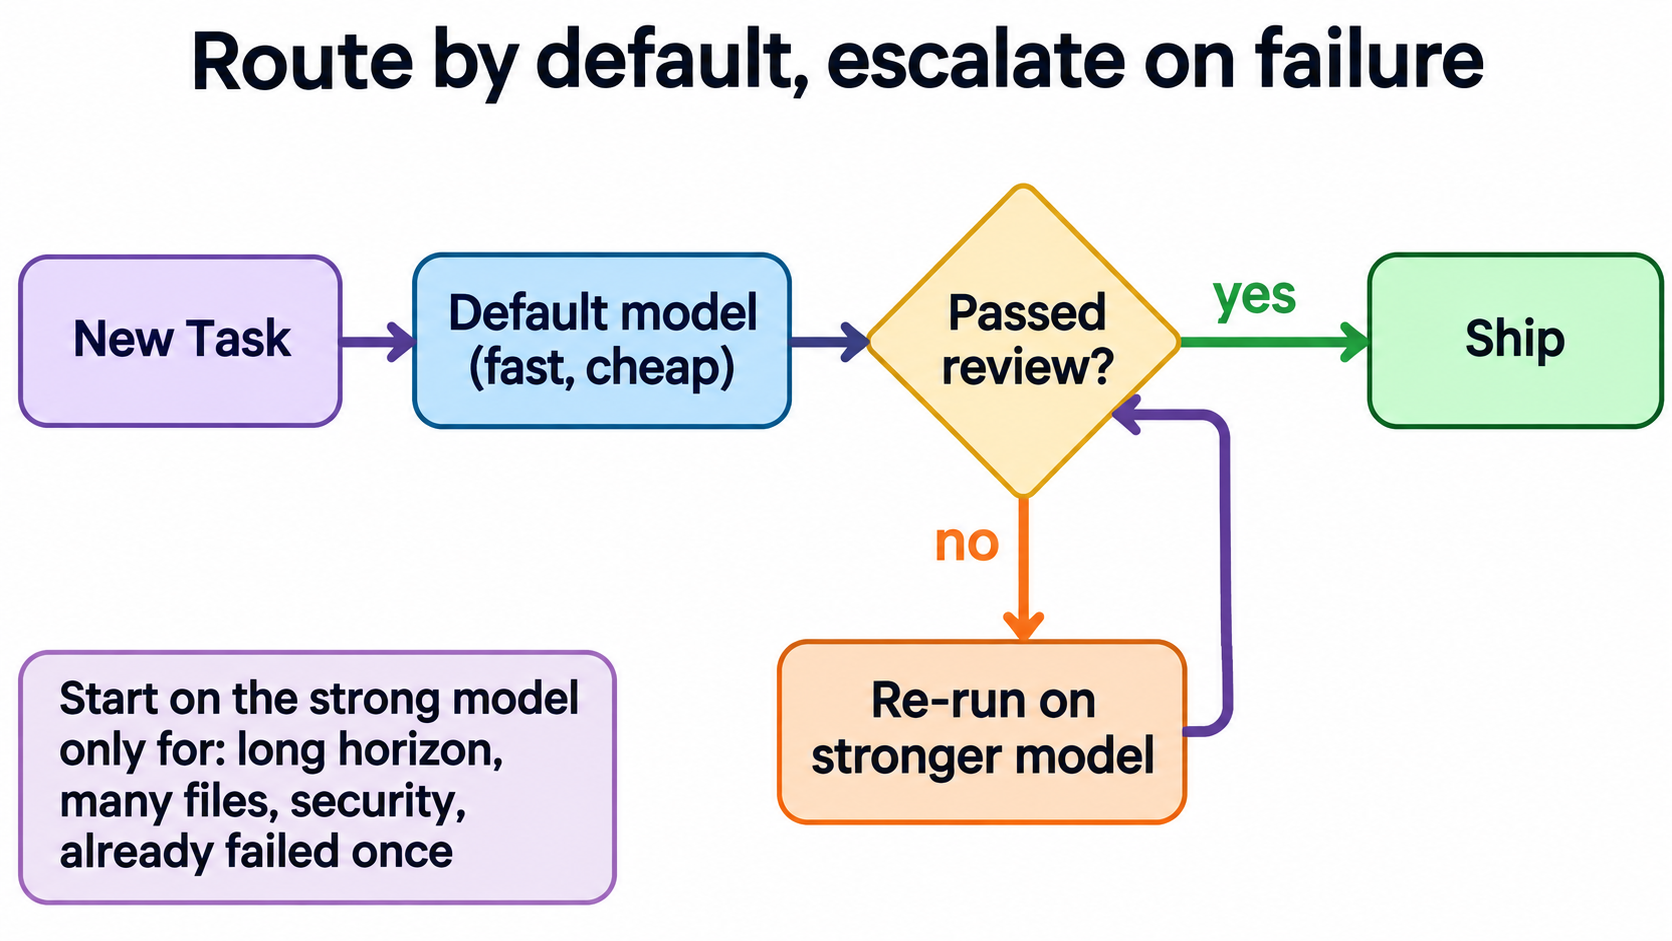
O roteamento de modelos para agentes de código consiste em escolher o modelo por tarefa, e não por equipe. A regra se resume em uma linha: toda tarefa começa no modelo padrão e só avança para o modelo mais robusto se houver um critério explícito de alta complexidade ou se o modelo padrão já tiver falhado.
Dois princípios fazem essa regra funcionar na prática:
- Um modelo padrão rápido e competente o bastante para a maioria das tarefas. Para equipes que usam o ecossistema Gemini, essa escolha é o Argon, seguindo a própria recomendação do Google.
- Um fluxo de escalonamento com gatilhos auditáveis. “Pareceu difícil” não é um gatilho válido. “Altera o código de autenticação” é.
Como identificar se uma tarefa é complexa
Você precisa de sinais objetivos que qualquer pessoa consiga identificar em uma tarefa antes de executá-la. Estes quatro abrangem a grande maioria dos casos:
Horizonte longo
Uma tarefa que envolve muitas etapas consecutivas — como uma migração com dez alterações interdependentes — amplia as chances de um modelo mais simples se desviar do objetivo. Os ciclos adicionais de verificação do Carbon foram feitos sob medida para esse cenário. Sinal de alerta: a descrição da tarefa lista mais de cinco etapas ou uma execução anterior de trabalho semelhante estourou o limite de tempo estipulado.
Múltiplos arquivos
Mudanças transversais exigem que o modelo mantenha mais partes da base de código ativas na memória de contexto. Sinal de alerta: a alteração abrange múltiplos pacotes ou mais de dez arquivos.
Impacto em segurança
Autenticação, processamento de pagamentos, manipulação de segredos e checagens de permissão não toleram erros confiantes. O post de lançamento do Google destaca que o Carbon lidera os benchmarks SEC-bench Pro e CWE-bench v1 quando acessado pelo Fairwind Program para profissionais de cibersegurança. Sinal de alerta: a tarefa altera arquivos em caminhos classificados como críticos ou sensíveis.
Já falhou uma vez
Este é o sinal mais direto e confiável. Se a execução com o modelo padrão foi reprovada na revisão de código, você tem a prova cabal de que a tarefa supera as capacidades dele. Reexecute-a no modelo mais potente, incluindo os apontamentos do revisor.
Uma tabela de roteamento inicial para o seu time
Use esta estrutura como ponto de partida e ajuste-a após duas semanas com base nas suas próprias taxas de aprovação.
| Tipo de tarefa | Modelo inicial | Escalar para | Motivo |
|---|---|---|---|
| Correção de texto, ajuste visual, atualização de dependência | Camada rápida (modelo Flash ou mini) | Argon | Diff pequeno, revisão simples |
| Correção de bug com teste quebrando | Argon | Carbon | O teste fornece um sinal claro de validação |
| Nova funcionalidade em um único módulo | Argon | Carbon | Padrão recomendado pelo Google para a maioria da engenharia |
| Refatoração em múltiplos arquivos | Carbon | Fable 5.2 ou revisão humana | Horizonte longo, múltiplos arquivos |
| Autenticação, pagamentos, permissões | Carbon | Sempre revisão humana | Impacto crítico em segurança |
| Qualquer tarefa reprovada na revisão | Um nível acima | Humano | Evidências superam suposições |
O Claude Fable 5.2 custa US$ 8 na entrada e US$ 40 na saída por milhão de tokens — quatro vezes o valor promocional do Carbon —, funcionando como um último recurso automatizado, e não como primeira opção. O preço do próprio Carbon subirá para US$ 4 e US$ 20 após 30 de novembro de 2026, de acordo com as notas do Google, o que reduzirá essa distância. Consulte os valores atualizados na página de preços da API do Gemini antes de fechar seus orçamentos.
Escale após a falha, não por antecipação
As equipes tendem a encaminhar previamente qualquer coisa que “pareça difícil” direto para o modelo mais potente. Isso dá uma falsa sensação de segurança e custa caro, já que muitas dessas tarefas seriam concluídas com sucesso pelo modelo padrão.
Escalar diante de falhas garante que você pague o custo do modelo menor em todas as tarefas e o custo do modelo avançado somente quando a tarefa comprovar que precisa dele. Uma tentativa que falhou no modelo econômico costuma custar bem menos do que uma execução desnecessária no modelo topo de linha.
Há apenas duas exceções a essa regra, ambas contempladas na tabela acima: tarefas de segurança começam no modelo superior porque um erro na primeira execução pode acabar passando despercebido pelo code review e indo para produção; refatorações extensas em múltiplos arquivos começam no topo porque uma falha desperdiça uma hora de trabalho, e não poucos minutos.
Vale lembrar que uma execução com falha só ensina algo se a etapa de revisão for capaz de pegá-la. Modelos podem burlar testes unitários; por isso, alinhe o escalonamento com as práticas descritas em como identificar agentes de código que trapaceiam em testes.
Monitore o custo e a taxa de aprovação por tarefa
Fazer roteamento sem métricas é agir no puro achismo. Acompanhe dois dados fundamentais para cada tarefa:
- Custo por tarefa: tokens de entrada e saída multiplicados pela tabela de preço do modelo, somando todas as execuções exigidas pela tarefa, incluindo as que falharam.
- Taxa de aprovação na revisão: a primeira tentativa foi aprovada ou exigiu uma nova rodada ou correção manual de um desenvolvedor?
Depois, cruze os dados. O custo por alteração aprovada é a métrica definitiva que orienta o roteamento. Um modelo barato que falha em metade das tentativas pode sair mais caro do que um modelo avançado aprovado de primeira — ponto que detalhamos em quando modelos mais baratos custam mais caro.
Relatórios independentes confirmam essa lógica. A Artificial Analysis aponta que rodar seu Intelligence Index custou US$ 7,76 no Gemini 4 Carbon (high) e US$ 26,54 no Claude Fable 5.2 (max), com o Fable atingindo 65 pontos contra 60 do Carbon. Uma diferença de apenas cinco pontos por um custo 3,4 vezes maior só compensa nas tarefas em que esses cinco pontos realmente alteram o resultado prático.
Um registro simples é suficiente para começar:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Neste exemplo, a tarefa COIN-213 falhou no Argon, foi escalada e passou com o Carbon. O custo total da tarefa foi de US$ 1,29, e essa linha indica claramente se tarefas semelhantes já devem começar direto no Carbon da próxima vez.
Centralize o roteamento por tarefa em um painel
Essa diretriz é fácil de entender, mas difícil de manter se cada engenheiro escolhe o modelo individualmente em seu terminal. Traga o roteamento para o mesmo local onde as tarefas são geridas.
Defina um modelo fixo para cada Agent
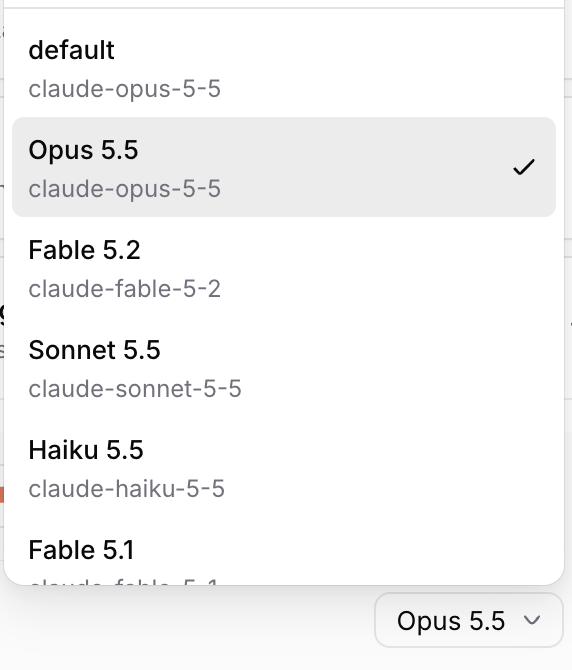
No Sharkly, um Agent adota por padrão o modelo configurado em seu Runtime. No menu de configurações do Agent, o campo Model permite selecionar outro modelo do catálogo daquele Runtime, além de definir a profundidade de raciocínio (thinking depth), quando o modelo disponibiliza essa opção. A documentação de Agents explica o passo a passo. Isso permite estruturar um Agent por nível: um Agent padrão no modelo rápido e um Agent de escalonamento no modelo avançado.
Escale execuções pontuais
Ao delegar uma tarefa, você pode escolher o modelo exclusivo para aquela execução, substituindo o padrão do Agent pontualmente. Isso permite executar o escalonamento pós-falha em uma única etapa: o revisor devolve a tarefa e a nova execução roda no Carbon, sem alterar o Agent compartilhado com o restante da equipe.
Mantenha o histórico centralizado
Cada execução armazena seu log completo, garantindo que sua análise de custo e taxa de aprovação reflita tarefas reais concluídas, e não estimativas de memória. Para Crews que distribuem demandas por função técnica e não por dificuldade, leia roteamento de modelos para Crews de agentes. Já na parte de governança, o post quem monitora seus agentes aborda os controles essenciais mantidos com o time. Você pode começar a usar o Sharkly gratuitamente.
Alternativas ao roteamento por tarefa
- Um modelo único para tudo: funciona bem para quem programa sozinho, mas gera desperdício assim que o nível de complexidade das tarefas varia.
- Modelo roteador automático: um modelo menor classifica cada prompt e seleciona o destino. O problema é que isso torna a decisão opaca e não tem visibilidade de quando uma revisão foi reprovada.
- Estruturas com múltiplos agentes: a prévia do comando /swarm do Google no Antigravity delega planejamento e auditoria ao Carbon enquanto modelos mais leves operam em paralelo. Trata-se de um roteamento funcional dentro da mesma atividade, complementando o roteamento por tarefa.
Conclusão
O próprio Google estabeleceu o padrão no artigo de lançamento: Argon por padrão, Carbon quando a tarefa justificar. Mapeie os quatro sinais de tarefas complexas, mantenha o restante no modelo econômico, escale diante de reprovações e registre o custo e a taxa de aprovação por tarefa. Em duas semanas, os seus próprios números reescreverão essa tabela com muito mais precisão do que qualquer benchmark de mercado.
Próximo passo: configure dois Agents no Sharkly — um com o modelo padrão e outro com o modelo de escalonamento — e direcione as tarefas desta semana por meio deles.
FAQ
Devo usar o Gemini 4 Carbon ou o Argon para agentes de código?
Use o Argon para a maioria das tarefas e o Carbon para as mais complexas. O post de lançamento do Google destaca que o Argon “continua sendo a escolha ideal para a maioria das tarefas de engenharia de software”, enquanto o Carbon é voltado para demandas que exigem o máximo da capacidade do modelo.
O Gemini 4 Carbon é mais caro que o Argon?
Por token individual, não: ambos custam US$ 2 na entrada e US$ 10 na saída por milhão de tokens até 30 de novembro de 2026. Por tarefa, geralmente sim, pois o Carbon utiliza mais tokens para raciocinar, explorar e validar o código.
O que acontece com os preços do Gemini 4 Carbon após 30 de novembro?
Segundo a documentação do Google, o valor promocional de lançamento expira em 30 de novembro de 2026, quando o Carbon passará a custar US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída.
O que é roteamento de modelos para agentes de IA?
Roteamento de modelos é a prática de escolher o modelo de IA específico para cada tarefa conforme a complexidade dela, buscando sempre o menor custo por alteração de código aprovada.
Como saber a hora de escalar uma tarefa para um modelo mais potente?
Escale quando a tarefa tiver um horizonte longo de execução, envolver dezenas de arquivos, mexer em trechos sensíveis de segurança ou já tiver sido reprovada na revisão com o modelo padrão.
Posso configurar um modelo diferente para cada agente no Sharkly?
Sim. Cada Agent possui a configuração Model para escolher qualquer modelo disponível no catálogo do seu Runtime, e você ainda pode sobrescrever o modelo para uma execução individual ao delegar a tarefa.


