
A maioria das equipes que opera vários agentes de programação define, em algum momento, um teto mensal para gastos com modelos — geralmente depois de uma semana ruim. Escolhe-se um número, limita-se a concorrência até a fatura ficar abaixo dele e revisa-se no trimestre seguinte. Em 22/09/2026, esse número silenciosamente deixou de significar o que significava.
A OpenAI lançou o GPT-6 Sol a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, com id de API gpt-6-sol, e publicou algo mais útil do que uma tarifa por token: o custo por tarefa. No AutomationBench 1.0.6, o Sol com esforço de raciocínio extra-alto pontua 33,2% a US$ 0,27 por tarefa. O Claude Opus 5 no esforço máximo pontua 26,9% a 11,1 vezes o custo por tarefa do Sol no mesmo harness.
Então calcule o que seu teto compra agora, antes de aumentá-lo. A resposta para a maioria das equipes é que ele já compra mais execuções concluídas do que qualquer pessoa consegue ler. O que significa que o teto nunca estava protegendo o orçamento. Estava protegendo seus revisores, por acidente, e isso está prestes a acabar.
Resumo
Custo por mudança aceita é o que sua equipe gasta com inferência de modelo para cada diff que uma pessoa realmente lê e aceita, e é a única métrica de custo de agente que se conecta ao trabalho entregue. Pelas tarifas publicadas, todo o throughput revisável mensal de uma equipe com quatro revisores custa cerca de US$ 136 de GPT-6 Sol. A restrição real migrou da fatura para a etapa de aceite, e nenhum lançamento de modelo mexe nisso. Agentes pesquisam, executam, testam e reportam. Pessoas definem a direção, concedem autoridade e aceitam o resultado.
Os números que a OpenAI realmente publicou
A OpenAI reporta a pontuação junto com o custo por tarefa, o que é incomumente honesto e muito mais útil do que uma tabela de preços.
| Modelo, no nível de esforço usado pela OpenAI | AutomationBench 1.0.6 | Custo por tarefa |
|---|---|---|
| GPT-6 Sol, extra-alto | 33,2% | US$ 0,27 |
| GPT-6 Astra, baixo | 30,3% | 3,9x Sol |
| Claude Opus 5, máximo | 26,9% | 11,1x Sol |
| Fable 5.1 com fallback para Opus 5, máximo | 31,4% | mais de 8,9x Sol |
O próprio resumo da OpenAI sobre a primeira e a terceira linhas: o Sol em extra-alto supera o Opus 5 em máximo por cerca de 9% do custo por tarefa do Opus 5. O mesmo padrão aparece em outros pontos do post. No Agents' Last Exam V1, o Sol em máximo pontua 56,4%, acima do melhor resultado do Opus 5, com 60% menos custo por tarefa. No DeepSWE 1.1, o Sol em máximo pontua 68,8%, dentro de 1,1 ponto percentual do Fable 5 em extra-alto (69,9%), cerca de 80% mais barato por tarefa.
Dois ressalvas acompanham esses números e raramente viajam com eles. A manchete da OpenAI é que Sol e Luna são cada um 50% mais baratos que o preço promocional do GPT-5.6, e "promocional" é palavra da própria OpenAI: a comparação é contra uma tarifa com desconto. E a OpenAI fez o benchmark contra o Claude Opus 5, porque o Claude Opus 5.5 foi lançado horas depois a US$ 4 e US$ 20 por milhão, contra os US$ 5 e US$ 25 do Opus 5. A coluna do Opus 5 é a última comparação publicada, não a atual.
Convertendo um orçamento em execuções
Multiplique US$ 0,27 por 11,1 e o Opus 5 em máximo chega a cerca de US$ 3,00 por tarefa nesse harness. Essa aritmética é nossa, a partir dos dois números da OpenAI. Divida um teto mensal por cada um e você obtém a tabela que muda a leitura do teto.
| Orçamento mensal de modelo | Tarefas no Sol, extra-alto | Tarefas no Astra, baixo | Tarefas no Opus 5, máximo |
|---|---|---|---|
| US$ 250 | cerca de 925 | cerca de 240 | cerca de 83 |
| US$ 1.000 | cerca de 3.700 | cerca de 950 | cerca de 330 |
| US$ 5.000 | cerca de 18.500 | cerca de 4.750 | cerca de 1.660 |
O custo por tarefa de um benchmark não é o seu custo por tarefa. As tarefas do AutomationBench têm formato de benchmark: delimitadas, curtas e em nada parecidas com um ticket real em um repositório com anos de histórico. Suas próprias tarefas podem consumir dez ou cem vezes mais tokens. O que viaja entre o benchmark e o seu repositório é a razão entre os modelos, não o dólar absoluto. Trate a tabela como o formato da mudança, e então meça seu próprio custo por execução entre agentes e reescale.
Há uma segunda correção, e ela corta na direção oposta. O custo por tarefa é por tentativa, não por sucesso. Na própria taxa de 33,2% do benchmark, cerca de duas tentativas em três não chegam ao resultado, então o Sol custa cerca de US$ 0,81 por sucesso de benchmark e o Opus 5 em máximo cerca de US$ 11,15. Nossa conta de novo, e aproximada, porque uma taxa de acerto em benchmark não é a taxa de aceite da sua equipe. A direção é o que importa: o custo de tentar algo duas vezes agora é pequeno o suficiente para que a estratégia de retry seja uma decisão de design, não uma decisão de orçamento.
Onde o teto está agora
Coloque o lado da revisão na mesma página. Um revisor que lê um diff adequadamente, entende o que o Agente escolheu e assume responsabilidade pelo resultado consegue dar conta de um certo número de mudanças em um dia de trabalho. Digamos seis, e ajuste ao seu time.
| Revisores | Mudanças aceitas por mês | Custo do Sol a US$ 0,27 | Custo do Opus 5 máximo a US$ 3,00 |
|---|---|---|---|
| 1 | cerca de 126 | US$ 34 | US$ 378 |
| 2 | cerca de 252 | US$ 68 | US$ 756 |
| 4 | cerca de 504 | US$ 136 | US$ 1.512 |
| 8 | cerca de 1.008 | US$ 272 | US$ 3.024 |
Seis mudanças aceitas por revisor por dia ao longo de 21 dias úteis, nossa suposição e nossa aritmética. Coloque seus próprios números e a conclusão se mantém: tudo o que uma equipe de engenharia normal consegue de fato aceitar em um mês custa algumas centenas de dólares de inferência, mesmo na ponta mais caras. Um teto de US$ 1.000 em um time de quatro pessoas não é uma restrição. É cerca de sete vezes mais produção de agentes do que o time consegue absorver.
Esse é o ponto central do corte de preços para uma equipe que revisa seu trabalho. Ele não aumentou sua produção. Removeu a última desculpa para a fila estar curta e tornou visível um gargalo que sempre foi a etapa de revisão humana.
O gasto interno da OpenAI é o contra-exemplo útil, não uma contradição. Seu pesquisador mediano consome mais de US$ 600 por dia de inferência de agente de programação a preços de API, e o percentil 90 consome US$ 7.000 por dia. Esses são números reais e ofuscam a tabela acima, porque esse trabalho tem um formato diferente: fan-out enorme, pontuação automatizada e nenhuma etapa em que uma pessoa nomeada aceita cada resultado em um branch de produção. Se seu processo tem essa etapa, sua conta de modelo vai permanecer pequena e sua fila não.
O que comprar com a folga
Uma vez que o orçamento não é restritivo, a pergunta deixa de ser quantas execuções comprar e passa a ser em que gastar a diferença. Duas respostas reduzem o trabalho que chega até um revisor em vez de aumentá-lo.
Compre esforço, não volume. O esforço de raciocínio é um controle de custo, e a própria tabela da OpenAI usa níveis diferentes para benchmarks diferentes. O número de US$ 0,27 é a linha extra-alto, então o prêmio por uma execução mais cuidadosa já está dentro de um número que é 9% da alternativa. Pagá-lo pelo mesmo número de tarefas custa quase nada e produz diffs que levam menos tempo para conferir.
Compre cache, não tokens. O GPT-6 dá 90% de desconto em leituras de entrada em cache, mantém taxas de acerto mais altas por padrão e não invalida mais o cache quando você muda o esforço de raciocínio ou a disponibilidade de ferramentas. Breakpoints explícitos permitem decidir onde termina um prefixo em cache. A OpenAI cita o GitHub vendo mais de 50% menos tokens de prompt precisando de processamento novo em bilhões de requisições. Para um Crew, essa é a diferença entre o primeiro Agente em um repositório e o décimo: eles reenviam quase o mesmo prefixo de layout, regras internas e convenções, e esse prefixo é exatamente para o que serve um cache. O custo de tokens do contexto do repositório é onde a conta de uma frota realmente mora.
O par de decisões honesto: aumente o número de execuções concorrentes quando as execuções extras convergem para um único resultado que uma pessoa aceita, como três tentativas de uma mesma migração em que uma suíte de testes escolhe a vencedora. Não aumente quando cada execução produz seu próprio diff, seu próprio resumo e sua própria decisão de aceite, por mais baratas que as execuções tenham ficado. No segundo caso, a fatura é a única coisa que escalou bem.
Torne o novo teto contável
O orçamento era um proxy ruim para capacidade, mas tinha uma virtude: era um número que alguém acompanhava. Substitua-o pelo número que agora é restritivo, que são as execuções concluídas aguardando uma pessoa.
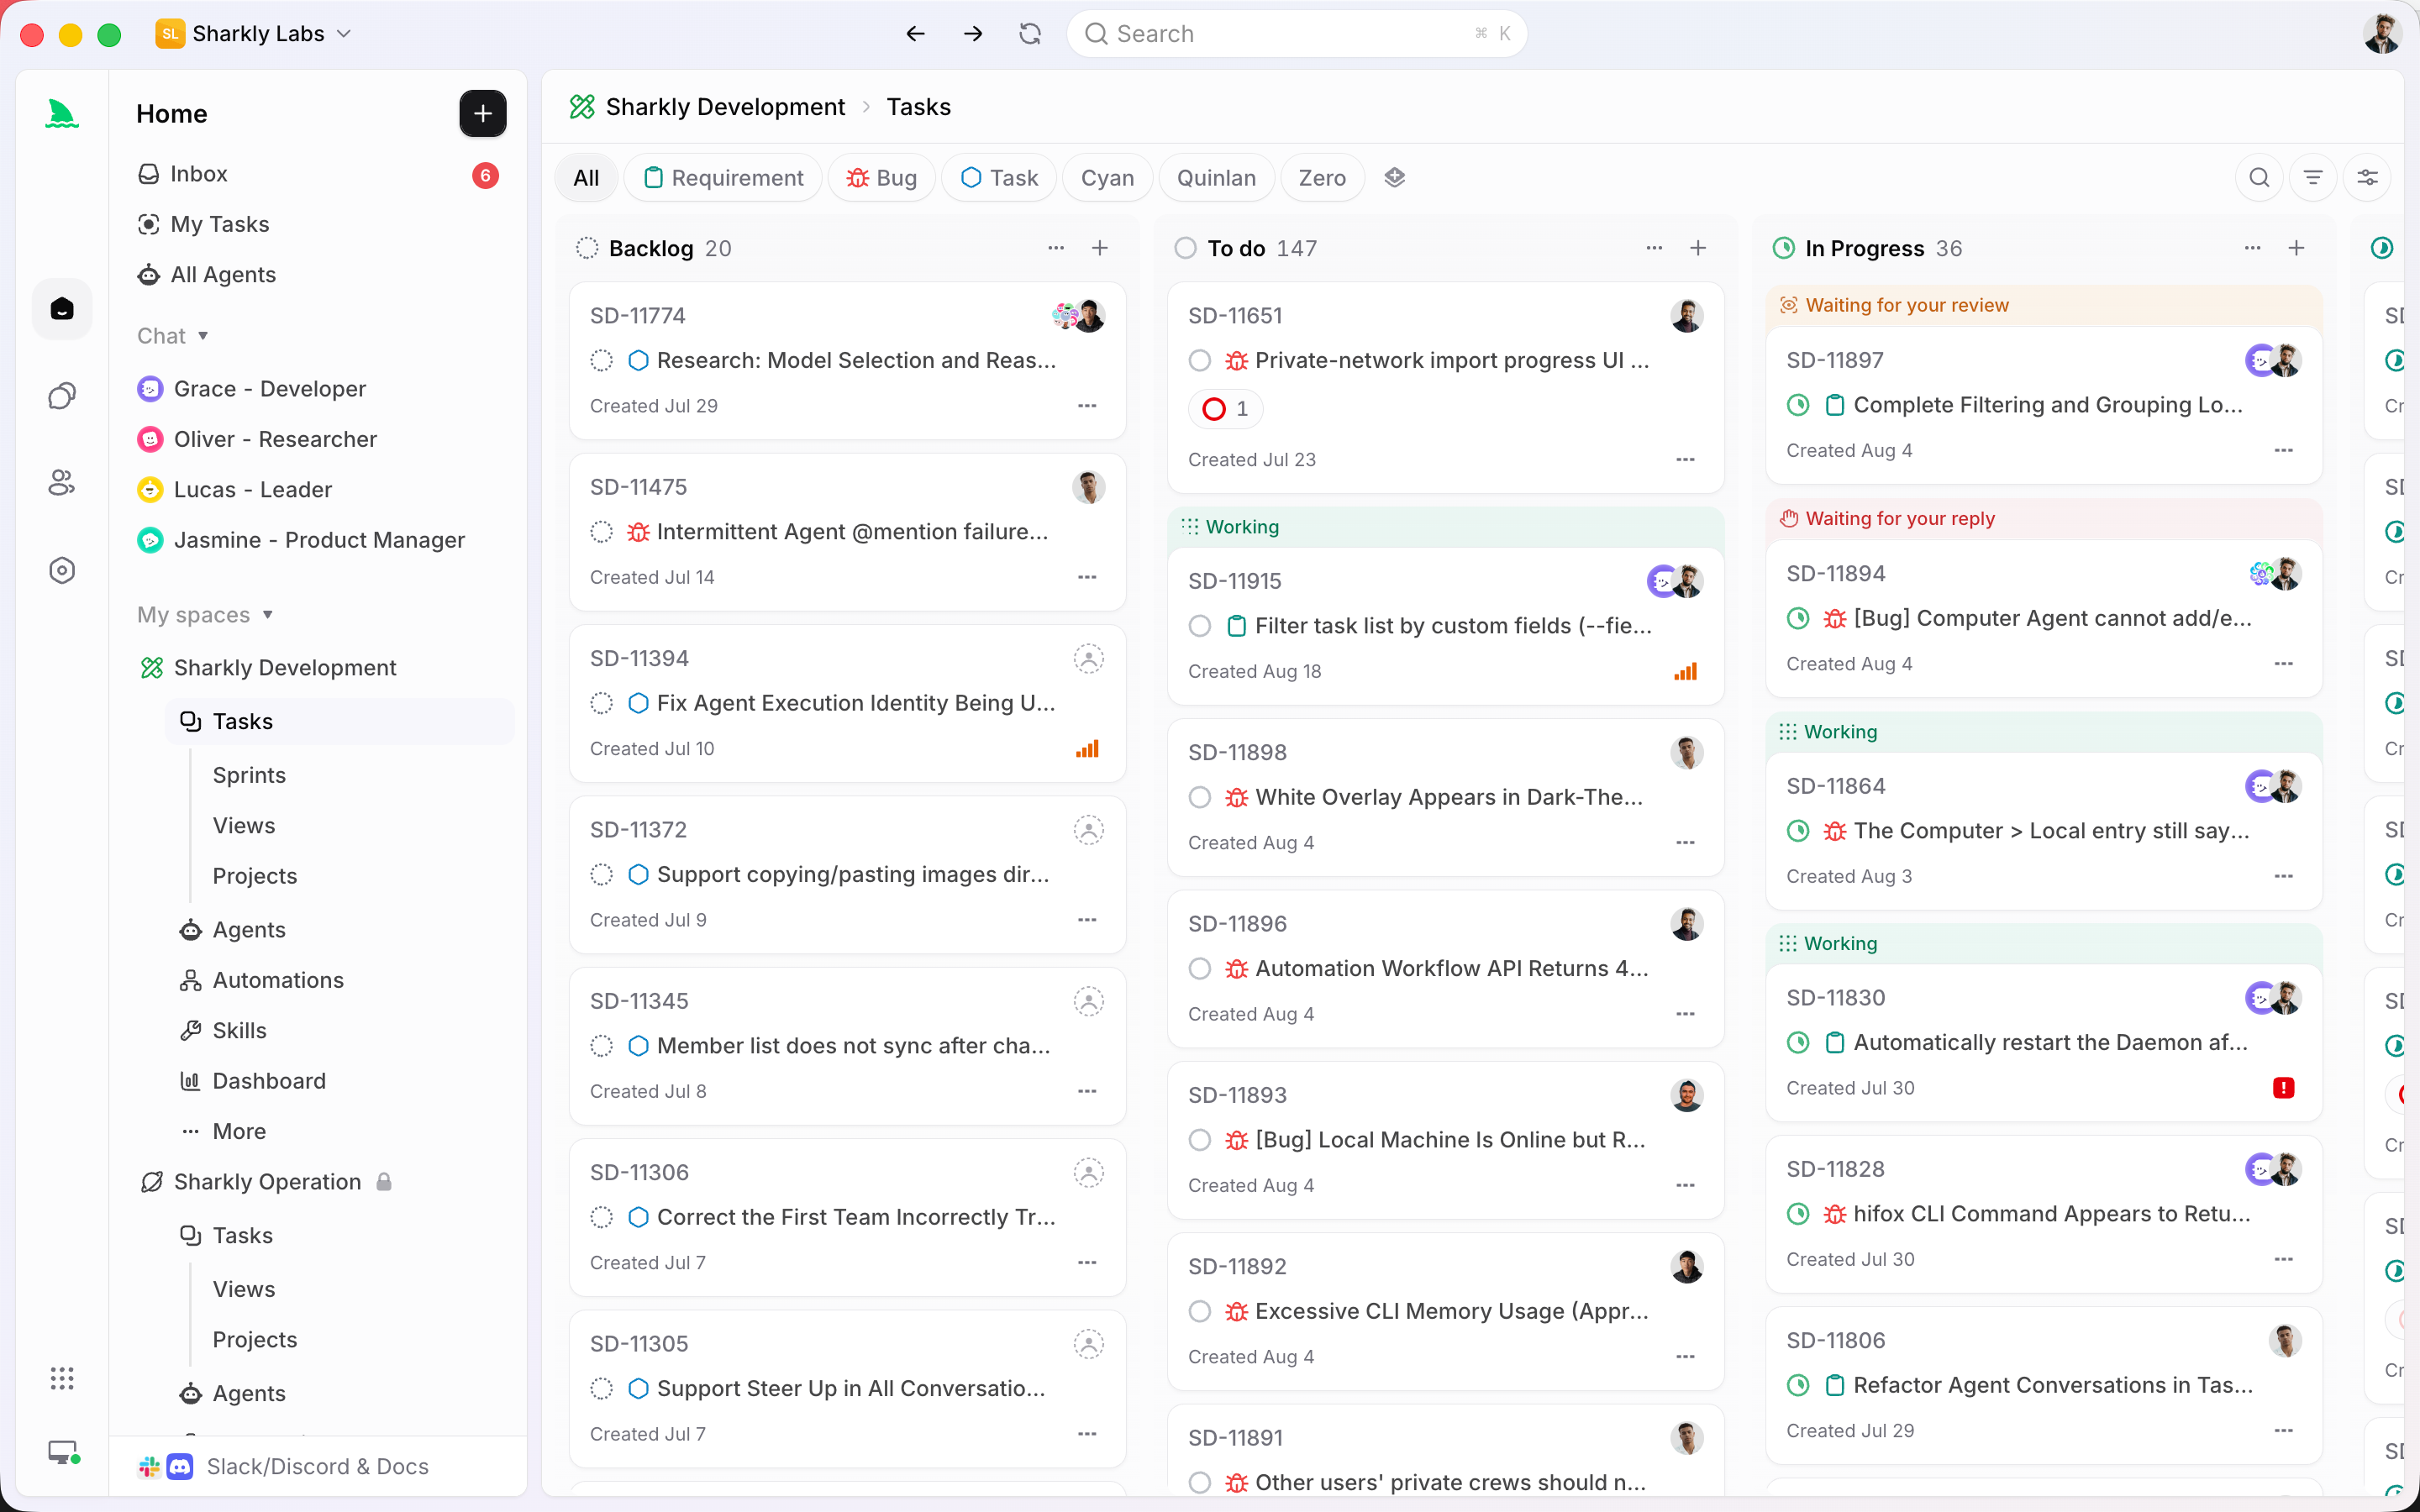
Isso só é mensurável se as execuções pararem de viver em terminais privados. O Sharkly não é um substituto para o Codex, o Claude Code ou as outras ferramentas que rodam esses modelos. É a camada ao redor delas, onde contexto, progresso, bloqueios, resultados e revisão humana permanecem visíveis da solicitação até a entrega. A execução e os bloqueios retornam à Task, então "aguardando uma pessoa" se torna um estado que você pode contar em um quadro, em vez de uma sensação que você tem na sexta à tarde. A aritmética da capacidade de revisão só funciona se você puder ver a fila.
Se você já opera vários agentes de programação, o movimento desta semana não é aumentar o teto. É descobrir quantas execuções concluídas sua equipe aceita em uma semana normal, definir a concorrência com base nisso e gastar o orçamento restante em execuções mais fáceis de aceitar.


