A fatura é o número mais fácil de reduzir e o menos interessante de analisar. Direcione o trabalho de rotina da sua Crew para o GPT-6 Luna a US$ 0,10 e US$ 0,50 por milhão de tokens e o custo com modelos desaba em menos de um dia. Duas semanas depois, a conta continua baixa, o painel exibe mais execuções concluídas do que nunca, e as quatro alterações da última terça-feira continuam esperando alguém para aprová-las.
Nada deu errado. Você apenas transferiu o custo de uma linha que estava monitorando para uma linha que ninguém precifica.
O custo por alteração aceita é o total em dinheiro e tempo humano gasto em cada tentativa que levou a uma alteração aceita por uma pessoa. Ele contabiliza as execuções que falharam, o código que ninguém mesclou e os minutos que alguém levou para tomar uma decisão sobre ambos. Nenhum fornecedor divulga esse valor, nenhum benchmark o mede, e ele é o único número que acompanha o que a sua equipe realmente entrega.
TL;DR
Um modelo mais barato reduz o custo de uma tentativa e eleva três fatores pagos com a atenção dos revisores: tentativas por alteração entregue, volume de saída por tentativa e decisões por alteração entregue. A atenção humana não ficou mais barata em 22/09/2026. A camada econômica é de fato mais barata onde quer que uma máquina decida se a tentativa foi aprovada, e silenciosamente cara onde quer que uma pessoa precise intervir. Agentes pesquisam, executam, testam e relatam. Pessoas definem o rumo, concedem autorizações e aceitam o resultado. A solução é uma mudança de contabilidade antes de ser uma mudança de roteamento: meça tentativas e minutos humanos por alteração aceita, por Runtime, e transforme o trabalho à espera de uma pessoa em um estado mensurável, e não em uma sensação ruim na sexta-feira.
Três métricas, e apenas uma é sua
| Unidade | Quem usa | O que ela mostra | O que ela ignora |
|---|---|---|---|
| Por milhão de tokens | Páginas de preços dos fornecedores | Quanto custa uma entrada e uma saída | Quantos tokens sua tarefa consome |
| Por tarefa concluída | Tabelas de benchmarks | O custo de uma tentativa avaliada | Tentativas com falha, sua base de código, a revisão |
| Por alteração aceita | Sua equipe | Quanto custou, de ponta a ponta, uma alteração entregue | Nada, e é por isso que ninguém a publica |
Ambos os laboratórios lançaram seus modelos em 22/09/2026 e ambos divulgaram dados da coluna do meio. Não leia essas tabelas como se fossem a coluna da direita.
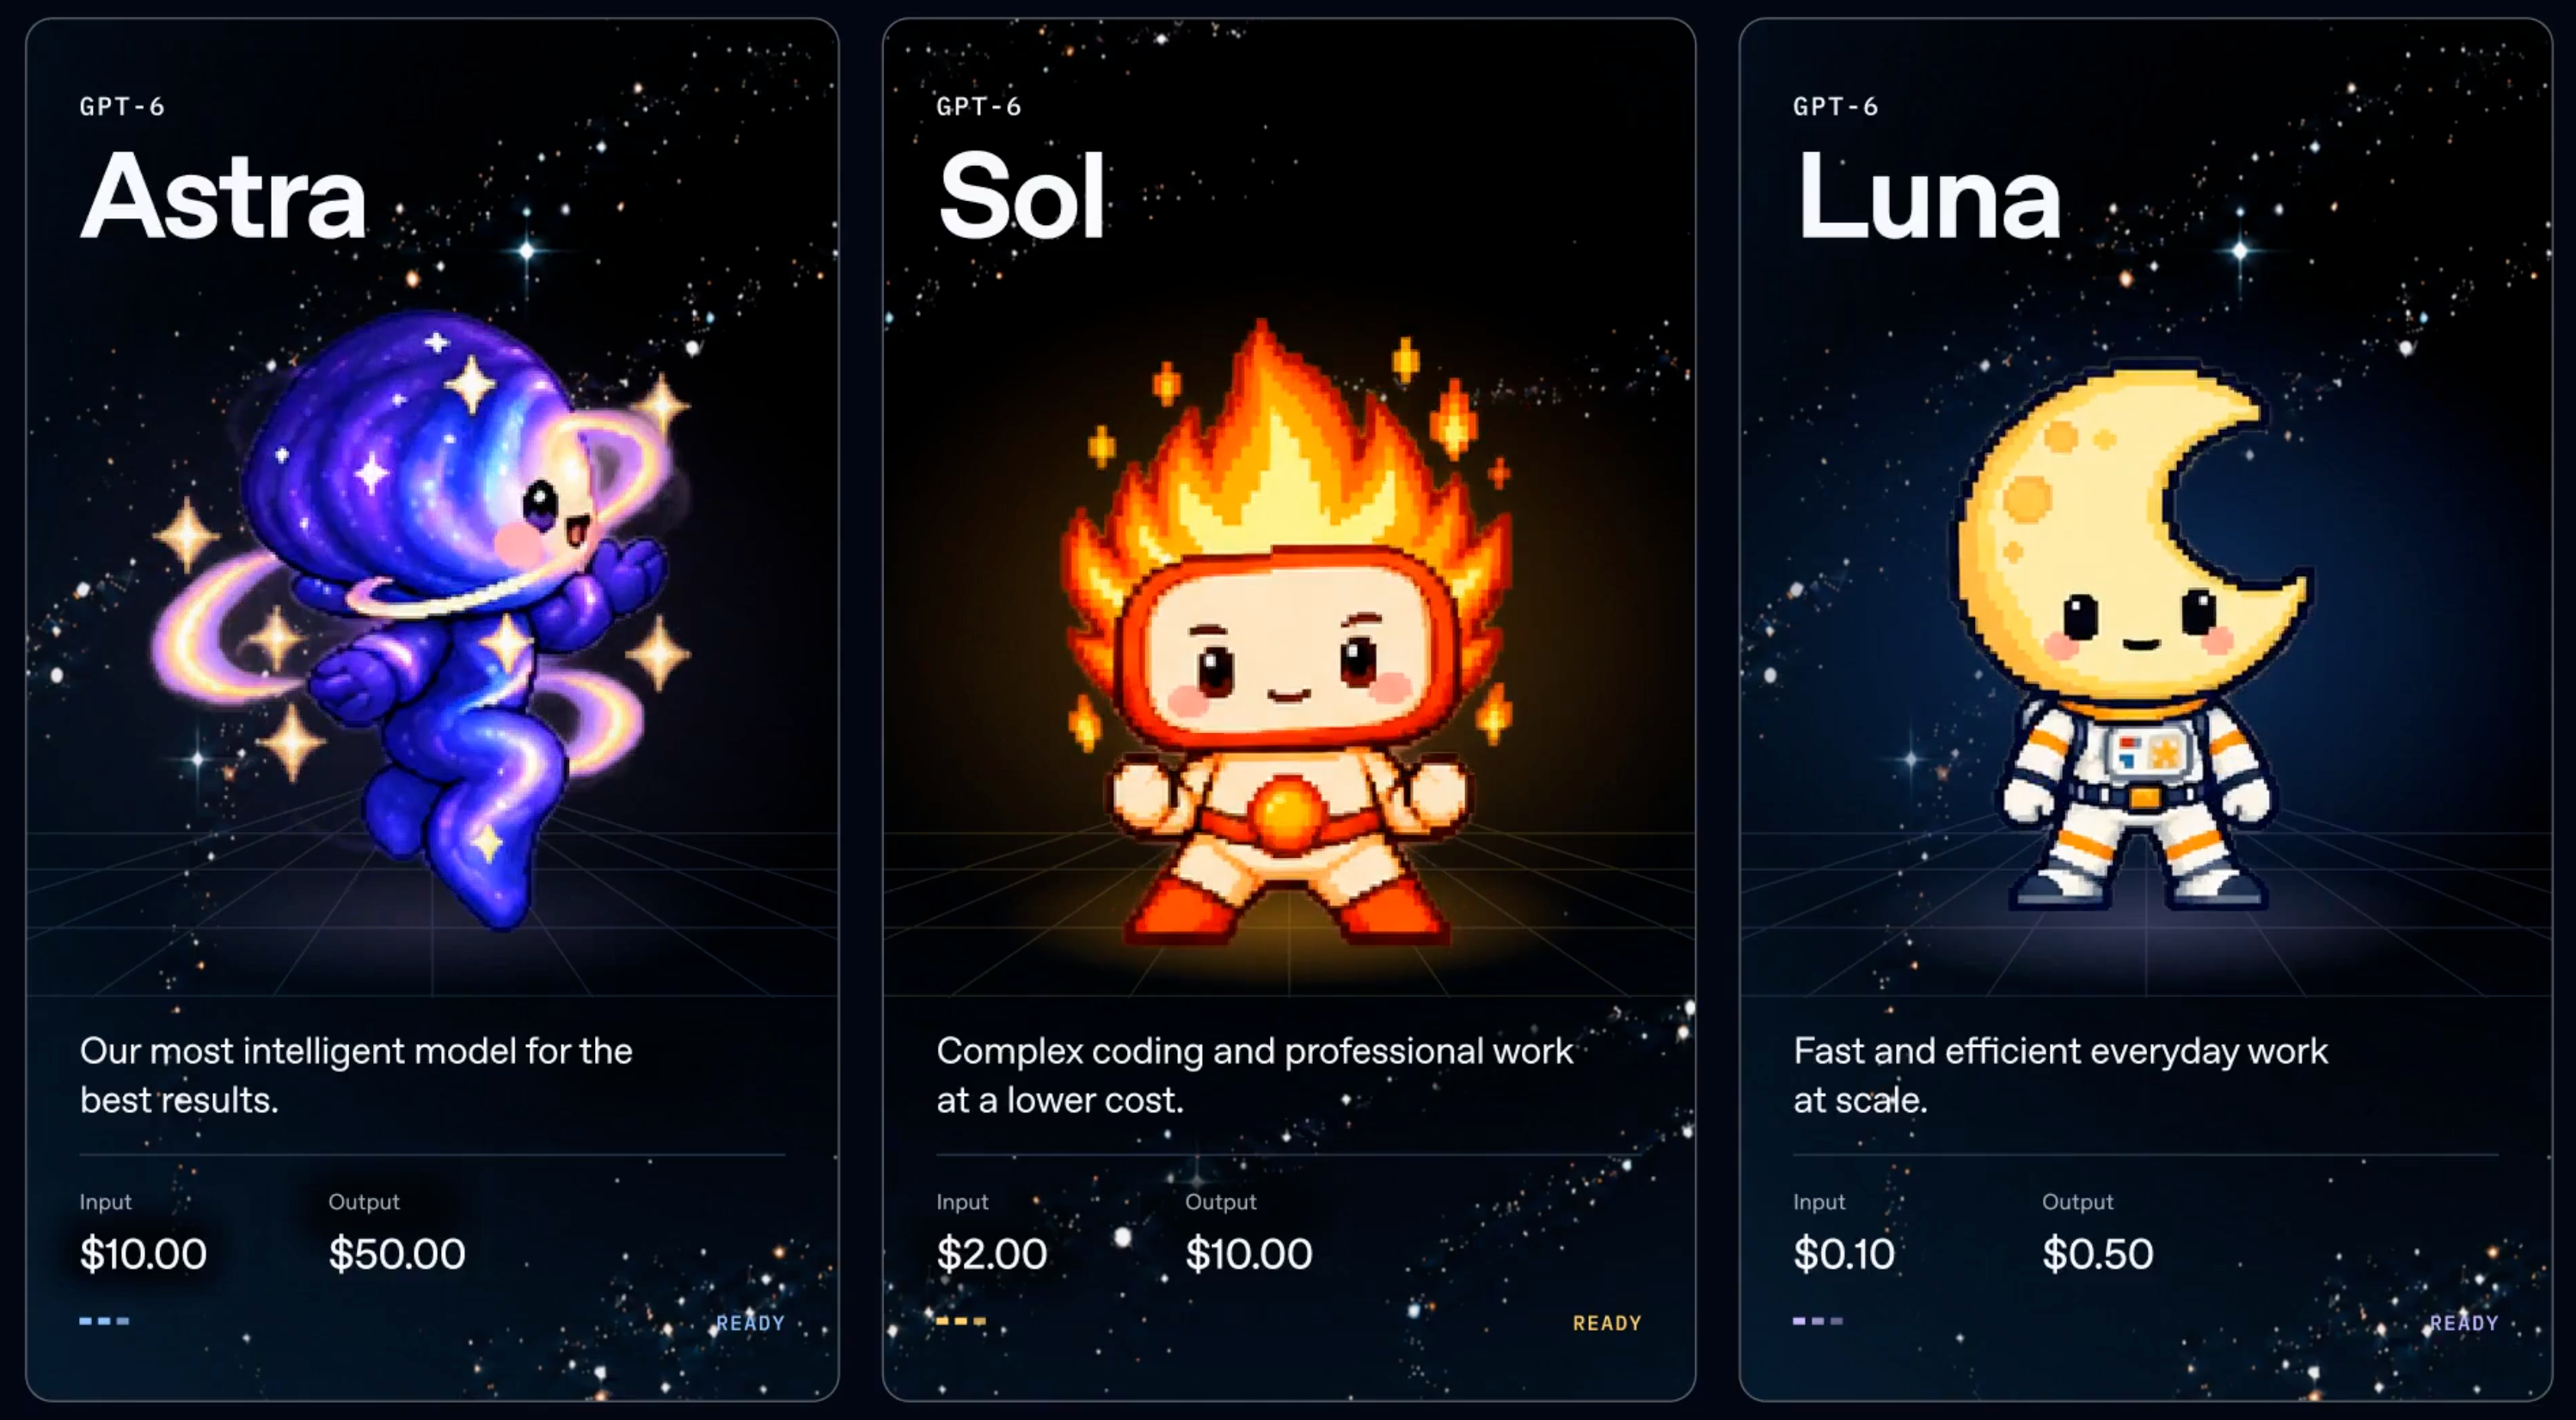
Quanto custa o nível mais barato e qual é o seu desempenho
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| ID da API | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Entrada / saída por 1M | US$ 0,10 / US$ 0,50 | US$ 2 / US$ 10 | US$ 4 / US$ 20 |
| Entrada em cache | 90% de desconto em leituras | 90% de desconto em leituras | US$ 0,20 leitura, US$ 5 gravação |
| Contexto | 1M | 872k | 1M |
| DeepSWE 1.1 com raciocínio máximo | 66,6% | 68,8% | Não consta no material de lançamento |
| Índice da Artificial Analysis | 37 | 48 | 58, primeiro de 212 |
A Anthropic relata 40,0% no AutomationBench para o Opus 5.5. A OpenAI relata 33,2% para o Sol com raciocínio extra-alto no AutomationBench 1.0.6, a US$ 0,27 por tarefa. Dois laboratórios, dois ambientes de teste, um único custo por tarefa publicado. Essa comparação não é direta, e a impossibilidade de torná-la direta é exatamente o ponto: nenhuma tabela de fornecedor informa o custo por alteração aceita.
Primeiro fator oculto: tentativas por alteração aceita
A OpenAI aponta que o Luna com raciocínio máximo atinge 66,6% no DeepSWE 1.1 e o Sol no máximo atinge 68,8%. Pelos nossos próprios cálculos, isso significa que aproximadamente uma a cada três tentativas do Luna não atinge um resultado aprovado. Seu repositório não é o DeepSWE e sua taxa será diferente, mas o padrão se mantém: uma camada econômica com pontuação ligeiramente menor não é apenas um pouco pior por execução; ela tem mais chances de entregar algo que precisará de mais uma rodada.
O impacto financeiro dessa rodada extra continua irrelevante. A OpenAI relata que o Luna no máximo é 93% mais barato por tarefa do que o Claude Opus 5 no mesmo benchmark. Mesmo dobrando as tentativas, novamente pelos nossos cálculos, você ainda estará cerca de 86% mais barato. O custo com modelos nunca chega a ser o problema.
A tentativa com falha não sai de graça em nenhum outro aspecto. Ela gerou uma branch, um resumo das alterações e uma decisão que cabe a uma pessoa tomar. Uma execução que falhou não é um zero a zero. É um item de revisão que não resultou em alteração alguma.
Segundo fator oculto: a camada econômica ganha qualidade pensando por mais tempo
Observe de onde vêm os bons números do Luna. A pontuação de 66,6% ocorre com raciocínio no máximo, e a nota de factualidade da OpenAI indica que o Luna com esforço mais alto iguala o GPT-5.6 Sol por cerca de um centésimo do custo. O nível econômico atinge uma qualidade aceitável exigindo mais esforço — e esse esforço se manifesta em tokens de saída e tempo decorrido.
A Artificial Analysis, uma entidade independente de ambos os fornecedores, mede as variantes com raciocínio máximo em 153,9 tokens de saída por segundo para o Luna, com 124,23 segundos até o primeiro token, e 115,2 tokens por segundo para o Sol, com 102,15 segundos. Considere esses números como indicativos: são dados de terceiros, cobrem especificamente as variantes no nível máximo e variam conforme o laboratório refaz as medições.
Duas consequências recaem sobre a sua equipe, e não sobre a sua fatura. Uma execução em silêncio por dois minutos parece exatamente uma execução travada, levando alguém a verificar o que houve. Além disso, um trace mais longo com um diff maior exige mais leitura, por tentativa, antes que alguém possa aceitá-lo. A leitura é o recurso escasso — e você acabou de comprar mais daquilo que o consome.
Terceiro fator oculto: decisões, não diffs
Conte as decisões humanas entre a atribuição de uma Task e a aprovação de uma alteração. Em um Runtime potente, o caminho habitual é simples: ler e aceitar. Já em um Runtime econômico realizando tarefas não verificáveis, o fluxo se ramifica — e cada ramificação exige uma pessoa:
- A execução falhou. Tentar novamente no mesmo Runtime ou escalar para um mais potente?
- A execução passou nos testes, mas seguiu uma abordagem que você não escolheria. Aceitar ou devolver para correção?
- A execução gerou três resultados parciais. Qual deles é a alteração definitiva?
- A execução parou para fazer uma pergunta. Quem responde e onde essa resposta fica registrada?
Nada disso aparece na fatura de tokens. Tudo isso aparece na agenda de quem é responsável pela revisão humana.
O cálculo, com os seus próprios números
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Preencha a fórmula com os seus números, não com os nossos. A US$ 0,10 e US$ 0,50 por milhão de tokens, o custo do modelo entre parênteses é praticamente nulo, de modo que a expressão é dominada pelos minutos do revisor multiplicados pelas tentativas. Mudar para um Runtime mais barato reduz um item da fatura que já era pequeno e multiplica aquele que não era. Às vezes, isso ainda compensa. Mas nunca é algo que você consiga avaliar apenas pela página de preços.
Quando a camada econômica realmente sai mais barata
Use um Runtime econômico quando uma máquina puder decidir se a tentativa foi bem-sucedida. Checagem de tipos (typecheck), testes unitários, compilação (build), regras de lint, validação de schema: o veredito chega antes que uma pessoa gaste sua atenção, e as tentativas adicionais são absorvidas pelo harness de automação em vez de consumirem a sua sexta-feira. Esse é o maior volume de trabalho de uma Crew ativa e o caso real para direcionar o trabalho rotineiro ao Luna.
Não use um Runtime econômico quando a aprovação exigir julgamento crítico. Decisões de arquitetura, migrações de dados, qualquer aspecto relevante de segurança e qualquer situação em que a pergunta "isso está correto?" não possa ser respondida por um comando. Nesses casos, a diferença de pontuação se converte diretamente em minutos de revisão, e a coisa mais barata que você pode comprar é uma tentativa que só precise ler uma vez.
Documente a regra de escalonamento em vez de deixá-la ao gosto pessoal, pois a preferência sempre perde para um preço mais baixo. O roteamento de modelos é uma regra sobre verificabilidade em primeiro lugar e custo em segundo.
Por que nenhum fornecedor vai lhe contar isso
Ambos os laboratórios divulgaram benchmarks comparativos no mesmo dia, e a base de comparação da OpenAI foi o Claude Opus 5, que a Anthropic substituiu pelo Opus 5.5 horas depois. A camada econômica de cada fornecedor serve como topo de funil próprio. Nenhum deles publicará a frase: "nosso modelo econômico exigirá uma rodada extra de revisão da sua equipe", e nenhum deles está errado em omitir isso: esse número depende da sua base de código e da sua equipe.
A Sharkly não vende tokens de modelos. O uso dos modelos continua ocorrendo por meio das assinaturas ou chaves de API configuradas nas ferramentas que a sua equipe já utiliza, de modo que nada do que foi dito aqui depende de qual Runtime você escolhe. Essa é a única postura a partir da qual esse argumento pode ser feito com integridade, e é o mesmo motivo pelo qual o seu fluxo de trabalho deve resistir ao próximo modelo de baixo custo sem precisar ser reconstruído.
O que colocar no painel de métricas
Minutos humanos por alteração aceita, por Runtime. Se esse número aumentou após a mudança, o modelo mais barato ficou mais caro, e agora você tem a comprovação. Dólares por execução respondem a uma pergunta que deixou de ser determinante em 22/09/2026.
Tentativas por alteração aceita, por Runtime. Esse fator determina todo o resto e nenhum fornecedor pode fornecê-lo a você. Você o obtém registrando qual Runtime gerou cada tentativa, na respectiva Task.
"Aguardando uma pessoa" como um estado real. Execução, impedimentos, resultados e discussões de acompanhamento retornam ao histórico da Task, tornando a fila de itens que precisam de intervenção humana mensurável, e não algo anedótico. Exija que cada execução apresente suas evidências:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Você não precisa de nada disso em pequena escala. Se uma única pessoa opera dois Agents e revisa tudo na mesma tarde, continue assim: estados e filas geram sobrecarga para um problema que você ainda não tem. Esse controle passa a ser essencial quando ninguém mais consegue dizer de memória quantas execuções concluídas estão na fila de espera.
A parte que não ficou mais barata
Dois laboratórios reduziram o preço de uma tentativa no mesmo dia. Nenhum deles lançou nada que analise um diff para você, e a responsabilidade final pela alteração continua cabendo a uma pessoa. Um modelo mais barato não significa um fluxo de trabalho mais barato. Significa apenas uma tentativa mais barata — e as tentativas alimentam um processo cuja etapa mais cara é a humana.
Se você já executa vários agentes de código, a Sharkly oferece um local centralizado para ver qual Runtime gerou cada tentativa, quais evidências foram anexadas e quanto trabalho está aguardando revisão humana neste exato momento.