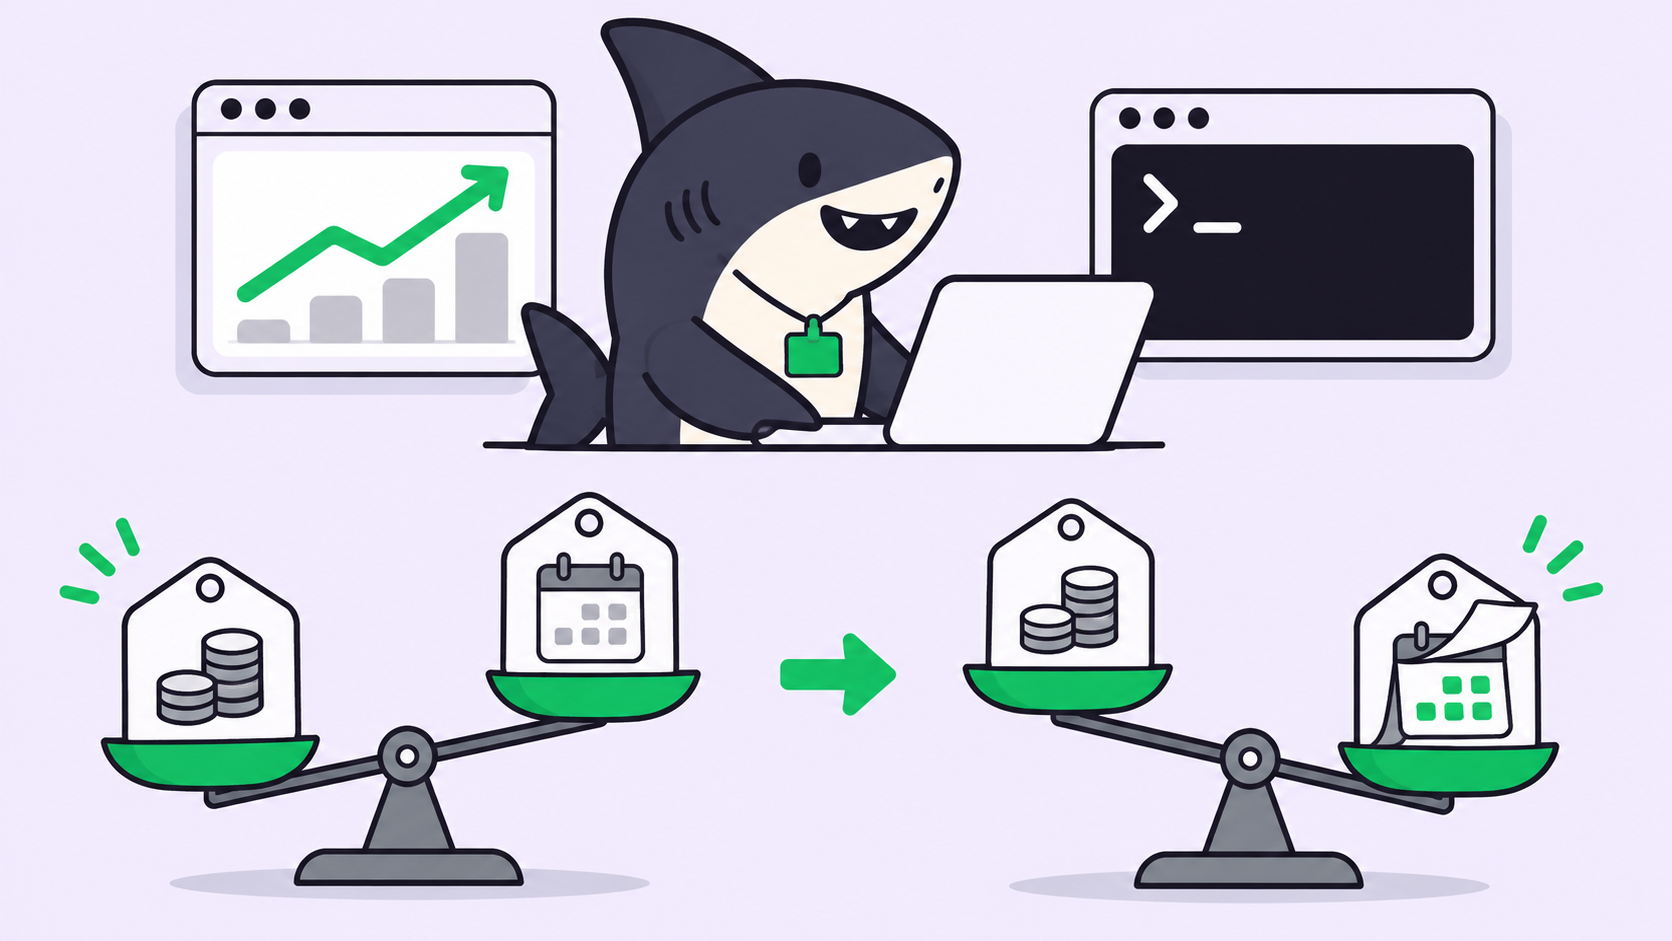
ต้นทุนต่องานของ Gemini 4 Neon ขึ้นอยู่กับมากกว่าแค่ราคา $3 / $15 ต่อโทเคน 1 ล้านตัว Google ระบุว่า Neon ที่ระดับการคิด high ซึ่งเป็นค่าเริ่มต้น มีต้นทุนต่องานถูกกว่า Gemini 4 Carbon ถึง 32% คิดเป็นราคาต่อโทเคนแล้ว Neon แพงกว่าอัตราเปิดตัวของ Carbon อยู่ 50% และถูกกว่าอัตราของ Carbon ตั้งแต่วันที่ 1 ธันวาคม 2026 อยู่ 25% ว่าแบบไหนจะถูกกว่าสำหรับเอเจนต์ของคุณ ขึ้นอยู่กับจำนวนโทเคนต่องาน และจำนวนครั้งที่ทีมของคุณยอมรับได้
TL;DR
- ราคาหน้าปก Neon: $3 ต่อโทเคนอินพุต 1 ล้านตัว, $15 ต่อโทเคนเอาต์พุต 1 ล้านตัว (รวมการคิด), $0.15 ต่ออินพุตที่แคช 1 ล้านตัว มีเฉพาะชั้นแบบจ่ายเงิน
- ราคาหน้าปก Carbon: $2 / $10 จนถึงวันที่ 30 พฤศจิกายน 2026 จากนั้นเป็น $4 / $20 ตั้งแต่วันที่ 1 ธันวาคม
- ข้ออ้างของ Google: ต้นทุนต่องานถูกกว่า Carbon 32% ที่ระดับ
highอ้างอิงจากกราฟ Artificial Analysis Intelligence Index โพสต์ไม่ได้ระบุว่ากราฟใช้ราคา Carbon แบบไหน - สิ่งที่หมายความว่า: Neon จะเอาชนะราคาเปิดตัวของ Carbon ได้ก็ต่อเมื่อทำงานเดียวกันเสร็จด้วยโทเคนน้อยกว่าสองในสามของ Carbon หลังวันที่ 1 ธันวาคม Neon จะชนะ เว้นแต่มันใช้โทเคนมากกว่า Carbon ถึงหนึ่งในสาม
- สิ่งที่ควรวัด: ต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ ไม่ใช่ต้นทุนต่อความพยายาม
ราคา Gemini 4 Neon เทียบกับ Carbon และ Hydrogen
Gemini 4 Neon คือโมเดลระดับกลางของตระกูล Gemini 4 ของ Google เปิดตัวเมื่อวันที่ 18 พฤศจิกายน 2026 ในชื่อ gemini-4-neon Model card ระบุว่ามันพัฒนาต่อยอดจาก Carbon และถูกออกแบบให้สมดุลระหว่าง “ความลึกและประสิทธิภาพ” นี่คืออัตรามาตรฐานของชั้นแบบจ่ายเงินต่อโทเคน 1 ล้านตัว จากหน้าราคา Gemini API:
| Model | Input | Output (incl. thinking) | Cached input | Batch input / output | Free tier |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | No |
| Gemini 4 Carbon, through Nov 30 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | No |
| Gemini 4 Carbon, from Dec 1 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | No |
| Gemini 4 Hydrogen (paid tier) | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Yes |
ทั้งสามตัวใช้ implicit caching เท่านั้น คู่มือ AI Studio ของ Neon ระบุว่า implicit caching เริ่มทำงานกับพรอมต์ที่มีอย่างน้อย 4,096 โทเคน และลดค่าอินพุตที่แคชลง 95% Neon ไม่มี explicit caching ดังนั้นให้ลบฟิลด์ cached_content ออกเมื่อย้ายงานที่ตั้งค่าไว้บน Carbon มาใช้
Google คิดค่าใช้จ่ายจาก “ทุกโทเคนที่โมเดลประมวลผล รวมถึง thinking tokens, คำสั่งของระบบ internal grounding และ function declarations” สำหรับเอเจนต์ที่ใช้เครื่องมือเยอะ declaration เหล่านี้จะถูกส่งไปทุกเทิร์น
Google วัดต้นทุนต่องานของ Neon อย่างไร
ต้นทุนต่องาน คือค่าใช้จ่ายรวมที่โมเดลใช้เพื่อทำงานเบนช์มาร์กหนึ่งงานให้เสร็จ คือจำนวนโทเคนที่ใช้คูณด้วยราคา โพสต์เปิดตัว ของ Google ระบุว่าที่ระดับ high Neon “มีคะแนน Artificial Analysis Intelligence Index สูงควบคู่กับต้นทุนต่องานที่ต่ำกว่า Carbon 32%” กราฟมีป้ายกำกับว่า “AA Index v5.01 cost per task”
Artificial Analysis เป็นบุคคลที่สาม ไม่ใช่ Google โพสต์ให้ข้ออ้างเรื่องต้นทุนอีกสองข้อ และไม่มีข้อไหนเกี่ยวกับ Carbon เลย:
- Neon ทำงานด้วย “ต้นทุนต่องานที่ต่ำกว่าโมเดล frontier ชั้นนำคู่แข่งประมาณ 50% ถึง 80%” โดยไม่ระบุชื่อคู่แข่ง
- ที่ระดับ
xhighNeon ยังมีต้นทุน “ต่ำกว่า 36%+ ต่องานเมื่อเทียบกับโมเดลคู่แข่งที่ตั้งค่าสูงสุด”
โพสต์ไม่ได้เผยแพร่จำนวนโทเคนหรือราคา Carbon ที่อยู่เบื้องหลังตัวเลข 32% ช่องว่างนี้สำคัญมากกว่าปกติ เพราะราคาของ Carbon จะเพิ่มเป็นสองเท่าในไม่ถึงสองสัปดาห์หลังจาก Neon เปิดตัว
Gemini 4 Neon ถูกกว่า Carbon หรือไม่? ขึ้นอยู่กับวันที่
คิดต่อโทเคนแล้ว Neon อยู่ระหว่างราคาทั้งสองของ Carbon: คือ 1.5 เท่าของอัตราเปิดตัว และ 0.75 เท่าของอัตราเดือนธันวาคม ดังนั้นตัวเลข 32% จึงมาได้จากการที่ Neon ใช้โทเคนต่องานน้อยกว่าเท่านั้น ลองคำนวณข้ออ้างนี้ทั้งสองทาง:
| If Google’s chart priced Carbon at | Implied Neon tokens vs Carbon | Neon vs Carbon through Nov 30 | Neon vs Carbon from Dec 1 |
|---|---|---|---|
| $2 / $10 (intro) | ประมาณ 45% | ถูกกว่า 32% | ถูกกว่าประมาณ 66% |
| $4 / $20 (December) | ประมาณ 91% | แพงกว่าประมาณ 36% | ถูกกว่า 32% |
ทั้งสองแถวสันนิษฐานว่าโมเดลทั้งสองแบ่งสัดส่วนโทเคนอินพุตและเอาต์พุตในอัตราเดียวกัน ซึ่งเป็นการทำให้ง่ายขึ้น ไม่ทางใดก็ทางหนึ่ง ตั้งแต่วันที่ 1 ธันวาคม Neon ถูกกว่าต่องานตามตัวเลขของ Google เอง ส่วนก่อนวันที่ 30 พฤศจิกายน คำตอบขึ้นอยู่กับรายละเอียดที่ Google ไม่ได้เผยแพร่
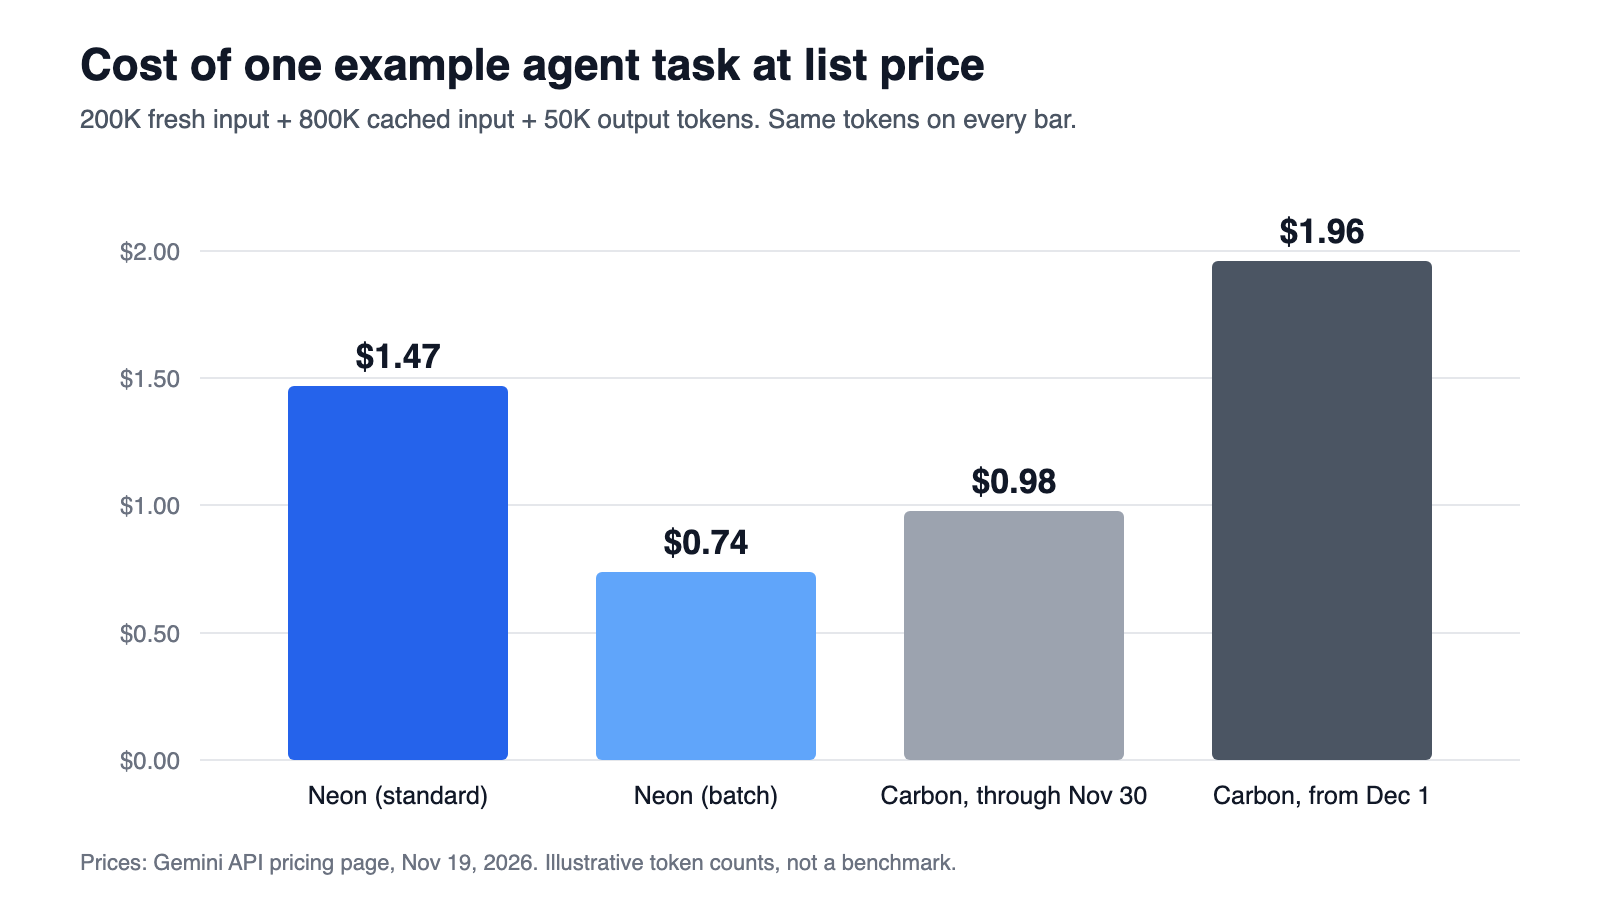
งานเอเจนต์หนึ่งงานมีค่าใช้จ่ายเท่าไรที่ราคาหน้าปก
นี่คือตัวอย่างการคำนวณด้วยตัวเลขง่าย ๆ ไม่ใช่เบนช์มาร์ก ลองนึกภาพเซสชันเอเจนต์เขียนโค้ดที่ส่งอินพุตโทเคนสด 200K ได้ cache hits 800K โทเคนจากการอ่านซ้ำ repository และสร้างเอาต์พุต 50K โทเคนรวมการคิด
| Model | Fresh input | Cached input | Output | Total |
|---|---|---|---|---|
| Neon (standard) | $0.60 | $0.12 | $0.75 | $1.47 |
| Neon (batch) | $0.30 | $0.06 | $0.375 | $0.74 |
| Carbon, through Nov 30 | $0.40 | $0.08 | $0.50 | $0.98 |
| Carbon, from Dec 1 | $0.80 | $0.16 | $1.00 | $1.96 |
ที่จำนวนโทเคนเท่ากัน Neon แพ้ราคาเปิดตัวของ Carbon และชนะราคาเดือนธันวาคม กฎจุดคุ้มทุนง่าย ๆ คือ เทียบกับราคาเปิดตัว Neon ต้องทำงานเสร็จด้วยโทเคนน้อยกว่า 67% ของ Carbon เทียบกับราคาเดือนธันวาคม Neon จะยังถูกกว่าอยู่ เว้นแต่ต้องใช้โทเคนมากกว่า 133% ของ Carbon
ในตัวอย่างนี้เอาต์พุตคิดเป็นครึ่งหนึ่งของบิลของ Neon และ thinking tokens คิดค่าใช้จ่ายเป็นเอาต์พุต นี่คือเหตุผลที่ระดับการคิดที่คุณเลือกมีผลต่อต้นทุนมากกว่าราคาหน้าปก
ระดับการคิด: ปุ่มปรับที่อยู่เบื้องหลังต้นทุนต่องานของ Neon
Neon รองรับระดับการคิดสี่ระดับ: low, medium, high (ค่าเริ่มต้น) และ xhigh คู่มือของ Google พูดตรง ๆ เรื่องการแลกเปลี่ยนนี้: xhigh “เพิ่ม latency และการใช้โทเคน” และคุณควร “เลือก thinking_level ที่ต่ำที่สุดที่ตอบโจทย์มาตรฐานคุณภาพของคุณ”
แนวทางการเลือกใช้ที่ใช้ได้จริงสำหรับงานเอเจนต์มีลักษณะดังนี้:
low: คำถามเกี่ยวกับ codebase, สรุป diff, โน้ตการคัดกรองmedium: การแก้ไขที่มีขอบเขตชัดเจน โดยที่ชุดทดสอบคือผู้ตัดสินจริงhigh: การ refactor, การ debug และเซสชัน tool call ยาว ๆ นี่คือจุดที่ข้ออ้าง 32% ของ Google ใช้ได้xhigh: เฉพาะงานที่ตรวจสอบไม่ผ่านที่ระดับhighแล้วเท่านั้น
ตั้งค่าต่อคำขอในโค้ด:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon ปฏิเสธระดับ minimal เดิมด้วยข้อผิดพลาด และไม่สนใจ temperature, top_p และ top_k Google ยังแนะนำให้ตั้ง client timeout อย่างน้อย 15 นาทีสำหรับพรอมต์ที่ยาก ซึ่งการรันเอเจนต์นาน ๆ มักเจอเป็นอย่างแรก
ทำไมต้นทุนต่องานยังไม่ใช่ตัวเลขของคุณ
งานเบนช์มาร์กจบลงเมื่อผู้ให้คะแนนให้คะแนนเสร็จ ส่วนงานของคุณจบเมื่อมีคน merge การเปลี่ยนแปลงนั้น การ retry, diff ที่ถูกปฏิเสธ และเวลาการตรวจสอบ อยู่ระหว่างสองจุดนั้น และไม่มีกราฟต้นทุนต่องานไหนแสดงสิ่งเหล่านี้
ตัวเลขที่ตรงกับงบประมาณของคุณคือต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ: ค่าใช้จ่ายโมเดลรวมในงานหนึ่งงาน รวมทุกความพยายาม หารด้วยจำนวนการเปลี่ยนแปลงที่คุณส่งมอบ เราได้นำเสนอข้อโต้แย้งฉบับเต็มไว้ในเมื่อโมเดลที่ถูกกว่ากลับแพงกว่า สรุปสั้น ๆ คือ:
cost per accepted change = cost per attempt / acceptance rate
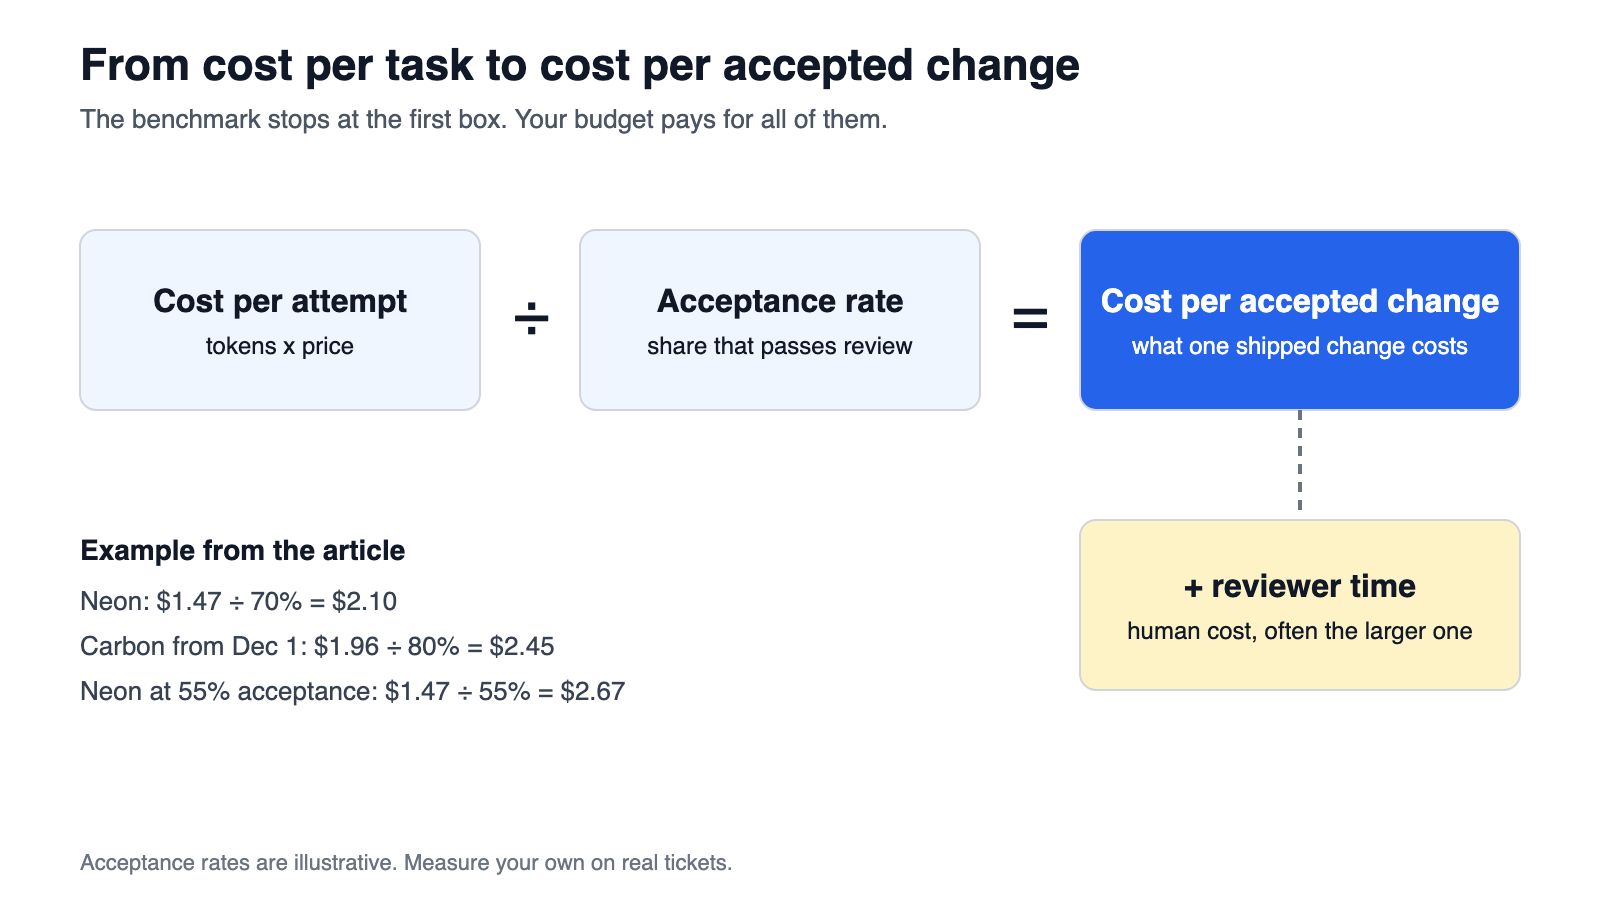
ลองใช้ตัวอย่างจากด้านบน ถ้า Neon ผ่านการตรวจสอบในความพยายามครั้งแรก 70% $1.47 ต่อความพยายามจะกลายเป็น $2.10 ต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ ถ้า Carbon ที่ราคาเดือนธันวาคมผ่าน 80% $1.96 จะกลายเป็น $2.45 Neon ยังชนะอยู่ แต่ถ้าอัตราการยอมรับของ Neon ตกไปที่ 55% มันจะมีค่าใช้จ่าย $2.67 ต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ และ Carbon จะชนะ อัตราการยอมรับของคุณ ไม่ใช่กราฟของ Google ตัดสินเส้นทางนี้
เวลาของผู้ตรวจสอบอยู่นอกสูตรนี้ และมักมีค่าใช้จ่ายมากกว่าโทเคนเสียอีก การตรวจสอบโดยมนุษย์เป็นคอขวด สำหรับเอเจนต์แบบขนาน ดังนั้นการลดจำนวน diff ที่ถูกปฏิเสธช่วยประหยัดส่วนที่แพงที่สุด
วิธีทดสอบ Neon เทียบกับ Carbon ด้วยงานของคุณเอง
คุณไม่จำเป็นต้องมีเบนช์มาร์กใหม่ คุณต้องมีตั๋วงานจริงสองสัปดาห์ และวิธีบอกว่าโมเดลไหนทำอะไร Sharkly ให้บอร์ดสำหรับสิ่งนี้กับคุณ: งานแต่ละงานเก็บการรันของเอเจนต์ ผลลัพธ์ และสถานะการตรวจสอบไว้ในที่เดียว
- เลือกงานธรรมดา 20 ถึง 30 งานจาก backlog ของคุณ: แก้บั๊ก, refactor เล็ก ๆ, เพิ่มการทดสอบ
- สร้าง Agents สองตัว Sharkly Agent ตามโมเดลเริ่มต้นของ Runtime และไม่มีตัวเลือกโมเดล ตามเอกสาร Agents ดังนั้นให้ชี้แต่ละ Agent ไปที่ Runtime ที่ตั้งค่าไว้สำหรับโมเดลต่างกัน: หนึ่งตัวบน
gemini-4-neonอีกหนึ่งตัวบนgemini-4-carbon - แบ่งงานระหว่าง Agent ทั้งสองโดยให้ความยากใกล้เคียงกันทั้งสองฝั่ง
- บันทึกสามตัวเลขต่องาน: โทเคนจากการใช้งาน Gemini API ของคุณ จำนวนความพยายามจนถึงการยอมรับ และนาทีของผู้ตรวจสอบ
- คำนวณต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับสำหรับแต่ละโมเดล ที่ราคา Carbon ทั้งสองแบบ ถ้าการทดสอบของคุณคร่อมวันที่ 1 ธันวาคม
Sharkly ไม่ขายโทเคนโมเดล การรันของคุณคิดค่าใช้จ่ายผ่าน Gemini API key ที่ตั้งค่าไว้แล้วบน Runtime ทำให้การเปรียบเทียบยุติธรรม: ไม่มีอะไรในแพลตฟอร์มบิดราคาเข้าข้างโมเดลใดโมเดลหนึ่ง สำหรับภาพรวมที่ใหญ่ขึ้น ดูทำไมแพลตฟอร์มเอเจนต์ไม่ควรขายโทเคนให้คุณ และการติดตามค่าใช้จ่ายระหว่าง Claude Code, Codex และ Gemini
Neon, Carbon และ Hydrogen เหมาะกับงานแบบไหน
Model card ของ Google วาง Carbon ไว้สำหรับ “โปรเจกต์ที่ยากที่สุดและมีมุมมองระยะยาว” และ Hydrogen สำหรับ “งานประจำวันที่รวดเร็ว” โดยมี Neon อยู่ระหว่างนั้น ในแง่ต้นทุน ทีมเอเจนต์จึงมีสามเลน:
- Hydrogen ที่ $1.50 / $7.50 สำหรับงานปริมาณสูง ความเสี่ยงต่ำ ดูGemini 4 Hydrogen สำหรับ coding agents
- Neon ที่ระดับ
highเป็นเลนเริ่มต้นสำหรับตั๋วงานซับซ้อน และเป็นหัวหน้าที่กำกับ Hydrogen subagents แบบขนาน - Carbon สำหรับงานระยะยาวที่ Neon ทำไม่ได้แม้อยู่ที่
xhighรีวิว Carbon ของเราครอบคลุมว่ามันคุ้มราคาตรงไหน
คู่มือจับคู่ Carbon และ Hydrogen แสดงบอร์ดแบบ planner-and-workers ตั้งแต่วันที่ 1 ธันวาคม Neon รับตำแหน่ง planner ได้ในราคาที่ถูกกว่า สำหรับการกำหนดเส้นทางข้ามผู้ให้บริการ ดูการ routing โมเดลสำหรับทีมเอเจนต์
บทสรุป
ตั้งแต่วันที่ 1 ธันวาคมเป็นต้นไป Gemini 4 Neon ถูกกว่า Carbon ต่องาน ไม่ว่าจะตีความตัวเลขของ Google อย่างไร ก่อนวันนั้น มันขึ้นอยู่กับว่าราคา Carbon แบบไหนอยู่เบื้องหลังกราฟ 32% ซึ่ง Google ไม่ได้บอก และอย่างไรก็ตามราคาหน้าปกไม่เคยเป็นตัวเลขชี้ขาดอยู่แล้ว: โทเคนต่องาน ระดับการคิด และอัตราการยอมรับ ต่างหากที่เป็นตัวชี้ขาด
ลองทดสอบสองสัปดาห์กับ backlog ของคุณเอง และคิดราคาทั้งสองโมเดลต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ ถ้าคุณรัน coding agents หลายตัวอยู่แล้ว Sharkly ให้บอร์ดเดียวสำหรับมอบหมายงาน เปรียบเทียบผลลัพธ์ของ Agents และรวมการตรวจสอบไว้ในคิวเดียว เอกสาร Sharkly อธิบายการเชื่อมต่อ Computer และการสร้าง Agents
FAQ
Gemini 4 Neon ราคาเท่าไร?
$3 ต่อโทเคนอินพุต 1 ล้านตัว, $15 ต่อโทเคนเอาต์พุต 1 ล้านตัวรวมการคิด และ $0.15 ต่อโทเคนอินพุตที่แคช 1 ล้านตัว บนชั้นแบบจ่ายเงินของ Gemini API Batch และ Flex ลดเหลือครึ่งหนึ่งเป็น $1.50 / $7.50 ไม่มีชั้น API ฟรี
Gemini 4 Neon ถูกกว่า Gemini 4 Carbon หรือไม่?
ต่อโทเคน ไม่ จนถึงวันที่ 30 พฤศจิกายน ($3 / $15 เทียบกับ $2 / $10) และใช่ ตั้งแต่วันที่ 1 ธันวาคม ($3 / $15 เทียบกับ $4 / $20) ต่องาน Google รายงานว่า Neon ที่ระดับ high ถูกกว่า Carbon 32% โดยไม่ได้เผยแพร่ว่าใช้ราคา Carbon แบบไหน
Gemini 4 Neon มีชั้นฟรีหรือไม่?
ไม่มี หน้าราคาระบุ “Not available” สำหรับชั้นฟรีของ Neon ในทุกระดับบริการ ส่วน Gemini 4 Hydrogen มี
Gemini 4 Neon คิดค่าใช้จ่าย thinking tokens หรือไม่?
ใช่ Google คิดค่าใช้จ่าย thinking tokens ที่อัตราเอาต์พุต $15 ต่อ 1 ล้านโทเคน พร้อมกับ function declarations และคำสั่งของระบบ grounding การลด thinking_level คือวิธีหลักในการตัดโทเคน
ระดับการคิดแบบไหนถูกที่สุดสำหรับ coding agents?
low ใช้โทเคนน้อยที่สุด และ xhigh มากที่สุด Google แนะนำให้ทดสอบทั้งสี่ระดับบนชุดประเมินผลของคุณ และเลือกระดับต่ำสุดที่ตอบโจทย์มาตรฐานคุณภาพของคุณ เริ่มที่ high สำหรับการเปลี่ยนแปลงโค้ดที่ซับซ้อน
ราคา Gemini 4 Carbon จะขึ้นเมื่อไร?
วันที่ 1 ธันวาคม 2026 อินพุตเปลี่ยนจาก $2 เป็น $4 ต่อโทเคน 1 ล้านตัว และเอาต์พุตจาก $10 เป็น $20 ตามหน้าราคา Gemini API