
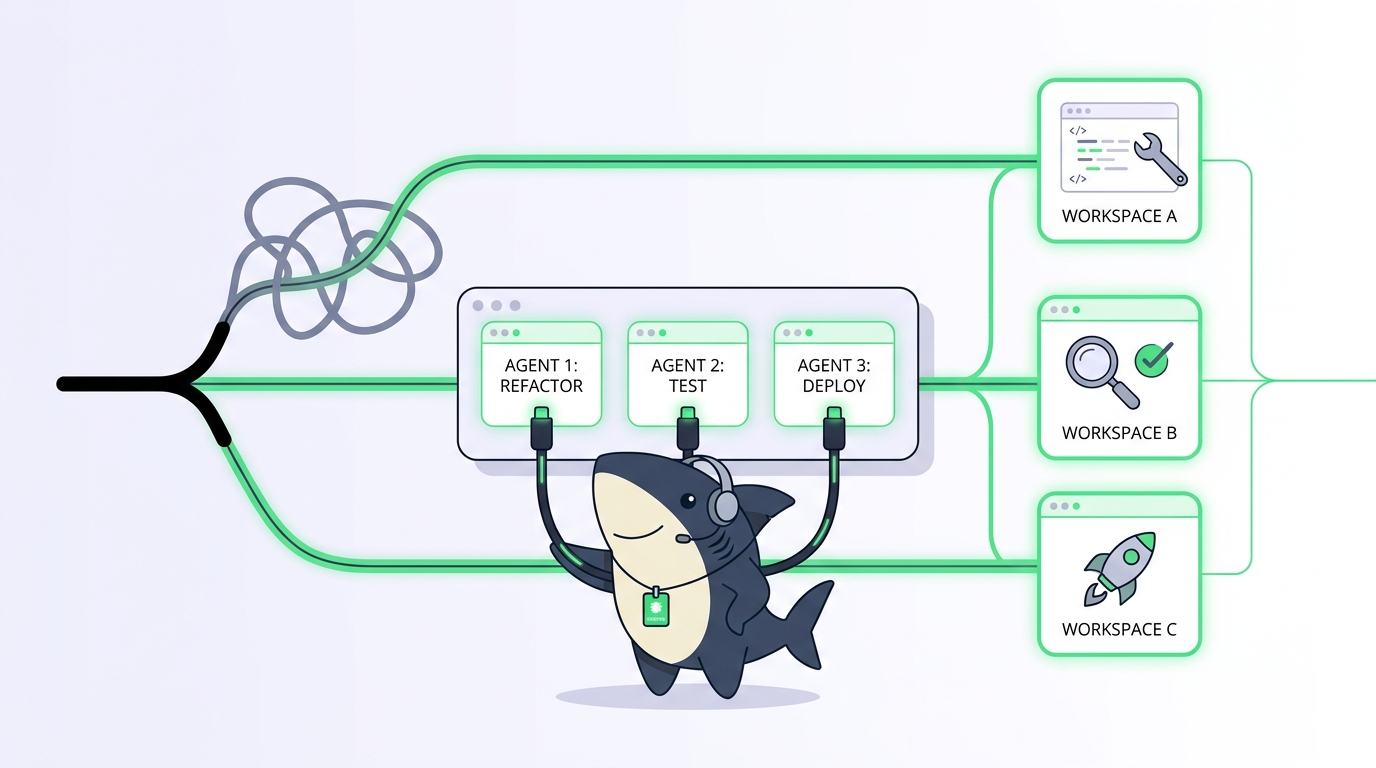
ถ้าให้ AI coding agent สองตัวทำงานบน checkout เดียวกัน สักวันหนึ่งคุณจะเสียเวลาทั้งบ่ายไปกับมัน ตัวหนึ่งเขียนทับไฟล์ที่อีกตัวกำลังแก้อยู่ อีกตัวสลับ branch ใต้เท้าอีกตัว ทั้งคู่รัน npm install ใส่ node_modules ก้อนเดียวกัน แล้วทิ้ง lockfile ที่ไม่มีใครเขียนไว้ให้คุณ ความพังนี้เงียบจนกว่ามันจะไม่เงียบ และตอนนั้นคุณต้องมานั่ง bisect ความเละที่ไม่มี agent ตัวไหนอธิบายได้
Git worktree คือทางแก้มาตรฐาน worktree ให้ agent แต่ละตัวมี working directory ของตัวเองและมี branch ที่ checkout ไว้ของตัวเอง บน repository ที่แชร์กันหนึ่งตัว งานคู่ขนานจึงเลิกชนกัน บทความนี้จะพาไล่คำสั่งจริง กับดักที่เจอในทางปฏิบัติ และวินัยในการเก็บกวาดที่ไม่มีใครบอกคุณ จากนั้นจะชี้ให้เห็นว่าสคริปต์ worktree ที่เขียนเองเริ่มไปไม่รอดตรงไหน และ Sharkly รันทุก Task ใน worktree ของตัวเองโดยอัตโนมัติได้อย่างไร ผลลัพธ์จึงกลับไปรวมที่บันทึกเดียวกันแทนที่จะกระจัดกระจายไปตาม terminal ต่างๆ
ถ้าคุณใช้ agent แค่ตัวเดียว ยังไม่ต้องสนใจเรื่องพวกนี้ แต่พอใช้สองตัวเมื่อไหร่ การแยกออกจากกันก็เลิกเป็นทางเลือกทันที
สรุปสั้นๆ
git worktree คือ working directory ที่สองที่ผูกกับ repository เดียวกัน โดยมี branch และ index ของตัวเอง ให้ AI coding agent แต่ละตัวมี worktree ของตัวเอง แล้วพวกมันจะแก้ไข build และทดสอบแบบคู่ขนานได้โดยไม่เขียนทับกันหรือแย่ง current branch คำสั่งนั้นง่าย แต่ต้นทุนการดำเนินงาน (การติดตั้งต่อ worktree, การเก็บกวาด, เนื้อที่ดิสก์, การประสานงาน) ต่างหากที่โตขึ้น Sharkly จัดการต้นทุนนี้โดยเตรียม worktree ที่แยกออกจากกันให้ทุก Task โดยอัตโนมัติ และส่งผลลัพธ์แต่ละรายการกลับไปที่ Task เพื่อให้ตรวจสอบ
ทำไม checkout เดียวจึงรองรับ agent สองตัวไม่ได้
git checkout ปกติมี working directory หนึ่งอัน index หนึ่งอัน และ HEAD หนึ่งอัน ซึ่งโอเคสำหรับคนหนึ่งคนที่ทำสิ่งหนึ่ง แต่พอมี agent สองตัวทำงานพร้อมกันมันก็พังทันที เพราะทั้งสามอย่างนั้นเป็น state ที่แชร์กัน
ลองนึกภาพ agent สองตัวบน repo เดียวกัน Agent A กำลัง refactor โมดูล auth อยู่บน branch ชื่อ auth-refactor ส่วน Agent B ได้รับมอบหมายให้แก้บั๊ก logging แล้วรัน git checkout -b fix-logging คำสั่งเดียวนั้นย้าย HEAD ของทั้ง checkout ความเปลี่ยนแปลงที่ยังไม่ commit ของ Agent A ตอนนี้ไปอยู่บน branch ผิด commit ถัดไปของมันก็ไปลงผิดที่ และ build ของมันก็เริ่มพังด้วยเหตุผลที่มันจะใช้เวลา 20 นาทีเพื่อ "ดีบั๊ก" ไม่มีอะไรแครชเลย state แค่ค่อยๆ เพี้ยนไปอย่างเงียบๆ
ยิ่งแย่ลงเมื่อพูดถึงไฟล์ เพราะ agent ทั้งสองแชร์ working directory เดียวกัน พอ Agent B สร้างไฟล์ config ใหม่หรือรัน formatter ใหม่ การแก้ไขที่เปิดค้างไว้ของ Agent A ก็ถูกทับบนดิสก์ coding agent ไม่ได้ถือแบบจำลองในหัวว่า "อีกตัวกำลังทำอะไรอยู่" มันอ่านไฟล์ ลงมือ แล้วเขียนกลับ นักเขียนสองคน ไฟล์เดียว ไม่มี lock คุณจะได้ปัญหา lost update สุดคลาสสิก เพียงแต่คราวนี้นักเขียนเป็นอัตโนมัติและเร็วมาก
นี่คือความเจ็บปวดที่คำค้น "git worktrees" ผุดขึ้นมาเรื่อยๆ คนไม่ได้ค้นหา worktree เพราะการ branching น่าสนใจ เขาค้นเพราะเขาลองรัน agent แบบคู่ขนานแล้วเจ็บตัว ถ้าคุณเป็นแบบนั้น ฝั่งการทำงานคู่ขนานมีอธิบายละเอียดไว้ในคู่มือของเราเรื่อง การรัน Claude Code agent หลายตัวพร้อมกัน ส่วนบทความนี้คือ primitive ของการแยกออกจากกันที่รองรับมันอยู่ข้างล่าง
git worktree จริงๆ แล้วคืออะไร
นี่คือคำนิยามฉบับที่ควรจดจำ:
git worktree คือ working directory เพิ่มเติมที่เชื่อมกับ repository เดียวกัน โดยมี branch index และ HEAD ที่ checkout ไว้ของตัวเอง และใช้ object database ร่วมกันหนึ่งชุด
วลีท้ายนั่นแหละคือเคล็ดลับทั้งหมด worktree ไม่ใช่ clone clone จะทำสำเนา object store ทั้งก้อน ทุก commit ทุก blob ทุก tag ถูกคัดลอกไปยัง .git อีกอันหนึ่ง ส่วน worktree แชร์ object store เดียวและเพิ่มแค่ working directory อันที่สองที่เบาๆ commit ของคุณมองเห็นได้จากทุก worktree ทันทีที่มันเข้ามา เพราะข้างล่างมีประวัติแค่ชุดเดียว สิ่งที่ต่างกันในแต่ละ worktree คือ checkout ว่า branch ไหนถูกดึงออกมา อะไรอยู่ใน staging และอะไรยังค้างอยู่บนดิสก์
สำหรับ agent สิ่งนี้เข้าคู่กับปัญหาได้พอดี Agent แต่ละตัวได้ worktree หนึ่งอัน แต่ละ worktree มี branch และไฟล์ของตัวเอง พวกมันเขียนทับกันไม่ได้เพราะอยู่คนละ directory จริงๆ และดึง branch ใต้เท้ากันไม่ได้เพราะแต่ละ worktree ตรึง HEAD ของตัวเองไว้ ความขัดแย้งย้ายไปอยู่ที่ที่มันควรอยู่ คือตอน merge อย่างตั้งใจ ภายใต้การตรวจสอบ แทนที่จะเกิดกลางการแก้ไขโดยอุบัติเหตุ
คำสั่ง worktree ที่คุณจะได้ใช้จริง
เริ่มจาก repository ปกติ ทุกคำสั่งด้านล่างรันจากข้างในนั้น
สร้าง worktree พร้อม branch ใหม่ อันนี้คืออันที่คุณจะใช้บ่อยที่สุด:
git worktree add -b fix-logging ../myproject-fix-logging main
คำสั่งนี้สร้าง directory ที่ ../myproject-fix-logging สร้าง branch ใหม่ชื่อ fix-logging เริ่มจาก main และ checkout ที่นั่น ชี้ agent ไปที่ directory นั้น แล้วมันก็มีที่ทำงานที่สะอาดและแยกออกจากกัน
สร้าง worktree สำหรับ branch ที่มีอยู่แล้ว:
git worktree add ../myproject-auth auth-refactor
ดูรายการที่เปิดอยู่:
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
บรรทัดละหนึ่ง worktree พร้อม path, commit ที่ checkout อยู่ และ branch เมื่อคุณรัน agent เป็นฝูง รายการนี้คือความจริงอ้างอิงว่าตัวไหนอยู่ที่ไหน
ลบ worktree เมื่องานถูก merge หรือถูกทิ้ง:
git worktree remove ../myproject-fix-logging
Prune metadata ที่ค้าง หลังจากคุณลบ directory ของ worktree ด้วยมือ (agent และสคริปต์ทำแบบนี้บ่อยกว่าที่คุณอยากให้เป็น):
git worktree prune
เท่านี้คือขอบเขตทั้งหมด ห้าคำสั่ง ความยากไม่ได้อยู่ที่คำสั่ง
กับดักที่กัดจริง
คำสั่งนั้นง่าย แต่ความเป็นจริงในการดำเนินงานต่างหากที่กินเวลาทั้งบ่าย นี่คือโหมดความพังที่โผล่มาเมื่อ agent ตัวจริงรันอยู่ใน worktree จริง
ไฟล์ที่ยังไม่ track และที่ถูก gitignore จะไม่ตามมา worktree จะ checkout ไฟล์ที่ track อยู่ที่ branch ที่คุณสั่ง มันไม่คัดลอก node_modules, .env, venv, build cache หรืออะไรก็ตามที่ git ignore ไว้ ดังนั้น worktree ใหม่สำหรับโปรเจกต์ Node จะยังรันไม่ได้จนกว่าคุณจะรัน install ในนั้น ทุก worktree จ่ายค่าติดตั้ง dependency ของตัวเอง ไฟล์ environment ของตัวเอง และ build ของตัวเอง agent ที่สมมติว่า "repo ตั้งค่าเสร็จแล้ว" จะรันคำสั่งแรกพังใน worktree ใหม่ จนกว่าคุณจะจัดการ setup อย่างชัดเจน
คุณ checkout branch เดียวกันสองครั้งไม่ได้ Git ไม่ยอมให้ branch หนึ่งถูก checkout ใน worktree สองอันพร้อมกัน และมันก็ถูกต้อง ถ้า agent สองตัวต้องการ main ที่ checkout อยู่ทั้งคู่ ตัวหนึ่งต้องแตก branch ออกไป นี่คือฟีเจอร์ ไม่ใช่ข้อจำกัด แต่มันทำให้คนที่คิดว่า worktree เป็นสำเนาลอยๆ อิสระต้องประหลาดใจ
ดิสก์โตเร็ว object storage แชร์กัน ประวัติจึงถูก แต่ working directory และสิ่งที่ติดตั้งในนั้นไม่ถูก สิบ worktree ของโปรเจกต์ที่มี node_modules ขนาด 900 MB คือ dependency ซ้ำซ้อน 9 GB บนแล็ปท็อปที่รัน agent ไม่กี่ตัว คุณจะรู้สึกได้ก่อนเที่ยง
worktree ที่มีไฟล์ค้างดื้อต่อการลบ git worktree remove จะปฏิเสธถ้า worktree มีความเปลี่ยนแปลงที่ยังไม่ commit ซึ่งช่วยปกป้องคุณจากการทิ้งงานที่ agent ทำยังไม่เสร็จ เมื่อคุณต้องการลบจริงๆ ก็ใช้ git worktree remove --force แต่ตอนนี้คุณต้องตัดสินใจเองด้วยมือว่าความเปลี่ยนแปลงที่ยังไม่ commit นั้นสำคัญไหม สำหรับทุก worktree
directory ที่ถูกลบจะทิ้งผีไว้ ลบโฟลเดอร์ worktree ด้วย rm -rf แล้ว git ยังคงแสดงมันอยู่จนกว่าคุณจะ git worktree prune สคริปต์ที่สร้าง worktree เร็วกว่าที่เก็บกวาดจะสะสมรายการค้าง และรายการเหล่านี้ถือ lock ที่บล็อกการใช้ชื่อ branch ซ้ำ การเก็บกวาดไม่ใช่เรื่องเลือกได้ แค่มันง่ายที่จะลืมจนกว่า git worktree list จะกลายเป็นสุสาน
cache ของ agent ที่ซ้อนอยู่ไม่ใช่ของคุณที่จะลบ บาง runtime เก็บ worktree cache ของตัวเอง เช่นที่ ~/.claude/worktrees อย่าชี้สคริปต์เก็บกวาดของคุณไปที่พวกนั้น ปล่อยให้เครื่องมือที่เป็นเจ้าของ cache จัดการมันเอง
ไม่มีข้อไหนยากเป็นรายตัว ปัญหาคือมันทบกัน ทุกข้อ worktree สองอันคุณจัดการเองด้วยมือ ห้าอันคุณเขียนสคริปต์ สิบสอง agent ที่รันข้ามสอง repository แล้วสคริปต์ก็กลายเป็นโครงสร้างพื้นฐานชิ้นเล็กๆ ที่มีบั๊กของตัวเอง และคุณคือคนที่ต้องรับสายเมื่อมันพัง
จุดที่สคริปต์เริ่มไปไม่รอด
เส้นเรื่องตรงๆ มันเป็นแบบนี้ คุณเริ่มจาก shell function ที่ห่อ git worktree add โยน agent เข้าไปใน directory ใหม่ แล้วรัน setup มันได้ผล คุณเพิ่มรูปแบบการตั้งชื่อเพื่อไม่ให้ directory ชนกัน คุณเพิ่มคำสั่งเก็บกวาด จากนั้นความต้องการก็ถาโถมเข้ามา
คุณอยากรู้ว่าตอนนี้ agent ตัวไหนอยู่ใน worktree ไหน และ branch ของมันอยู่สถานะใด git worktree list ของคุณไม่รู้จัก agent มันรู้จักแค่ directory คุณก็ต่อไฟล์ mapping เข้าไป คุณอยากให้การติดตั้ง dependency ต่อ worktree ไม่กระหน่ำดิสก์ เลยเพิ่ม logic caching คุณอยากให้ output ของ agent, diff ของมัน และผลทดสอบไปลงที่ที่มนุษย์ตรวจสอบได้ แทนที่จะไปติดอยู่ใน terminal ที่ปิดไปแล้ว ตอนนี้คุณกำลังเขียนตัวเก็บผลลัพธ์ คุณอยากให้ agent สองตัวไม่แย่งงานเดียวกันจากคิว ตอนนี้คุณกำลังเขียน lock
ถึงจุดหนึ่งคุณก็สร้าง orchestration layer ขึ้นมาใหม่จาก shell script และไม่มีใครมีหน้าที่ดูแลมัน นี่คือรอยต่อที่บทสนทนาเรื่อง ทางเลือกแทน vibe kanban ตั้งอยู่ และเป็นเหตุผลที่ทีมต่างๆ เอื้อมไปหาชั้นการจัดการจริงจังเมื่อจำนวน agent ข้ามเส้นหนึ่งไป worktree ไม่เคยเป็นส่วนที่ยาก การประสานงานการรันที่แยกออกจากกันหลายๆ อันแล้วดึงผลลัพธ์กลับมารวมที่เดียวต่างหากที่ยาก
Sharkly รันทุก Task ใน worktree ของตัวเองได้อย่างไร
Sharkly คือแพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจร มันไม่ได้แทนที่ Claude Code, Codex หรือเครื่องมือรันอื่นๆ ที่ agent ของคุณใช้อยู่ แต่เพิ่มชั้นของ Task, Computer, context และการตรวจสอบที่ใช้ร่วมกันเข้าไป การแยกด้วย worktree ถูกฝังอยู่ในชั้นนั้น คุณจึงเลิกเขียนเองด้วยมือ
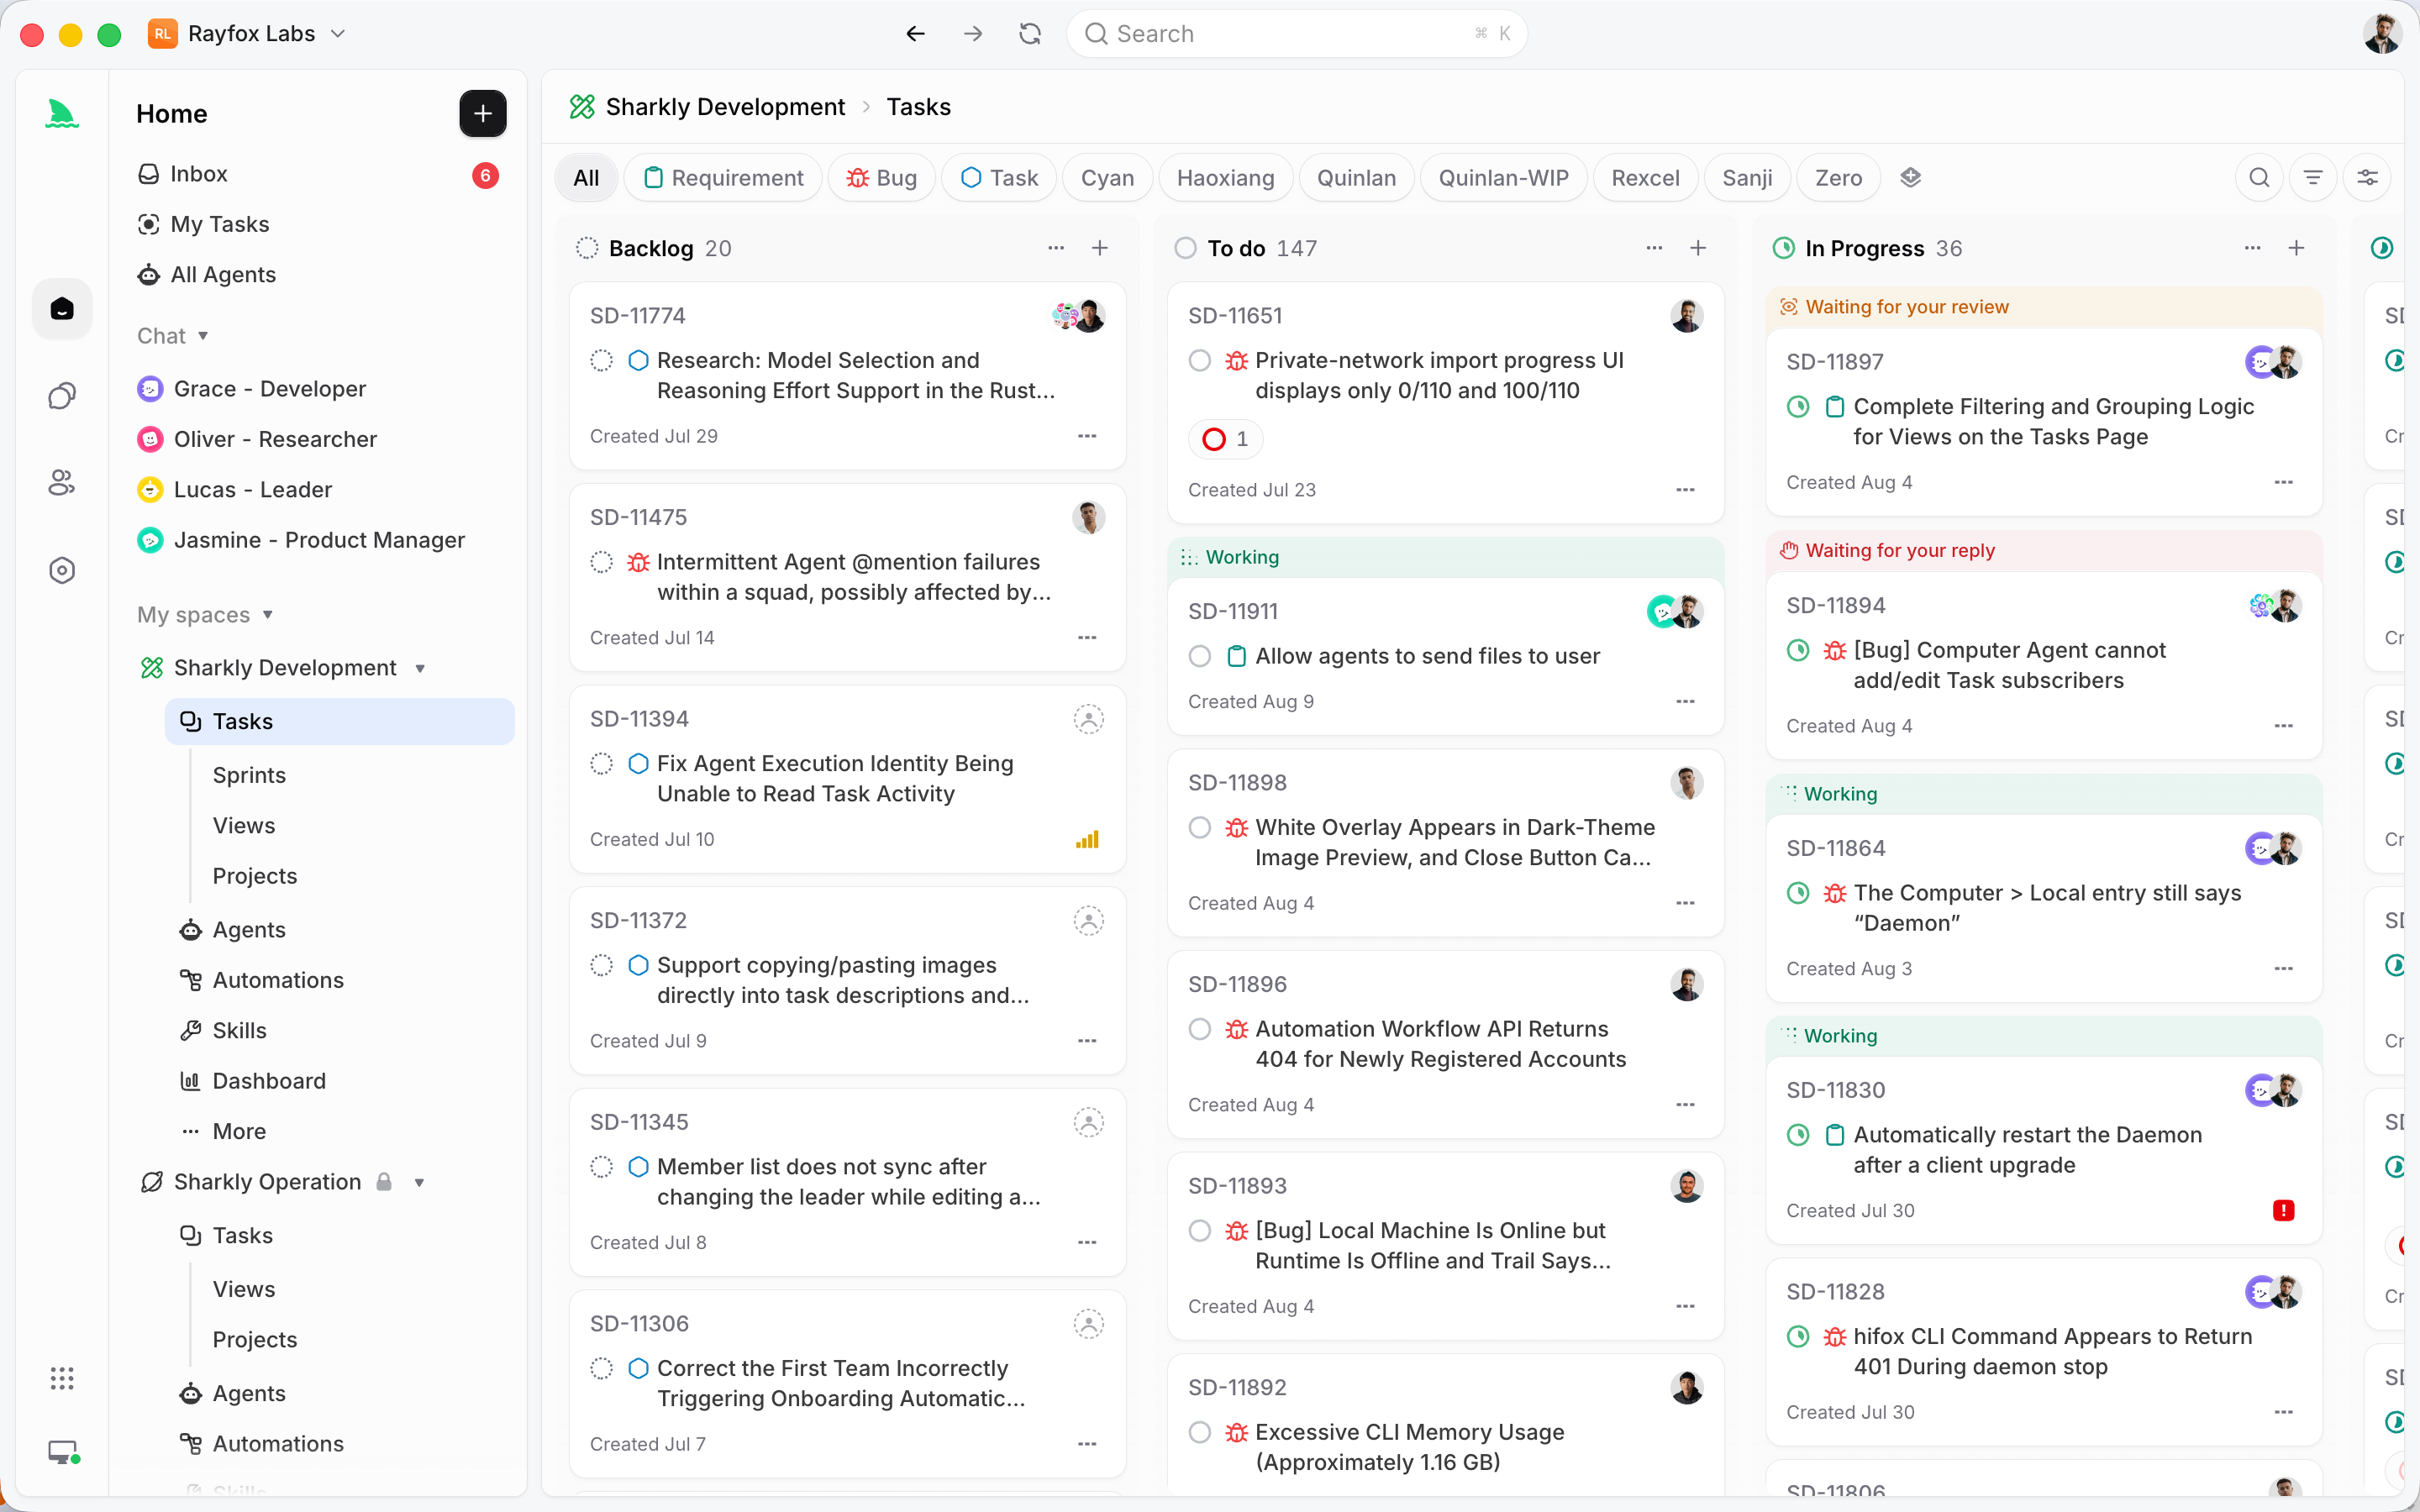
กลไกนั้นตรงไปตรงมา แต่ละ Task ได้ directory ที่แยกออกจากกัน สำหรับงานที่อิง repository Sharkly จะเตรียม worktree ใหม่ให้ทุกการรันจากข้อมูล repository ที่แคชไว้ หลาย Task จึงทำงานกับ source เดียวกันได้โดยไม่เคยเขียนลง checkout ที่แชร์กัน คุณไม่ต้องรัน git worktree add ไม่ต้องเขียนรูปแบบการตั้งชื่อ งานเก็บกวาด หรือไฟล์ mapping คุณแค่กำหนด Task แล้วการแยกออกจากกันก็มีอยู่แล้ว
นี่คือการแยกหน้าที่ที่ทำให้ทุกอย่างสงบลง Agent นิยามว่างานควรถูกจัดการอย่างไร Computer จัดหา host และทรัพยากรในเครื่อง Runtime ทำ session ของ agent จริงๆ และ Task ยังคงเป็นบันทึกที่ทีมใช้ร่วมกัน เพราะแต่ละการรันอยู่ใน worktree ของตัวเอง งาน frontend, backend, การแก้บั๊ก และ test coverage ใหม่ จึงเดินหน้าพร้อมกันได้โดยไม่เหยียบกันเลย ซึ่งก็คือความคู่ขนานที่วิธีทำเองพยายามไขว่คว้า
และผลลัพธ์ก็มีที่ไป การรัน อุปสรรค ผลลัพธ์ และการพูดคุยติดตามผล ทั้งหมดกลับไปที่ไทม์ไลน์ของ Task แทนที่ diff ของ agent จะอยู่ใน terminal ที่คุณต้องคอยจำไปดูเอง สรุปการเปลี่ยนแปลง output ของการตรวจสอบ และข้อจำกัดที่รู้อยู่ จะกลับมาที่ Task ที่คนรับมันไป ขอแก้ไข หรือตัดสินใจ merge context, ความคืบหน้า, อุปสรรค, ผลลัพธ์ และการตรวจสอบโดยมนุษย์ จะมองเห็นได้ตั้งแต่คำขอจนถึงการปล่อย ของในที่เดียวที่แชร์กัน แทนที่จะแยกกันอยู่ตาม prompt ส่วนตัวและ session ของ terminal ถ้าคุณเพิ่งเริ่มรู้จักโมเดลนี้ การมอบหมาย Task แรกให้ AI coding agent คือทางเข้าที่สั้นที่สุด
คุณยังใช้เครื่องมือเดิมที่ใช้อยู่ การใช้โมเดลยังคงผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น Sharkly เพิ่มการแยกออกจากกัน การประสานงาน และการตรวจสอบให้กับมัน
worktree ทำเอง กับ ชั้นการจัดการ
ทั้งสองวิธีใช้ primitive เดียวกัน ต่างกันที่ว่าใครแบกน้ำหนักในการดำเนินงาน
| ประเด็น | git worktree ทำเอง | worktree ที่ Sharkly จัดการ |
|---|---|---|
| การแยกต่อ agent | คุณรัน git worktree add เองทุกครั้ง |
ทุก Task ได้ worktree ใหม่โดยอัตโนมัติ |
| การตั้งค่าต่อ worktree | คุณเขียนสคริปต์ติดตั้งและไฟล์ env เอง | จัดการเป็นส่วนหนึ่งของการเตรียมงาน |
| การเก็บกวาดและ prune | เป็นความรับผิดชอบของคุณ ลืมง่าย | จัดการให้ การเก็บกวาดปลอดภัยไม่แตะ cache ที่ต้องสงวน |
| agent ตัวไหนอยู่ที่ไหน | ไฟล์ mapping ที่คุณดูแลเอง | มองเห็นบน Task ไม่ต้องมีไฟล์ข้างเคียง |
| ผลลัพธ์และ diff | ติดอยู่ในแต่ละ terminal | กลับไปที่ Task เพื่อให้ตรวจสอบ |
| การจอง Task / lock | คุณเขียน lock เอง | Task ถูกจองจากแผนที่แชร์กัน |
| การประสานเรื่องดิสก์ | ทำเองด้วยมือ | จัดการข้าม Computer ที่เชื่อมต่อกัน |
ใช้ worktree ทำเองเมื่อคุณเป็นนักพัฒนาคนเดียวที่รัน agent หนึ่งหรือสองตัว และอยากคุม shell เองทั้งหมด การตั้งค่าแบบนั้นก็ดีจริง และคุ้มค่าที่จะเรียนรู้ เพราะกลไกข้างในจะสอนคุณว่าชั้นใดก็ตามข้างบนกำลังทำอะไรอยู่ ใช้ชั้นการจัดการเมื่อจำนวนมากขึ้น เมื่อมีมากกว่าหนึ่งคนต้องเห็นงาน หรือเมื่อการเสียผลลัพธ์ของ agent ไปใน terminal ที่ปิดไปแล้วทำให้คุณเจ็บจริงๆ สิ่งนี้สอดคล้องกับเกณฑ์ตัดสินใจตรงๆ ในคู่มือ AI agent orchestration ของเรา อย่าเพิ่มเครื่องจักรประสานงานจนกว่างานคู่ขนานจะเป็นเรื่องจริง และอย่าเขียนเองต่อไปเมื่อมันเป็นจริงแล้ว
สัญญาระหว่างคนกับ agent ยังคงอยู่
การแยกออกจากกันเปลี่ยนที่ที่งานเกิดขึ้น ไม่ใช่ว่าใครตัดสินใจ worktree ทำให้ agent ค้นคว้า ลงมือ ทดสอบ และรายงานแบบคู่ขนานได้โดยไม่ชนกัน แต่มนุษย์ยังคงกำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์ ระบบอัตโนมัติหยุดตรงจุดที่ต้องใช้วิจารณญาณของทีม worktree ใหม่ต่อ agent หนึ่งตัวคือสิ่งที่ทำให้เส้นแบ่งนั้นบังคับใช้ได้จริง งานของแต่ละ agent มาถึงในรูปความเปลี่ยนแปลงที่แยกออกมาและตรวจสอบได้บน branch ของตัวเอง ไม่ใช่การแก้ไขที่ตามรอยไม่ได้ซึ่งถูกกลืนไปกับ checkout ที่แชร์กัน คุณตรวจ branch ไม่ใช่ตรวจความเละ สำหรับภาพรวมว่าการเปลี่ยนแปลงนี้หมายถึงอะไรในแต่ละวัน คำอธิบายของเราเรื่อง agentic coding ให้บริบทไว้ และ Sharkly คืออะไร ครอบคลุมแพลตฟอร์มแบบครบวงจร
วิธีที่พิสูจน์แล้วสำหรับ worktree ทำเอง
ถ้าคุณยังทำเองอยู่สักพัก นิสัยพวกนี้ช่วยกันความเจ็บปวดได้เกือบทั้งหมด:
- ตั้งชื่อ directory ของ worktree ตาม branch หรือ task ไม่ใช่ตั้งตามลำดับ
myproject-auth-refactorบอกคุณว่ามันคืออะไร ส่วนmyproject-wt3ไม่บอก - เก็บ worktree ไว้เป็นพี่น้องกับ checkout หลัก ไม่ซ้อนไว้ข้างใน การซ้อนจะทำให้เครื่องมือที่เดินสำรวจ tree สับสนและทำให้ ignore rule ของคุณพองตัว
- ทำการตั้งค่าต่อ worktree ให้เป็นสคริปต์เดียวที่ agent รันก่อน worktree ใหม่จึงรันได้ในขั้นตอนเดียว แทนที่จะพังเพราะไม่มี install
- Prune ตามกำหนดเวลา ไม่ใช่ตามอารมณ์
git worktree pruneทุกวันพร้อมรีวิวgit worktree listช่วยลดรายการผีได้ - อย่าลบ cache ของ runtime ที่ซ้อนอยู่เช่น
~/.claude/worktreesจากสคริปต์ของคุณเอง ปล่อยให้ runtime เป็นเจ้าของมัน - Commit หรือ stash ก่อนลบ
--forceมีไว้สำหรับตอนที่คุณแน่ใจ ไม่ใช่เป็นค่าเริ่มต้น
บทสรุป
Git worktree คือ primitive ของการแยกออกจากกันที่ทำให้ AI coding agent ทำงานคู่ขนานได้อย่างปลอดภัย แนวคิดหลักนั้นคุ้มค่าที่จะจดจำ:
- checkout หนึ่งอันมีหนึ่ง branch หนึ่ง index หนึ่ง
HEADและรองรับ agent สองตัวพร้อมกันไม่ได้ - worktree เพิ่ม working directory อันที่สองบนประวัติที่แชร์กัน agent แต่ละตัวจึงได้ branch และไฟล์ของตัวเอง
- ห้าคำสั่ง (
add,list,remove,pruneและ--forceเมื่อคุณหมายถึงอย่างนั้น) นั้นง่าย - ต้นทุนการดำเนินงาน (การติดตั้งต่อ worktree, ดิสก์, การเก็บกวาด, การประสานงาน, การเก็บผลลัพธ์) ต่างหากที่โตขึ้น
- worktree ทำเองเหมาะกับ agent หนึ่งหรือสองตัว ส่วนชั้นการจัดการจะคุ้มค่าเมื่อจำนวนและความเสี่ยงสูงขึ้น
- Sharkly เตรียม worktree ใหม่ให้ทุก Task โดยอัตโนมัติ และส่งผลลัพธ์แต่ละรายการกลับไปที่ Task เพื่อให้มนุษย์ตรวจสอบ
เรียนรู้คำสั่งทำเองก่อน มันจะสอนคุณว่าชั้นใดก็ตามข้างบนกำลังทำอะไรอยู่ เมื่อการทำบัญชีเริ่มแพงกว่างานจริง Sharkly รับงาน worktree การประสานงาน และการตรวจสอบไปจากมือคุณ เชื่อม Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว แล้วมอบหมายอะไรที่ซ้ำซากให้มันสักอย่าง
คำถามที่พบบ่อย
git worktree คืออะไร พูดแบบง่ายๆ? มันคือ working directory อันที่สองที่ผูกกับ repository เดียวกัน โดยมี branch ที่ checkout อยู่ของตัวเอง และมีความเปลี่ยนแปลงที่ staged กับ unstaged ของตัวเอง มันแชร์ประวัติ commit ชุดเดียวกับ checkout หลัก จึงเบากว่า clone มาก สำหรับ AI agent นั่นหมายความว่า agent แต่ละตัวมีที่ทำงานส่วนตัวโดยไม่แตะไฟล์ของตัวอื่น
ทำไม AI coding agent ถึงต้องใช้ worktree? เพราะ agent สองตัวที่แชร์ checkout เดียวกันจะเขียนทับไฟล์กันและเปลี่ยน branch ของกันและกัน worktree ต่อ agent ย้ายความขัดแย้งไปที่ตอน merge ที่มองเห็นและตรวจสอบได้ แทนที่จะเกิดกลางการแก้ไขที่ทำ state เสียหายอย่างเงียบๆ ดูคู่มือการรัน Claude Code agent หลายตัวพร้อมกันของเราเพื่อการตั้งค่าแบบคู่ขนานเต็มรูปแบบ
worktree เหมือน clone ไหม? ไม่ clone คัดลอก object database ทั้งก้อนไปยัง repository แยกต่างหาก worktree แชร์ object database เดียวและเพิ่มแค่ working directory ใหม่และ branch checkout commit ที่ทำใน worktree ใดก็มองเห็นได้ทันทีจากทุกอัน และใช้ดิสก์น้อยกว่ามาก
worktree สองอัน checkout branch เดียวกันได้ไหม? ไม่ได้ Git ไม่ยอมให้ branch หนึ่งถูก checkout ใน worktree สองอันพร้อมกัน เพื่อปกป้องคุณจากการเขียนที่ขัดแย้งกันลงใน branch เดียวกัน ถ้า agent สองตัวต้องการ branch นั้นเป็นฐานทั้งคู่ ตัวหนึ่งต้องสร้าง branch ใหม่จากมัน
จะเก็บกวาด worktree อย่างปลอดภัยได้อย่างไร? Commit หรือ stash งานก่อน แล้วค่อย git worktree remove <path> ถ้าคุณลบ directory ของ worktree ด้วยมือ ให้รัน git worktree prune เพื่อล้าง metadata ที่ค้าง อย่าชี้สคริปต์เก็บกวาดไปที่ cache ของ runtime เองเช่น ~/.claude/worktrees
เมื่อไหร่ควรเลิกจัดการ worktree ด้วยมือ? เมื่อคุณประสานงาน agent มากกว่าสองสามตัว เมื่อมีมากกว่าหนึ่งคนต้องเห็นงาน หรือเมื่อผลลัพธ์ที่หายไปใน terminal ที่ปิดไปแล้วทำให้คุณเสียเวลา ตอนนั้นชั้นการจัดการที่แยกและติดตามการรันแต่ละครั้งจะคุ้มค่าในตัวเอง คู่มือ AI agent orchestrationของเราครอบคลุมว่าเมื่อไหร่ควรกระโดดมาที่ตรงนั้น


