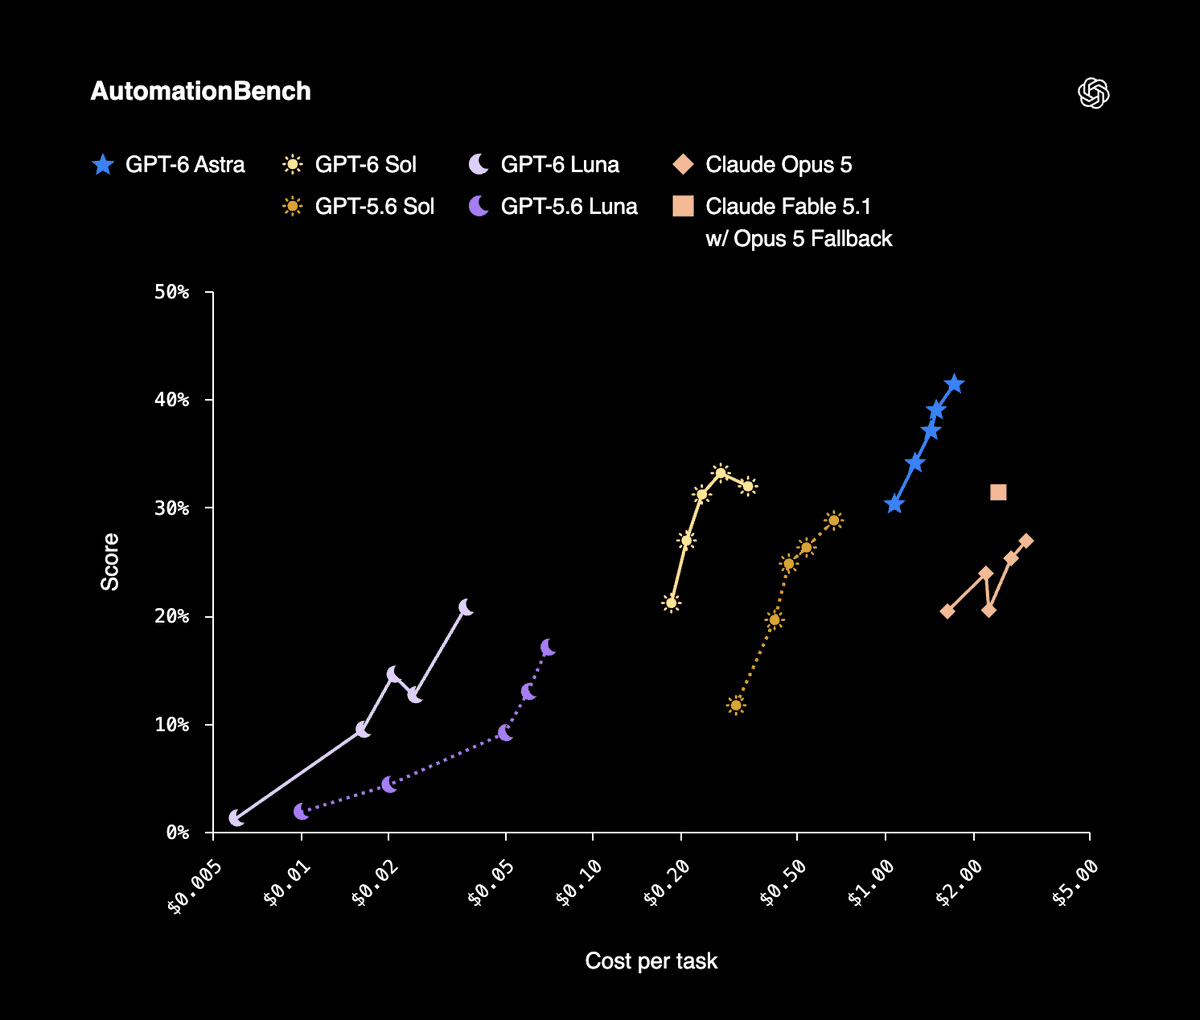
OpenAI เปิดตัว GPT-6 Sol เมื่อวันที่ 22 กันยายน ในราคา 2 ดอลลาร์ต่ออินพุต 1 ล้านโทเค็น และ 10 ดอลลาร์ต่อเอาต์พุต 1 ล้านโทเค็น โดยใช้ API id ว่า gpt-6-sol พร้อมหน้าต่างบริบท 872k ตัวเลขที่ควรเปลี่ยนวิธีที่บอร์ดของคุณมองไม่ใช่อัตราค่าโทเค็น แต่คือต้นทุนต่องานที่ทำเสร็จหนึ่งงาน: จากผลลัพธ์ AutomationBench 1.0.6 ของ OpenAI นั้น Sol ที่ระดับความพยายามในการให้เหตุผล xhigh ทำคะแนนได้ 33.2% ด้วยต้นทุน 0.27 ดอลลาร์ต่องาน ขณะที่ Claude Opus 5 ที่ความพยายามสูงสุดทำได้ 26.9% แต่มีต้นทุนต่องานสูงกว่า Sol ถึง 11.1 เท่า
ให้อ่านสิ่งนี้เป็นคำแถลงเรื่องงบประมาณ มากกว่าจะเป็นตารางจัดอันดับ ถ้าที่ผ่านมาทีมของคุณต้องจำกัดรอบการรันของเอเจนต์เพราะการรันเต็มรูปแบบมีราคาแพง ข้อจำกัดนั้นเพิ่งถูกเลื่อนออกไป ข้อจำกัดถัดไปคือสิ่งที่ไม่มีใครใช้เงินซื้อทางออกได้ นั่นคือยังต้องมีคนอ่าน diff และยอมรับงานชิ้นนั้น คู่มือนี้จะพาคุณไปตามเส้นทางที่สั้นที่สุดแต่ใช้งานได้จริงในการตั้งค่า จากนั้นจะพูดตรง ๆ ถึงส่วนที่การลดราคาแก้ให้ไม่ได้ เริ่มจากการเอา Sol ใส่ใน Codex บน Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว และมอบหมาย Task จริงหนึ่งงาน
สรุปสั้น ๆ (TL;DR)
ตั้งค่า model = "gpt-6-sol" ใน Codex บน Computer ที่เชื่อมต่ออยู่ ยืนยันว่า Codex Runtime แสดงสถานะ Available ใน Sharkly ปล่อยให้ working directory ของ Agent อยู่ในโหมด Temporary เพิ่ม timeout ต่อ Task ก่อนที่คุณจะไว้ใจการรันยาวครั้งแรก แล้วมอบหมาย Task หนึ่งงาน Sharkly จะไม่แสดงชื่อโมเดล แต่จะแสดงการรัน ล็อก คำถาม และผลลัพธ์บน Task เอเจนต์มีหน้าที่ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทาง ให้อำนาจ และยอมรับผลลัพธ์
การตั้งค่าโมเดลอยู่ตรงไหน
Sharkly ไม่ได้เป็นตัวเลือกโมเดล เอกสาร Agents ระบุไว้ตรง ๆ ว่า “Agent จะใช้โมเดลเริ่มต้นของ Runtime ไม่มีการสัญญาหรือแสดงชื่อโมเดลใดเป็นการเฉพาะ หากต้องการเปลี่ยนโมเดล ให้เปลี่ยนในการตั้งค่าเครื่องมือของ Runtime หรือ Computer ไม่ใช่บน Agent”
บน Agent ไม่มีดรอปดาวน์ให้เลือกโมเดล และไม่มีตัวควบคุมระดับความลึกในการคิดเช่นกัน จึงไม่ต้องไปหามัน บทบาทมีสี่อย่าง แต่ละอย่างมีหน้าที่เดียว Agent กำหนดว่างานควรถูกจัดการอย่างไร Computer จัดหาฮอสต์และทรัพยากรภายในเครื่อง Runtime ทำหน้าที่รันเซสชันของเอเจนต์จริง ซึ่งในที่นี้ Codex คือ Runtime ส่วน Task ยังคงเป็นบันทึกที่ทีมใช้ร่วมกัน
ขั้นที่ 1: ใส่ GPT-6 Sol ลงใน Codex บน Computer
บน Computer ที่จะใช้รัน อัปเดต Codex และลงชื่อเข้าใช้ด้วยบัญชีหรือ API key ที่เข้าถึง Sol ได้ OpenAI เปิดให้ใช้ Sol ใน ChatGPT Work และใน Codex สำหรับแพ็กเกจ Plus, Pro, Business, Enterprise และ Edu และยังไม่มีใน Chat ถ้า codex -m gpt-6-sol เปิดเซสชันได้ในเทอร์มินัลธรรมดาบนโฮสต์นั้น Sharkly ก็ใช้งานได้
จากนั้นตั้งค่าเริ่มต้น เพื่อให้ทุกรันบน Computer เครื่องนี้หยิบไปใช้:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
มีข้อควรระวังสองข้อใน snippet นั้น ชื่อคีย์ reasoning-effort แตกต่างกันไปตามเวอร์ชันของ Codex ดังนั้นให้เทียบกับไฟล์ตั้งค่าตัวอย่างของบิลด์ Codex บน Computer เครื่องนั้น และระดับ effort เป็นการตัดสินใจเรื่องต้นทุน ไม่ใช่ปุ่มปรับคุณภาพที่คุณหมุนค้างไว้สูงสุด: ผลลัพธ์ที่ OpenAI เผยแพร่เองใช้ระดับ effort ต่างกันในแต่ละ benchmark และตัวเลข 0.27 ดอลลาร์ต่องานข้างต้นคือแถวของ xhigh [VERIFY]
กลับมาที่ Sharkly เปิดรายละเอียด Computer แล้วรันการสแกนซ้ำหรือทดสอบการเชื่อมต่อ Codex Runtime ควรแสดง Available การที่ Computer แสดงว่าออนไลน์เพียงอย่างเดียวหมายความว่าบริการภายในเครื่องกำลังส่งสัญญาณ heartbeat อยู่ สถานะความสามารถของ Runtime ต่างหากที่บอกคุณว่าการรันเริ่มต้นได้
ขั้นที่ 2: ตั้งค่าแคชก่อนขยาย Crew
นี่คือการเปลี่ยนแปลงของ GPT-6 ที่สำคัญที่สุดเมื่อมีเอเจนต์มากกว่าหนึ่งตัวทำงานในรีโพเดียวกัน และเป็นสิ่งที่ทีมส่วนใหญ่จะข้ามไป
OpenAI รายงานว่า GPT-6 มีอัตราการเข้าแคช (cache hit) สูงขึ้นโดยค่าเริ่มต้น มีส่วนลด 90% สำหรับการอ่านอินพุตที่แคชไว้ มีแดชบอร์ด prompt caching และเครื่องมือวินิจฉัย และที่สำคัญต่องานเอเจนต์คือ การเปลี่ยนระดับ reasoning effort หรือเปลี่ยนชุดเครื่องมือที่ใช้งานได้ ไม่ทำให้แคชใช้ไม่ได้อีกต่อไป จุดตัดแบบระบุชัด (explicit breakpoints) ช่วยให้คุณเลือกได้ว่า prefix ที่แคชไว้จะสิ้นสุดตรงไหน OpenAI อ้างว่า GitHub มีโทเค็นพรอมป์ที่ต้องประมวลผลใหม่ลดลงมากกว่า 50% จากการร้องขอหลายพันล้านครั้ง
สำหรับ crew ภาพในทางปฏิบัติเป็นแบบนี้ ทุกรันของเอเจนต์บนรีโพเดียวกันจะส่ง prefix ขนาดใหญ่ที่เกือบเหมือนกันซ้ำอีกครั้ง ทั้งโครงสร้างรีโพ กฎของทีม คำสั่งรันเทสต์ และธรรมเนียมการเขียนโค้ด prefix นั้นคือสิ่งที่แคชถูกออกแบบมาเพื่อรองรับพอดี และเป็นเหตุผลที่ฝูงเอเจนต์มีต้นทุนต่อรอบถูกกว่าเอเจนต์ตัวแรกมาก
คู่การตัดสินใจ เพราะนี่ไม่ใช่งานที่ได้มาฟรี ๆ ปักหมุด prefix ที่นิ่งแล้วและตั้ง breakpoint แบบชัดเจนเมื่อมีเอเจนต์หลายตัวรันซ้ำ ๆ กับโค้ดเบสเดียว และข้อความ Skill กับคำสั่งของคุณนิ่งแล้ว ไม่ต้องไปเสียเวลากับเรื่องนี้เมื่อเอเจนต์รันแค่ไม่กี่ครั้งต่อสัปดาห์ หรือคำสั่งยังเปลี่ยนทุกสัปดาห์ เพราะคุณจะเสียเวลาดูแลขอบเขตนั้นมากกว่าที่ประหยัดได้
ขั้นที่ 3: สร้าง Agent ให้รองรับการรันที่เริ่มต้นช้า
เปิด Agents เลือก New Agent เลือก Computer และ Codex Runtime แล้วตั้งค่าสามอย่าง
Timeout ต่อ Task ตั้งค่านี้อย่างตั้งใจ เพราะรันของ Sol ในโหมด reasoning สูงอาจดูเหมือนตายไปแล้วก่อนที่จะดูเหมือนกำลังทำงาน Artificial Analysis ซึ่งเป็นบุคคลที่สาม ไม่ใช่ผู้ขายรายใดรายหนึ่ง วัดได้ 102.15 วินาทีจนถึงโทเค็นแรก สำหรับตัวแปร max reasoning ของ GPT-6 Sol นานกว่าที่คนส่วนใหญ่จะรอก่อนคิดว่ามีอะไรค้างอยู่ และนี่คือความล้มเหลวแบบที่สถานะบนบอร์ดที่แชร์กันช่วยป้องกันได้ แต่เทอร์มินัลทำไม่ได้ รันที่กำลังคิดอยู่กับรันที่แครชไปแล้วดูเหมือนกันเป๊ะใน scrollback ดู coding agent observability เพื่อรู้ว่าสถานะต้องมีอะไรบ้างจึงจะคุ้มค่าที่จะอ่าน
Working directory โหมด Temporary แต่ละ Task จะได้ไดเรกทอรีแยกของตัวเอง และรันที่ผูกกับรีโพจะเตรียม worktree ใหม่ให้ ดังนั้นรัน Sol สองรันบนรีโพเดียวกันจึงเขียนทับกันไม่ได้ ค่า concurrency เริ่มต้นสำหรับไดเรกทอรีชั่วคราวคือ 50% ของขีดจำกัดของ Computer ปล่อยไว้ตรงนั้นจนกว่า Computer เครื่องนั้นจะรับมือรันจริงมาหลายรอบแล้ว เพราะ concurrency ที่สูงขึ้นกิน CPU หน่วยความจำ ดิสก์ และความจุของผู้ให้บริการพร้อมกันในทีเดียว
คำสั่ง (Instructions) สั้นและนิ่ง:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
ขั้นที่ 4: มอบหมาย Task หนึ่งงาน แล้วตัดสินว่า Crew คุ้มค่าที่จะมีหรือไม่
เลือก Task ที่มีเกณฑ์การยอมรับชัดเจน ตั้ง Agent เป็น Assignee แล้วย้าย Task ออกจาก Backlog ไปยังสถานะที่มีหมวดหมู่เป็นพร้อมทำงาน เพราะ Task ที่มอบหมายไว้ใน Backlog จะรออยู่เฉย ๆ การรันจะไล่จาก queued ไป dispatched แล้ว running และแท็บ Executions จะสตรีมล็อกให้ดู ถ้าเอเจนต์ต้องการการตัดสินใจ คำถามจะกลับมาที่ Task ในรูปแบบคอมเมนต์ Task จะแสดงว่ารอคำตอบจากคน และจะถูกส่งต่อไปยัง Inbox ของคุณ
สำหรับการเปลี่ยนแปลงที่มีขอบเขตชัดเจน การใช้เอเจนต์ตัวเดียวคือคำตอบที่ถูก และจำนวนชิ้นส่วนที่ต้องขยับก็เป็นศูนย์ Crew คือกลุ่มของคนและเอเจนต์ที่ใช้ซ้ำได้ ซึ่งประสานงานโดยเอเจนต์หัวหน้าเพียงตัวเดียว และจะคุ้มค่าก็ต่อเมื่อหัวหน้าต้องตีความเป้าหมายและรวบผลลัพธ์ของสมาชิกหลายตัวกลับมารวมใน Task เดียว
Sol เปลี่ยนการคำนวณนั้น เพราะหัวหน้าส่วนใหญ่แค่อ่าน วางแผน มอบหมาย และรีวิว ซึ่งเคยเป็นงานที่ยากที่สุดในการหาเหตุผลรองรับเมื่อมันอยู่บนสุดของตารางราคา:
| โมเดลของ Runtime | API id | อินพุต / เอาต์พุตต่อ 1M | เหมาะกับบทบาทไหนใน Crew |
|---|---|---|---|
| GPT-6 Astra | ไม่ได้ระบุ | $10 / $50 | หัวหน้า เมื่อตัวแผนเองคือส่วนที่ยาก |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | หัวหน้า และสมาชิกที่ลงมือเปลี่ยนแปลงจริง |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | สมาชิกที่ใช้งานปริมาณมาก: คัดแยก จัดป้ายกำกับ ตั้งโครง |
เราเขียนวิธีตั้งค่าแบบเดียวกันไว้สำหรับ Astra ในบทความ การรัน GPT-6 Astra เป็นหัวหน้า Crew ข้อโต้แย้งในบทความนั้นยังใช้ได้ แต่ราคาที่รองรับอยู่ข้างใต้เปลี่ยนไปแล้ว
สิ่งที่การลดราคาซื้อไม่ได้
OpenAI อธิบายว่า Sol ถูกกว่าราคาโปรโมชันของ GPT-5.6 อยู่ 50% คำกำกับดังกล่าวเป็นถ้อยคำของ OpenAI เอง และมันสำคัญ เพราะฐานที่ใช้เปรียบเทียบคือราคาโปรโมชัน ไม่ใช่ราคาปกติ มีข้อควรระวังอีกสองข้อที่ควรอยู่บนหน้าเดียวกัน benchmark ตอนเปิดตัวของ OpenAI เปรียบเทียบกับ Claude Opus 5 ซึ่ง Anthropic เปลี่ยนไปใช้ Opus 5.5 ในอีกไม่กี่ชั่วโมงถัดมาในวันเดียวกัน ดังนั้นให้อ่านส่วนต่างเหล่านั้นว่าเป็นการวัดเทียบกับเจนเนอเรชันก่อนหน้า และระดับ effort เป็นตัวทำงาน: Sol ทำได้ 68.8% บน DeepSWE 1.1 และ 56.4% บน Agents’ Last Exam V1 ที่ระดับ max effort ไม่ใช่ที่ระดับที่คุณจะเปิดค้างไว้สำหรับงานประจำ
จากนั้นก็ถึงส่วนที่ไม่ได้เกี่ยวกับโมเดลเลย OpenAI รายงานว่านักวิจัยค่ามัธยฐานของบริษัทเองใช้จ่ายมากกว่า 600 ดอลลาร์ต่อวันกับ coding agent โดยเปอร์เซ็นไทล์ที่ 90 อยู่ที่กว่า 7,000 ดอลลาร์ การที่ต้นทุนต่องานถูกลงคือวิธีที่บิลแบบนั้นถูกสร้างขึ้น ไม่ใช่วิธีที่มันถูกหลีกเลี่ยง ทุกรันยังคงสร้างการเปลี่ยนแปลงที่ต้องมีคนอ่าน ตั้งคำถาม และยอมรับ และคิวนั้นไม่ได้ถูกลง 11 เท่าในสัปดาห์นี้ วางแผนโดยคำนึงถึง ความสามารถในการรีวิว แทนการเลือกโมเดล เขียน routing ลงเป็นกฎ แทนที่จะเป็นความชอบส่วนตัว และเก็บการมอบหมาย ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยคนไว้ในที่เดียวตั้งแต่คำขอจนถึงการปล่อยของ
ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว ลองเชื่อมต่อ Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว แล้วมอบหมายงานน่าเบื่อ ๆ ให้มันสักอย่าง