
Argon หรือ Carbon ดี? ให้รัน Agent Task ส่วนใหญ่ด้วย Gemini 4 Argon แล้วส่งเฉพาะ Task ที่ยากจริงๆ ไปให้ Gemini 4 Carbon ขนาด Google ยังบอกเองว่า Argon ยังคงเป็นตัวเลือกเริ่มต้น (Default) สำหรับงานวิศวกรรมซอฟต์แวร์ส่วนใหญ่ ส่วน Carbon มีไว้สำหรับงานที่ยากกว่า โดยทั้งสองรุ่นมีราคาเท่ากันที่ $2 ขาเข้า และ $10 ขาออกต่อหนึ่งล้าน Token จนถึงวันที่ 30 พฤศจิกายน 2026 แต่ Carbon จะใช้จำนวน Token ต่อหนึ่ง Task มากกว่า
สรุปใจความสำคัญ (TL;DR)
- เริ่มต้นด้วยตัวประหยัด ขยับขึ้นเมื่อมีหลักฐานชัดเจน: เริ่มต้นทุก Task ด้วยโมเดลที่เร็ว และขยับไปใช้โมเดลที่เก่งขึ้นก็ต่อเมื่อเข้าเกณฑ์ความยากที่คุณตรวจสอบได้ หรือเมื่อรันรอบแรกไม่ผ่านเท่านั้น
- ราคาต่อ Token เท่ากัน ไม่ได้แปลว่าราคาต่อ Task จะเท่ากัน: Carbon อ่านข้อมูลมากกว่า ใช้เวลาคิดวิเคราะห์ลึกซึ้งกว่า และมีลูปการตรวจสอบซ้ำมากกว่า ทำให้การทำหนึ่ง Task ใช้ Token มากกว่า
- 4 สัญญาณบ่งบอกว่า Task นั้นยาก: มีขั้นตอนต่อเนื่องยาวนาน (Long horizon), เกี่ยวข้องกับหลายไฟล์, ส่งผลกระทบต่อความปลอดภัย (Security), หรือเคยรันรอบแรกไม่ผ่าน
- วัดผล 2 ตัวเลขต่อ Task: ต้นทุน และอัตราการผ่านการรีวิว (Pass rate) แล้วใช้สองค่านี้เป็นเกณฑ์ในการ Route แทนที่จะดูตาม Leaderboard
- ตั้งค่าโมเดลให้เป็นระบบ ไม่ใช่มานั่งตัดสินใจใหม่ทุก Prompt: ใน Sharkly นั้น Agent แต่ละตัวจะมีโมเดล Default กำหนดไว้ และคุณสามารถเลือกระบุโมเดลเฉพาะสำหรับการรันงานรอบนั้นๆ ได้เมื่อมอบหมาย Task
ทำไมคำถามที่ว่า “โมเดลไหนดีที่สุด” ถึงเป็นคำถามที่ไม่ถูกต้อง
Gemini 4 Carbon เปิดตัวเวอร์ชัน GA อย่างเป็นทางการเมื่อวันที่ 10 พฤศจิกายน 2026 ภายใต้ Model ID gemini-4-carbon ซึ่งในโพสต์เปิดตัว GA ของ Google นั้น มีสิ่งที่โพสต์เปิดตัวผลิตภัณฑ์แทบไม่เคยทำ นั่นคือการบอกตรงๆ ว่าอย่าใช้โมเดลใหม่ล่าสุดนี้กับงานส่วนใหญ่: “Argon ยังคงเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับงานวิศวกรรมซอฟต์แวร์และงานองค์ความรู้ส่วนใหญ่”
จากโพสต์เดียวกันยังระบุด้วยว่า Carbon ถูก “สร้างขึ้นมาสำหรับ Task ที่ท้าทายขีดจำกัดความฉลาดของโมเดล” และมัน “ใช้ Token มากกว่า Argon ในการสำรวจข้อมูลอย่างละเอียด คิดวิเคราะห์อย่างลึกซึ้ง และมีลูปการตรวจสอบที่ครอบคลุมยิ่งขึ้น”
มุมมองนี้สอดคล้องกับแนวทางการทำงานของทีมที่ใช้ Agent คุณย่อมมีคิวของ Task ที่มีความยากง่ายต่างกัน และแต่ละ Task ก็ควรใช้โมเดลที่ประหยัดที่สุดเท่าที่จะทำงานผ่านการรีวิวได้ การเลือก “โมเดลที่ดีที่สุด” เพียงโมเดลเดียวให้กับทั้งทีม จะทำให้คุณจ่ายแพงเกินไปสำหรับ Task ง่ายๆ หรือไม่ก็ให้พลังประมวลผลไม่เพียงพอกับ Task ที่ยาก
หากคุณต้องการทำความเข้าใจภาพรวมของ Carbon ก่อน บทความ Gemini 4 Carbon for coding agents ของเราจะอธิบายว่ามันคืออะไร และคู่มือ Gemini 4 Argon guide จะครอบคลุมเกี่ยวกับโมเดลเริ่มต้น
กฎการ Route โมเดล: เริ่มต้นด้วยตัวประหยัด ขยับขึ้นเมื่อเจองานยาก
การ Route โมเดลสำหรับ Coding Agent คือการเลือกโมเดลให้เหมาะสมเป็นราย Task แทนที่จะเลือกโมเดลเดียวใช้ทั้งทีม กฎนี้สรุปได้ในบรรทัดเดียว: ทุก Task เริ่มต้นด้วยโมเดล Default และจะขยับไปใช้โมเดลที่เก่งขึ้นก็ต่อเมื่อมีสัญญาณหรือเกณฑ์ที่ระบุไว้ชัดเจนว่าเป็นงานยาก หรือเมื่อโมเดล Default รันแล้วไม่ผ่านเท่านั้น
กฎนี้ทำงานได้จริงด้วย 2 องค์ประกอบ:
- โมเดลเริ่มต้นที่เร็วและดีพอสำหรับ Task ส่วนใหญ่: สำหรับทีมที่ใช้ Gemini โมเดลนั้นคือ Argon ตามคำแนะนำของ Google เอง
- ขั้นตอนการส่งต่องาน (Escalation path) ที่มีเงื่อนไขตรวจสอบได้: คำว่า “รู้สึกว่าง่ายหรือยาก” ไม่ใช่เงื่อนไขที่ใช้ได้ แต่ “มีการแตะต้องโค้ดระบบยืนยันตัวตน (Auth)” คือเงื่อนไขที่ชัดเจน
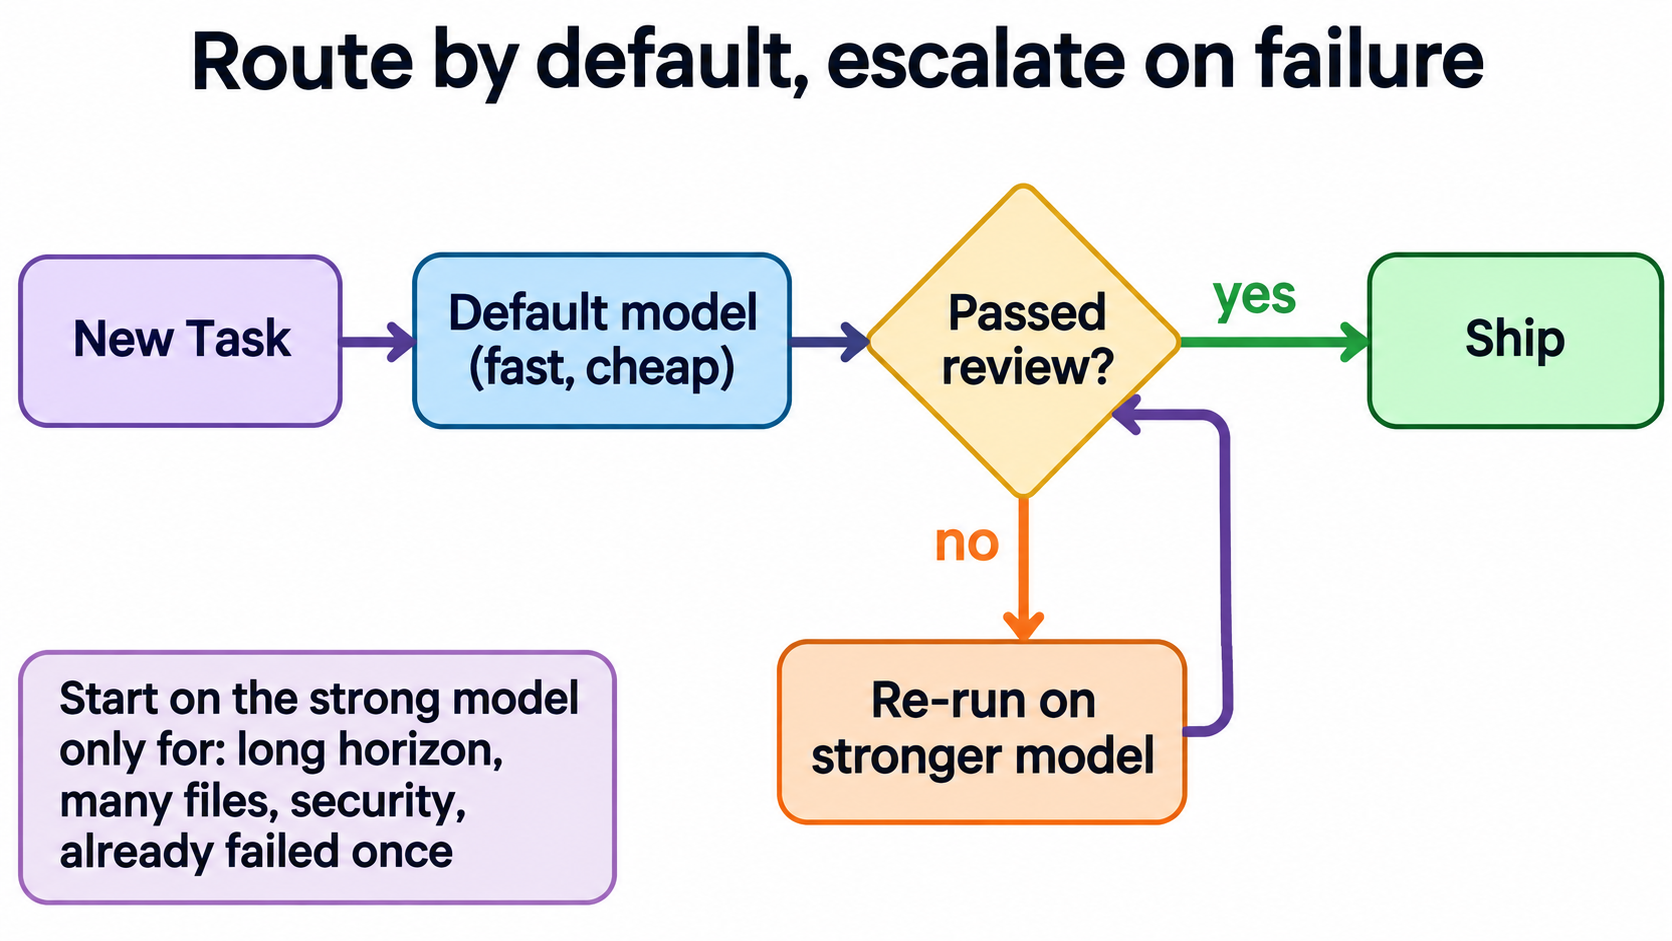
วิธีดูว่า Task ไหนคืองานยาก
คุณต้องมีสัญญาณที่สามารถสังเกตได้จาก Task ก่อนที่จะเริ่มรัน ซึ่ง 4 ข้อนี้ครอบคลุมกรณีส่วนใหญ่ได้เกือบทั้งหมด
มีขั้นตอนการทำงานต่อเนื่องยาวนาน (Long horizon)
Task ที่ต้องทำหลายขั้นตอนต่อเนื่องกัน เช่น การทำ Migration ที่มีการเปลี่ยนแปลงซึ่งต้องขึ้นต่อกันถึง 10 สเต็ป จะทำให้โมเดลระดับทั่วไปมีโอกาสหลุดประเด็นหรือเกิดข้อผิดพลาดได้ง่าย ลูปการตรวจสอบเพิ่มเติมของ Carbon จึงถูกออกแบบมาเพื่อแก้ปัญหานี้โดยเฉพาะ สัญญาณที่สังเกตได้: คำอธิบายของ Task ระบุขั้นตอนมากกว่า 5 ขั้นตอน หรือการรันงานลักษณะเดียวกันในอดีตเคยใช้เวลาเกินงบประมาณที่กำหนดไว้
เกี่ยวข้องกับหลายไฟล์
การแก้ไขที่ส่งผลกระทบข้ามหลายส่วน (Cross-cutting changes) บังคับให้โมเดลต้องจดจำและเข้าใจบริบทของ Codebase ปริมาณมากพร้อมๆ กัน สัญญาณที่สังเกตได้: การแก้ไขครอบคลุมหลาย Package หรือมีไฟล์ที่เกี่ยวข้องมากกว่า 10 ไฟล์ขึ้นไป
ส่งผลกระทบต่อความปลอดภัย (Security impact)
ระบบ Auth, การชำระเงิน, การจัดการ Secret และการตรวจสอบสิทธิ์ เป็นจุดที่หากโมเดลให้คำตอบผิดพลาดอย่างมั่นใจจะสร้างความเสียหายร้ายแรงได้ ในโพสต์เปิดตัว GA ของ Google ระบุว่า Carbon ทำคะแนนนำใน SEC-bench Pro และ CWE-bench v1 เมื่อใช้งานผ่าน Fairwind Program สำหรับผู้เชี่ยวชาญด้านความปลอดภัยทางไซเบอร์ สัญญาณที่สังเกตได้: Task นั้นแตะต้อง Path ของไฟล์ที่คุณระบุไว้ว่ามีความสำคัญหรือมีความอ่อนไหวสูง (Sensitive)
เคยรันแล้วไม่ผ่านมาก่อน
นี่คือสัญญาณที่ประหยัดและตรงไปตรงมาที่สุด หากการรันด้วยโมเดล Default ไม่ผ่านการรีวิว คุณก็มีหลักฐานชัดเจนแล้วว่า Task นั้นเกินขีดความสามารถของมัน ให้ส่งไปรันใหม่บนโมเดลที่เก่งขึ้นพร้อมแนบความคิดเห็น (Comment) จากผู้รีวิวไปด้วย
ตารางการ Route เบื้องต้นที่คุณนำไปใช้ได้ทันที
ใช้ตารางนี้เป็นแนวทางเริ่มต้น แล้วค่อยนำอัตราการผ่านการรีวิว (Pass rate) จริงของทีมคุณมาปรับแก้หลังจากผ่านไป 2 สัปดาห์
| ประเภทของ Task | เริ่มต้นที่ | ส่งต่อไปยัง | เหตุผล |
|---|---|---|---|
| แก้ไขคำผิด, ปรับแก้ข้อความ (Copy), อัปเดต Dependency | กลุ่มโมเดลความเร็วสูง (ตระกูล Flash หรือ mini) | Argon | การเปลี่ยนแปลงของโค้ดน้อย และรีวิวได้ง่าย |
| แก้ Bug โดยมี Test case ที่รันไม่ผ่านอยู่แล้ว | Argon | Carbon | มีผลการรัน Test เป็นตัวบ่งชี้ความสำเร็จที่ชัดเจน |
| พัฒนาฟีเจอร์ภายในโมดูลเดียว | Argon | Carbon | เป็นโมเดลเริ่มต้นที่ Google แนะนำสำหรับงานวิศวกรรมส่วนใหญ่ |
| รีแฟกเตอร์โค้ดข้ามหลายไฟล์ | Carbon | Fable 5.2 หรือส่งต่อให้นักพัฒนา | มีขั้นตอนยาวนาน และเกี่ยวข้องกับหลายไฟล์ |
| ระบบ Auth, การชำระเงิน, สิทธิ์การใช้งาน | Carbon | ต้องให้คนรีวิวเสมอ | ส่งผลกระทบต่อความปลอดภัย |
| Task ใดก็ตามที่รีวิวไม่ผ่านหนึ่งรอบ | ขยับขึ้นหนึ่งระดับ | นักพัฒนา (คน) | หลักฐานจริงดีกว่าการคาดเดา |
Claude Fable 5.2 มีราคาอยู่ที่ $8 ขาเข้า และ $40 ขาออกต่อหนึ่งล้าน Token ซึ่งสูงกว่าราคาช่วงเปิดตัวของ Carbon ถึง 4 เท่า ดังนั้นโมเดลนี้จึงถูกจัดให้อยู่เหนือ Carbon ในฐานะด่านสุดท้ายของระบบอัตโนมัติ ไม่ใช่ตัวเลือกเริ่มต้น ส่วนราคาของ Carbon จะปรับขึ้นเป็น $4 และ $20 หลังวันที่ 30 พฤศจิกายน 2026 ตามหมายเหตุของ Google ซึ่งจะทำให้ส่วนต่างของราคาแคบลง อย่าลืมตรวจสอบราคาล่าสุดที่ หน้าราคา Gemini API ก่อนที่คุณจะกำหนดงบประมาณ
ขยับโมเดลเมื่อรันไม่ผ่าน ไม่ใช่เลือกตัวท็อปตั้งแต่แรก
ทีมพัฒนามักมีแนวโน้มที่จะส่งงานอะไรก็ตามที่ “ฟังดูยาก” ไปให้โมเดลที่เก่งที่สุดไว้ก่อน แม้จะรู้สึกปลอดภัยแต่ก็มีค่าใช้จ่ายสูงมาก เพราะ Task เหล่านั้นจำนวนมากสามารถผ่านการรีวิวได้ด้วยโมเดล Default อยู่แล้ว
การส่งต่องานเมื่อเกิดความล้มเหลว (Escalation on failure) ทำให้คุณจ่ายค่าโมเดลตัวเล็กกับทุก Task และจ่ายค่าโมเดลตัวใหญ่เฉพาะกับ Task ที่พิสูจน์แล้วว่าจำเป็นต้องใช้จริงๆ การรันด้วยโมเดลราคาถูกแล้วไม่ผ่านหนึ่งรอบ มักมีต้นทุนต่ำกว่าการรันด้วยโมเดลราคาแพงโดยไม่จำเป็นตั้งแต่ต้น
มีเพียง 2 กรณีที่เป็นข้อยกเว้นของกฎนี้ ซึ่งตารางด้านบนได้ระบุไว้แล้ว คืองานด้านความปลอดภัยที่ควรเริ่มด้วยโมเดลระดับสูงตั้งแต่แรก เพราะหากการรันรอบแรกที่ผิดพลาดหลุดรอดสายตาของผู้รีวิวไป อาจถูก Merge เข้าสู่ระบบได้ และงานรีแฟกเตอร์ขนาดใหญ่ที่ครอบคลุมหลายไฟล์ ซึ่งควรเริ่มด้วยโมเดลระดับสูงเช่นกัน เนื่องจากการรันไม่ผ่านในงานประเภทนี้จะทำให้เสียเวลาเป็นชั่วโมง ไม่ใช่แค่นาทีเดียว
นอกจากนี้ การรันที่ไม่ผ่านจะให้ข้อมูลที่มีประโยชน์ก็ต่อเมื่อการรีวิวตรวจจับข้อผิดพลาดนั้นได้เท่านั้น เนื่องจากบางครั้งโมเดลอาจหาช่องโหว่เพื่อให้รัน Test ผ่าน ดังนั้นจึงควรใช้การยกระดับโมเดลควบคู่ไปกับแนวทางตรวจสอบในบทความ วิธีจับไต๋เมื่อ Coding Agent โกงผลการทดสอบ
วัดต้นทุนและอัตราการผ่านต่อหนึ่ง Task
การ Route โมเดลโดยไม่มีตัวเลขมารองรับจะกลายเป็นการใช้ความคิดเห็นส่วนตัว ให้คุณติดตาม 2 สิ่งนี้สำหรับทุก Task:
- ต้นทุนต่อ Task (Cost per Task): จำนวน Token ขาเข้าและขาออกคูณด้วยราคาของโมเดลนั้นๆ แล้วรวมทุกรอบที่ Task นั้นถูกรัน รวมถึงรอบที่ไม่ผ่านด้วย
- อัตราการผ่านการรีวิว (Pass rate at review): การรันรอบแรกผ่านเลยหรือไม่ หรือต้องรันซ้ำ หรือต้องให้นักพัฒนามาช่วยแก้?
จากนั้นให้นำมาคำนวณ ต้นทุนต่อหนึ่งการเปลี่ยนแปลงที่ผ่านการอนุมัติ (Cost per accepted change) คือตัวเลขสำคัญที่ใช้ตัดสินใจในการ Route โมเดล เพราะโมเดลราคาถูกที่รันไม่ผ่านถึงครึ่งหนึ่ง อาจมีต้นทุนรวมสูงกว่าโมเดลตัวเก่งที่ทำผ่านตั้งแต่รอบแรก ดังข้อคิดเห็นในบทความ เมื่อโมเดลที่ถูกกว่ากลับมีต้นทุนที่แพงกว่า
ข้อมูลจากบุคคลภายนอกก็ชี้ไปในทางเดียวกัน โดย Artificial Analysis รายงานว่าการทดสอบ Intelligence Index มีค่าใช้จ่ายอยู่ที่ $7.76 บน Gemini 4 Carbon (high) และ $26.54 บน Claude Fable 5.2 (max) โดย Fable ได้คะแนน 65 ขณะที่ Carbon ได้ 60 คะแนน ผลต่างคะแนนเพียง 5 คะแนนแต่แลกด้วยต้นทุนที่สูงกว่าถึง 3.4 เท่า จึงคุ้มค่าที่จะจ่ายเฉพาะกับ Task ที่คะแนน 5 แต้มนั้นสามารถเปลี่ยนผลลัพธ์ของงานได้จริงๆ เท่านั้น
เพียงแค่บันทึก Log แบบเรียบง่ายก็เพียงพอสำหรับการเริ่มต้น:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
ในตัวอย่างนี้ COIN-213 รันไม่ผ่านบน Argon จึงถูกส่งต่อไปยัง Carbon และผ่านการรีวิว โดย Task นี้มีค่าใช้จ่ายรวมทั้งหมด $1.29 และข้อมูลแถวนั้นจะช่วยบอกคุณได้ว่า Task ในลักษณะนี้ควรเริ่มต้นที่ Carbon ตั้งแต่แรกในครั้งถัดไปหรือไม่
จัดการแบบราย Task บนกระดานงาน (Board)
กฎนี้พูดง่ายแต่ทำตามได้ยาก หากนักพัฒนาแต่ละคนยังคงเลือกโมเดลกันเองใน Terminal ของตน ดังนั้น ควรนำการ Route โมเดลไปไว้ในที่ที่ Task นั้นอยู่
กำหนดโมเดลเฉพาะให้กับ Agent แต่ละตัว
ใน Sharkly ตัว Agent จะใช้โมเดลตาม Runtime ของมันโดยค่าเริ่มต้น และแถว Model ในการตั้งค่าของ Agent จะเปิดโอกาสให้คุณเลือกโมเดลอื่นจากแคตตาล็อกของ Runtime นั้นได้ รวมถึงกำหนดระดับความลึกในการคิด (Thinking depth) หากโมเดลนั้นรองรับ ซึ่งสามารถดูรายละเอียดได้ใน เอกสารคู่มือเกี่ยวกับ Agent วิธีนี้จะช่วยให้คุณมี Agent หนึ่งตัวต่อหนึ่งระดับความสามารถ ได้แก่ Agent ตัวเริ่มต้นที่รันบนโมเดลที่เร็ว และ Agent สำหรับส่งต่องานที่รันบนโมเดลที่ทรงพลัง
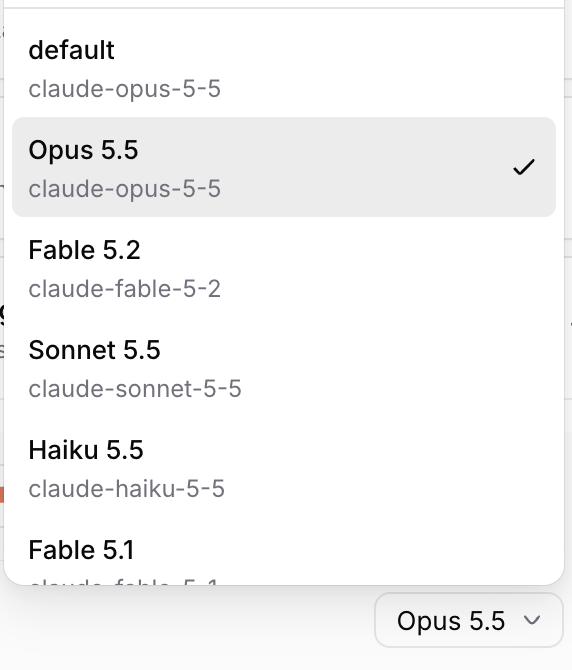
ยกระดับโมเดลสำหรับการรันเฉพาะรอบ
เมื่อคุณมอบหมาย Task คุณสามารถเลือกโมเดลเฉพาะสำหรับการรันรอบนั้นได้ ซึ่งจะเป็นการ Override ค่าเริ่มต้นของ Agent สำหรับการรันครั้งนั้นเพียงครั้งเดียว นี่คือการส่งต่องานเมื่อเกิดความล้มเหลวได้ในขั้นตอนเดียว: เมื่อผู้รีวิวส่ง Task กลับมา การรันซ้ำจะถูกส่งไปที่ Carbon ทันที โดยไม่ต้องเปลี่ยนการตั้งค่าของ Agent ที่คนอื่นๆ กำลังใช้งานอยู่
เก็บประวัติการทำงานไว้ในที่เดียว
การรันงานทุกรอบจะมีการบันทึก Execution log ไว้อย่างครบถ้วน ตารางต้นทุนและอัตราการผ่านของคุณจึงมาจากข้อมูลของ Task ที่ส่งมอบจริง ไม่ใช่มาจากการคาดเดา สำหรับทีมที่ทำงานแบบ Crew ซึ่งแบ่งหน้าที่ตามบทบาทแทนความยากของงาน สามารถดูเพิ่มเติมได้ที่ การ Route โมเดลสำหรับ Agent Crew และในด้านการกำกับดูแล บทความ ใครคือผู้ควบคุม Agent ของคุณ จะครอบคลุมการควบคุมต่างๆ ที่ทีมของคุณสามารถจัดการได้ ทั้งนี้ Sharkly สามารถเริ่มต้นใช้งานได้ฟรี
ทางเลือกอื่นนอกเหนือจากการ Route แบบราย Task
- ใช้โมเดลเดียวสำหรับทุกอย่าง: เหมาะสำหรับนักพัฒนาที่ทำงานคนเดียว แต่จะสิ้นเปลืองอย่างมากเมื่อ Task มีความหลากหลาย
- ใช้โมเดล Router อัตโนมัติ: ใช้โมเดลขนาดเล็กมาช่วยจัดหมวดหมู่แต่ละ Prompt แล้วเลือกโมเดลปลายทางให้ แต่วิธีนี้จะซ่อนกระบวนการตัดสินใจและไม่สามารถรับรู้ได้ว่าการรีวิวไม่ผ่าน
- โหมดการทำงานแบบทีม Agent (Agent-team modes): พรีวิวคำสั่ง /swarm ของ Google ใน Antigravity ให้ Carbon ทำหน้าที่วางแผนและตรวจสอบความถูกต้อง ขณะที่โมเดลขนาดเล็กกว่าทำงานควบคู่กันไป ซึ่งนี่คือการ Route ตามบทบาทหน้าที่ภายในงานชิ้นเดียว และสามารถนำมาใช้เสริมร่วมกับการ Route แบบราย Task ได้
บทสรุป
Google ได้บอกแนวทางการ Route โมเดลไว้ให้แล้วในโพสต์เปิดตัว: ใช้ Argon เป็นค่าเริ่มต้น และใช้ Carbon เมื่อ Task นั้นยากจนคู่ควร กำหนดสัญญาณบ่งบอก Task ยากทั้ง 4 ข้อของคุณให้ชัดเจน เริ่มต้นงานอื่นๆ ด้วยโมเดลที่ประหยัด ขยับไปใช้โมเดลที่เก่งขึ้นเมื่อรีวิวไม่ผ่าน พร้อมทั้งบันทึกต้นทุนและอัตราการผ่านต่อ Task เสมอ หลังจากผ่านไป 2 สัปดาห์ ตัวเลขจริงจากทีมของคุณจะช่วยปรับแต่งตารางการทำงานได้แม่นยำกว่าผล Benchmark ใดๆ
ขั้นตอนต่อไป: ตั้งค่า Agent สองตัวใน Sharkly โดยตัวหนึ่งใช้โมเดลเริ่มต้น และอีกตัวใช้โมเดลสำหรับการยกระดับ แล้วเริ่ม Route งานของสัปดาห์นี้ผ่าน Agent เหล่านี้ได้เลย
คำถามที่พบบ่อย (FAQ)
ควรใช้ Gemini 4 Carbon หรือ Argon สำหรับ Coding Agent ดี?
ใช้ Argon สำหรับ Task ส่วนใหญ่ และใช้ Carbon สำหรับงานที่ยาก โดยโพสต์เปิดตัว GA ของ Google ระบุว่า Argon “ยังคงเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับงานวิศวกรรมซอฟต์แวร์ส่วนใหญ่” ส่วน Carbon มีไว้สำหรับ Task ที่ท้าทายขีดจำกัดของโมเดล
Gemini 4 Carbon มีราคาแพงกว่า Argon หรือไม่?
หากคิดต่อ Token จะตอบว่าไม่: ทั้งสองรุ่นมีราคาอยู่ที่ $2 ขาเข้า และ $10 ขาออกต่อหนึ่งล้าน Token จนถึงวันที่ 30 พฤศจิกายน 2026 แต่หากคิดต่อ Task โดยทั่วไปจะแพงกว่า เนื่องจาก Google ระบุว่า Carbon ใช้ Token มากกว่าในการค้นหาคำตอบและตรวจสอบความถูกต้อง
ราคาของ Gemini 4 Carbon จะเป็นอย่างไรหลังจากวันที่ 30 พฤศจิกายน?
หมายเหตุของ Google ระบุว่าราคาช่วงแนะนำจะสิ้นสุดลงในวันที่ 30 พฤศจิกายน 2026 และ Carbon จะปรับราคาเป็น $4 ต่อหนึ่งล้าน Token ขาเข้า และ $20 ต่อหนึ่งล้าน Token ขาออก
การ Route โมเดลสำหรับ AI Agent คืออะไร?
การ Route โมเดล คือการเลือกโมเดลให้เหมาะสมกับแต่ละ Task ตามระดับความยากง่าย โดยมีเป้าหมายเพื่อให้ได้ต้นทุนต่ำที่สุดต่อหนึ่งการเปลี่ยนแปลงโค้ดที่ได้รับการยอมรับ (Accepted change)
จะรู้ได้อย่างไรว่าเมื่อใดควรส่งต่อ Task ไปยังโมเดลที่เก่งกว่า?
ให้ส่งต่องานเมื่อ Task นั้นมีขั้นตอนการทำงานต่อเนื่องยาวนาน, ครอบคลุมหลายไฟล์, แตะต้องโค้ดที่เกี่ยวข้องกับความปลอดภัย, หรือเคยรีวิวไม่ผ่านจากการรันบนโมเดลเริ่มต้นมาแล้ว
เราสามารถกำหนดโมเดลที่แตกต่างกันให้กับ Agent แต่ละตัวใน Sharkly ได้หรือไม่?
ได้ ในการตั้งค่าของ Agent แต่ละตัวจะมีแถว Model ให้เลือกโมเดลจากแคตตาล็อกของ Runtime นั้นๆ และคุณยังสามารถเลือก Override โมเดลสำหรับการรันรอบใดรอบหนึ่งโดยเฉพาะได้เมื่อคุณมอบหมาย Task


