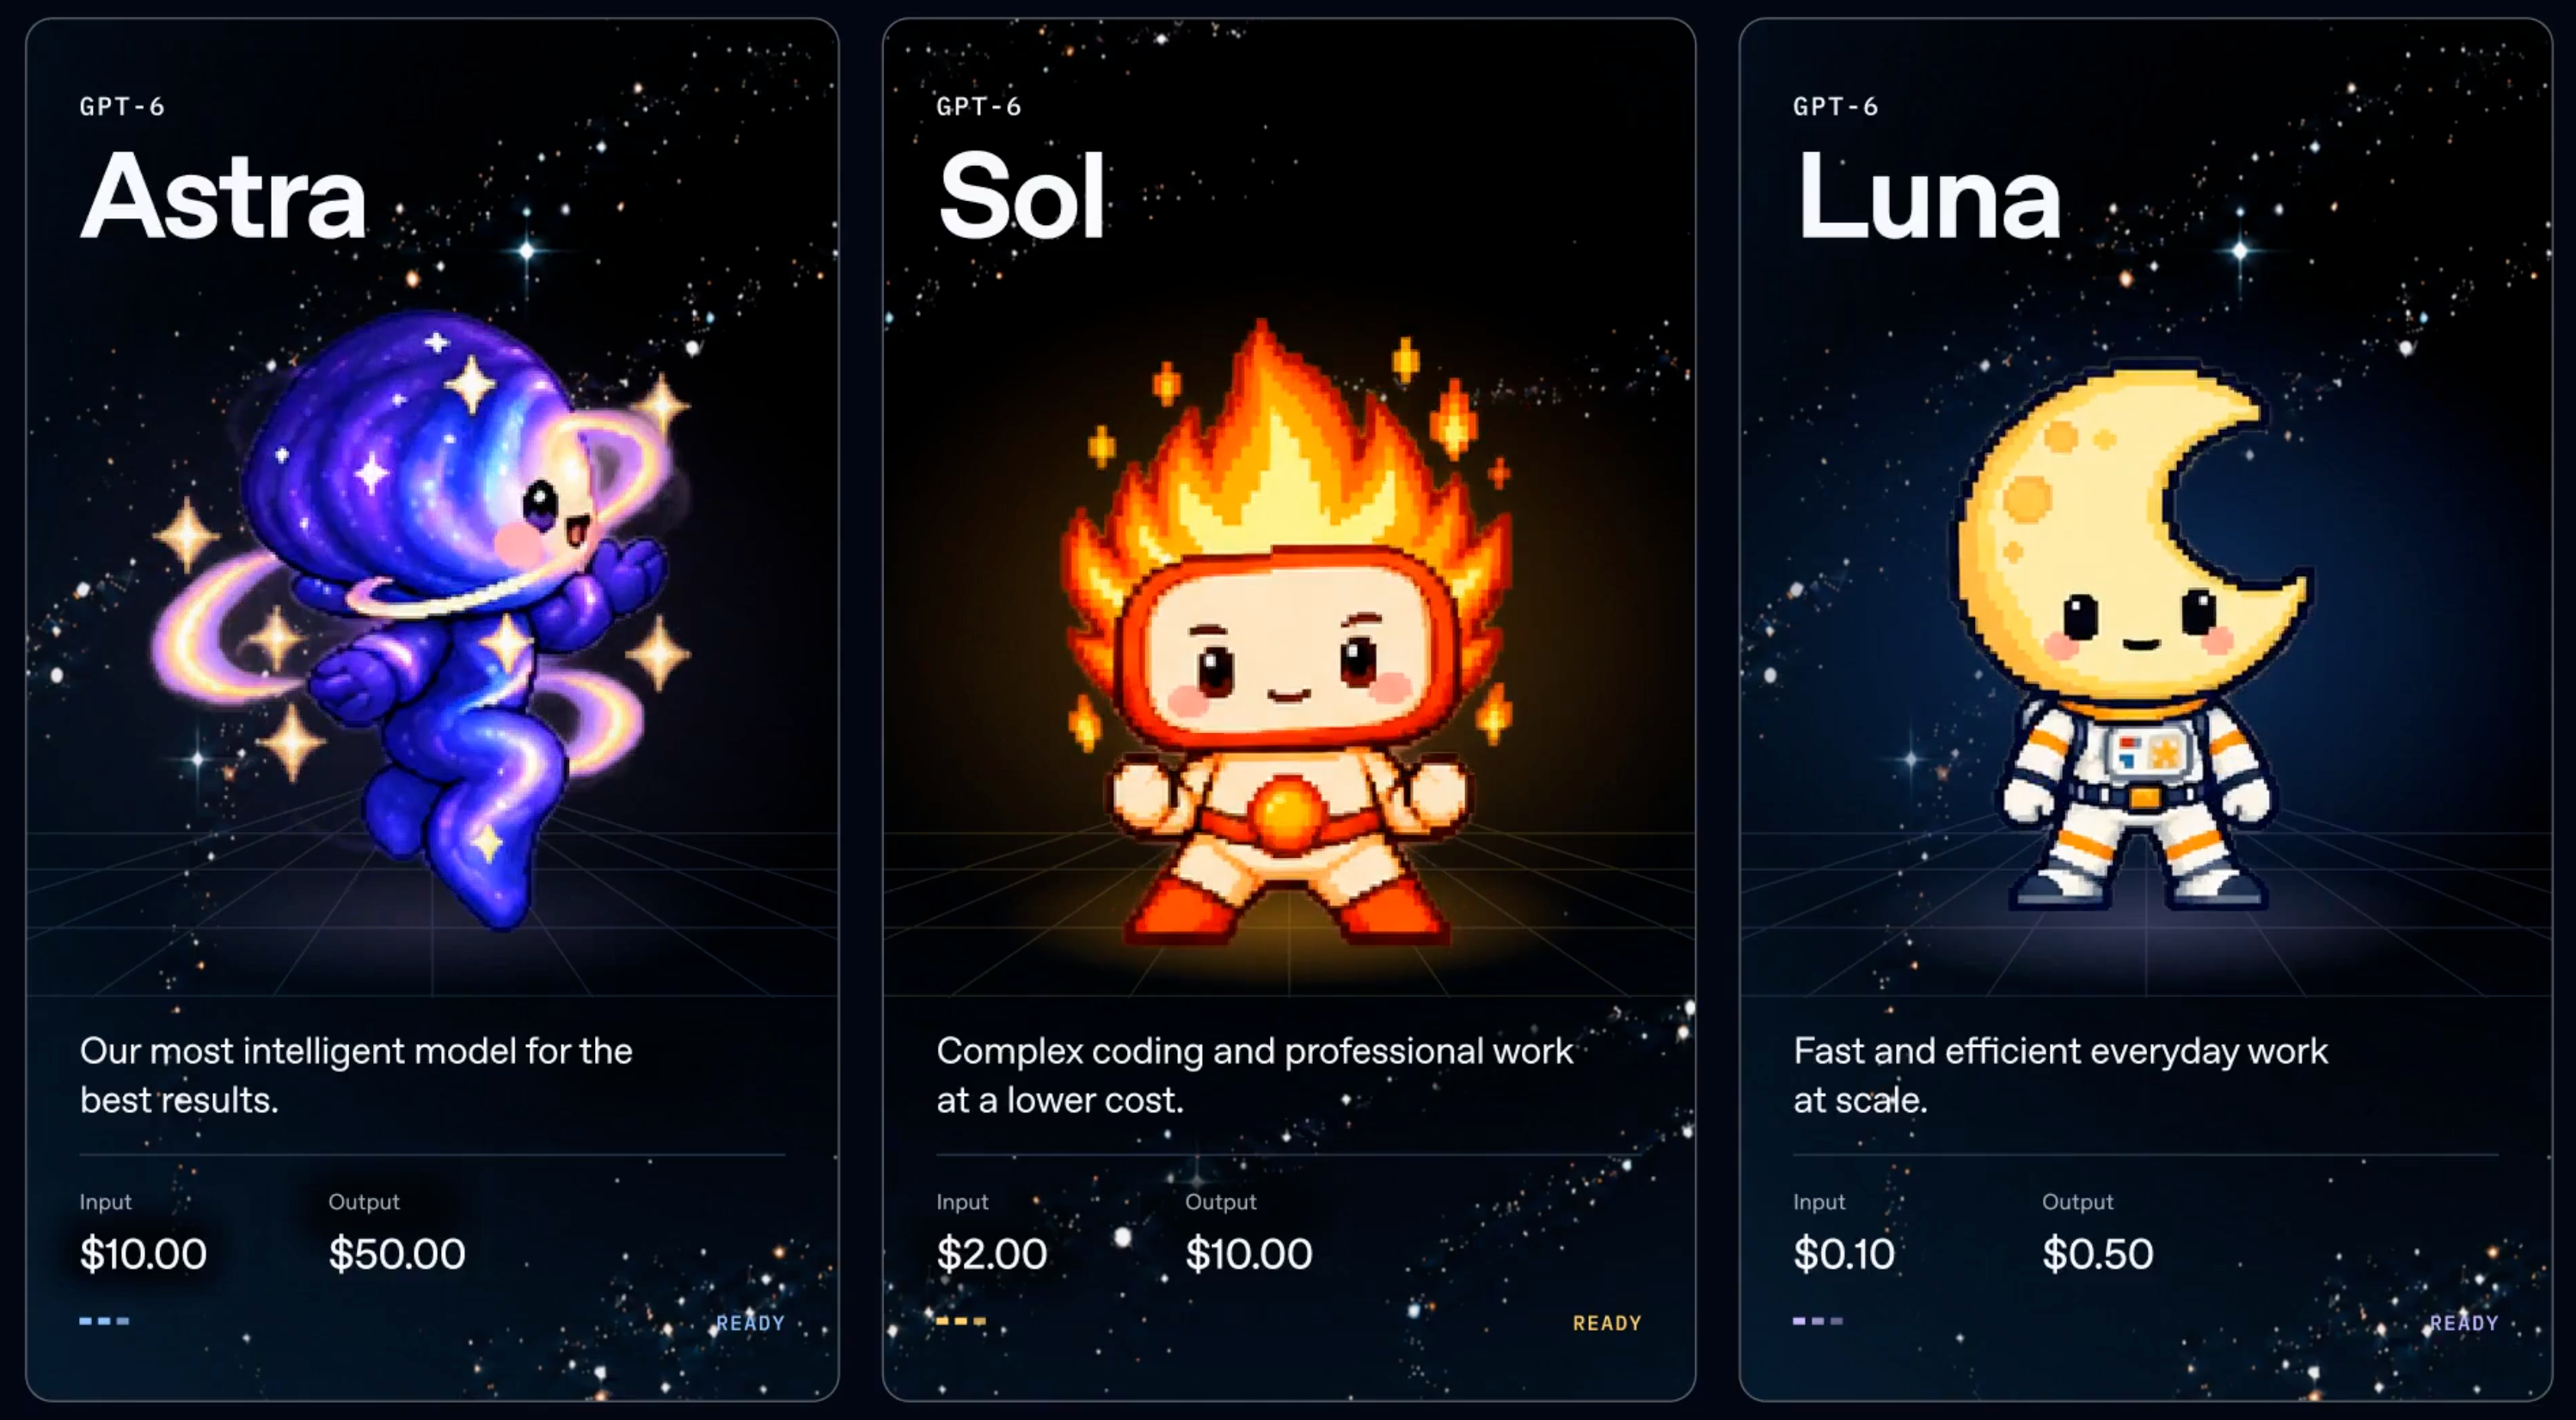
ตัวเลขในใบแจ้งหนี้คือสิ่งที่ปรับลดได้ง่ายที่สุด แต่กลับเป็นตัวเลขที่บอกอะไรได้น้อยที่สุด หากคุณส่งต่องานประจำของ Crew ไปให้ GPT-6 Luna ที่ราคา $0.10 และ $0.50 ต่อ 1 ล้านโทเคน ค่าใช้จ่ายฝั่งโมเดลจะลดฮวบลงในเวลาเพียงวันเดียว สองสัปดาห์ต่อมา บิลค่ายังคงถูกลงอย่างเห็นได้ชัด กระดานงานมีรอบการทำงานที่เสร็จสมบูรณ์มากกว่าที่เคย แต่การเปลี่ยนแปลง 4 รายการจากวันอังคารที่แล้วก็ยังคงค้างเติ่งเพื่อรอคนมากดอนุมัติ
ไม่มีอะไรผิดพลาดเลย คุณแค่ย้ายต้นทุนจากบรรทัดที่คุณคอยจับตา ไปไว้ในบรรทัดที่ไม่มีใครเคยคิดราคาต่างหาก
ต้นทุนต่อการเปลี่ยนแปลงที่ได้รับอนุมัติ (Cost per accepted change) คือเงินและเวลาของมนุษย์ทั้งหมดที่ใช้ไปกับทุกความพยายาม จนนำไปสู่การเปลี่ยนแปลงหนึ่งรายการที่มีคนยอมรับ ตัวเลขนี้รวมรอบการทำงานที่ล้มเหลว ผลลัพธ์ที่ไม่มีใครนำไปรวมโค้ด (merge) และเวลาเป็นนาทีที่ใครบางคนต้องเสียไปเพื่อตัดสินใจเรื่องเหล่านั้น ไม่มีผู้ให้บริการรายใดลงตัวเลขนี้ ไม่มีเกณฑ์มาตรฐาน (benchmark) ไหนวัดผลมันได้ แต่นี่คือตัวเลขเดียวที่สะท้อนถึงสิ่งท่ีทีมของคุณส่งมอบงานได้จริง
สรุปประเด็นสำคัญ (TL;DR)
โมเดลที่ถูกกว่าจะช่วยลดต้นทุนต่อหนึ่งครั้งที่พยายามรัน แต่จะไปเพิ่มสามสิ่งที่ต้องจ่ายด้วยสมาธิและเวลาของผู้ตรวจสอบแทน นั่นคือ จำนวนครั้งที่พยายามต่อการส่งมอบงานหนึ่งชิ้น, ปริมาณเอาต์พุตต่อการพยายามหนึ่งครั้ง และจำนวนการตัดสินใจต่อการส่งมอบงานหนึ่งชิ้น เวลาความสนใจของคนเราไม่ได้ถูกลงตามไปด้วยในวันที่ 2026-09-22 โมเดลระดับประหยัดจะช่วยประหยัดเงินได้จริงก็ต่อเมื่อระบบอัตโนมัติเป็นผู้ตัดสินว่าผลการรันผ่านหรือไม่ แต่จะแอบแพงขึ้นเงียบ ๆ ทันทีที่ต้องใช้คนตัดสินใจ หน้าที่ของ Agent คือการค้นคว้า ลงมือทำ ทดสอบ และรายงานผล ส่วนคนมีหน้าที่กำหนดทิศทาง มอบอำนาจ และตรวจรับผลลัพธ์ ทางแก้จึงเป็นเรื่องของการเปลี่ยนวิธีคิดทางบัญชีก่อนที่จะไปเปลี่ยนระบบเราต์งาน: จงวัดจำนวนครั้งที่พยายามและเวลาของมนุษย์เป็นนาทีต่อการเปลี่ยนแปลงที่อนุมัติ แยกตามแต่ละ Runtime และทำให้สถานะ "งานที่รอคนตรวจสอบ" กลายเป็นสิ่งที่คุณนับและวัดผลได้ แทนที่จะเป็นแค่ความรู้สึกเหนื่อยล้าในวันศุกร์
หน่วยวัดสามแบบ และมีเพียงแบบเดียวที่เป็นของคุณ
| หน่วยวัด | ใครเป็นคนใช้ | บอกอะไรคุณบ้าง | ไม่ได้บอกอะไรคุณ |
|---|---|---|---|
| ต่อหนึ่งล้านโทเคน | หน้าราคาของผู้ให้บริการ | ต้นทุนของอินพุตและเอาต์พุต | งานของคุณต้องใช้โทเคนจำนวนเท่าใด |
| ต่องานที่ทำเสร็จสมบูรณ์ | ตารางเกณฑ์มาตรฐาน (Benchmark) | ต้นทุนของการพยายามหนึ่งครั้งที่ถูกให้คะแนน | ครั้งที่ล้มเหลว, โค้ดเบสของคุณ, เวลาที่ใช้รีวิว |
| ต่อการเปลี่ยนแปลงที่ได้รับอนุมัติ | ทีมของคุณเอง | ต้นทุนทั้งหมดตั้งแต่ต้นจนจบต่องานที่ปล่อยจริงหนึ่งชิ้น | ไม่มีอะไรตกหล่น และนั่นคือเหตุผลที่ไม่มีใครนำมาตีพิมพ์ |
แล็บทั้งสองแห่งเปิดตัวโมเดลในวันที่ 2026-09-22 และต่างรายงานผลลัพธ์ในคอลัมน์ตรงกลาง อย่าอ่านตารางเหล่านั้นประหนึ่งว่ามันคือคอลัมน์ทางขวาสุดเด็ดขาด
โมเดลระดับประหยัดราคาเท่าไร และทำคะแนนได้แค่ไหน
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / output per 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached input | 90% off reads | 90% off reads | $0.20 read, $5 write |
| Context | 1M | 872k | 1M |
| DeepSWE 1.1 at max reasoning | 66.6% | 68.8% | Not in the launch material |
| Artificial Analysis index | 37 | 48 | 58, first of 212 |
Anthropic รายงานคะแนน 40.0% บน AutomationBench สำหรับ Opus 5.5 ขณะที่ OpenAI รายงานผล 33.2% สำหรับ Sol ที่ระดับการใช้เหตุผลแบบสูงพิเศษ (extra high reasoning) บน AutomationBench 1.0.6 ด้วยต้นทุน $0.27 ต่องาน สองแล็บ สองชุดทดสอบ แต่เผยแพร่ต้นทุนต่องานเพียงตัวเลขเดียว การเปรียบเทียบสองสิ่งนี้จึงไม่ใช่การเทียบแบบหมัดต่อหมัด และการที่เราไม่สามารถนำมาเทียบกันตรง ๆ ได้นั่นแหละคือประเด็นสำคัญ: เพราะไม่มีตารางของผู้ให้บริการรายไหนเลยที่จะพาคุณไปถึงต้นทุนต่อการเปลี่ยนแปลงที่ได้รับอนุมัติจริง ๆ ได้
ต้นทุนแฝงข้อที่ 1: จำนวนครั้งที่พยายามต่อการเปลี่ยนแปลงที่ได้รับอนุมัติ
OpenAI ระบุว่า Luna ที่ระดับ max reasoning ทำคะแนนได้ 66.6% บน DeepSWE 1.1 ส่วน Sol ที่ระดับ max ทำได้ 68.8% หากคำนวณตามตัวเลขนี้ จะพบว่าการรันของ Luna ราวหนึ่งในสามครั้งไม่ได้ผลลัพธ์ที่ผ่านเกณฑ์ ที่เก็บโค้ดของคุณไม่ใช่ DeepSWE และอัตราความสำเร็จของคุณย่อมแตกต่างออกไป แต่รูปแบบยังคงเดิม: โมเดลรุ่นประหยัดที่มีคะแนนต่ำกว่าไม่กี่เปอร์เซ็นต์ไม่ได้แปลว่าแย่ลงแค่เล็กน้อยในแต่ละรอบ แต่มันเพิ่มโอกาสที่จะส่งมอบงานที่ยังต้องเอากลับไปวนทำใหม่อีกรอบ
ค่าใช้จ่ายในรูปของตัวเงินสำหรับการวนทำใหม่นั้นยังคงน้อยมาก OpenAI รายงานว่า Luna ที่ระดับ max ประหยัดกว่า Claude Opus 5 ถึง 93% ต่องานบนเบঞ্চมาร์กเดียวกัน ต่อให้ต้องลองรันเพิ่มเป็นสองเท่า จากการคำนวณของเรา คุณก็ยังคงประหยัดกว่าเดิมราว 86% ค่าใช้จ่ายในบรรทัดของโมเดลไม่มีวันกลายมาเป็นปัญหา
แต่รอบการทำงานที่ล้มเหลวไม่ได้ฟรีสำหรับส่วนอื่น ๆ ของงานเลย มันสร้าง branch ใหม่ขึ้นมา สร้างสรุปการเปลี่ยนแปลง และสร้างภาระการตัดสินใจที่ตกเป็นของมนุษย์ การรันที่ล้มเหลวจึงไม่ใช่ค่าเท่ากับศูนย์ แต่มันคืองานที่ต้องตรวจรีวิวชิ้นหนึ่งซึ่งไม่มีการเปลี่ยนแปลงใด ๆ เกิดขึ้นจริงในตอนท้าย
ต้นทุนแฝงข้อที่ 2: โมเดลราคาประหยัดเก่งขึ้นได้เพราะใช้เวลาคิดนานขึ้น
ลองดูที่มาของตัวเลขผลงานที่ดีของ Luna ดูสิ คะแนน 66.6% นั้นได้มาจากการตั้งค่า reasoning ไว้สูงสุด และหมายเหตุเรื่องความถูกต้องของข้อเท็จจริงของ OpenAI ระบุว่า Luna ที่ใช้ความพยายามสูงขึ้นสามารถทำผลงานเทียบเท่า GPT-5.6 Sol ได้โดยมีต้นทุนเพียงประมาณหนึ่งในร้อยเท่านั้น โมเดลระดับประหยัดจะบรรลุคุณภาพที่ยอมรับได้ก็ต่อเมื่อทุ่มเทความพยายามมากขึ้น และความพยายามนั้นก็สะท้อนออกมาในรูปของโทเคนเอาต์พุตและเวลาจริงที่สูญเสียไป
Artificial Analysis ซึ่งเป็นหน่วยงานภายนอกที่ไม่ใช่ทั้งสองบริษัท ได้วัดผลรุ่นย่อยที่ใช้ reasoning สูงสุด พบว่า Luna สร้างเอาต์พุตได้ 153.9 โทเคนต่อวินาที โดยใช้เวลา 124.23 วินาทีกว่าจะเริ่มสร้างโทเคนแรก ขณะที่ Sol ทำได้ 115.2 โทเคนต่อวินาที โดยใช้เวลา 102.15 วินาที ตัวเลขเหล่านี้ใช้เป็นแนวทางอ้างอิง: เป็นข้อมูลจากภายนอก เจาะจงเฉพาะรุ่นที่เปิดโหมด max reasoning และเปลี่ยนแปลงได้ตามที่แล็บมีการวัดผลใหม่
ผลกระทบสองประการตกมาอยู่ที่ทีมของคุณโดยตรง ไม่ได้ปรากฏบนใบแจ้งหนี้ ประการแรก การรันที่เงียบไปเฉย ๆ นานสองนาทีดูไม่ต่างอะไรจากการรันที่ระบบค้าง จึงต้องมีใครสักคนคอยเข้าไปเช็กดู และประการที่สอง ขั้นตอนการคิดที่ยาวขึ้นพร้อม diff โค้ดที่ยาวขึ้น หมายความว่ามีสิ่งที่ต้องอ่านมากขึ้นในแต่ละครั้งที่รัน ก่อนที่ใครจะกดอนุมัติได้ เวลาในการอ่านคือทรัพยากรที่หายาก และคุณเพิ่งซื้อสิ่งที่เผาผลาญเวลานั้นเข้ามาเพิ่มขึ้นเรื่อย ๆ
ต้นทุนแฝงข้อที่ 3: ภาระการตัดสินใจ ไม่ใช่แค่การตรวจ diff
ลองนับจำนวนการตัดสินใจของมนุษย์ระหว่างช่วงที่ Task ถูกมอบหมายไปจนถึงช่วงที่การเปลี่ยนแปลงได้รับการอนุมัติ หากใช้ Runtime ตัวท็อป เส้นทางมักจะมีขั้นตอนเดียว: อ่านแล้วกดรับ แต่เมื่อใช้ Runtime ราคาประหยัดกับงานที่ไม่สามารถตรวจสอบความถูกต้องได้แบบอัตโนมัติ เส้นทางจะแตกแขนงออกไป และทุกแขนงล้วนต้องใช้คนเข้ามาจัดการ:
- การรันล้มเหลว จะลองใหม่บน Runtime เดิม หรือจะส่งต่อให้ตัวที่เก่งกว่า?
- การรันผ่านแบบทดสอบทั้งหมด แต่วิธีการที่ใช้ไม่ใช่แนวทางที่คุณต้องการ จะกดรับ หรือส่งกลับไปแก้?
- การรันให้ผลลัพธ์มาสามส่วนแบบไม่สมบูรณ์ ชิ้นไหนคือการเปลี่ยนแปลงที่แท้จริง?
- การรันหยุดชะงักเพื่อตั้งคำถาม ใครจะเป็นคนตอบ และคำตอบนั้นต้องบันทึกไว้ที่ไหน?
สิ่งเหล่านี้ไม่มีรายการปรากฏในบิลค่าโทเคน แต่ทั้งหมดจะไปเบียดเบียนตารางเวลาของใครก็ตามที่ต้องรับผิดชอบการตรวจทานโดยมนุษย์ (human review)
ผลรวม เมื่อแทนค่าด้วยตัวเลขของคุณเอง
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
ลองแทนค่าด้วยตัวเลขจริงของคุณเอง ไม่ใช่ตัวเลขของเรา ที่ราคา $0.10 และ $0.50 ต่อ 1 ล้านโทเคน ค่าใช้จ่ายของโมเดลในวงเล็บแทบจะปัดเศษเป็นศูนย์ได้เลย ดังนั้นสมการนี้จึงถูกควบคุมด้วยจำนวนนาทีของผู้ตรวจคูณด้วยจำนวนครั้งที่พยายาม การเปลี่ยนไปใช้ Runtime ที่ถูกกว่าจึงเป็นการลดค่าใช้จ่ายในบรรทัดที่เล็กอยู่แล้ว แต่กลับไปทวีคูณบรรทัดที่ไม่ได้เล็ก บางครั้งนี่อาจยังเป็นการแลกเปลี่ยนที่คุ้มค่า แต่มันไม่มีทางประเมินได้จากแค่หน้าราคาค่าบริการเพียงอย่างเดียว
เมื่อใดที่โมเดลระดับประหยัดจะช่วยประหยัดได้จริง
เลือกใช้ Runtime ราคาประหยัดเมื่อระบบอัตโนมัติสามารถตัดสินได้ว่าความพยายามนั้นผ่านหรือไม่ การตรวจสอบชนิดข้อมูล (Typecheck), การทดสอบย่อย (Unit test), การบิลด์, กฎ Lint หรือการตรวจโครงสร้างข้อมูล (Schema check): คำตัดสินเหล่านี้เกิดขึ้นก่อนที่มนุษย์จะต้องเสียสมาธิลงไปดู และจำนวนครั้งที่ต้องพยายามซ้ำจะถูกดูดซับโดยระบบทดสอบอัตโนมัติ ไม่ใช่เบียดเบียนเวลาในวันศุกร์ของคุณ นั่นคืองานส่วนใหญ่ใน Crew ที่กำลังทำงานอยู่ และเป็นเหตุผลอันสมควรในการเราต์งานจำเจ 80% ไปให้ Luna
อย่าใช้ Runtime ราคาประหยัดเมื่อการอนุมัติงานต้องอาศัยวิจารณญาณส่วนบุคคล การตัดสินใจเชิงสถาปัตยกรรม, การย้ายข้อมูล (Data migration), งานใด ๆ ที่เกี่ยวข้องกับความปลอดภัย หรือเรื่องใดก็ตามที่คำถามประเภท "แบบนี้ถูกต้องหรือไม่?" ไม่สามารถหาคำตอบได้ด้วยคำสั่งคอมมานด์เพียงคำสั่งเดียว ช่องว่างของคะแนนประสิทธิภาพจะแปลงสภาพไปเป็นเวลาของผู้ตรวจสอบทันที และสิ่งที่คุ้มค่าที่สุดที่คุณจะซื้อได้ก็คือรอบการทำงานที่คุณต้องอ่านเพียงรอบเดียวเท่านั้น
เขียนกฎการส่งต่องาน (escalation rule) ไว้ให้ชัดเจนเป็นลายลักษณ์อักษร อย่าปล่อยให้ขึ้นอยู่กับความชอบส่วนบุคคล เพราะความชอบมักพ่ายแพ้ให้กับราคาที่ถูกกว่าเสมอ การเลือกโมเดล (Model routing) คือกฎที่คำนึงถึงความสามารถในการตรวจพิสูจน์ได้เป็นอันดับแรก แล้วเรื่องต้นทุนจึงค่อยตามมาทีหลัง
ทำไมไม่มีผู้ให้บริการรายไหนบอกเรื่องนี้กับคุณ
แล็บทั้งสองแห่งต่างเผยแพร่ผลทดสอบเทียบกันในวันเดียวกัน โดยเกณฑ์เปรียบเทียบของ OpenAI คือ Claude Opus 5 ซึ่งเพียงไม่กี่ชั่วโมงต่อมา Anthropic ก็นำ Opus 5.5 มาแทนที่ โมเดลระดับประหยัดของผู้ให้บริการทุกรายคือส่วนบนสุดของช่องทางการขาย (funnel) ของตนเอง ไม่มีใครออกมายอมรับหรอกว่า "โมเดลรุ่นประหยัดของเราจะทำให้ผู้ตรวจสอบของคุณต้องตรวจซ้ำเพิ่มอีกรอบ" และพวกเขาก็ไม่ได้ผิดที่ไม่ระบุไว้ เพราะตัวเลขขึ้นอยู่กับโค้ดเบสและบุคลากรของคุณเอง
Sharkly ไม่ได้ขายโทเคนของโมเดล การใช้งานโมเดลยังคงดำเนินต่อไปผ่านแพ็กเกจสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือที่ทีมของคุณใช้อยู่แล้ว ดังนั้นเนื้อหาในบทความนี้จึงไม่มีส่วนได้ส่วนเสียกับ Runtime ที่คุณเลือกใช้ นี่เป็นจุดยืนเดียวที่ทำให้เราพูดเรื่องนี้ได้อย่างตรงไปตรงมา และเป็นเหตุผลเดียวกับที่ทำให้เวิร์กโฟลว์ของคุณควรอยู่รอดต่อไปได้เมื่อมีโมเดลราคาถูกตัวถัดไปเปิดตัว โดยไม่ต้องรื้อสร้างใหม่ทั้งหมด
สิ่งที่คุณควรนำมาแสดงบนแดชบอร์ดแทน
เวลาของมนุษย์ (นาที) ต่อการเปลี่ยนแปลงที่ได้รับอนุมัติ แยกตาม Runtime หากตัวเลขนี้พุ่งสูงขึ้นหลังการเปลี่ยนโมเดล แสดงว่าโมเดลที่ถูกกว่านั้นแท้จริงแล้วทำให้ต้นทุนแพงขึ้น และตอนนี้คุณมีหลักฐานยืนยันแล้ว ตัวเลขค่าใช้จ่ายต่อรอบการทำงานเป็นคำตอบของคำถามที่เลิกมีความสำคัญไปแล้วตั้งแต่วันที่ 2026-09-22
จำนวนครั้งที่พยายามต่อการเปลี่ยนแปลงที่ได้รับอนุมัติ แยกตาม Runtime ตัวแปรนี้เป็นตัวกำหนดทุกสิ่งทุกอย่าง และไม่มีผู้ให้บริการรายใดมอบให้คุณได้ คุณจะได้มาก็ต่อเมื่อบันทึกว่า Runtime ใดเป็นผู้สร้างความพยายามในแต่ละรอบ บน Task นั้น ๆ
ทำให้ "การรอคนตรวจสอบ" เป็นสถานะงานจริง ไม่ว่าจะเป็นการทำงาน, อุปสรรคที่ติดขัด, ผลลัพธ์ และการพูดคุยติดตามผล ล้วนต้องส่งกลับมายังไทม์ไลน์ของ Task เพื่อให้คิวงานที่ต้องใช้คนสามารถนับจำนวนได้จริง แทนที่จะเป็นเพียงเรื่องเล่าลอย ๆ กำหนดให้การรันแต่ละครั้งต้องแนบหลักฐานมาด้วยเสมอ:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
หากทำงานในสเกลเล็ก คุณไม่จำเป็นต้องมีสิ่งเหล่านี้เลย หากคนคนเดียวรัน Agent สองตัวแล้วสามารถนั่งอ่านตรวจทานทุกอย่างเสร็จภายในบ่ายวันเดียวกัน ก็ทำแบบนั้นต่อไปได้ เพราะการจัดการสถานะและคิวงานถือเป็นภาระส่วนเกินสำหรับปัญหาที่คุณยังไม่ได้เผชิญ แต่ระบบการคิดคำนวณเช่นนี้จะเริ่มมีความสำคัญทันทีที่ไม่มีใครสามารถบอกได้จากความจำอีกต่อไปว่า มีงานที่รันเสร็จแล้วกี่ชิ้นที่กำลังค้างรอคนมาดู
ส่วนที่ไม่ได้มีราคาถูกลงเลย
สองแล็บตัดราคาต้นทุนต่อความพยายามลงพร้อมกันในวันเดียว แต่ไม่มีใครเปิดตัวระบบที่มานั่งอ่าน diff แทนคุณ และความรับผิดชอบในการตรวจรับงานยังคงต้องจบลงที่มนุษย์เสมอ โมเดลที่ถูกลงไม่ได้หมายถึงเวิร์กโฟลว์ที่ถูกลง มันเป็นเพียงความพยายามที่ถูกลง และความพยายามเหล่านั้นก็ถูกป้อนเข้าสู่กระบวนการที่ขั้นตอนอันแสนแพงยังคงต้องพึ่งพาคน
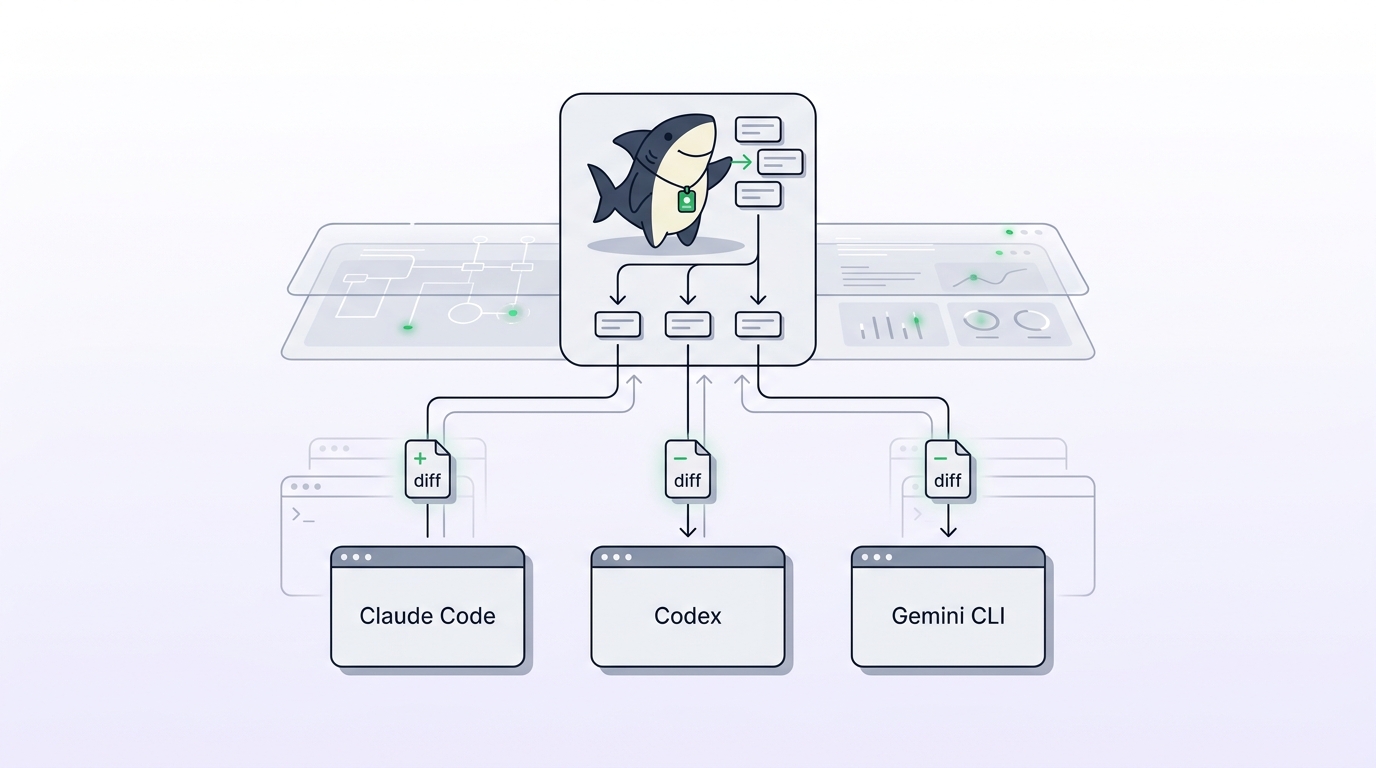
หากคุณใช้งานเอเจนต์ช่วยเขียนโค้ดอยู่หลายตัว Sharkly มีพื้นที่ศูนย์กลางให้คุณเห็นได้ในที่เดียวว่า Runtime ใดสร้างการรันครั้งไหนขึ้นมา มีหลักฐานอะไรแนบมาบ้าง และตอนนี้มีงานกองรอให้คนมาตรวจสอบอยู่มากน้อยเพียงใด