OpenAI, 29 Eylül'deki DevDay etkinliğinde GPT-6.1 Sol modelini GPT-6 Sol ile aynı liste fiyatıyla kullanıma sundu: 1 milyon girdi token'ı için 2 $, 1 milyon çıktı token'ı için 10 $ ve yarı yarıya indirilerek 0,10 $'a düşen önbelleğe alınmış girdi fiyatı. Birden fazla Codex agent'ı çalıştıran bir ekip için en kritik detay ise çok daha sessiz sedasız gerçekleşti. Codex CLI belgelerindeki açılış ekranında artık gpt-6.1-sol medium yazıyor. Belirli bir modeli sabitlemeyen herhangi bir Computer üzerinde, siz planladığınız için değil, birisi o Computer'daki Codex'i güncellediği anda Agent'larınızın kullandığı model de değişir.
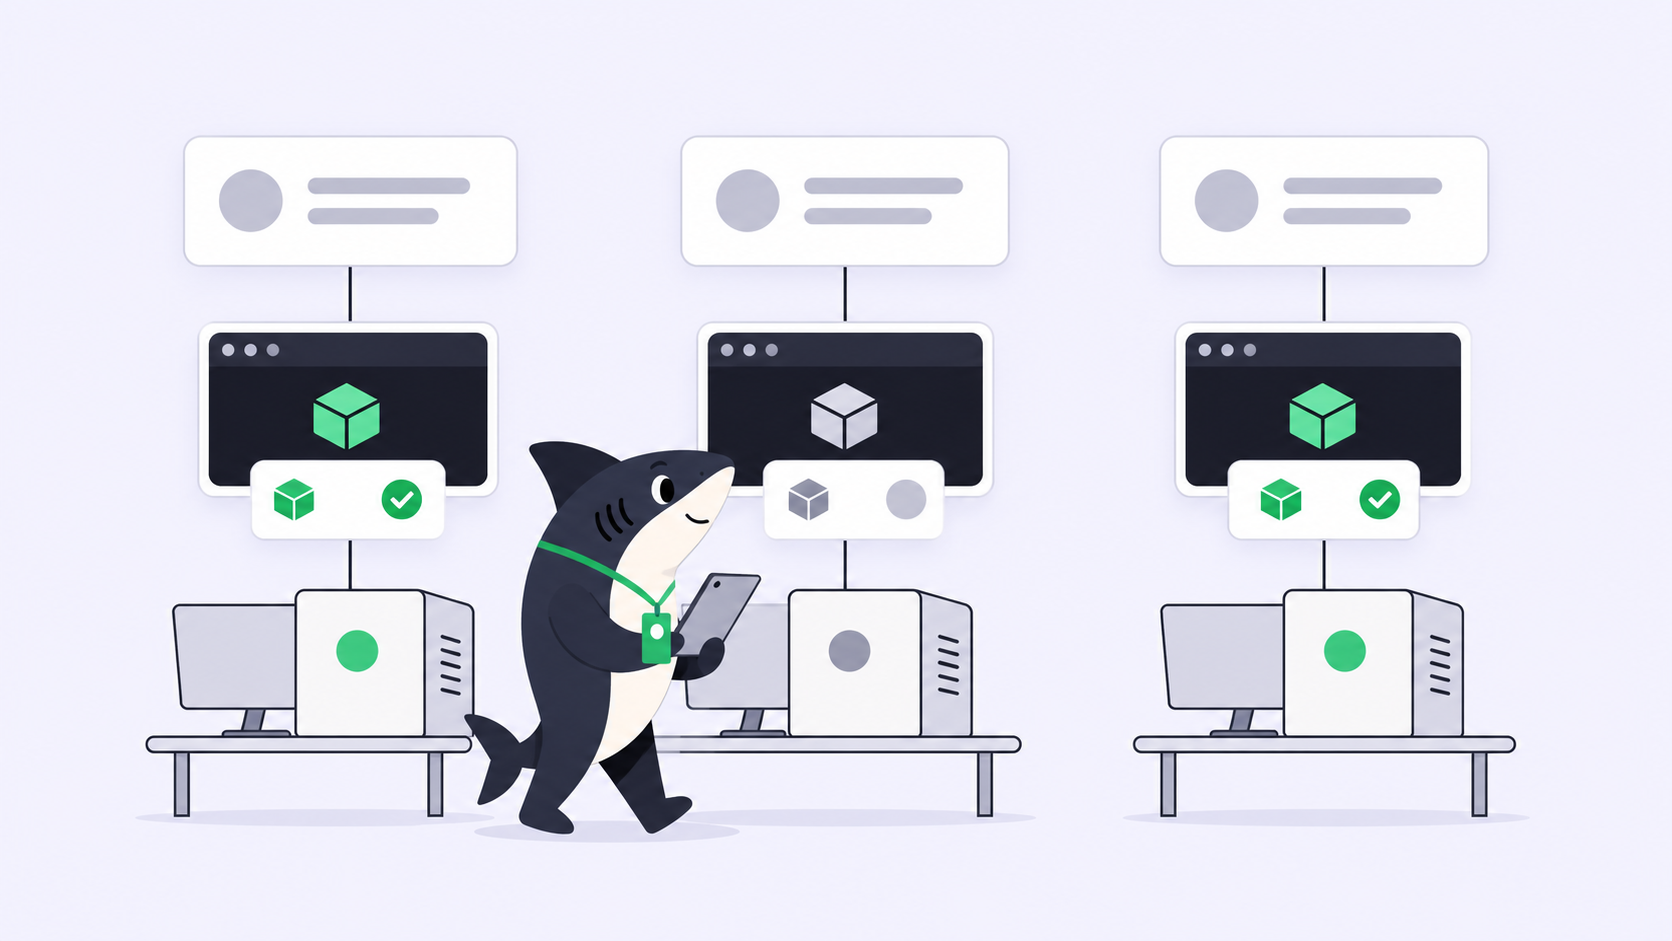
Sharkly bu değişikliği göstermez. Agent, Runtime'ın varsayılan modelini izler ve herhangi bir model adı görüntülemez; bu nedenle bu haftadan sonra, panoda Task'ları tamamen aynı görünürken iki farklı Computer üzerinde birebir aynı talimatlara sahip iki Agent farklı modeller çalıştırabilir. Hangi agent'ın hangi modeli kullandığı ve hangi sonucun hangisinden çıktığı, yalnızca hafızaya güvenilerek yanıtlanabilen bir soruya dönüşür. Bu rehber, yalnızca GPT-6 Sol rehberimizden bu yana gerçekleşen farkları ele almaktadır: yeni varsayılan modelin nereden geldiği, ne zaman sabitlenmesi gerektiği, yeri değişen iki ayar ve orta segment artık zirveye daha yakınken bir Crew'un işleri nasıl yönlendirmesi gerektiği.
Özetle (TL;DR)
GPT-6.1 Sol, Sharkly'ye bir Computer üzerindeki Codex Runtime aracılığıyla ulaşır ve bu gerçekleştiğinde Sharkly tarafında hiçbir şey değişmez. Her bir Computer'ın hangi Codex derlemesini (build) çalıştırdığını ve ~/.codex/config.toml dosyasında bir model sabitleyip sabitlemediğini kontrol edin. Sabitleme yapılmamış Computer'lar, belgelerde artık orta eforda (medium effort) gpt-6.1-sol olarak belirtilen CLI varsayılanını izler. Önceki rehberimize göre kurulan Computer'lar ise birisi tek bir satırı düzenleyene kadar gpt-6-sol sürümünde kalır. Varsa none efor ayarını low ile değiştirin; yarıya inen önbellek fiyatının plan girişleri yerine API anahtarı kullanan Computer'lara yansıyacağını unutmayın ve aşağıdaki yönlendirme tablosunu kesin bir kural olarak değil, kendi Task'larınızda test etmeniz gereken bir başlangıç noktası olarak değerlendirin.
Codex Runtime tarafında neler değişti?
Agent belgeleri, bu yazının neden Agent'lardan çok Computer'larla ilgili olduğunu açıklar: “Agent, Runtime'ın varsayılan modelini izler. Belirli bir model adı taahhüt etmez veya görüntülemez. Modelleri Agent üzerinde değil, Runtime veya Computer araç yapılandırmasında değiştirin.” Dolayısıyla bu yükseltme, doğrudan Runtime düzeyinde gerçekleşen bir olaydır. İşte bir Crew'un hissedeceği temel farklar:
| GPT-6 Sol | GPT-6.1 Sol | Ne yapılmalı | |
|---|---|---|---|
| Model ID | gpt-6-sol |
gpt-6.1-sol |
Her Computer için karar verin: sabitleyin veya varsayılanı izleyin |
| 1M başına girdi / çıktı | 2 $ / 10 $ | 2 $ / 10 $ | Hiçbir şey |
| 1M başına önbelleğe alınmış girdi | 0,20 $ | 0,10 $ | Bir API anahtarına faturalandırılan uzun çalıştırmalarda fark yaratır |
| Akıl yürütme eforu | none ile max arası, varsayılan medium |
low ile max arası, varsayılan medium; none veya minimal yok |
none ayarını low olarak değiştirin, ardından sonuçları yeniden kontrol edin |
| Bilgi kesilme tarihi | 20 Nisan 2026 | 30 Nisan 2026 | On gün daha yeni; çoğu kod deposu için önemsiz bir fark |
| Erişim | Plus, Pro, Business, Enterprise, Edu | Aynı; ChatGPT Work ve Codex içinde mevcut, Chat'te yok; Enterprise ve Edu için bir yönetici etkinleştirene kadar varsayılan olarak kapalı | Enterprise ve Edu Computer'ları için önce bir yönetici onayı gerekebilir |
Yenilenen Codex CLI; tüm planlara ses desteği, bir /agents görünümü, prompt düzenleme, sürdürme (resume) ve worktree özelliklerini de ekledi. Codex'i bir terminalden manuel olarak kullandığınız her an bunlardan yararlanmaya değer. Ancak iş bir kez ekibin sorumluluğuna geçtiğinde, paylaşılan ortak kayıt Task olur. Sharkly, Geçici (Temporary) modda her Task'a kendi özel dizinini atar; kod deposu çalışmaları için temiz bir worktree hazırlayabilir ve çalıştırmanın durumu, günlükleri (log), soruları ve sonuçları bir sonraki kişinin kolayca bulabilmesi için doğrudan Task'a iletilir.
Modeli sabitlemek mi, yoksa her Computer'ın varsayılanı izlemesine izin vermek mi?
İşe bir envanter çıkararak başlayın, çünkü verilecek yanıt Computer bazında değişiklik gösterebilir. sharkly computer list komutu kuruluşunuza kayıtlı Computer'ları listeler; sharkly computer show <computer-id> ise belirli bir Computer'ı sahip olduğu Runtime'lar ile birlikte döndürür. Computer'ın bizzat üzerinde codex komutunu çalıştırmak, derleme (build) ve model bilgilerini ekrana basar. Codex değişiklik günlüğü, 0.159.1 sürümünün (29 Eylül) GPT-6.1 Sol'u varsayılan yaptığını ve belgelerdeki örnek oturumun model: gpt-6.1-sol medium şeklinde olduğunu gösteriyor.
İki noktaya dikkat edin. Birincisi, hangi ikili dosyanın (binary) çalıştığı. macOS üzerinde, tek başına kurulmuş bir Codex bulunmayan bir Computer, ChatGPT masaüstü uygulamasının içine gömülü Codex CLI'ı kendi Runtime'ı olarak kaydedebilir; oysa Sharkly belgeleri bizzat kurup PATH ortam değişkenine eklediğiniz bir Codex'i kullanmanızı önerir. İkincisi ise modeli hangi yapılandırma katmanının belirlediğidir. Codex yapılandırma temelleri; kişisel varsayılanları ~/.codex/config.toml dosyasına yerleştirir, bir kod deposunun kendi .codex/config.toml dosyasıyla bunları geçersiz kılmasına izin verir (yalnızca güvenilen projeler için yüklenir) ve komut satırındaki -m veya --model parametresinin her ikisine de baskın gelmesini sağlar.
Karar verirken şu iki senaryoyu göz önünde bulundurun: Bir Computer yalnızca tek bir kişiye aitse, haftada sadece birkaç Task çalıştırıyorsa ve o kişi bir yapılandırma satırını yönetmek yerine OpenAI'ın önerdiği modeli takip etmeyi tercih ediyorsa, Computer'ın varsayılanı izlemesine izin verin. Ancak o Computer üzerindeki Agent'lara birden fazla kişi iş atıyorsa, bir Crew birden fazla Computer'a yayılıyorsa veya sessiz bir model değişikliğinin Salı günkü sonuç ile Perşembe günkü sonucu Task üzerinde aslında farklı oldukları halde aynı gibi gösterme riski taşıdığı bir Sprint'in ortasındaysanız, modeli mutlaka sabitleyin.
Modeli sabitlemek için, Codex Runtime'ı çalıştıran Computer üzerindeki kullanıcı yapılandırmasını düzenleyin:
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
Her iki anahtar da Codex yapılandırma belgelerinde bu değerlerle yer almaktadır. GPT-6 Sol rehberimizi uyguladıysanız, ilgili dosyada zaten model = "gpt-6-sol" yazıyordur ve o Computer güncelleme sonrasında kendiliğinden yeni modele geçmez. Bu satırı önceden değil, yalnızca hazır olduğunuzda değiştirin.
Codex'i, belgelerin hem kurulum hem de güncelleme için kullandığı yükleyici ile güncelleyin veya Sharkly'den belirli bir Runtime için CLI güncellemesi istemesini talep edin:
curl -fsSL https://chatgpt.com/codex/install.sh | sh
# or, from anywhere with the Sharkly CLI:
sharkly computer update <computer-id> <runtime-id>
Ardından Computer ayrıntılarında yeniden tarama (rescan) veya bağlantı testini çalıştırın ve Codex Runtime durumunun Available (Kullanılabilir) olarak göründüğünü doğrulayın. Son olarak, sabitlenen modeli Agent'ın açıklamasına yazın. Bir diff incelemesi yapan kişinin, kodu hangi modelin yazdığını öğrenmek için bir Computer üzerinde kabuk (shell) oturumu açmak zorunda kalmaması gerekir.
Değişen iki ayar: efor ve önbellek
none seçeneği artık yok. GPT-6.1 Sol; low, medium, high, xhigh ve max değerlerini kabul ederken none veya minimal değerlerini desteklemez. Yapılandırmasında, GPT-6 Sol için hızlı bir işlem hattında doğal bir tercih olan none ayarını kullanan bir Computer'ın geçiş yapmadan önce low değerine çekilmesi gerekir; ayrıca sonuçları tekrar incelemekte fayda var çünkü low seviyesi hâlâ akıl yürütme (reasoning) gerçekleştirir. Eski ayar nedeniyle bir çalıştırma başarısız olursa, yürütme günlüğü başlığı ve model servisinin orijinal yanıtını saklar. Sharkly'nin desteklenmeyen bir seçenek için sorun giderme kılavuzu, körü körüne yeniden denemek yerine model ve istek seçeneklerini kontrol etmeyi önerir.
Önbellek tarafındaki kazanım ise daha arka planda kalan bir avantaj. OpenAI, önbelleğe alınmış girdiyi milyon başına 0,10 $ olarak fiyatlandırıyor; bu da “standart girdi fiyatlandırmasından %95, GPT-6 Sol'un önbelleğe alınmış girdi fiyatlandırmasından ise %50 daha düşük.” Bu fark özellikle uzun süre çalışan Agent'larda kendini gösterir. Bir kod deposu üzerinde bir saat boyunca çalışan bir görev, aynı bağlamın büyük bir kısmını tekrar tekrar gönderir; aynı depo düzeni, kurallar ve test komutlarıyla işe başlayan Crew üyeleri de gün boyu aynı öneki (prefix) yeniden kullanır.
Gerçekçi bir değerlendirme için dikkat edilmesi gereken üç önemli nokta var. Birincisi, token başına tasarruf yalnızca Codex'in faturayı bir API anahtarına kestiği Computer'larda geçerlidir; bir ChatGPT planıyla oturum açmış bir Computer ise bunun yerine plan kullanım kotasını harcar ki bu konu API anahtarı olmadan GPT-6.1 Sol çalıştırma başlıklı kardeş yazımızın konusudur. İkincisi, liste fiyatı değişmediği için önbelleğe alınmamış işlemler geçen haftakiyle aynı maliyettedir. Üçüncüsü ise uzun bağlamların ek ücrete tabi olmasıdır: OpenAI, 272 bin girdi token'ını aşan tüm istemleri (prompt) tüm istek boyunca girdi ve önbellek birim fiyatlarının 2 katı, çıktı birim fiyatının ise 1,5 katı üzerinden ücretlendirir; bu yüzden her adımda devasa bir bağlamı peşinden sürükleyen bir Agent'a daha büyük bir bütçe tanımlamadan önce daha küçük ve kararlı bir önek sağlamak gerekir.
Crew yönlendirmesi: Astra, 6.1 Sol, Luna veya Claude Runtime
OpenAI'ın 6.1 Sol konusundaki temel tezi, Astra'ya yakın sonuçları maliyetin küçük bir kısmıyla sunabilmesidir ve bu iddianın arkasındaki tüm veriler OpenAI'ın kendi test çalıştırmalarından gelir. DeepSWE v1.1 kıyaslamasında OpenAI, 6.1 Sol'un yaklaşık beşte bir maliyetle Astra'yı yakaladığını ve daha düşük eforla GPT-6 Sol'un en iyi skorunu 6,4 puan geride bıraktığını belirtiyor. Bir bilgisayar kullanımı (computer-use) testi olan OSWorld 2.0'da ise maksimum eforda, görev başına yaklaşık yedide bir maliyetle Astra'nın 2,1 puan gerisinde yer alıyor. OpenAI bu sınır konusunda da oldukça açık: Astra, %68,1 ile Terminal-Bench Science kıyaslamasında hâlâ en yüksek skora sahip ve OpenAI en zorlu bilimsel çalışmalar için Astra'nın kullanılmasını öneriyor.
OpenAI'ın model seçimi rehberi de ürün ailesini benzer şekilde sıralıyor: belirsiz problemler için Astra, zaman ve maliyetin önem taşıdığı karmaşık işler için 6.1 Sol, kapsamı belirli görevler ve triyaj için Luna. Üstelik OpenAI bu rehberin yalnızca bir başlangıç noktası olduğunu belirtiyor. Model doğrudan Runtime yapılandırmasında tanımlandığı için, Sharkly'deki bir yönlendirme kuralı aslında Computer'larla ilgili bir kuraldır: Codex varsayılanı Astra olan bir Computer'a bağlı bir Agent, Astra modelini çalıştırır. Test edebileceğiniz örnek bir başlangıç kuralı:
| Crew rolü | Başlangıç | Ne zaman değiştirilmeli |
|---|---|---|
| Belirsiz bir hedefi yorumlayan lider | GPT-6 Astra üzerinde Codex | Planlar tüm bir Sprint boyunca rutine bindiğinde; 6.1 Sol'u deneyin |
| Kapsamı belirli özellikler, yeniden üretilebilen hatalar ve tek modüllü yeniden düzenlemeler (refactor) üzerinde çalışan üyeler | GPT-6.1 Sol (medium) üzerinde Codex | Belirli bir Task türü iki kez başarısız olduğunda; bir kişi seviyeyi yükseltir (eskalasyon) |
| En zorlu Task'lar (başarısız olan 6.1 Sol çalıştırmaları dahil) | GPT-6 Astra üzerinde Codex | Asla otomatik olarak değil; Task'ı bir kişi taşır |
| Triyaj, etiketleme, temel kod iskeleti (scaffolding), bağımlılık güncellemeleri | GPT-6 Luna üzerinde Codex | İnceleyenler çıktıları baştan yazmaya başladığında |
| Ekibinizin hâlihazırda Claude'a güvendiği işler veya ikinci bir sağlayıcıdan inceleme | Claude Code | Kendi yaptığınız karşılaştırma aksini gösterdiğinde |
Son satır bir kıyaslama (benchmark) iddiası değil, sağlayıcı bağımsızlığının somutlaşmış halidir. Claude Sonnet 5.5, 6.1 Sol'dan bir gün önce yine 2 $ ve 10 $ fiyatıyla çıktı; OpenAI'ın blog yazısı ise 6.1 Sol'u Sonnet 5.5 ile değil, Opus 5.5 ve Fable 5.1 ile kıyaslıyor. Hiçbir sağlayıcı bu ikisini doğrudan karşı karşıya getiren bir analiz yayımlamadı; dolayısıyla geçerli olan tek karşılaştırma, kendi Task'larınız üzerinde yapacağınız karşılaştırmadır. Manuel bir eskalasyon yoluna sahip yazılı bir kuralın arkasındaki tüm mantık Crew'lar için model yönlendirme yazımızda yer alıyor.
Bunların hiçbiri sürecin varış noktasını değiştirmez. Astra düzeyine yakın sonuçlara daha ucuza ulaşmak, günde daha fazla görevin tamamlanması anlamına gelir; ancak her çalıştırma yine de diff'i inceleyen bir insanda son bulur. Agent'lar araştırır, yürütür, test eder ve raporlar. Yönü belirleyen, yetki veren ve sonucu kabul eden ise insanlardır. Bu hafta yapılması gereken en faydalı iş; panonun hangi Computer'ın hangi modeli çalıştırdığını, nelerin tamamlandığını, eski bir efor ayarı yüzünden nelerin başarısız olduğunu ve nelerin inceleme beklediğini net bir şekilde gösterebildiğinden emin olmaktır. Birden fazla Codex terminalini hâlâ manuel olarak yönetiyorsanız, birden fazla Codex agent'ını yönetme rehberi öncelikle bu sürecin manuel versiyonunu adım adım ele alıyor.
Bu yapıyı worktree'ler ile manuel olarak kurabilir veya iş akışını yönetmek için Sharkly'den yararlanabilirsiniz.