OpenAI, GPT-6 Luna'yı 22 Eylül'de milyon giriş token'ı başına 0,10 $ ve milyon çıkış token'ı başına 0,50 $ fiyatla, gpt-6-luna API kimliği ve 1M bağlam penceresiyle yayınladı. Bu fiyatla birlikte ilginç soru, modelin soyut olarak yeterince iyi olup olmadığı olmaktan çıkıyor. Soru artık, tahtanızdaki hangi şeritleri ona teslim etmeye razı olduğunuz ve ucuz şeritle pahalı şeridin aynı Computer üzerinde, kimse belirli bir sonucu hangisinin ürettiğini kaybetmeden nasıl çalıştığı hâline geliyor.
Bu, bir model sorunu olmadan önce bir yapılandırma sorunudur. Luna'yı her yere bağlayan bir ekip para tasarrufu yapar, sonra bunu inceleme sürecinde geri harcar. Luna'yı hiç bağlamayan bir ekip ise bir Agent'a test dosyası yeniden adlandırtmak için prim ücretleri ödemeye devam eder. Bu kılavuz en küçük faydalı yolu izliyor: gpt-6-luna'yı tek bir Computer'a koyun, kendi şeridinde tutun, gerçek bir Task atayın ve sonucu ekibin görebileceği bir yerde okuyun.
TL;DR
gpt-6-luna'yı bağlı bir Computer'daki bir Runtime'ın varsayılan modeli olarak bağlayın, bu Runtime'ın Sharkly'de Available (Kullanılabilir) olarak göründüğünü doğrulayın, pahalı olanı yeniden kullanmak yerine ona kendi Agent'ını verin, uzun bir çalışmaya güvenmeden önce Task başına zaman aşımını artırın ve Luna'yı çıktısını bir kişinin bir dakikadan kısa sürede kontrol edebileceği işlerde tutun. Sharkly model adını göstermez. Çalışmayı, günlüğü, soruları ve sonucu Task üzerinde gösterir. Agent'lar araştırır, yürütür, test eder ve raporlar. Yönü insanlar belirler, yetkiyi insanlar verir ve sonucu insanlar kabul eder.
Model ayarı nerede bulunur
Sharkly model seçmez. Agents dokümantasyonu bu konuda açık: "Agent, Runtime'ın varsayılan modelini izler. Belirli bir model adı vaat etmez veya göstermez. Modeli Agent üzerinde değil, Runtime veya Computer araç yapılandırmasında değiştirin."
Yani bir Agent üzerinde ne model açılır menüsü ne de düşünme derinliği kontrolü vardır. Dört rol, her birinin tek bir işi var. Agent, işin nasıl ele alınacağını tanımlar. Computer, ana makineyi ve yerel kaynakları sağlar. Runtime, gerçek agent oturumunu yürütür. Task ise ekibin paylaşılan kaydı olarak kalır. Bu kurulumun tam anlatımı GPT-6 Sol kılavuzumuzda yer alıyor; bu yazı, tahtaya ucuz bir model koymaya özgü kısmı ele alıyor.
Adım 1: gpt-6-luna'yı Computer'a bağlayın
Onu çalıştıracak Computer'da agent aracınızı güncelleyin ve Luna erişimi olan bir hesapla veya API anahtarıyla oturum açın. OpenAI, Luna'yı ChatGPT Work'te ve Codex'te Plus, Pro, Business, Enterprise ve Edu planları için kullanıma sundu, Free ve Go kullanıcılarına masaüstü uygulamasında Luna verdi ve henüz Chat'e koymadı. codex -m gpt-6-luna o ana makinede sade bir terminalde oturum başlatıyorsa, Sharkly onu kullanabilir.
Ardından o Runtime üzerindeki çalışmaların bunu alması için varsayılanı ayarlayın:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Bu kod parçasıyla ilgili iki uyarı var. reasoning-effort anahtarının adı Codex sürümleri arasında farklılık gösterir; bu yüzden o Computer'da kurulu sürümün örnek yapılandırmasıyla karşılaştırarak kontrol edin. Ve high varsayılan olarak değil, bilinçli olarak oradadır: aşağıdaki yayımlanmış her Luna sonucu high veya max effort ile ölçülmüştür, ucuz bir modeli daha da ucuzlatmak için seçeceğiniz ayarla değil. [VERIFY]
Sharkly'ye döndüğünüzde, Computer ayrıntısını açın ve yeniden taramayı veya bağlantı testini çalıştırın. Runtime, Available olarak görünmelidir. Bir Computer'ın yalnızca online görünmesi, yerel servisinin sinyal gönderdiği anlamına gelir. Bir çalışmanın başlayabileceğini size söyleyen şey ise Runtime yetenek durumudur.
Adım 2: ucuz şeridi görünür biçimde ayrı tutun
Bir Computer bir veya daha fazla Runtime sunabilir; her biri kendi bağlantı durumunu bildirir ve Computer ayrıntısından kendi adı ve başlatma komutuyla özel bir ACP Runtime eklenebilir. Burada kullanmaya değer kaldıraç budur. Luna şeridine kendi Runtime girdisini ve kendi Agent'ını verin; bunları modele göre değil şeride göre adlandırın; böylece kimse bir yürütme günlüğü okumadan tahta size bir Task'ın hangi şeritte çalıştığını söyler.
Bu kozmetik bir şey değil. Sharkly, bir Runtime'ın gerçekte hangi modeli kullandığını güvenilir biçimde okuyamaz; Agent'ların Runtime varsayılanını izlemesinin ve hiçbir model adı göstermemesinin nedeni tam da budur. Biri bir yapılandırma dosyasını düzenlediği için bir Agent salı ile perşembe arasında sessizce model değiştirirse, Task üzerinde aynı görünen iki çalışma aslında aynı değildir. Maliyet kademesi başına bir şerit, bunu ekibin zaten baktığı tek yerde görünür kılar. Runtime'ların nasıl algılanıp test edildiğini Sharkly'deki Computers yazısında görebilirsiniz.
Karar vermeniz gereken bir ikili durum var, çünkü iki şeridi sürdürmenin bir maliyeti vardır. O Computer'da birden fazla kişi iş atıyorsa ve 0,10 $'lık bir çalışma ile 10 $'lık bir çalışma arasındaki fark birileri için önemliyse Runtime'ı ayırın. Haftada birkaç Task çalıştıran tek bir mühendis varsa ayırmayın; tek bir Runtime ve Task başına verilen bir karar, akılda tutulması gereken daha az şeydir ve worktree isolation zaten çalışmaların çakışmasını engeller.
Adım 3: yavaş başlayan bir model için çalışmayı boyutlandırın
Ucuz olmak hızlı olmak demek değildir ve insanların ilk yanlış yaptığı ayar budur. İki satıcıdan hiçbiri değil, bağımsız bir üçüncü taraf olan Artificial Analysis, GPT-6 Luna'nın max reasoning varyantı için saniyede 153,9 çıkış token'ı ve ilk token'a 124,23 saniye ölçtü. Bu, çoğu insanın bir sürecin takıldığını varsaymadan önce beklediğinden daha uzun bir süre.
Bu yüzden Task başına zaman aşımını bilinçli olarak ayarlayın ve çalışma dizinini Temporary modunda tutun; böylece her Task yalıtılmış bir dizin ve yepyeni bir worktree alır. Böylece aynı depo üzerinde iki Luna çalışması birbirinin üzerine yazamaz ve düşünen bir çalışma, ölmüş bir çalışmadan farklı görünür; çünkü durumu Task taşır, bir terminal kaydırma geçmişi taşımaz.
Ucuz bir Runtime bir Crew'de nereye konur
Bir Crew, tek bir lider Agent tarafından koordine edilen, yeniden kullanılabilir bir İnsan ve Agent grubudur. OpenAI'ın kendi rakamlarından çıkan yerleştirme kuralı, Luna'nın en tepede değil, üyeler arasında yer aldığıdır.
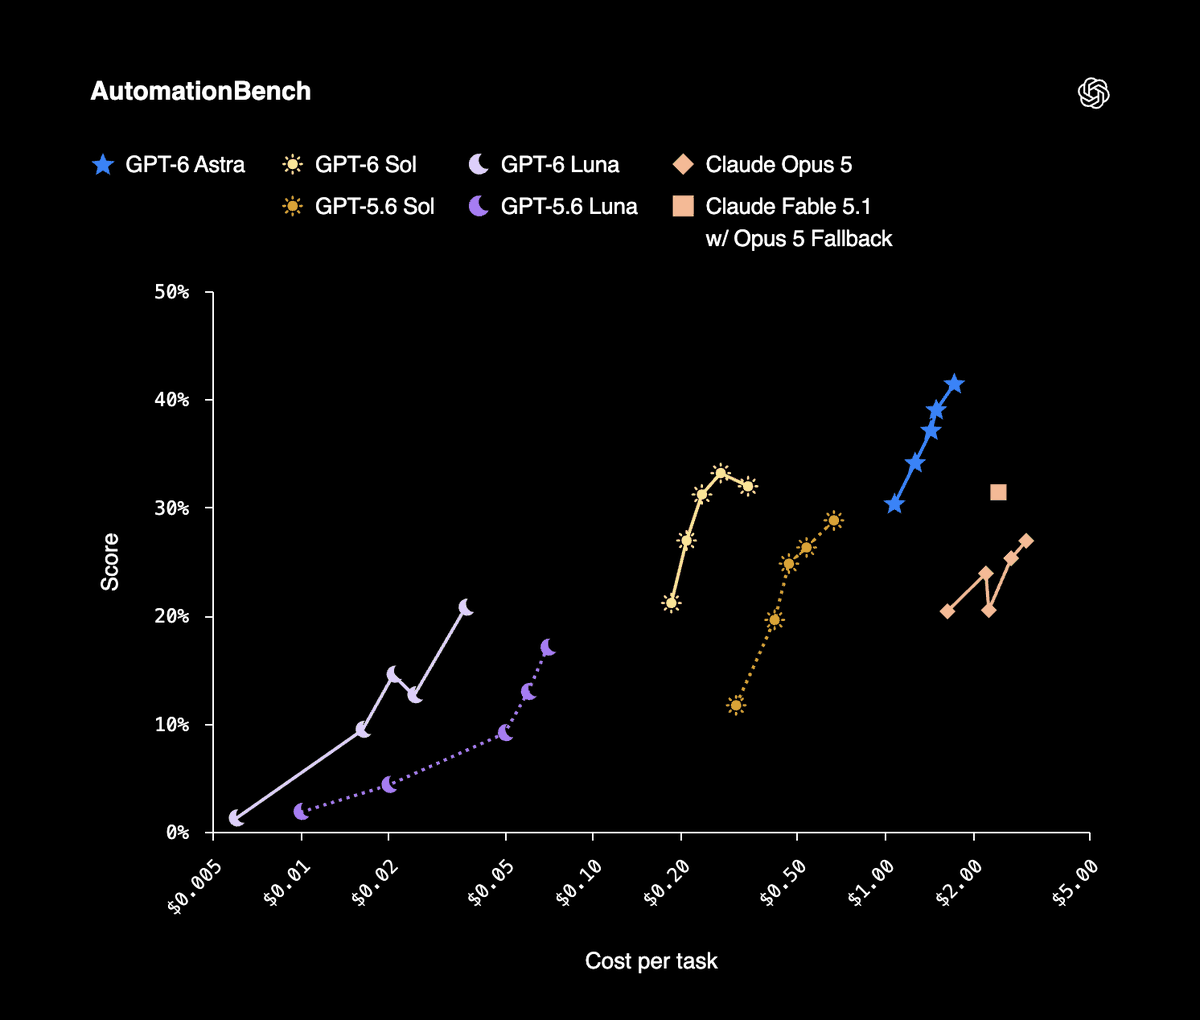
Üye olma durumu güçlü. DeepSWE 1.1'de OpenAI, max effort ile Luna'nın %66,6 puan aldığını, medium effort ile çalışan Claude Opus 5 ve Fable 5 ile karşılaştırılabilir olduğunu, görev başına Opus 5'ten %93 ve Fable 5'ten %96 daha düşük maliyetle bildiriyor. OSWorld 2.0 offline'da, max seviyedeki Luna, medium seviyedeki GPT-5.6 Sol'u onda bir maliyetle geçiyor. AutomationBench 1.0.6'da high seviyedeki Luna, görev başına %58 daha düşük maliyetle selefinden 5,4 yüzde puan daha yüksek puan alıyor; olgusallıkta ise daha yüksek effort ile Luna, yaklaşık yüzde bir maliyetle GPT-5.6 Sol ile eşleşiyor. OpenAI ayrıca Sol ve Luna'yı GPT-5.6 promosyon fiyatlandırmasından %50 daha ucuz olarak tanımlıyor ve bu niteleyici OpenAI'ın kendisine ait: temel alınan, liste fiyatı değil promosyon oranı.
Lider olma durumu zayıf ve bu herhangi bir kıyaslama yüzünden değil. Bir lider hedefi yorumlar, üyelerin ne yapacağına karar verir ve sonuçlarını tek bir Task'ta bir araya getirir. En tepedeki bir yorum hatası tek bir kötü çalışma değildir; her üyenin çalışmasının yanlış şeye yöneltilmesidir ve liderin token'larından yapılan tasarruf bunun yanında bir yuvarlama hatasıdır. Crew leader kılavuzumuz fiyat listesinin diğer ucunda aynı savı ortaya koyuyor.
| İş | Şerit | Neden |
|---|---|---|
| Triyaj, etiketleme, backlog düzenleme | Luna | Yüksek hacim ve bir kişi sonucu saniyeler içinde kontrol edebilir |
| Test iskeleti, ilk geçiş inceleme notları | high effort ile Luna | Yayımlanan başarılar high veya max seviyede, daha düşük bir ayarda değil |
| Yayına giden koda yapılan değişiklikler | 2 $ / 10 $ ile GPT-6 Sol | Görev başına 0,27 $ ile AutomationBench %33,2 |
| Bir Crew için belirsiz bir hedefi yorumlamak | GPT-6 Sol veya 10 $ / 50 $ ile Astra | Bir liderin hatası her üyeye yayılarak çoğalır |
Bunu bir alışkanlık yerine kural olarak yazın. Hangi kodlama görevi için hangi model yazısı, yönlendirme sorusunu tümüyle ele alıyor.
OpenAI'ın marjlarını okurken bir uyarı: lansman yazısı Claude Opus 5'e karşı kıyaslama yapıyor ve Anthropic aynı gün saatler sonra Opus 5'in yerine Opus 5.5'i getirdi. Yukarıdaki Luna karşılaştırmaları, adı geçen modelin bir önceki nesline karşı ölçülmüştür.
Ucuz bir Runtime'ın ucuzlatmadığı şey
Luna, bir değişiklik üretmenin fiyatını düşürür. Bir değişikliği kabul etmenin fiyatına ise hiçbir etkisi yoktur. On ucuz çalışma on diff, on test çıktısı seti ve yalnızca bir kişinin verebileceği on karar üretir; OpenAI'ın kendi harcama rakamları da bir güvence değil, bir uyarıdır: şirket, medyan bir araştırmacının kodlama agent'larına günde 600 $'dan fazla harcadığını, 90. yüzdelik dilimin ise 7.000 $ olduğunu bildiriyor. Görev başına daha ucuz olmak, böyle bir faturanın nasıl oluştuğunun cevabıdır.
O hâlde bu işin dürüst hâli şu. Ucuz bir Runtime, üstlendiği iş bir kişinin hızlıca doğrulayabileceği bir işse bağlamaya değerdir; inceleyicinizin önündeki kuyruğu çoğaltıyorsa bu yanlış bir ekonomidir. Bağlamı, ilerlemeyi, engelleri, sonuçları ve insan incelemesini talep anından sürüm çıkışına kadar görünür tutun ve şeride inceleme anında değil, atama anında karar verin. İnsan incelemesi darboğazdır yazısı bunun planlama tarafını ele alıyor.
Zaten birkaç kodlama agent'ı çalıştırıyorsanız, bir Computer bağlayın, ucuz şeritte bir Agent oluşturun ve ona sıkıcı bir iş atayın.