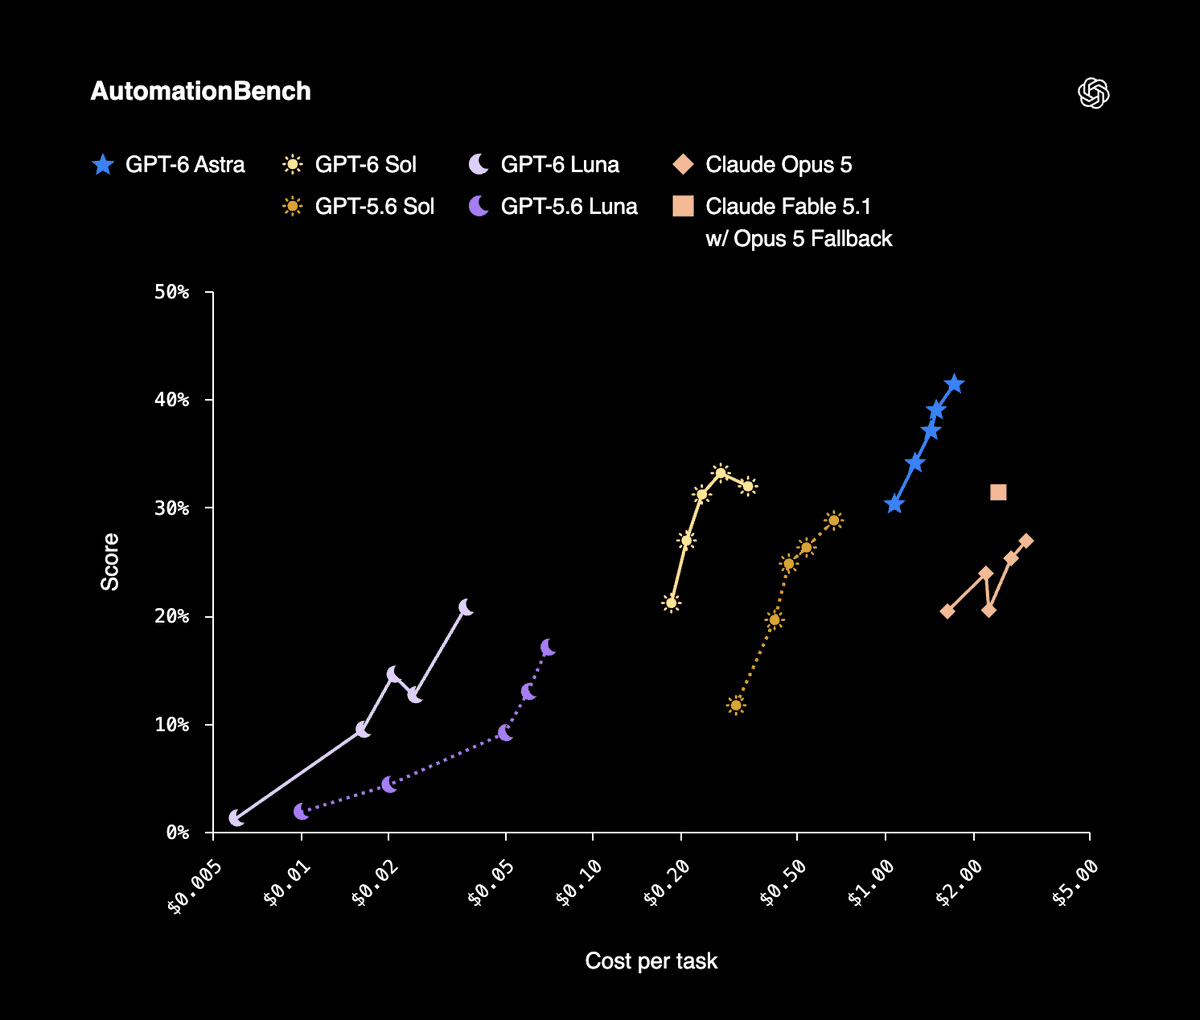
OpenAI, 22 Eylül'de GPT-6 Sol'u milyon giriş token'ı başına 2 dolar, milyon çıkış token'ı başına 10 dolar fiyatla, gpt-6-sol API kimliği ve 872 bin token'lık bağlam penceresiyle yayına aldı. Panonuzun nasıl göründüğünü değiştirmesi gereken sayı token ücreti değil. Tamamlanan görev başına maliyet: OpenAI'ın AutomationBench 1.0.6 sonuçlarına göre Sol, xhigh akıl yürütme çabasında görev başına 0,27 dolarla %33,2 puan alırken, Claude Opus 5 maksimum çabada Sol'un görev başına maliyetinin 11,1 katıyla %26,9 puan alıyor.
Bunu bir sıralama tablosu değil, bir bütçe beyanı olarak okuyun. Ekibiniz tam bir çalıştırma pahalı olduğu için agent çalıştırmalarını karneye bağlıyorsa, o kısıt artık yer değiştirdi. Sıradaki kısıt ise paranın çözemeyeceği türden: bir insanın hâlâ diff'i okuyup işi kabul etmesi gerekiyor. Bu kılavuz, kurulumda işe yarayan en kısa yolu izliyor, ardından fiyat indiriminin çözmediği kısımda dürüst davranıyor. Sol'u tek bir Computer'da Codex'e koyun, tek bir Agent oluşturun, gerçek bir Task atayın.
TL;DR
Bağlı bir Computer'da Codex'te model = "gpt-6-sol" ayarını yapın, Codex Runtime'ın Sharkly'de Available olarak göründüğünü doğrulayın, Agent'ın çalışma dizinini Temporary modunda tutun, ilk uzun çalıştırmaya güvenmeden önce Task başına zaman aşımını artırın ve tek bir Task atayın. Sharkly model adını göstermez. Çalıştırmayı, günlüğü, soruları ve sonucu Task üzerinde gösterir. Agent'lar araştırır, yürütür, test eder ve raporlar. İnsanlar yön belirler, yetki verir ve sonucu kabul eder.
Model ayarı nerede bulunur
Sharkly model seçmez. Agents dokümantasyonu bunu açıkça belirtiyor: "Agent, Runtime'ın varsayılan modelini izler. Belirli bir model adı vaat etmez veya göstermez. Modeli Agent üzerinde değil, Runtime veya Computer araç yapılandırmasında değiştirin."
Agent üzerinde ne bir model açılır menüsü ne de bir düşünme derinliği denetimi var, o yüzden aramaya kalkmayın. Dört rol, her birinin tek bir işi. Agent, işin nasıl ele alınacağını tanımlar. Computer, ana makineyi ve yerel kaynakları sağlar. Runtime gerçek agent oturumunu yürütür ve burada Runtime Codex'tir. Task ise ekip için ortak kayıt olarak kalır.
1. Adım: GPT-6 Sol'u Computer'daki Codex'e koyun
Çalıştıracak olan Computer'da Codex'i güncelleyin ve Sol erişimi olan bir hesapla veya API anahtarıyla oturum açın. OpenAI, Sol'u ChatGPT Work'te ve Plus, Pro, Business, Enterprise ve Edu planları için Codex'te kullanıma sundu; henüz Chat'te yok. Eğer o ana makinede düz bir terminalde codex -m gpt-6-sol bir oturum başlatıyorsa, Sharkly onu kullanabilir.
Ardından varsayılanı ayarlayın ki bu Computer'daki her çalıştırma onu alsın:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Bu kod parçasıyla ilgili iki uyarı. Akıl yürütme çabası anahtarının adı Codex sürümleri arasında farklılık gösterir, bu yüzden o Computer'daki Codex derlemesinin örnek yapılandırmasıyla karşılaştırıp kontrol edin. Ayrıca çaba seviyesi bir maliyet kararıdır, maksimumda bırakacağınız bir kalite kadranı değil: OpenAI'ın kendi yayımladığı sonuçlar farklı kıyaslamalar için farklı çaba seviyeleri kullanıyor ve yukarıdaki görev başına 0,27 dolar rakamı xhigh satırı. [VERIFY]
Sharkly'ye dönün, Computer ayrıntısını açın ve yeniden tarama veya bağlantı testini çalıştırın. Codex Runtime Available olarak görünmelidir. Yalnızca online görünen bir Computer, yerel servisinin sinyal gönderdiği anlamına gelir. Bir çalıştırmanın başlayıp başlayamayacağını size Runtime yetenek durumu söyler.
2. Adım: Crew'ü büyütmeden önce önbelleği kurun
Aynı depoda birden fazla Agent çalışmaya başladığında en çok önem taşıyan GPT-6 değişikliği bu ve çoğu ekibin atlayacağı şey de bu.
OpenAI, GPT-6 için varsayılan olarak daha yüksek önbellek isabet oranları, önbelleğe alınmış giriş okumalarında %90 indirim, bir prompt önbellekleme panosu ve bir teşhis aracı bildiriyor; agent çalışması açısından önemli olan bir nokta da artık akıl yürütme çabasını veya araç kullanılabilirliğini değiştirmenin önbelleği geçersiz kılmaması. Açık kesme noktaları, önbelleğe alınmış bir önekin nerede bittiğini seçmenize olanak tanır. OpenAI, GitHub'ın milyarlarca istek genelinde taze işlem gerektiren prompt token'larında %50'den fazla azalma gördüğünü aktarıyor.
Bir crew için pratikteki durum şu. Aynı depoda her Agent çalıştırması büyük, neredeyse aynı bir öneki yeniden gönderir: depo düzeni, şirket kuralları, test komutu, konvansiyonlar. Bu önek tam da önbelleğin var olma sebebi ve bir agent filosunun çalıştırma başına maliyetinin ilk agent'ınkinden çok daha düşük olabilmesinin nedeni.
Bir karar ikilisi, çünkü bu bedava bir iş değil. Birkaç Agent tek bir kod tabanına karşı tekrar tekrar çalıştığında ve Skill ile talimat metniniz oturduğunda sabit bir önek belirleyin ve açık bir kesme noktası ayarlayın. Bir Agent haftada birkaç kez çalışıyorsa veya talimatları hâlâ haftalık değişiyorsa zahmet etmeyin, çünkü sınırı korumak için harcadığınız zaman kazandığınızdan fazla olur.
3. Adım: Agent'ı yavaş başlayan bir çalıştırma etrafında kurun
Agents'i açın, New Agent'ı seçin, Computer'ı ve Codex Runtime'ı seçin, ardından üç şeyi ayarlayın.
Task başına zaman aşımı. Bunu bilinçli olarak ayarlayın, çünkü yüksek akıl yürütme modundaki bir Sol çalıştırması meşgul görünmeden önce ölü görünebilir. İki satıcıdan hiçbiri değil, bir üçüncü taraf olan Artificial Analysis, GPT-6 Sol'un maksimum akıl yürütme varyantı için ilk token'a kadar 102,15 saniye ölçtü. Bu, çoğu insanın bir şeyin donduğunu varsaymadan önce beklediğinden daha uzun ve tam da paylaşılan bir panodaki durumun önlediği, terminalin ise önleyemediği arıza bu. Düşünen bir çalıştırma ile çökmüş bir çalıştırma, kaydırma geçmişinde birbirinin aynısı görünür. Bir durumun okumaya değer olması için ne taşıması gerektiğini coding agent gözlemlenebilirliği yazımızda bulabilirsiniz.
Çalışma dizini. Temporary modu. Her Task yalıtılmış bir dizin alır ve depo destekli çalıştırmalar taze bir worktree hazırlar, böylece aynı depodaki iki Sol çalıştırması birbirinin üzerine yazamaz. Geçici dizinler için varsayılan eşzamanlılık, Computer sınırının %50'sidir. O Computer birkaç gerçek çalıştırmayı idare edene kadar bu değerde bırakın; daha yüksek eşzamanlılık CPU, bellek, disk ve sağlayıcı kapasitesini aynı anda tüketir.
Talimatlar. Kısa ve sabit:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
4. Adım: Tek bir Task atayın, sonra bir Crew yerini hak ediyor mu karar verin
Kabul kriteri net olan bir Task seçin. Agent'ı Assignee olarak seçin ve Task'ı Backlog'dan, kategorisi çalışmaya hazır olan bir duruma taşıyın; Backlog'da atanan bir Task bekler. Çalıştırma queued, dispatched ve running aşamalarından geçer ve Executions sekmesi günlüğü akıtır. Agent bir karar gerektirirse soru, Task'a bir yorum olarak döner, Task waiting for human reply gösterir ve bu da Inbox'ınıza yönlenir.
Sınırlı bir değişiklik için tek bir Agent doğru tercihtir ve hareketli parçalar sıfırda kalır. Bir Crew, bir lider Agent tarafından koordine edilen, yeniden kullanılabilir bir İnsan ve Agent grubudur ve liderin bir hedefi yorumlaması ve birkaç üyenin sonucunu tek bir Task'ta bir araya getirmesi gerektiğinde yerini hak eder.
Sol bu hesabı değiştiriyor, çünkü bir lider çoğunlukla okur, planlar, atar ve gözden geçirir ve bu, bir fiyat listesinin en üstünde haklı çıkarılması en zor işti:
| Runtime modeli | API kimliği | 1M başına giriş / çıkış | Crew'de nereye oturur |
|---|---|---|---|
| GPT-6 Astra | belirtilmemiş | $10 / $50 | Planın kendisi zor kısım olduğunda lider |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Lider ve gerçek değişiklikleri yapan üyeler |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | Yüksek hacimli üyeler: triyaj, etiketleme, iskelet kurma |
Aynı kurulumu Astra için GPT-6 Astra'yı Crew lideri olarak çalıştırma yazımızda anlattık. Oradaki argüman hâlâ geçerli; altındaki fiyat noktası değişti.
Fiyat indiriminin satın alamadığı şey
OpenAI, Sol'u GPT-5.6 promosyon fiyatlandırmasından %50 daha ucuz olarak tanımlıyor. Bu niteleyici OpenAI'ın kendisine ait ve önemli, çünkü karşılaştırma temeli liste fiyatı değil promosyon ücreti. Aynı sayfada belirtilmesi gereken iki uyarı daha var. OpenAI'ın lansman kıyaslamaları Claude Opus 5'e karşı; Anthropic aynı gün saatler sonra onu Opus 5.5 ile değiştirdi, yani bu farkları önceki nesile karşı ölçülmüş olarak okuyun. Ve işi çaba seviyesi yapıyor: Sol, DeepSWE 1.1'de %68,8'e ve Agents' Last Exam V1'de %56,4'e maksimum çabada ulaşıyor, rutin görevler için açık bırakacağınız ayarda değil.
Sonra modelle hiç ilgisi olmayan kısım. OpenAI, kendi medyan araştırmacısının coding agent'lara günde 600 dolardan fazla harcadığını, 90. yüzdelik dilimin ise 7.000 doların üzerinde olduğunu bildiriyor. Görev başına daha ucuz olmak, böyle bir faturanın nasıl oluştuğudur, nasıl önlendiği değil. Her çalıştırma hâlâ bir insanın okuyup sorgulaması ve kabul etmesi gereken bir değişiklik üretiyor ve o kuyruk bu hafta 11 kat ucuzlamadı. Model seçimi yerine inceleme kapasitesi etrafında plan yapın, yönlendirmeyi bir tercih değil kural olarak yazın ve atamayı, ilerlemeyi, engelleri, sonuçları ve insan incelemesini talepten sürüme kadar tek bir yerde tutun.
Hâlihazırda birkaç coding agent çalıştırıyorsanız, bir Computer bağlayın, bir Agent oluşturun ve ona sıkıcı bir şey atayın.