Gerçek işi hangi kodlama ajanına emanet edeceğinize karar vermeye çalışıyorsunuz: Claude Code, Codex, Gemini CLI, OpenCode ya da ikisi birden. Sonra benchmark puanlarına bakıyorsunuz. Bir ajan herkese açık bir görev setinin %68'ini çözüyor, bir diğeri %71'ini ve siz de buna göre seçim yapmanız gerektiğini düşünüyorsunuz. Derken ajan deponuza giriyor ve hiçbir kamuya açık veri setinin görmediği bir derleme adımında takılıp kalıyor.
Bir benchmark, sabit ve ortak bir sorunlar kümesini ölçer. Sizin kod tabanınız ise özel bir sorunlar kümesidir: kendi kurallarınız, monorepo düzeniniz, herkesin görmezden geldiği kararsız (flaky) test, sadece bir kişinin anladığı dağıtım betiği. Haftanızı belirleyen puan, bir laboratuvarın yayımladığı puan değil, o kod üzerinde ürettiğiniz puandır. Bu rehber, kodlama ajanlarını gerçekten yayına aldığınız yazılım üzerinde karşılaştırmanın bir yöntemini ve bu karşılaştırmayı ajanları birbirinden ayrı tutmak için beş terminal açmadan nasıl yapacağınızı anlatıyor.
Sharkly bu yöntemin vardığı yer. Sharkly hepsi bir arada bir Agent komut ve yönetim platformudur: kendi Bilgisayarınızı bağlarsınız, aynı Task'ı farklı Agent'lara atarsınız ve her çalıştırma diff'ini, test çıktısını ve incelemesini tek bir yere döndürür. Adil bir karşılaştırmayı mümkün kılan da budur. Ölçmek istediğiniz değişken ajandır; üç çalıştırmanın birbirine karışmasını engellemek için yapacağınız terminal cambazlığı değil.
Bir benchmark puanı deponuzu değil, bir veri setini ölçer
Bir kodlama ajanı benchmark'ı, herkes için aynı şekilde puanlanan sabit ve herkese açık bir test setidir. Onu model geliştiren laboratuvarlar için faydalı kılan tam da budur ve sizin için zayıf bir öngörücü yapan da tam olarak budur.
SWE-bench gibi kamuya açık benchmark'lar görevlerini tanınmış açık kaynak projelerden alır; ince ayarlı bir test düzeneği ve özenle seçilmiş kabul kontrolleriyle birlikte. Bunların hiçbiri sizin bir salı gününüzü tanımlamaz. Bir ajanın sizin kodunuzda nasıl performans göstereceğini belirleyen şeyler, kamuya açık bir veri setinin asla içeremeyeceği şeylerdir: modelin hiç okumadığı dahili kütüphaneleriniz, lint yapılandırmanız, servisin aslında nasıl ayağa kalktığını açıklayan 400 satırlık bağlam dosyası, testi olmayan o tek modül.
Yüksek bir benchmark puanı, bir ajanın sizin deponuzda nasıl davranacağını öngörmez. Başkasının deposunda nasıl davrandığını öngörür. Liderlik tablosunu, hangi ajanların test edilmeye değer olduğuna dair kaba bir filtre olarak görün, sonra asıl önemli olan testi yapın. Her ajana hangi modeli yönlendireceğinizi hâlâ seçiyorsanız, modelleri ajan rollerine eşleştirmek, ham puandan daha iyi bir başlangıç sorusudur.
Bir oyuncak istem değil, gerçek bir görev seçin
En küçük faydalı karşılaştırmayla başlayın. Ajanları "bir yapılacaklar uygulaması yap" üzerinden benchmark'lamayın. Backlog'unuzdan gerçek bir gereksinim seçin: kapsamı belirli bir hata, tek bir modül üzerinde küçük bir özellik, zaten yapacak olduğunuz bir taşıma işlemi. Çalıştırabileceğiniz bir kabul testi ve birkaç dakikada okuyabileceğiniz bir diff'i olan bir şey.
Sonra her ajana aynı girdiyi verin: aynı görev tanımı, aynı başlangıç commit'i, aynı kabul kriterleri. Bunu izleyicinizin yazacağı şekilde yazın; SH-312: fatura dışa aktarımındaki saat dilimi kaymasını düzelt gibi bir görev. Bir ajana diğerinden daha zengin bir istem verirseniz, ajanı değil kendi isteminizi ölçüyorsunuz demektir.
Bir ajanın mevcut kodu nasıl okuduğunu ve çizginin içinde kalıp kalmadığını görmek istiyorsanız bir hata düzeltmesi kullanın. Yeni kodu nasıl yapılandırdığını ve kendi testlerini yazıp yazmadığını görmek istiyorsanız küçük bir özellik kullanın. Zaman içinde her ikisini de çalıştırın; tek bir görev size yalnızca tek bir görev hakkında bilgi verir.
Her ajanı en iyi halinde karşılaştırın, asla en kötü halinde değil
Her ajanın en güçlü işini yaptığı bir kurulumu vardır: doğru model, doğru bağlam dosyası, gerçekten ihtiyaç duyduğu izinler. Claude Code'a CLAUDE.md'sini verin, Codex'e yapılandırmasını verin, her Runtime'a belgelerinin önerdiği ortamı verin. İyi yapılandırılmış bir ajanı çıplak bir ajanla karşılaştırmak, hangisini kurma zahmetine girdiğinizden başka hiçbir şey söylemez.
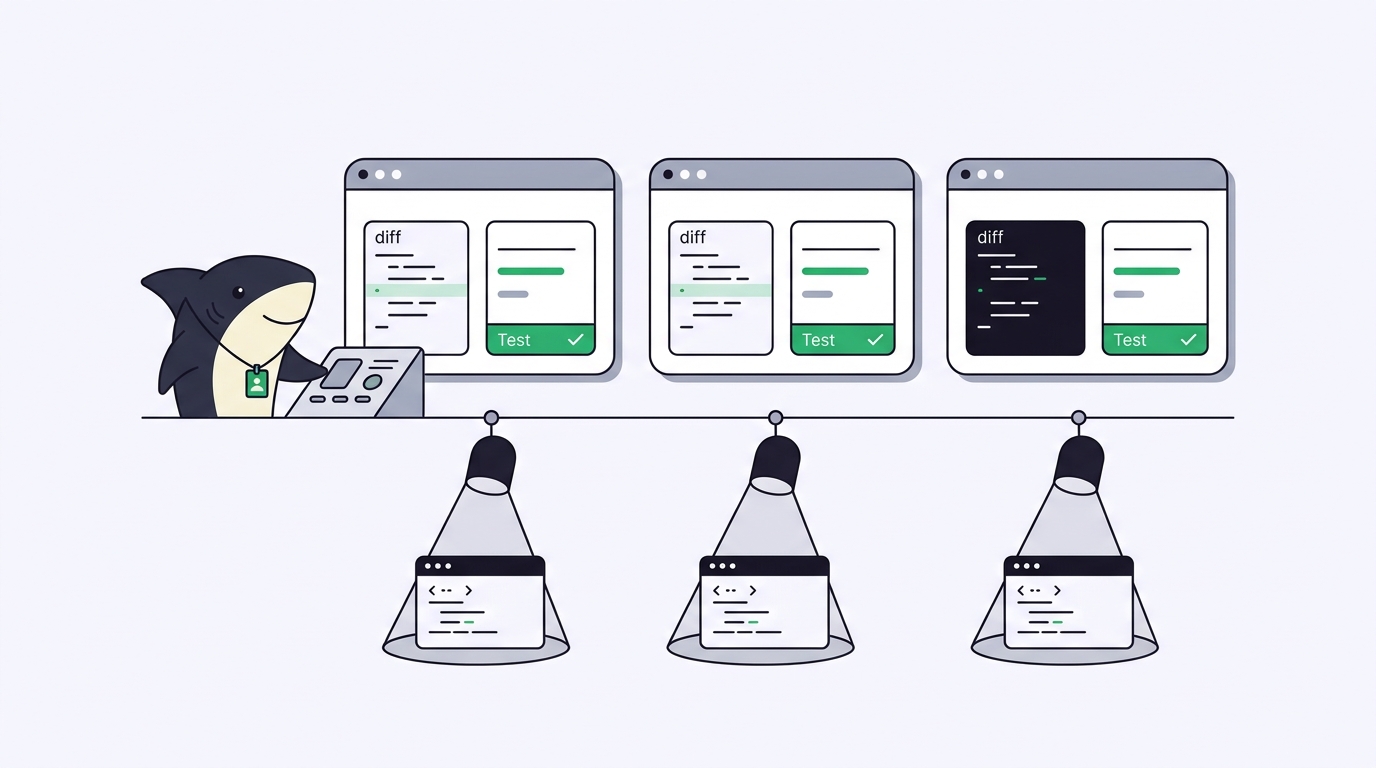
Onları en iyi hallerinde, yan yana çalıştırmak, terminal yaklaşımının çöktüğü yerdir. Sharkly'de aynı Task'ı her Agent'a atarsınız ve her Agent, bağlı bir Bilgisayarda izole bir worktree içinde çalışır; böylece aynı depoyu düzenleyen üç ajan birbirlerinin dosyalarına asla dokunmaz. Aynı soruna dair tek bir paylaşılan çalışma ağacı ve elle çözmeniz gereken bir merge yerine üç temiz deneme elde edersiniz. Bunu elle yapıyorsanız, birden fazla ajanı aynı anda çalıştırmak, Sharkly'nin sırtınızdan almak için tasarlandığı kısımdır.
Yalnızca tek bir ajan kullanıyor ve terminalde yaşıyorsanız, bir worktree içinde iyi ayarlanmış tek bir Claude Code oturumu yeterlidir ve bunların hiçbirine ihtiyacınız olmayabilir. Denklem, iki veya daha fazla ajanı, birden fazla görev üzerinde karşılaştırmaya başladığınızda ve sonuçları gerçekten yan yana okuyabileceğiniz bir biçimde istediğinizde değişir.
Gerçek işte belirleyici olan beş kriter
Bir benchmark tek bir sayıyı puanlar: görev geçti mi. Gerçek iş ise o sayının dışarıda bıraktığı beş şeyle belirlenir.
| Kriter | Yanıtladığı soru |
|---|---|
| Paralel çalıştırma | Ajanları aynı görev üzerinde, aynı anda, izole bir şekilde, çakışma olmadan çalıştırabilir miyim? |
| Ekip görünürlüğü | Benden başka biri her ajanın ne yaptığını ve neden yaptığını görebilir mi? |
| İnceleme akışı | Diff'i, testleri ve bilinen sınırları ne kadar hızlı okuyup kabul veya reddedebilirim? |
| Kendi makinede çalıştırma | Ajan benim Bilgisayarımda, gerçek ortamıma ve gizli anahtarlarıma karşı mı çalışıyor? |
| Entegrasyonlar | Sonuç, zaten kullandığımız izleyiciye, depoya ve inceleme araçlarına düşüyor mu? |
İlk dördü, çoğu ajanın bir benchmark'ta birbirinin aynısı görünüp sizin kodunuzda hiç de benzemediği alandır. Özellikle kendi makinede çalıştırma, kamuya açık bir test için görünmezdir: gerçek araç zincirinize, yerel veritabanınıza, gerçek CI kancalarınıza karşı çalışan bir ajan, ona benzeyen bir kum havuzunda değil, yayına aldığınız şey üzerinde test ediliyordur.
Ajanlar araştırır, yürütür, test eder ve raporlar. Siz yön belirlersiniz, yetki verirsiniz ve sonucu kabul edersiniz. Bir karşılaştırma, ancak bunun her parçasını her ajan için, kaydırma geçmişinden yeniden kurmak zorunda kalmadan görebiliyorsanız dürüsttür.
Ajanın iddia ettiğini değil, geri döneni puanlayın
"Bitti" diye yazdıran bir ajan, geçen bir değişiklikle aynı şey değildir. Her çalıştırmayı, iddia ettiğine göre değil, geri dönene göre puanlayın. Her deneme için faydalı kanıt aynı kısa listedir: diff, typecheck ve test sonuçları, değişiklik özeti ve ajanın kabul ettiği sınırlar. Sharkly; bağlamı, ilerlemeyi, engelleri, sonuçları ve insan incelemesini talepten sürüme kadar görünür tutar, böylece karşılaştırma, hatırlamanız gereken beş terminal yerine bir sonuçlar tablosu gibi okunur.
Gerçek darboğaz da tam burada ortaya çıkar. İki ajan bir görevi yirmi dakikada "bitirebilir" ve yine de her birinin incelenmesi size birer saat pahalıya gelebilir. Ajan çıktısını incelemek, çoğu zaman bir ekibin ne kadar paralel işi kaldırabileceğinin gerçek sınırıdır ve hangi ajanı seçeceğinizde ağırlıklı bir rol oynamalıdır. Neye ağırlık vereceğiniz ise seçimi kimin yaptığına bağlıdır:
| Kimin için seçiliyor | En çok ağırlık verilecek |
|---|---|
| Tek geliştirici | İnceleme akışı ve kendi makinede çalıştırma; tek inceleyen sizsiniz |
| Küçük ekip | Paralel çalıştırma ve ekip görünürlüğü; birkaç kişinin aynı çalıştırmaları görmesi gerekiyor |
| Platform ekibi | Entegrasyonlar ve görünürlük; iş akışının sıradaki en iyi ajandan sağ çıkması gerekiyor |
Son satır, karşılaştırma yapmanın asıl amacıdır. Bugünün en iyi ajanı, gelecek çeyreğin en iyi ajanı olmayabilir ve lider her değiştiğinde iş akışınızı yeniden kurmak başlı başına bir vergidir. Sharkly bir kodlama ajanı ya da bir benchmark düzeneği değildir; süreci her seferinde onların etrafında yeniden kurmadan ajanları kendi kodunuz üzerinde test etmeye devam etmenizi sağlayan katmandır.
Tek bir ekosisteme bağlanmak yerine birden fazla kodlama ajanı kullanmaya devam etmek istiyorsanız, Sharkly tam da bu sorun etrafında tasarlandı. Sharkly'yi indirin, tek bir Bilgisayar bağlayın ve aynı gerçek görevi iki ajana atayın. Geri aldığınız karşılaştırma sizin kod tabanınızla ilgilidir; haftanızı öngören tek karşılaştırma da budur.