Ekibiniz işleri modeller arasında zaten yönlendiriyor. Sadece bunu insanların kafasının içinde yapıyor. Bir mühendis, daha az hata verdiği için her şeyi pahalı katmanda çalıştırıyor. Bir diğeri geçen ay ucuz bir modele geçti ve kimseye söylemedi. Üçüncüsü ise hâlâ kurulumda aracın varsayılan olarak seçtiği modelde. Tek bir kişi tek bir ajanı çalıştırdığı sürece bu idare edilebilir. Beş Agent paralel olarak çalışmaya başladığı anda ise sona erer: kimse hangisinin bir docstring için ihtiyacının kırk katını harcadığını ya da hangisinin aslında hiçbir zaman üstesinden gelemeyeceği bir işi sessizce başarısız yaptığını söyleyemez.
2026-09-22'de katmanlar arasındaki fark önem taşıyacak kadar açıldı. Anthropic, Claude Opus 5.5'i yayımladı. OpenAI ise GPT-6 Sol ve GPT-6 Luna'yı çıkardı. Bu üçü arasında en ucuz ile en pahalı arasındaki fark, girdi token'larında kırk kat. Üstelik üçü de gerçek bir Task'ı devretmeye yetecek kadar iyi.
Yönlendirme kuralı bir tercih değil, yazılı bir beyandır
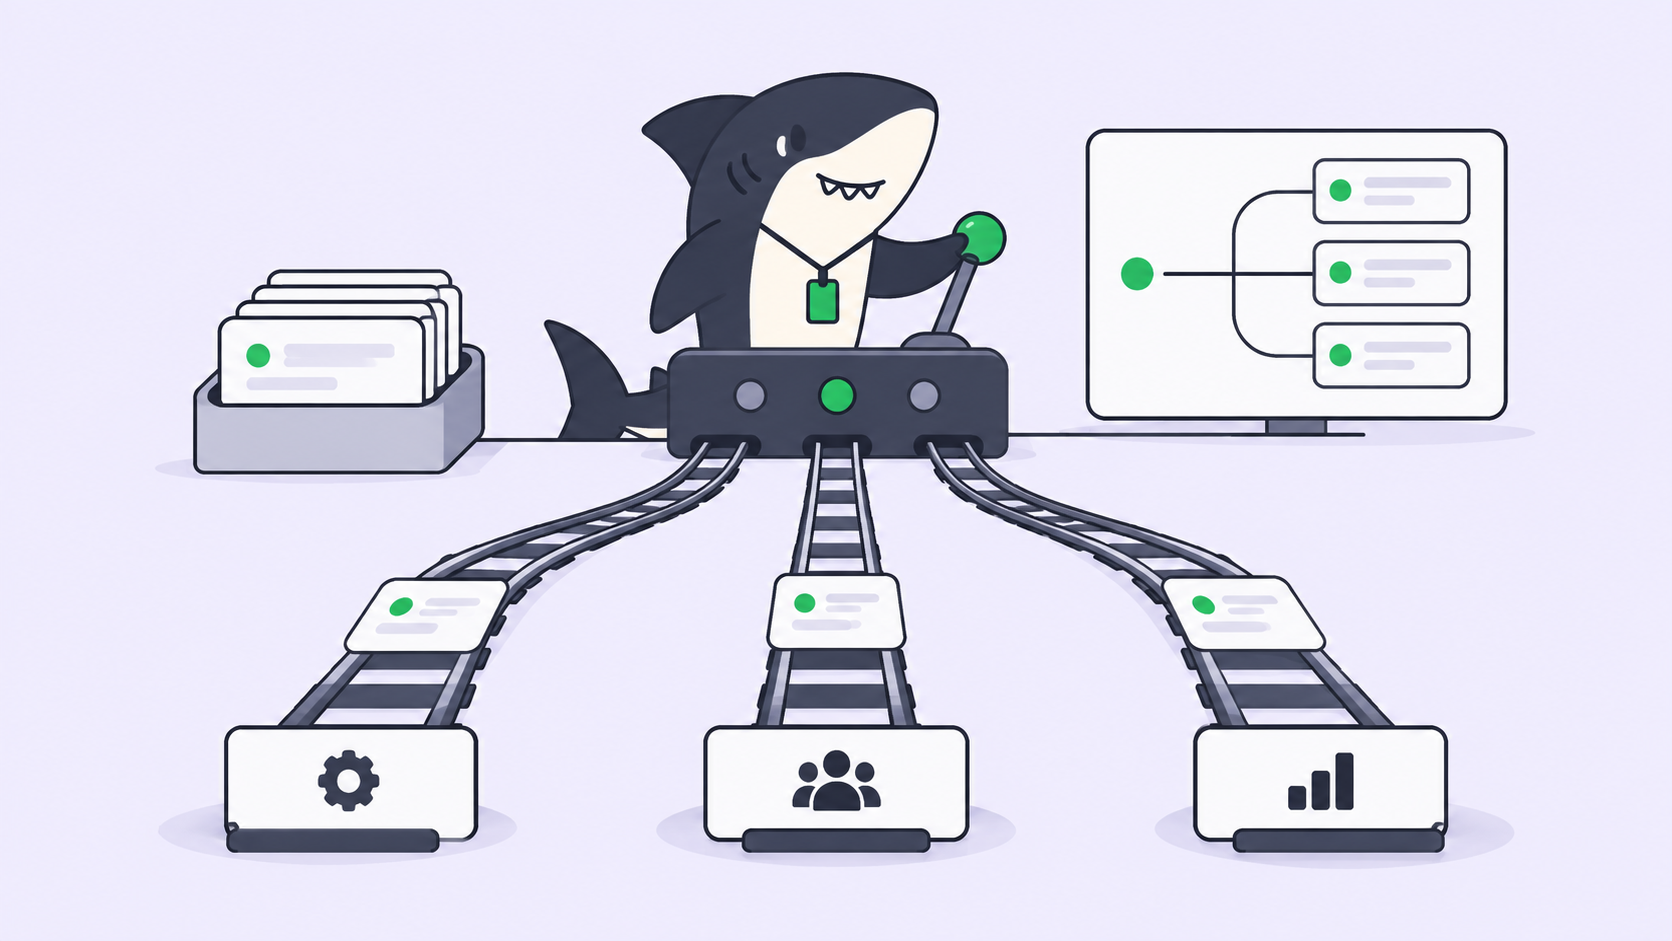
Yönlendirme kuralı, hangi Task sınıfının hangi Runtime üzerinde çalışacağını belirten yazılı bir beyandır ve çalıştırmayı başlatan kişiye değil, işi yürüten Agent'a bağlıdır.
Bütün mesele bu; işin önemli yarısı da "yazılı" olması. Tercih, tek bir kişinin terminalinde yaşar ve o kişi izne çıktığında sona erer. Kural ise Agent'ın yanında durur; böylece bir Task'ı devralan Assignee onu da devralır, inceleyen kişi okuduğu diff'i hangi katmanın ürettiğini görebilir ve gelecek çeyrekte fikrinizi değiştirmek altı konuşma yerine tek bir düzenlemeye bakar.
Yönlendirme kuralı modellerin sıralaması değildir. Bir kazanan iddia etmez, zaten bir kazanana da ihtiyacı yoktur. Her iş türünün varsayılan olarak nereye gittiğini ve bu varsayılanın yanlış çıkması durumunda ne olacağını söyler.
Üç katmanın maliyeti
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API kimliği | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| 1M başına girdi / çıktı | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| Önbelleğe alınmış girdi | okuma $0.20, yazma $5 | okumalarda %90 indirim | okumalarda %90 indirim |
| Bağlam | 1M | 872k | 1M |
Referans olarak: Claude Opus 5, $5 / $25 ve GPT-6 Astra, $10 / $50. OpenAI, Sol ve Luna'yı GPT-5.6 promosyon fiyatlandırmasına kıyasla %50 daha ucuz olarak tanımlıyor. "Promosyon" kelimesi OpenAI'ın kendisine ait ve anlamı değiştiriyor: bu manşetin dayandığı temel, liste fiyatı değil indirimli bir oran. OpenAI ayrıca Astra'nın "her alanda en iyi modelimiz olmaya devam ettiğini" söylüyor; bu da Sol'un kendi ailesinin amiral gemisi değil, değer katmanı olduğunu hatırlatan faydalı bir uyarı.
Bir katmanı kurala yazmadan önce yapılacak pratik bir kontrol: OpenAI, Sol ve Luna'yı ChatGPT Work ile Plus, Pro, Business, Enterprise ve Edu için Codex'te listeliyor; Free ve Go ise masaüstü uygulamasında Luna'yı alıyor ve ikisinin de henüz Chat'te olmadığını söylüyor. Erişilebilirlik, yönlendirme kuralını fiyat kadar şekillendirir; çünkü Crew'nizin yarısının ulaşamadığı bir katman, katman değildir.
Yönlendirmeyi token ücretine göre değil, tamamlanan iş başına maliyete göre yapın
Token fiyatı, gerçekte ödediğiniz tutarın yalnızca bir göstergesidir. Beşte biri fiyata sahip olup dört deneme ve bir insan kurtarması gerektiren bir model daha ucuz değildir. OpenAI bu lansmanda skorun yanında görev başına maliyeti de yayımladı; bu alışılmadık ölçüde doğrudan bir veri ve bir yönlendirme kararı için tam da doğru kanıt biçimi.
| OpenAI'ın yayımladığı hâliyle benchmark | Sonuç | Görev başına maliyet, göreli |
|---|---|---|
| AutomationBench 1.0.6, Sol ekstra yüksek ayarda | %33,2 | görev başına $0.27 |
| AutomationBench 1.0.6, GPT-6 Astra düşük ayarda | %30,3 | Sol'un 3,9 katı |
| AutomationBench 1.0.6, Claude Opus 5 maksimum ayarda | %26,9 | Sol'un 11,1 katı |
| AutomationBench 1.0.6, Opus 5 yedekli Fable 5.1 maksimum ayarda | %31,4 | Sol'un 8,9 katından fazla |
| Agents' Last Exam V1, Sol maksimum ayarda | %56,4, Opus 5'in en iyi sonucunun üzerinde | Opus 5'ten %60 daha düşük |
| OSWorld 2.0 çevrimdışı, Sol ekstra yüksek ayarda | %60,3 alan orta ayardaki Opus 5'e karşı %60,5 | yaklaşık %80 daha ucuz |
| DeepSWE 1.1, Luna maksimum ayarda | %66,6 | Opus 5'ten %93 daha ucuz |
| DeepSWE 1.1, Sol maksimum ayarda | %68,8, ekstra yüksek ayardaki Fable 5'in 1,1 puan yakınında | yaklaşık %80 daha ucuz |
Bu tabloda aynı anda iki şey doğru. Farklar büyük ve bu farklar Claude Opus 5'e karşı ölçülmüş, Opus 5.5'e karşı değil; zira OpenAI'ın yazısı kaleme alındığında Opus 5.5 henüz yoktu ve saatler sonra, Anthropic'in kendi açıklamasına göre Opus 5'ten %40 daha ucuza çalışacak şekilde piyasaya sürüldü. Kimse karşılaştırmayı yeniden çalıştırmadı. Satırları en son yayımlanan sayılar, ima ettikleri sıralamayı ise kendi deponuzda test edeceğiniz bir hipotez olarak değerlendirin.
Bu uyarıdan geriye kalan şey şekil; bir yönlendirme kuralının ihtiyacı olan da tam olarak bu şekil. Ucuz katmanlar, sınırları belirli ve tekrarlanabilir işlerde maliyetin küçük bir kısmıyla kendi başlarının çaresine bakıyor. Anthropic'in Opus 5.5 için öne sürdüğü iddialar ise görev başına fiyatla hiç ilgili değil: Opus 5'ten %40 daha az maliyetle çalışma, yaklaşık %30 daha hızlı çıktı, 128k maksimum çıktı ve 18 saat veya daha uzun süre işin başında kalma. Bunlar, yüzlerce küçük işe değil, uzun ve çirkin işlere yönelteceğiniz bir modeli tarif ediyor.
Kuralın yazılı hâli
İşte ortaya çıkan belge. Kasten sıkıcı ve tek bir dizüstü bilgisayardaki özel bir yapılandırma dosyasında değil, ekibin okuduğu bir yerde durması gerekiyor.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
Asıl işi üç satır yapıyor. Varsayılan katman adıyla belirtilmiş, böylece kimsenin üzerinde düşünmediği bir Task makul bir yere düşüyor. Yükseltme açıkça tanımlanmış, böylece ucuz bir başarısızlık fark edilmeden pahalı bir başarısızlığa dönüşemiyor. İstisnalar Task üzerinde kaydediliyor; bir kural ile bir öneri arasındaki fark da tam olarak bu.
Yükseltme, ekiplerin atladığı yarı
Yukarıdaki tablodaki tasarruflar deneme başına gerçek. Ancak ucuz bir deneme rutin olarak pahalı bir yeniden denemeye artı bir insan kurtarmasına dönüşürse buharlaşırlar; çünkü o zaman hem iki çalıştırmanın hem de kesintinin bedelini ödersiniz. Otomatik yedekleme zincirlerinin başarısızlık biçimi budur: ucuz katmanın maliyetini pahalı olanın faturasının içine gizlerler ve kimse döviz kurunu göremez.
Öyleyse yükseltmeyi manuel ve görünür kılın. Başarısız bir çalıştırma; logu, o ana kadarki diff'i ve takıldığı soruyla birlikte Task'a geri döner. Bir katman yukarı yönlendirmeye, işi bölmeye ya da netleştirmeye karar veren kişidir. Agent'lar araştırır, yürütür, test eder ve raporlar. İnsanlar yön belirler, yetki verir ve sonucu kabul eder. Yükseltme yolunuz bir yeniden deneme döngüsüyse, tam da bir insana ihtiyaç duyan kararı otomatikleştirmiş olursunuz.
Gecikmeye duyarlı işleri bir katman aşağı yönlendirmeden önce dikkat etmeye değer bir şey daha var. Her iki satıcıdan bağımsız bir üçüncü taraf olan Artificial Analysis, "max" akıl yürütme varyantlarını Sol için saniyede 115,2 çıktı token'ı ve ilk token'a 102,15 saniye, Luna için ise saniyede 153,9 token ve 124,23 saniye olarak ölçtü. Bunlara güvenmeden önce güncel listeyle doğrulayın. [VERIFY] Önemli olan şekil: maksimum akıl yürütme eforunda ucuz modeller hızlı başlayan modeller değildir ve yüz saniye boyunca düşünen bir Agent, tam olarak takılıp kalmış bir Agent gibi görünür. Hangi katmana yönlendirirseniz yönlendirin, Runtime'ın ilerlemeyi ve başarısızlığı nasıl bildirdiği, farkı birinin fark edip etmeyeceğini belirler.
Yönlendirme kuralı ne zaman yazılmaz
Tek bir depoda tek bir ajan çalıştırıyorsanız bunların hiçbirini yapmayın. İşinize uyan katmanı seçin ve devam edin. Yönlendirme, bakımı için bir belge ve yapılacak bir tartışma gerektirir; karşılığını ise ancak birden fazla Agent aynı anda çalıştığında ve maliyetleri ya da başarısızlık örüntüleri farklılaştığında verir.
Eşik kabaca şu: iki veya daha fazla kişi bir çalıştırma başlatabiliyorsa ya da tek bir bütçe birden çok eşzamanlı Agent'ı kapsıyorsa kuralı yazın. Bunun altında kural fazlalıktır. Üstünde ise yokluğu, kimsenin geçen ayın faturasını açıklayamamasının nedenidir.
Değişmeyen sayı
Tamamlanan iş başına maliyet, bu lansmanın her iki tarafında da sert biçimde düştü. Ölçek için: OpenAI, medyan araştırmacısının kodlama ajanlarına günde $600'ün üzerinde harcadığını, 90. yüzdelik dilimin ise $7.000 olduğunu bildiriyor. Bu çizginin altındaki ekipler, aynı bütçeyle birkaç kat daha fazla bitmiş ajan işi elde etti; bu da fatura başına değil Runtime başına izlemeye değer.
Buna karşılık sıfır ek inceleyici saati kazandılar. Yönlendirme bir maliyet kaldıracı ve bir güvenilirlik kaldıracıdır; bir verim kaldıracı değildir, çünkü bir kişinin kabul etmesini bekleyen iş kuyruğu değişmez. Yönlendirmenin yapabileceği şey bu kuyruğu okunur kılmaktır: bu diff'i hangi katman üretti, ne kadara mal oldu, kaç deneme gerektirdi ve iki kez başarısız olan Task birinin Inbox'ında mı duruyor yoksa hiçbir yerde mi? Hedefi, çalıştırmayı, maliyeti, engelleri ve incelemeyi talepten sürüme kadar Task üzerinde tutun; o zaman yönlendirme kuralı, altı kişinin gizlice sürdürdüğü bir alışkanlık değil, ekibin düzenlediği bir ayar hâline gelir.
Sharkly modeli çalıştırmaz ve sizin için model seçmez. Bunu yapan araçların etrafındaki paylaşılan Task, Computer, bağlam ve inceleme katmanıdır; bir yönlendirme kuralının onu yazan kişiden daha uzun yaşaması gerekiyorsa bulunması gereken yer de tam olarak burasıdır. Hâlihazırda birden fazla kodlama ajanı çalıştırıyorsanız, hangi model hangi görevi alır ve hangi ajan onu alır, aynı kararın iki farklı taraftan görünümüdür. Bir Computer bağlayın, her katman için bir Agent oluşturun ve ucuz olana sıkıcı bir şey verin.