Özetle (TL;DR): OpenAI’ın yapay zekâ ajan ekibi, Linux çekirdeğindeki 5.034 denetim hedefini yaklaşık 1,2 milyon dolarlık API kredisi kullanarak 948 özgün yerel yetki yükseltme (LPE) istismarına dönüştürdü; ardından insan araştırmacılar sonuçları inceledi. Bu yapıyı kendi kodunuza da uyarlayabilirsiniz: Ajanlar erişilebilir alanları keşfeder, analiz eder, her bulguyu izole bir ortamda kanıtlar ve bir düzeltme taslağı hazırlar; bir insan ise son onayı verir.
4 Kasım 2026'da OpenAI, “A thousand fewer paths to root” başlıklı bir yazı yayımladı. Manşette 948 Linux açığı yer alıyor. Ancak yazılım ekipleri için asıl ders bunun altında yatıyor: Bu sonuç, her birinin bir sonrakine somut kanıtlar aktardığı aşamalar hâlinde çalışan ve sürecin sonunda bir insanın yer aldığı özelleşmiş ajanlar sayesinde elde edildi.
Bu mimari çekirdek (kernel) uzmanlığına bağımlı değildir; dolayısıyla aynı yapıyı kendi servislerinize de uygulayabilirsiniz. Konunun aciliyeti oldukça gerçek: OpenAI, kurduğu bu ardışık düzenin (pipeline) herkese açık ödül avcılığı (bug bounty) ödemelerine kıyasla “net kârda” olduğunu belirtiyor. Saldırganlar da bu hesabı yapabilir; bu yüzden şimdiden başlayın.
OpenAI’ın yapay zekâ ajan ekibinin bulguları
OpenAI, bu iş akışını 2026 Ekim ayının ortalarında, yakında çıkacak bir siber güvenlik modelini kullanarak en güncel Linux çekirdeğine karşı çalıştırdı. Hedefler, standart korumaları devrede olan standart bir masaüstü işletim sistemi çalıştıran izole sanal makinelerden (VM) oluşuyordu.
| Aşama | Sonuç | API maliyeti |
|---|---|---|
| Scout (Keşif) | 5.034 denetim hedefi, yaklaşık 2,8 milyon satır, çekirdeğin kabaca %7'si | 3.426 $ |
| Analyze (Analiz) | 2.308 aday bulgu | 316.549 $ |
| Validate (Doğrulama) | 1.724 yeniden üretilen bulgu (yaklaşık %74,7) | 73.330 $ |
| İstismar edilebilirliği değerlendirme | 948 özgün LPE istismarı, 291 bilgi sızıntısı PoC'si | 820.123 $ |
| Toplam | 1.213.430 $ |
Bu rakamlar OpenAI’ın çekirdek ölçeğindeki verileridir; sizin deponuz (repo) için bir maliyet tahmini değildir. OpenAI, verimliliği değil kabiliyeti ölçtüğü için bu maliyetleri “daha ziyade bir üst sınır” olarak nitelendiriyor.
Üç temel kısıtı göz önünde bulundurun:
- Bunlar yerel yetki yükseltme (LPE) açıklarına yönelik hatalardır. Bir saldırganın öncelikle yerel bir erişim noktası elde etmesi gerekir. Kendi başlarına uzaktan çalıştırılabilen açıklar değillerdir.
- Birçoğu henüz düzeltilmedi. 10 günlük tarama ve analiz süreci sona erdiğinde, 61 LPE ana kaynakta (upstream) yamalanmış, 43'ü hazırlık (staging) yamasına kavuşmuş ve 299'u kamuya açık şekilde tartışılmaktaydı. OpenAI, kritik hatalar için yüzlerce rapor ve yama iletti; geri kalanları ise Patch the Planet ortaklarıyla kademeli olarak göndermeye devam ediyor.
- OpenAI’ın yazısında, bu açıkların sahada aktif olarak istismar edildiğine dair bir bilgi bulunmuyor.
Buna rağmen OpenAI’ın uyarısı son derece nettir: En son yamaları almamış bir işletim sisteminde, düşük yetkili bir hesabın “kaynakları güçlü bir tehdit aktörü için işlevsel olarak root erişimine eşdeğer kabul edilmesi gerektiği” belirtiliyor. Bu yüzden yamaları aksatmayın ve etki alanını (blast radius) Firecracker ve gVisor gibi izolasyon çözümleriyle sınırlandırın.
Yapay zekâ ajanlı güvenlik iş akışının beş aşaması
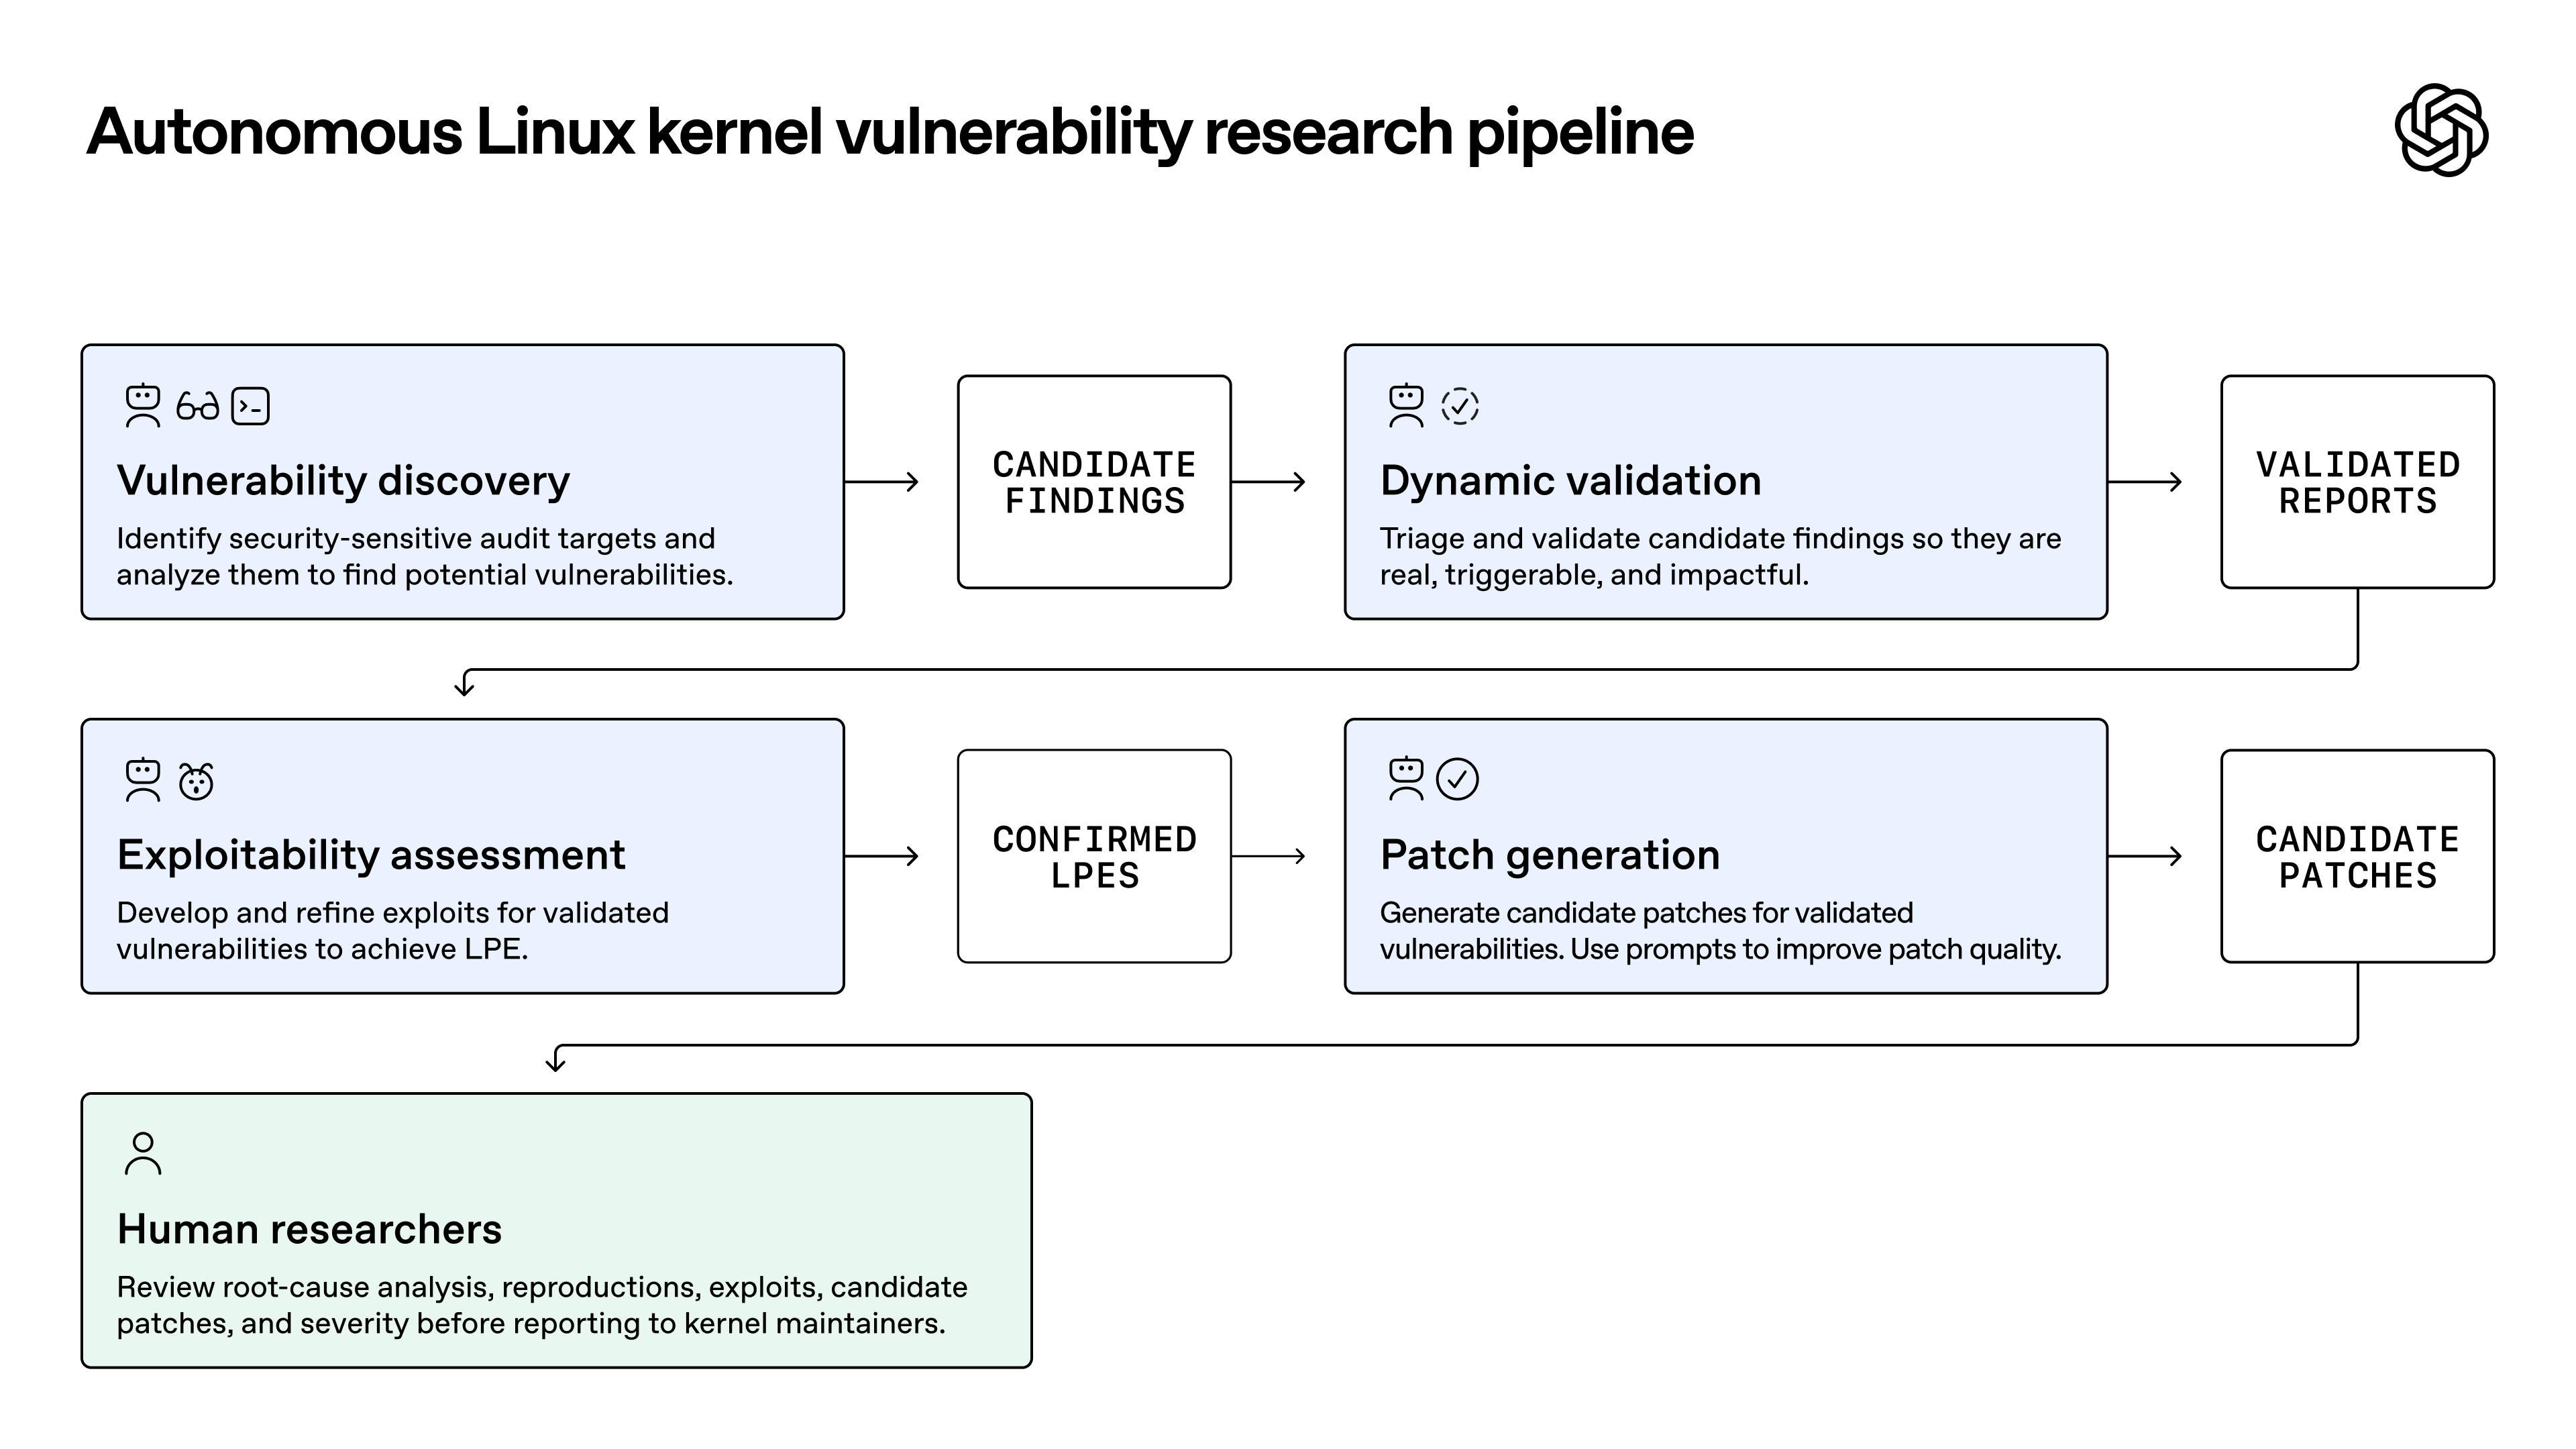
Yapay zekâ ajanlı güvenlik iş akışı, incelemeyi aşamalara ayırır; her aşama kapsamı daraltır ve bir sonraki aşama için somut kanıt üretir. OpenAI’ın modelinde beş aşama bulunur:
- Keşif (Discovery). Keşif (Scout) ajanları, denetim hedeflerini erişilebilirlik ve güvenlik açısından önemlerine göre seçer. Analist ajanlar her hedefi okur, bir tehdit modeli oluşturur ve aday bulguları raporlar.
- Dinamik doğrulama (Dynamic validation). Triyaj ajanları bir kavram kanıtlama (PoC) kodu yazar ve bunu çekirdek bellek hatalarını tespit eden KASAN ile donatılmış izole bir sanal makinede çalıştırır; hata yeniden üretilene veya tüm seçenekler tükenene kadar kodu iyileştirir.
- İstismar edilebilirliği değerlendirme (Exploitability assessment). Bir eleme ajanı, makul bir istismar yolu olmayan bulguları eler. ExploitDev ajanları ise kalanları test eder.
- Yama üretimi (Patch generation). Ajanlar, doğrulanmış her hata için ilgili kod tabanının kurallarına uygun ve varyantları da kontrol eden bir yama taslağı hazırlar.
- İnsan incelemesi (Human review). Güvenlik araştırmacıları, geliştiricilere iletilmeden önce istismar kodunu, yamayı ve önem derecesini inceler.
Her devir teslim süreci kişisel görüşler yerine somut kanıtlar aktarır; böylece sürecin sonundaki insan kararlarını olgulara dayandırarak verir.
Her aşamayı kendi deponuza nasıl uyarlarsınız?
Bu iş akışını yalnızca sahibi olduğunuz veya test etmeye yetkili olduğunuz kod tabanlarında kullanın. Kendi deponuz için istismar geliştirme aşamasını tamamen çıkarabilirsiniz. Başarısız olan bir test, bir saldırı aracı üretmeden de hatanın varlığını kanıtlar.
| OpenAI aşaması | Sizin sürümünüz | Çıktı |
|---|---|---|
| Scout | Anonim veya düşük yetkili kullanıcıların erişebileceği giriş noktalarını listeleyin: rotalar, web kancaları (webhooks), dosya yüklemeleri, ayrıştırıcılar, kuyruk tüketicileri | Denetim listesi |
| Analyst | Her çalıştırmada tek bir hedef: kodu okuyun, kısa bir tehdit modeli yazın, şüphelenilen kusurları bildirin | Aday bulgular |
| Validate | Tek kullanımlık bir ortamda hata veren minimal bir test yazın | Test ve log çıktısı |
| Assess | Aşılan güven sınırına göre etkiyi derecelendirin | Gerekçeli önem derecesi |
| Patch | Düzeltmeyi, testi de içerecek şekilde bir pull request olarak taslak hâline getirin | Pull request |
| Human | İnceleyin, ardından birleştirin veya reddedin | Birleştirilmiş düzeltme veya kapatılmış bulgu |
Kapsamı daraltmak maliyetini fazlasıyla karşılar. OpenAI’ın keşif ajanları 3.426 dolara mal oldu ve denetim alanını çekirdeğin yaklaşık %7'sine indirdi. İşe tek bir servis ve onun herkese açık giriş noktalarıyla başlayın. Tek bir bulgu için tanımlanan görev şu kısalıkta olabilir:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Yalnızca sonucu değil, izlenen yolu da doğrulayın
Erken çalıştırmalardan birinde, OpenAI’ın istismar aşaması 200 başarılı sonuç bildirdi. Yapılan insan incelemesinde, bunlardan 20'sinin hedeflenen açık yerine tamamen farklı bir sıfır gün (0-day) açığı üzerinden root yetkisine ulaştığı ortaya çıktı. İş akışı sadece sonuca bakarak başarı işareti koymuştu ve sonuç doğruydu, ancak yanlış gerekçeyle gerçekleşmişti.
OpenAI görev kısıtlamalarını sıkılaştırdı ve her istismarın kendisine atanan güvenlik açığını kullandığından emin olmak için bağımsız bir kontrol adımı ekledi. Buradan çıkarılan ders: Sonucun kendisi kadar, sonuca giden yolu da doğrulayın.
Kendi süreçlerinizde de benzer bir durumla karşılaşabilirsiniz: Bir ajan, yazdığı testin kimlik doğrulama kusurunu kanıtladığını söyler ancak test aslında eksik bir fixture nedeniyle başarısız oluyordur. Testi yazmamış bağımsız bir kontrol ajanı ekleyin ve ona tek bir soru sorun: Bu başarısızlık gerçekten rapor edilen kod yolundan mı kaynaklanıyor?
Erken doğrulayın, çünkü yanlış pozitiflerin maliyeti de aynıdır
OpenAI, gerçek bir pozitif bulguyu doğrulamaya çalışmakla yanlış bir pozitif bulguyu doğrulamaya çalışmanın neredeyse aynı maliyette olduğunu tespit etti. Dolayısıyla doğrulama aşamasına ulaşan her hatalı aday, tam bir çalıştırma maliyeti tüketir.
Kanıtlamaya geçmeden önce filtreleyin. OpenAI; düşük yetkili bir kullanıcının erişebildiği, özel yetkilere ihtiyaç duymayan ve ölçülebilir kanıtlar üreten bulguları doğrulamaya aldı. Kendi kodunuz için de “yönetici rolü olmadan erişilebilir olma” gibi eşdeğer filtreler tanımlayın. Bu filtreyi geçemeyen bulgular gerekçesi belirtilerek kapatılmalıdır.
Ayrıca, mükerrer veya geçerliliğini yitirmiş bildirimlerin önüne geçmek için bulguları raporlamadan önce, OpenAI’ın da önerdiği gibi, en güncel koda karşı yeniden kontrol edin.
Çalıştırma başlamadan önce bir vazgeçme kuralı belirleyin
Başarısız denemeler en maliyetli olanlardı. LPE adaylarında, 69 başarısız denemenin her biri ortalama 3.922 dolara mal olurken, 1.169 başarılı denemenin ortalama maliyeti 360 dolardı. Yaptığımız hesaba göre, tüm denemelerin yaklaşık %6'sı, bu aşamada harcanan 691.000 doların yaklaşık %39'unu tüketti.
OpenAI’ın önerdiği çözüm; ilerleme kaydedilmeden geçen bir saatin ardından işlemi durdurmak gibi bir vazgeçme (give-up) koşulu tanımlamaktır. Bu kuralı görev tanımına ekleyin ve çalıştırma üzerinde kesin bir sınırla destekleyin.
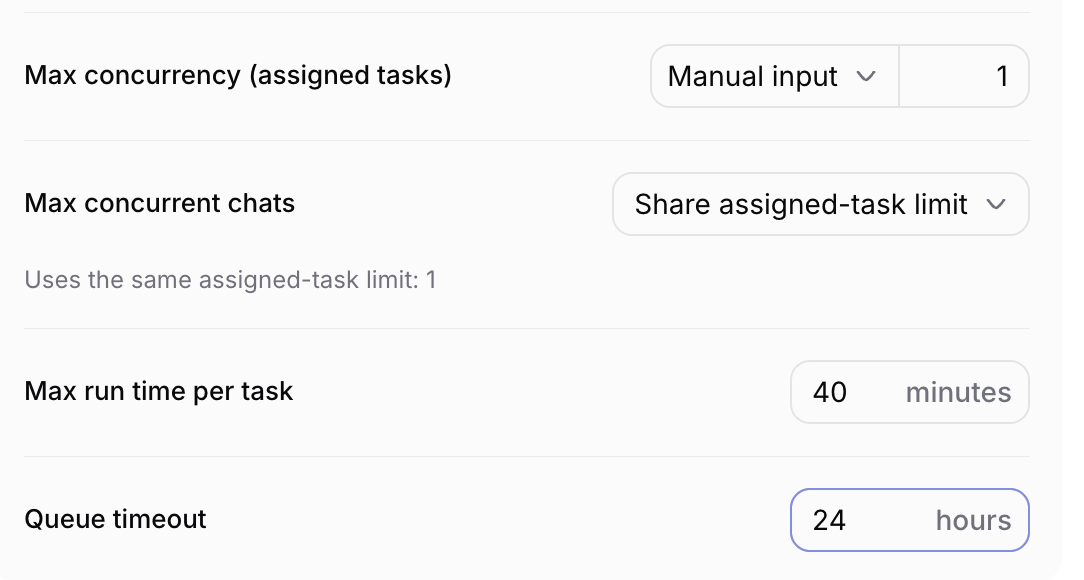
Sharkly'de Görev başına zaman aşımı, bir Ajanın Run settings bölümünde yer alır. Bu bir ilerleme algılayıcısı değil, bir zaman sınırıdır; bu nedenle talimatlar arasına “yeni kanıt yoksa dur” kuralını mutlaka ekleyin.
Modeller geliştikçe orkestrasyonu sade tutun
OpenAI, GPT-5.5 Cyber için başarı oranını %76,2'den %88,9'a çıkaran 103 istismar tekniğinden oluşan bir katman oluşturmuştu. Aynı katman GPT-5.6 Cyber modelinde yalnızca 1,5 puanlık bir artış sağlayınca OpenAI bu katmanı kaldırdı.
Modelleri her değiştirdiğinizde kendi yapı iskelesi (scaffolding) mantığınızı yeniden test edin. Taramaları da tekrarlayın: Ekim ayındaki çalışma, üç ay daha fazla sıkılaştırma görmüş bir kod tabanında, Temmuz ayında GPT-5.6 Sol ile yapılan çalışmaya kıyasla 5 kattan fazla yeni LPE buldu.
Canlıya geçmeden önce insan incelemesini devrede tutun
Ajanlar düzeltme taslaklarını pull request olarak sunar. Birleştirmeyi (merge) ise bir insan yapar. OpenAI, ilk tur yamaların gerekenden daha kapsamlı olabildiğini, varyantları kaçırabildiğini veya kod kurallarını bozabildiğini; ilave turların ise bunları iyileştirdiğini gözlemledi.
Ayrıca hem insanların hem de yapay zekânın yazdığı yamaların çekişmeli (adversarial) incelemesi için modellerin kullanılmasını tavsiye ediyor. Dolayısıyla bir ajanın düzeltmeyi atlatmayı (bypass) denemesini sağlayın, ardından kararı bir insana bırakın. İnceleme süreci hâlihazırda darboğazınız hâline geldiyse, yeni bir pull request akışı eklemeden önce paralel ajanlar için inceleme süreçlerinin nasıl tasarlanacağını okuyun.
Bu iş akışı Sharkly'de Görevler olarak nasıl çalıştırılır?
Sharkly'deki temel iş birimi bir Görevdir (Task). Bu iş akışını kurgulamanın bir yolu şöyledir:
- Bir görev türü oluşturun. Bir görev türü (task type), sıralı durumlardan oluşan bir İş Akışına (Workflow) sahiptir. Bir “Güvenlik bulgusu” türü; Aday, Yeniden Üretildi, Yama Hazırlandı, İncelemede ve Kapatıldı adımlarını içerebilir.
- Bir Ekip (Crew) oluşturun. Bir Ekip (Crew), tek bir lider Ajan tarafından koordine edilen, İnsanlar ve Ajanlardan oluşan yeniden kullanılabilir bir gruptur. Keşif, analist, kontrol ve yama Ajanlarını ekleyin. Lider ajan ilk olarak başlar ve belirli işler için ekip üyelerini etiketler.
- Çalıştırmaları izole edin. Her Görevin kendi çalışma ağacını (worktree) alması için bir geçici dizin kullanın ve paralel çalışmayı ölçeklendiriyorsanız izole çalışma ağaçları rehberimizi okuyun. Kontrol Ajanının bağımsızlığa ihtiyaç duyduğu durumlarda Ekibin paylaşılan dizinini devre dışı bırakın.
- Devir teslimleri otomatikleştirin. Görev durumu tetikleyicisine sahip bir Otomasyon, bir Görev “Yeniden Üretildi” durumuna ulaştığında yama Ajanını başlatabilir. Bu çalıştırmalar katılımsızdır (unattended) ve soru soramaz; ayrıca durum eşleştirmesi organizasyon genelindedir, bu nedenle talimatların tetikleyici Görevi doğrulamasını sağlayın.
- Pull request'leri bağlayın. GitHub entegrasyonu ile dal (branch) adındaki, başlıktaki veya açıklamada yer alan görev kimliği pull request'i otomatik olarak bağlar. Birleştirme işlemi görev durumunu değiştirmez; bu nedenle Görevi inceleyen kişi kapatır.
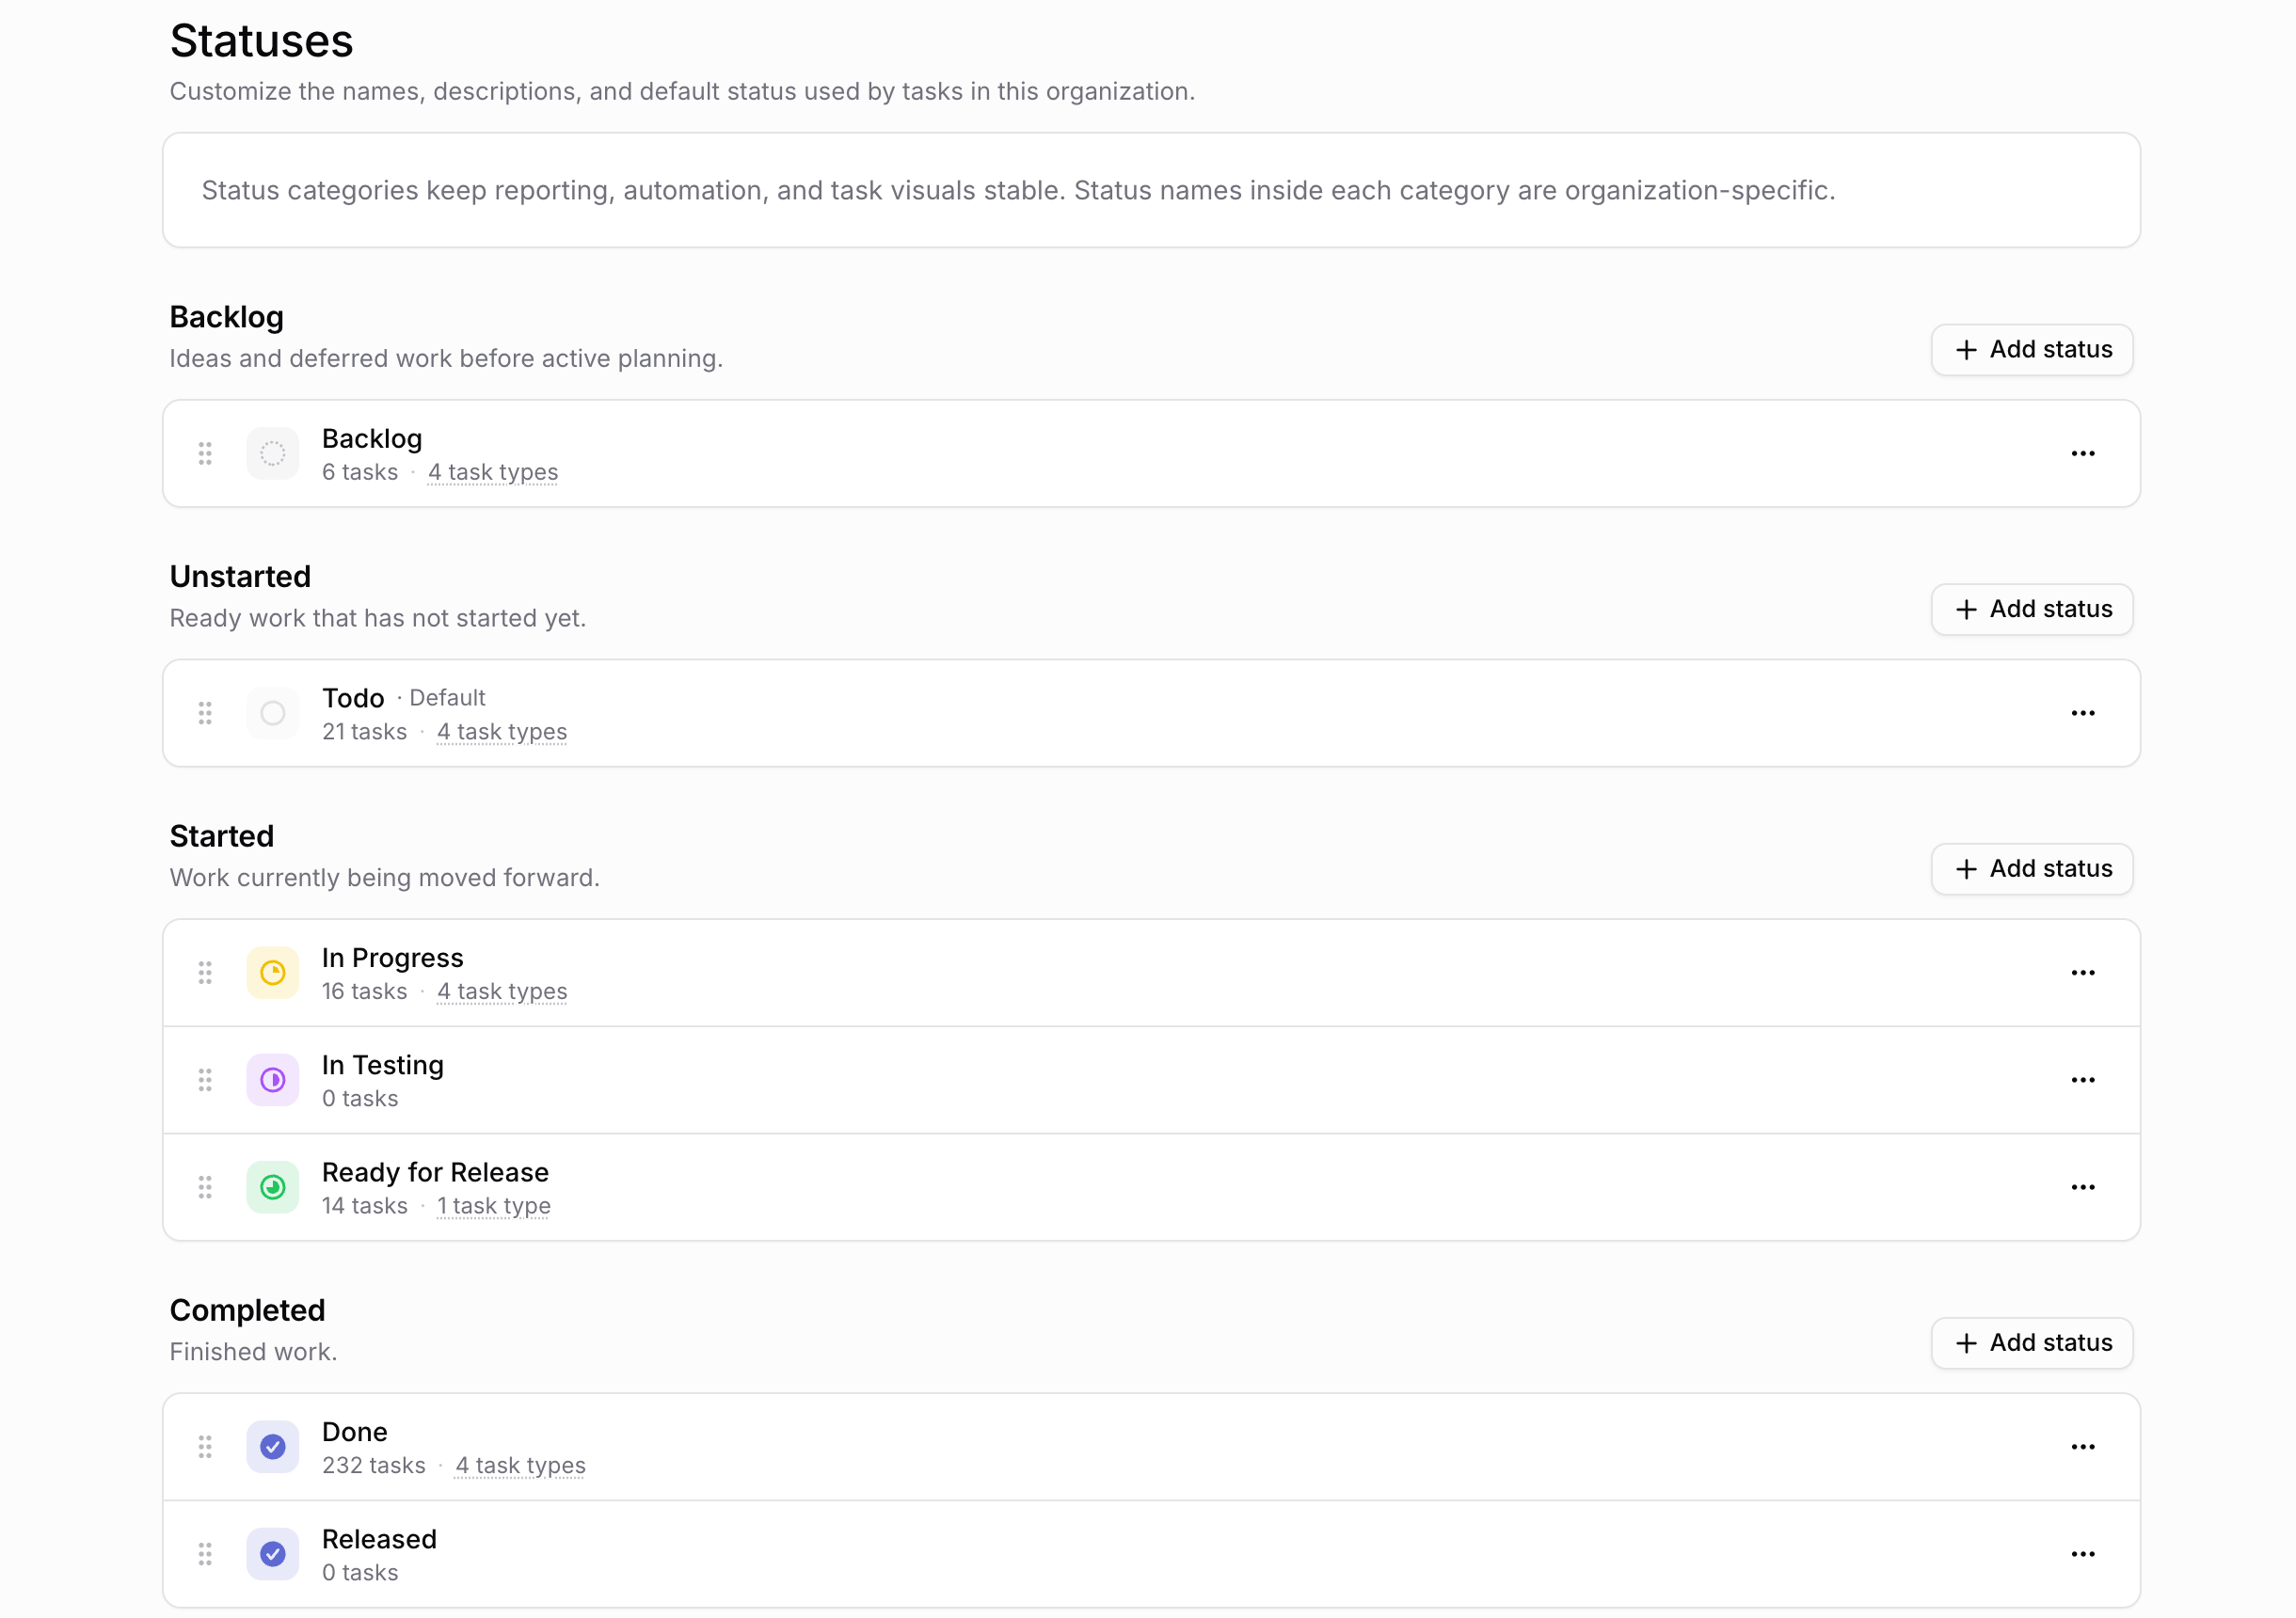
Durumlar Organizasyon genelinde paylaşıldığından, mevcut olanları yeniden adlandırmak yerine bu iş akışı için yenilerini ekleyin.
Burada kritik bir sınır söz konusudur: Bir çalışma ağacı Görevlerin birbiriyle çakışmasını engeller, ancak bir güvenlik koruma alanı (sandbox) değildir. Yeniden üretim testlerini hiçbir üretim parolası veya gizli bilgisi içermeyen tek kullanımlık bir konteynerde veya sanal makinede çalıştırın ve Ajanlara yalnızca ihtiyaç duydukları minimum Git erişim yetkisini verin.
Sharkly bu çalışmayı koordine eder. Yürütme işlemini Claude Code, Codex ve benzeri araçlar gerçekleştirir ve model kullanımı bu araçlarda yapılandırılan abonelikler veya API anahtarları üzerinden devam eder. Sistemi ölçeklendiriyorsanız, aynı anda 10 yapay zekâ kodlama ajanının nasıl çalıştırılacağına göz atın.
Küçük bir depo için tek bir Ajanı tek bir Göreve atayın ve Ekip adımını atlayın. Bir liderin birden fazla rolü sıralaması ve sonuçları tek bir Görevde bir araya getirmesi gerektiğinde bir Ekip kullanın.
Sonuç
OpenAI’ın elde ettiği sonuç ekibiniz için bir yol haritası niteliğindedir: Kapsamı daraltın, her devir teslimde somut kanıt talep edin, izlenen yolu doğrulayın, başarısız çalıştırmaları erkenden sonlandırın ve birleştirme düğmesinin başında mutlaka bir insan bulundurun.
Bu hafta başlayın. Sahip olduğunuz bir servisi seçin, herkese açık giriş noktalarını listeleyin ve şüphelenilen her kusur için bir doğrulama Görevi açın. Sharkly'nin hızlı başlangıç kılavuzu ilk Ajanınızı bağlı bir Bilgisayarda çalıştırmanızı sağlar; sharkly.ai ise görev ve inceleme katmanının ajanlarınızın etrafına nasıl konumlandığını gösterir.
SSS
OpenAI ajanları canlı Linux sistemlerine mi saldırdı?
Hayır. İstismarlar kontrollü bir araştırma ortamındaki izole sanal makinelerde çalıştırıldı ve sonuçlar raporlanmadan önce insan araştırmacılar tarafından incelendi.
948 Linux güvenlik açığının tümü yamalandı mı?
Hayır. Birçoğu hâlâ raporlanma ve yamalanma aşamasındadır. 10 günlük taramanın sonunda 61'i ana kaynakta (upstream) yamalanmış, 43'ü ise hazırlık (staging) yamalarına kavuşmuştu.
Bu açıklar bir sunucuyu uzaktan ele geçirebilir mi?
Kendi başlarına hayır. Bunlar yerel yetki yükseltme (LPE) hataları olduğundan saldırganın öncelikle yerel bir erişim noktası elde etmesi gerekir. Sistemlerinizi güncel tutun ve güvenilmeyen iş yüklerini izole edin.
Bu iş akışının kendi depomdaki maliyeti ne olur?
OpenAI’ın rakamları doğrudan uyarlanamaz çünkü çekirdek ölçeğindeki bir çalıştırmayı kapsar. İşe tek bir servisle başlayın, çalıştırma sınırları belirleyin ve doğrulanmış bulgu başına maliyeti ölçün.
OpenAI’ın siber modeline ihtiyacım var mı?
OpenAI bunu yakında çıkacak bir model olarak tanımladığı için henüz kullanamazsınız. Aşamalar modelden bağımsızdır; bu nedenle ekibinizin hâlihazırda kullandığı kodlama ajanlarıyla bunları test edin ve çıktıyı sunduğu kanıtlara göre değerlendirin.