
Web scraping miễn phí cho AI agent giờ đã chạy trên chính phần cứng của bạn. Firecrawl Local là một binary Rust duy nhất có khả năng scrape, crawl và map các trang web thành markdown, kết nối với Claude Code, Codex, Cursor hoặc Gemini CLI như một MCP server, và trả lời API Firecrawl v2 ngay trên localhost. Chỉ cần đặt FIRECRAWL_CLOUD=off là không một trang, truy vấn hay URL nào rời khỏi máy của bạn.
TL;DR
- Cài đặt:
cargo install firecrawl-local(cần Rust và trình biên dịch C). Bản build của chúng tôi mất 5 phút 55 giây và cho ra binary nặng 19 MB. - Kết nối:
firecrawl-local initsẽ thêm MCP server vào mọi công cụ agent được hỗ trợ mà nó tìm thấy. - Chi phí: $0 cho scrape, crawl, map và batch scrape. Search, các trang bị chặn và các data provider của Alexandria sẽ được chuyển tới Firecrawl Cloud, trừ khi bạn tắt đi.
- Công tắc riêng tư:
FIRECRAWL_CLOUD=offgiữ mọi thứ ở lại cục bộ. - Thiết lập cho team: cài một lần trên Computer mà các agent của bạn chạy, và mọi agent trên Computer đó đều dùng chung một scraper.
Firecrawl Local là gì
Firecrawl Local là một binary duy nhất từ đội ngũ Firecrawl, có nhiệm vụ tải trang web, làm sạch chúng thành markdown và trả về đúng loại JSON mà API Firecrawl được lưu trữ trả về. Nó không cần database, queue hay container. Firecrawl công bố công cụ này vào ngày 18/11/2026, và crate trên crates.io đã xuất hiện từ một tuần trước đó với phiên bản 0.1.0.
README mô tả ba cách sử dụng: một CLI, một MCP server cho agent, và một bản sao cục bộ của API v2. Phần code làm sạch được biên dịch từ chính source mà API lưu trữ sử dụng, nên một trang markdown từ laptop của bạn sẽ khớp với kết quả cloud trả về cho cùng một trang mà cả hai đều truy cập được.
Bài đăng ra mắt của Firecrawl khẳng định primitive scrape nhanh gấp 37 lần so với Firecrawl tự host và tốn ít bộ nhớ hơn 230 lần, chỉ 11 MB khi idle. Đó là số liệu của Firecrawl; README không công bố phương pháp đo. Chúng tôi đã tự đo phần bộ nhớ ở bên dưới.
Nếu bạn đang chạy nhiều coding agent, đây là scraper đầu tiên mà bạn có thể giao cho tất cả chúng mà không phải trả phí theo từng lần gọi. Phần còn lại của bài viết sẽ đi qua cách thiết lập, công tắc riêng tư, và cách cấp cho cả một team agent cùng một công cụ trên Sharkly.
Vì sao agent cần một scraper cục bộ
Một agent không đọc được web sẽ phải làm việc với dữ liệu huấn luyện đã cũ. Nó đoán mò một API nó chưa từng thấy, hoặc yêu cầu bạn dán tài liệu vào chat.
Các API scraping được lưu trữ giải quyết được điều đó, nhưng kéo theo hai loại chi phí. Mỗi trang là một lần gọi bị tính phí, nên việc crawl một site tài liệu 400 trang sẽ thành một dòng trên hoá đơn. Và mọi URL mà agent mở đều đi qua server của người khác — điều này đáng quan tâm khi agent đang nghiên cứu domain của khách hàng hoặc một trang sản phẩm chưa ra mắt của đối thủ.
Một scraper cục bộ loại bỏ cả hai. Trang được tải từ chính mạng của bạn và được làm sạch trên CPU của bạn. Cái giá phải trả là bạn tự lo phần cài đặt và các giới hạn đi kèm với một chiếc laptop.
Cài đặt Firecrawl Local
Bạn cần Rust và một trình biên dịch C. Trên macOS, xcode-select --install là đủ cho phần biên dịch; trên Debian hoặc Ubuntu, hãy cài build-essential. Cài Rust từ rustup.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Hai thành phần phụ là tuỳ chọn. Chrome hoặc Chromium cho phép render những trang cần JavaScript; nếu không có, trang tĩnh vẫn hoạt động bình thường và một trang nặng về script sẽ trả về kèm cảnh báo. Node.js 22 trở lên là cần thiết cho MCP server, vì firecrawl-local mcp chạy package npm firecrawl-mcp thông qua npx.
Scrape, crawl và map từ CLI
Ba lệnh là đủ cho hầu hết công việc của agent.
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
Chúng tôi đã chạy từng lệnh vào ngày 19/11/2026 với cloud đã tắt. Một lần scrape example.com mất 1,6 giây. Một lần crawl 10 trang tài liệu của chính Firecrawl mất 4,2 giây và ghi ra 144 KB markdown. map trả về danh sách URL tài liệu trong 3,9 giây.
| Lệnh | Các flag hữu dụng |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (mặc định 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Mọi lệnh | --browser auto|never|always |
Một điều cần lưu ý từ lần chạy thử của chúng tôi: trên mạng chỉ ra được web qua proxy, lần scrape đầu tiên thất bại với lỗi TLS. Đặt HTTPS_PROXY là khắc phục được, tức là binary có tuân thủ các biến proxy tiêu chuẩn.
Kết nối với AI agent qua MCP
MCP (Model Context Protocol) là cách tiêu chuẩn để một công cụ agent nạp các công cụ bên ngoài. Firecrawl Local tự đăng ký mình như một công cụ như vậy.
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
Lần dry run trên máy Mac của chúng tôi liệt kê năm mục tiêu: Claude Code trong ~/.claude.json, Claude Desktop, Cursor trong ~/.cursor/mcp.json, Gemini CLI trong ~/.gemini/settings.json và Codex trong ~/.codex/config.toml. Windsurf cũng được hỗ trợ nếu đã cài. Hãy khởi động lại từng công cụ sau khi chạy init để nó nạp server. Dùng --agent cursor nếu bạn chỉ muốn thiết lập một công cụ.
Để thêm bằng tay, hãy đăng ký binary như một stdio server:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
Agent sẽ nhận được bộ công cụ MCP chuẩn của Firecrawl. Scrape, crawl, map và batch scrape chạy cục bộ; phần còn lại chuyển tới Firecrawl Cloud. Flag --public-only là phần bổ sung của chúng tôi, được giải thích trong mục bảo mật bên dưới.
Tắt cloud để bảo vệ quyền riêng tư
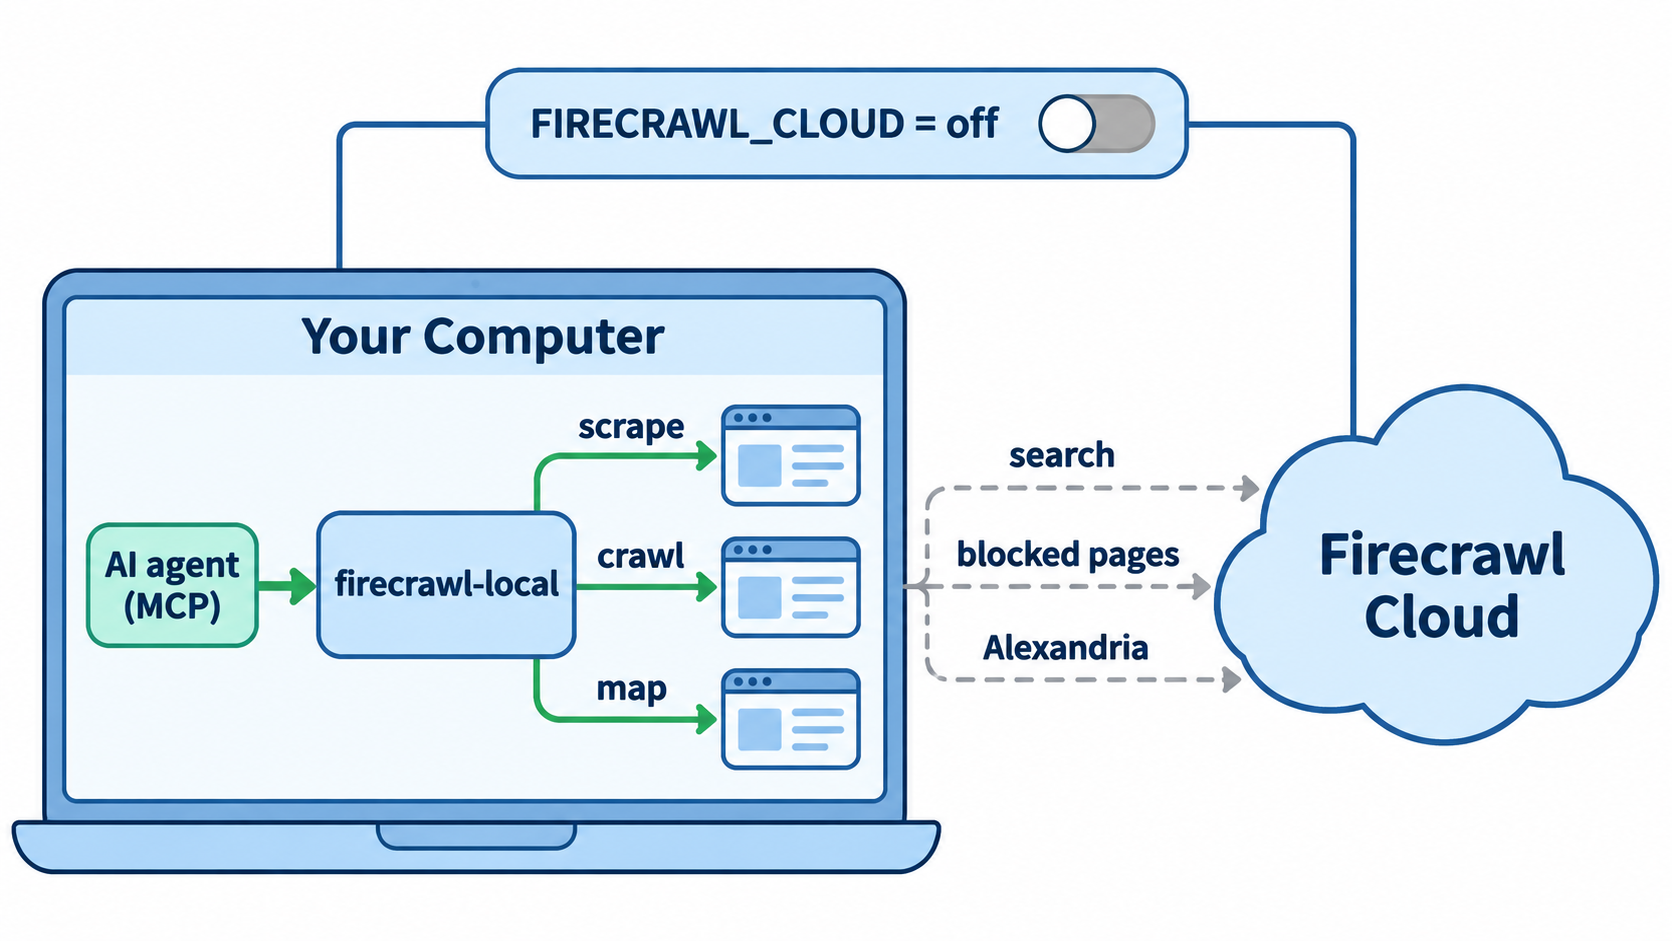
Có ba loại công việc cần tới Firecrawl Cloud, vì một chiếc laptop không có search index và không có cách nào vượt qua một trang web chặn nó.
| Dữ liệu gửi tới Firecrawl Cloud | Lý do | Tài khoản |
|---|---|---|
| Truy vấn tìm kiếm | Không có search index cục bộ | Không; tìm kiếm không cần key sẽ bị giới hạn tốc độ |
| URL của trang đã chặn bạn | Cloud sẽ tải trang đó thay bạn | Không |
| Các data provider của Alexandria | Các provider chạy trên cloud | Có, tài khoản miễn phí qua firecrawl-local login |
| Một install ID ngẫu nhiên và tên công cụ của bạn | Đếm số lượt cài đặt | Không |
Biến FIRECRAWL_CLOUD kiểm soát việc bàn giao này. auto (mặc định) cho phép tất cả những điều trên. search chỉ gửi truy vấn tìm kiếm. off không gửi gì cả, và một giá trị không nhận diện được cũng được tính là off. Một trang được cloud tải về sẽ có gắn thẻ "source": "firecrawl-cloud", giúp bạn kiểm tra được những gì đã rời khỏi máy.
Với công việc agent trên site của khách hàng hoặc nghiên cứu nội bộ, hãy bắt đầu với off. Agent của bạn sẽ mất khả năng web search, nên hãy ghép nó với công cụ tìm kiếm nào bạn đã tin tưởng.
Chạy API Firecrawl cục bộ
firecrawl-local serve trả lời API Firecrawl v2 trên cổng 3002 mà không cần API key cho các route cục bộ. Code SDK hiện tại chỉ cần đổi một URL là chuyển sang dùng được.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Các route cục bộ gồm POST /v2/scrape, POST /v2/map, crawl và batch scrape cùng các endpoint trạng thái và huỷ của chúng, và GET /health. Các route /v2 khác như /v2/search sẽ được chuyển tiếp tới cloud; v0 và v1 không được phục vụ.
Chúng tôi đã đo bộ nhớ khi nó chạy: tiến trình serve ở mức 10 MB resident khi idle và 16 MB sau một lần scrape. Con số này khá sát với tuyên bố 11 MB của Firecrawl. Một lần scrape qua API trả về "creditsUsed": 0 và "engine": "local-fetch".
Các thiết lập bảo mật mặc định quan trọng với agent
Một agent đọc phải trang có chứa chỉ dẫn ẩn có thể bị dắt sang tải một URL nội bộ. OWASP xếp loại tấn công này vào nhóm prompt injection, và một scraper chính là con đường hiển nhiên để thực hiện nó.
servechỉ bind vào127.0.0.1và từ chối các địa chỉ localhost và địa chỉ riêng tư trừ khi bạn truyền--allow-private. Chúng tôi yêu cầu nó scrape127.0.0.1:22và nhận vềBLOCKED_TARGET.- Bind sang host khác bằng
--hostsẽ bắt buộc phải có--token. - Các địa chỉ link-local và cloud metadata bị chặn trong mọi chế độ, kể cả sau khi redirect.
scrape,crawlvàmcpmặc định có thể truy cập mạng riêng của bạn, vì chúng chạy cho người ngồi trước bàn phím. Hãy thêm--public-onlykhi agent duyệt những site bạn không tin tưởng.- Các lần crawl có đọc
robots.txt(theo chuẩn RFC 9309), và chủ site có thể nhắm tới crawler bằng tênFirecrawlLocal.
Những giới hạn cần tính trước
- Không hỗ trợ định dạng
jsonhaysummary, cũng không cóactionstrình duyệt khi chạy cục bộ. Yêu cầusummarycủa chúng tôi chỉ trả về metadata kèm cảnh báo rằng định dạng đó bị bỏ qua. - Chụp màn hình cần có Chrome.
- Các job crawl và batch lưu trong bộ nhớ, hết hạn sau một giờ kể từ khi bắt đầu, và kết thúc khi
servedừng. - Giấy phép: repository là AGPL-3.0. Hãy hỏi ý kiến pháp chế trước khi phát hành một bản sao đã chỉnh sửa bên trong một sản phẩm được lưu trữ.
Để có queue, worker và mọi định dạng, hướng dẫn tự host của Firecrawl bao quát toàn bộ server.
Cấp cho mọi agent trong team cùng một scraper
Một lập trình viên với một agent có thể dừng ở đây. Nhưng một team đang chạy nhiều agent sẽ gặp một vấn đề khác: công cụ của mỗi agent nằm trong config của máy tính mà nó chạy, và không ai theo dõi được agent nào có thể đọc web.
Trong Sharkly, một Agent chạy trên một Computer (laptop, server hoặc container bạn kết nối) thông qua một Runtime, tức công cụ agent được cài trên đó, ví dụ Claude Code hay Codex. Bạn cài công cụ lên Computer giống hệt như khi dùng trực tiếp. Sau đó phần cài đặt Tools, Knowledge & MCP của Agent sẽ liệt kê các MCP server mà nó kế thừa từ Claude Code trên Computer đó, bao gồm cả các stdio server trong cấu hình người dùng — chính là phạm vi mà init ghi vào.
Vậy nên quy trình là: cài Firecrawl Local lên Computer, chạy init, mở phần cài đặt của Agent và bấm Check. Chúng tôi đã xác nhận bảng này liệt kê được các stdio server trong cấu hình người dùng; chúng tôi chưa chạy thử một lần scrape Firecrawl bên trong Task của Sharkly, nên hãy thử trước với một Task chỉ đọc.
Đặt scraper trên một Computer luôn bật
Laptop thì có lúc ngủ. Một server Linux nhỏ được đăng ký làm Computer (sharkly computer register với install token dạng sit_, theo tài liệu về Computers) sẽ luôn trực, nên mọi Agent trỏ vào đó đều dùng chung một scraper và một chính sách FIRECRAWL_CLOUD. Hãy đặt biến này trong môi trường Runtime của Agent để chính sách đi theo Agent, chứ không đi theo người đăng nhập gần nhất.
Từ đó, công việc nghiên cứu trở thành thứ có thể giao được. Trưởng nhóm Crew chia “map tài liệu của năm nhà cung cấp này” thành các Task, mỗi Agent crawl phần của mình cục bộ, và kết quả đổ về bảng để con người xem lại. Sharkly hiện miễn phí cho tổ chức tối đa 5 người, và Agent lẫn Computer đều không chiếm seat; model vẫn dùng trên subscription của chính bạn.
Các tình huống sử dụng thực tế
- Nạp tài liệu: crawl tài liệu của một thư viện thành markdown trước khi agent nâng cấp một dependency.
- Nghiên cứu khách hàng tiềm năng: ghép scraping cục bộ với các provider của Alexandria, như trong bài hướng dẫn xây dựng lead list của chúng tôi.
- Theo dõi changelog: một Task được lên lịch map site của nhà cung cấp hàng ngày và đánh dấu các URL mới.
- Nghiên cứu riêng tư: scrape các trang của khách hàng hoặc trang trước khi ra mắt với cloud đã tắt, để không có gì rời khỏi mạng của bạn. Bài viết vì sao tắt web search không chặn được rò rỉ dữ liệu của AI agent của chúng tôi đề cập tới những đường thoát khác.
Kết luận
Firecrawl Local biến web scraping miễn phí cho AI agent thành một bản build sáu phút và một lệnh init. Hãy giữ FIRECRAWL_CLOUD=off cho công việc riêng tư, thêm --public-only cho những site không đáng tin, và xem các tuyên bố về tốc độ là của Firecrawl cho tới khi bạn tự đo lại.
Bước tiếp theo của bạn: cài nó lên Computer mà các agent đang dùng, rồi kết nối Computer đó với Sharkly để mọi Agent trong team đều nhận được cùng một scraper và cùng một bộ quy tắc. Muốn xem thêm các thiết lập $0, hãy đọc AI agent miễn phí cho team.
FAQ
Firecrawl Local có miễn phí không? Có. Scrape, crawl, map và batch scrape chạy cục bộ mà không cần API key, và lần scrape thử của chúng tôi báo 0 credit đã dùng. Search và Alexandria thì dùng Firecrawl Cloud.
Firecrawl Local có cần Docker không? Không. Nó là một binary duy nhất, không có database, queue hay container. Docker chỉ là một lựa chọn, và việc render JavaScript trong container cần một seccomp profile cho phép sandbox của Chrome.
firecrawl-local init hỗ trợ những agent nào? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI và Codex. Bất kỳ MCP client nào khác đều có thể đăng ký firecrawl-local mcp như một stdio server.
Tôi có thể giữ toàn bộ scraping ngoài server của Firecrawl không? Có. Đặt FIRECRAWL_CLOUD=off. Bạn sẽ mất search, cơ chế dự phòng cho trang bị chặn và Alexandria.
Firecrawl Local có nhanh hơn Firecrawl tự host không? Firecrawl nói nhanh gấp 37 lần và tốn ít bộ nhớ hơn 230 lần. Chúng tôi đo được 10 MB bộ nhớ khi idle, khớp với tuyên bố về bộ nhớ; chúng tôi chưa benchmark tốc độ so với một server tự host.
Firecrawl Local có phải mã nguồn mở không? Repository dùng giấy phép AGPL-3.0. Hãy đọc giấy phép trước khi phát hành một bản sao đã chỉnh sửa như một phần của dịch vụ được lưu trữ.


