

GPT-6.2 Astra vs Fable 5.2 thực ra cân tài cân sức hơn những gì các tiêu đề giật gân gợi ý. Cả hai đều niêm yết ở mức $8 mỗi triệu token đầu vào và $40 mỗi triệu token đầu ra. Anthropic công bố điểm lập trình tác tử (agentic coding) cao hơn cho Fable 5.2; OpenAI không công bố bất kỳ benchmark lập trình nào cho Astra. Giá cache, phụ phí ngữ cảnh dài và tỷ lệ thay đổi được chấp nhận của chính đội ngũ bạn sẽ quyết định ai là người thắng cuộc.
OpenAI phát hành GPT-6.2 Astra vào ngày 17 tháng 11 năm 2026, tám ngày sau khi Anthropic tung ra Claude Fable 5.2. Cả hai đều là những mô hình tiên phong hướng tới các tác vụ tác tử dài và khó. Nếu bạn đang vận hành các agent lập trình, giờ đây bạn có hai lựa chọn hàng đầu với cùng một mức giá niêm yết.
Một bảng xếp hạng không thể giải quyết chuyện này thay bạn. Các dependency, bộ test và những người review của bạn mới làm được điều đó. Hướng dẫn này so sánh các con số đã công bố, chỉ ra nơi hóa đơn có thể chênh lệch, và đưa ra một bài kiểm tra đối đầu mà bạn có thể chạy trên chính repository của mình. Nếu bạn đã chạy Codex và Claude Code song song, Sharkly là nơi bạn giao cùng một nhiệm vụ cho cả hai và lưu kết quả lại với nhau.
GPT-6.2 Astra vs Fable 5.2: thông số kỹ thuật đặt cạnh nhau
GPT-6.2 Astra là mô hình tiên phong của OpenAI trong dòng GPT-6.2; GPT-6.2 Sol là người anh em rẻ hơn dùng hàng ngày. Claude Fable 5.2 là mô hình hàng đầu được cung cấp rộng rãi của Anthropic, còn Mythos 5.2 được giữ lại như một bản phát hành hạn chế truy cập. Dưới đây là những gì mỗi nhà cung cấp công bố, được kiểm tra ngày 20 tháng 11 năm 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Ngày phát hành | 17 tháng 11, 2026 | 9 tháng 11, 2026 |
| Mã mô hình API | gpt-6.2-astra |
claude-fable-5-2 |
| Đầu vào, mỗi 1M token | $8 | $8 |
| Đầu ra, mỗi 1M token | $40 | $40 |
| Đầu vào cache (truy cập cache) | $0.40 | $0.20 |
| Ghi cache | $10 (30 phút) | $10 (5 phút), $16 (1 giờ) |
| Batch | 50% so với giá tiêu chuẩn | $4 đầu vào, $20 đầu ra |
| Chế độ nhanh | Gấp 2 giá tiêu chuẩn | $16 đầu vào, $80 đầu ra |
| Cửa sổ ngữ cảnh | 1.050.000 token (tối đa 922.000 đầu vào) | 1M token ở mức giá tiêu chuẩn |
| Đầu ra tối đa | 128.000 token | 128.000 token |
| Phụ phí đầu vào dài | Trên 272K đầu vào: giá đầu vào và cache tăng gấp đôi, đầu ra 1,5x | Không liệt kê |
| Agent lập trình thường dùng | Codex | Claude Code |
Nguồn: trang mô hình GPT-6.2 Astra của OpenAI, tài liệu giá và tổng quan mô hình của Anthropic.
Hai dòng quan trọng nhất đối với agent. Một agent lập trình gửi lại ngữ cảnh của nó mỗi lượt, nên tỷ lệ truy cập cache quyết định phần lớn hóa đơn. Và một agent đã đọc một repository lớn có thể vượt qua 272K token đầu vào, nơi mức giá của Astra thay đổi.
Các benchmark lập trình nói gì, và không nói gì
Thông báo về Fable 5.2 của Anthropic báo cáo 69,9% trên FrontierSWE v2 và 49,1% trên FrontierCode 2.0 ở mức effort Xhigh. Trong cùng bảng đó, cột so sánh OpenAI được ghi là GPT-6 Astra, thế hệ trước, với 65,5% và 42,8%.
Bảng đó không bao gồm GPT-6.2 Astra. Trang mô hình của OpenAI cũng không liệt kê điểm lập trình kiểu SWE nào cho nó. Bài viết về buổi ra mắt của Simon Willison lưu ý rằng "Astra 6.2 không đạt điểm cao bằng Fable 5.2 trên nhiều benchmark khác nhau", và một số người dùng thấy phong cách giao tiếp của nó "có thể gây khó hiểu".
Vậy cách đọc trung thực gồm ba phần:
- Fable 5.2 có điểm lập trình tác tử do nhà cung cấp tự chạy và công bố, cao hơn Astra đời trước.
- Chưa nhà cung cấp nào công bố so sánh lập trình trực tiếp với GPT-6.2 Astra.
- Mọi con số trên đều do chính nhà cung cấp của mô hình chạy, trên harness của riêng họ, ở các mức effort tự chọn.
Hãy coi benchmark như một bộ lọc danh sách rút gọn. Bài viết này không bao gồm kết quả kiểm thử độc lập nào của cả hai mô hình.
Nơi hóa đơn chênh lệch
Giá niêm yết bằng nhau không có nghĩa là hóa đơn bằng nhau. Ba cơ chế tách chúng ra.
Truy cập cache
Fable 5.2 tính $0.20 mỗi triệu token khi truy cập cache. Astra tính $0.40. Với một agent gửi lại tiền tố đã cache 100.000 token 50 lần trong một phiên, tiền tố đó tốn $1.00 trên Fable và $2.00 trên Astra, trước khi tính đầu vào và đầu ra mới. Simon Willison vẫn gọi giá cache của Astra là "tin tuyệt vời cho các phiên tác tử chạy lâu hơn"; nó thấp hơn nhiều so với mức $8 không cache.
Ngữ cảnh dài
Giá của Astra tăng bậc một khi yêu cầu vượt quá 272K token đầu vào. Anthropic niêm yết toàn bộ ngữ cảnh 1M ở mức giá tiêu chuẩn cho Fable. Nếu các agent của bạn thường xuyên tải nửa monorepo, hãy mô phỏng ngưỡng đó trước khi cam kết.
Mức effort và số token mỗi tác vụ
Cả hai mô hình đều có các mức effort, và effort cao hơn đốt nhiều token hơn. Bài test SVG không chính thức của Simon cho thấy mức chênh lệch trên một prompt: GPT-6.2 Astra tốn 11,55 cent ở effort High và 88,71 cent ở Max. Đó chỉ là một prompt đồ chơi, không phải benchmark lập trình, nhưng khoảng cách 7 lần cho thấy tại sao bạn nên cố định mức effort trước khi so sánh chi phí.
Bài phân tích giá Fable 5.2 của chúng tôi đi sâu vào các lần thử lại và thời gian review; hướng dẫn về rate limit GPT-6.2 đề cập đến giới hạn token mỗi phút mà các agent Astra chạm trước tiên.
Cách chạy thử nghiệm GPT-6.2 Astra vs Fable 5.2 trên repo của chính bạn
Một cuộc đối đầu trên mã của chính bạn đánh bại mọi bảng công bố. Phương pháp dưới đây theo hướng dẫn đánh giá Fable 5.2 trên codebase của bạn dài hơn của chúng tôi; ở đây nó được triển khai như một cuộc đấu giữa hai mô hình.
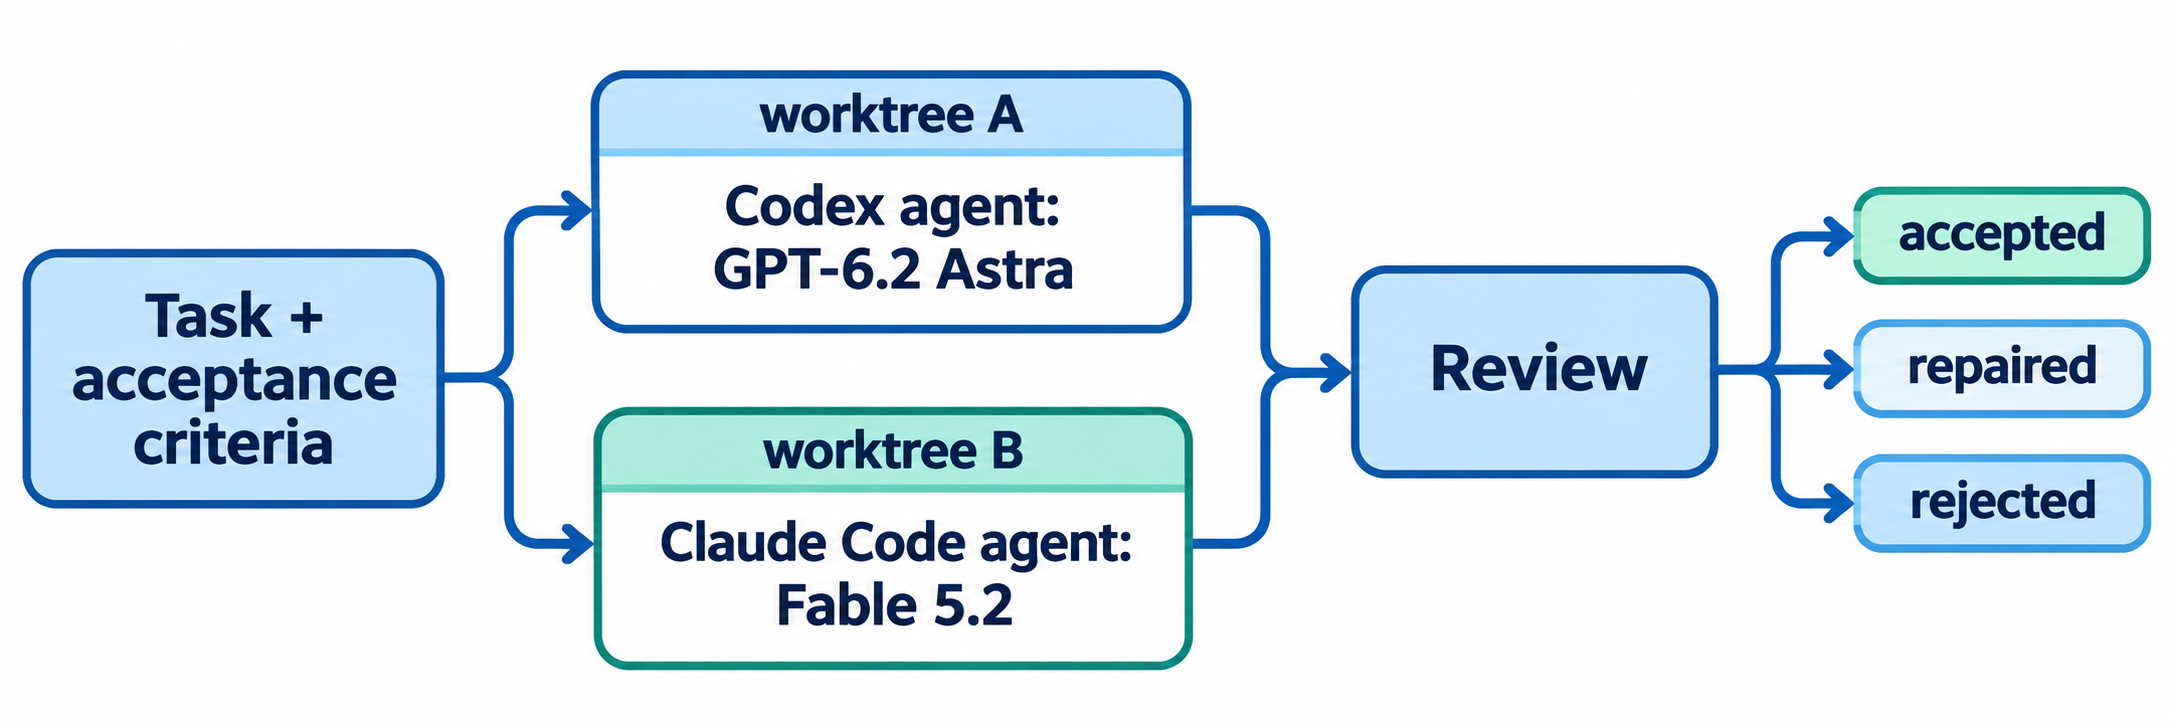
- Chọn 10 đến 12 tác vụ gần đây từ backlog của bạn: sửa bug, bổ sung nhỏ, một lần refactor và một lần điều tra.
- Viết tiêu chí chấp nhận trước, trước khi bất kỳ agent nào chạy, để không kết quả nào định hình tiêu chuẩn.
- Cố định harness. Astra chạy tốt nhất trong Codex và Fable trong Claude Code, nên bạn đang so sánh hai quy trình làm việc trọn vẹn. Hãy nêu rõ điều đó trong báo cáo của bạn.
- Cố định mức effort. Chọn High cho cả hai, hoặc ghi rõ các cài đặt chính xác bạn đã dùng.
- Cô lập mọi lần thử trong một worktree git mới, để không agent nào kế thừa các chỉnh sửa của agent kia.
- Chạy mỗi tác vụ trên cả hai mô hình, luân phiên xem bên nào chạy trước.
- Review mù khi có thể, và chấm mỗi kết quả là được chấp nhận, được chấp nhận sau khi sửa, hoặc bị từ chối.
- Chia tổng chi phí cho số thay đổi được chấp nhận, bao gồm cả các lần thử thất bại.
Chi phí trên mỗi thay đổi được chấp nhận là con số quyết định. Một mô hình rẻ hơn 20% mỗi token nhưng cần thêm một chu kỳ sửa chữa mỗi tác vụ lại là mô hình đắt hơn đối với đội ngũ của bạn.
Chạy cả hai mô hình dưới dạng Agent trong Sharkly
Sharkly vận hành các agent lập trình mà bạn đã dùng; nó không thay thế chúng. Một Agent trong Sharkly là một đồng đội AI được cấu hình sẵn, thực thi các Task thông qua một Runtime, chẳng hạn Codex hoặc Claude Code, trên một Computer mà bạn kết nối.
Thiết lập cuộc đấu với hai Agent:
- Astra Agent: một Codex Runtime được cấu hình cho
gpt-6.2-astra. - Fable Agent: một Claude Code Runtime được cấu hình cho
claude-fable-5-2.
Mỗi Agent có một mô hình mặc định, được chọn trong mục Computer, Runtime và Working directory từ các mô hình mà Runtime của nó báo cáo. Hãy xem trung tâm trợ giúp Sharkly để biết cài đặt Agent hiện tại.
Đặt giới hạn chạy giống nhau cho cả hai Agent, để không bên nào có nhiều lượt chạy song song hơn hay thời gian ngân sách dài hơn bên kia.

Dùng chế độ thư mục làm việc tạm thời, để mỗi Task có một thư mục riêng và các lượt chạy dựa trên repository có thể chuẩn bị một worktree mới. Đặt tiêu chí chấp nhận trong phần mô tả Task. Mỗi Agent báo cáo bản patch và các bước kiểm tra về Task của chính nó, điều này giữ mọi lần thử nằm sát bên phán quyết của người review.
Việc sử dụng mô hình nằm trên các gói đăng ký và khóa API của chính bạn. Sharkly không bán token, và hạn mức mô hình phụ thuộc vào các công cụ, gói dịch vụ và tài khoản API mà đội ngũ của bạn kết nối.
Các lựa chọn thay thế cho việc chọn thẳng Astra hay Fable
Bạn không nhất thiết phải tôn một mô hình lên ngôi.
- Phân chia theo loại tác vụ. Dùng Fable 5.2 cho các hạng mục mà nó thắng trong bài test của bạn, còn Astra cho phần còn lại.
- Một mô hình dẫn dắt, mô hình kia làm phần việc. Một mô hình tiên phong lập kế hoạch và review; một mô hình rẻ hơn làm các phần thường nhật, đúng mô thức trong GPT-6 Astra làm đội trưởng Crew của bạn.
- Hạ một bậc. GPT-6.2 Sol niêm yết ở mức $2 đầu vào và $10 đầu ra mỗi triệu token. Với công việc bảo trì thường nhật, nó có thể đáp ứng tiêu chuẩn của bạn với một phần tư giá.
- Giữ cả hai cùng hoạt động. Tính trung lập với nhà cung cấp chính là điểm mấu chốt: không mô hình nào giữ được vị trí tốt nhất lâu dài, như Argon, Astra và Opus đã lập luận.
Các trường hợp sử dụng thực tế
- Các cuộc migration dài. Anthropic báo cáo một nhóm các agent Fable 5.2 đã chuyển một dịch vụ production từ Python sang Rust. Hãy kiểm thử loại công việc đó với một phần nhỏ của chính bạn trước khi giao cho bất kỳ mô hình nào.
- Điều tra trên repo lớn. Vượt qua 272K token đầu vào và giá của Astra sẽ thay đổi. Hãy chạy mô hình chi phí ở kích thước ngữ cảnh thực tế của bạn.
- Hàng đợi bug song song. Mười bản sửa nhỏ chia cho cả hai Agent sẽ cho bạn tỷ lệ thay đổi được chấp nhận của mỗi mô hình trong vòng một tuần.
Kết luận
GPT-6.2 Astra và Fable 5.2 có cùng chi phí mỗi token trên giấy tờ. Fable có điểm lập trình được công bố mạnh hơn và truy cập cache rẻ hơn; Astra có cửa sổ ngữ cảnh lớn hơn một chút nhưng giá cao hơn khi vượt quá 272K đầu vào. Cả hai sự thật đó đều không cho bạn biết mô hình nào ship được nhiều mã được chấp nhận hơn trong repository của bạn.
Hãy chạy cuộc đấu. Kết nối một Computer với Sharkly, tạo một Codex Agent trên GPT-6.2 Astra và một Claude Code Agent trên Fable 5.2, rồi giao cho cả hai cùng năm tác vụ trong tuần này. Giữ lại mô hình thắng về chi phí trên mỗi thay đổi được chấp nhận.
Câu hỏi thường gặp
GPT-6.2 Astra có rẻ hơn Claude Fable 5.2 không?
Không. Cả hai đều niêm yết ở mức $8 mỗi triệu token đầu vào và $40 mỗi triệu token đầu ra. Truy cập cache của Fable rẻ hơn ($0.20 so với $0.40), và giá của Astra tăng khi vượt quá 272K token đầu vào.
Mô hình nào tốt hơn cho lập trình, GPT-6.2 Astra hay Fable 5.2?
Anthropic báo cáo điểm lập trình tác tử cao hơn cho Fable 5.2 so với GPT-6 Astra đời trước. Không có benchmark công bố nào so sánh trực tiếp Fable 5.2 với GPT-6.2 Astra, nên hãy kiểm thử cả hai trên tác vụ của chính bạn.
Cửa sổ ngữ cảnh của GPT-6.2 Astra và Fable 5.2 là bao nhiêu?
GPT-6.2 Astra niêm yết 1.050.000 token với giới hạn đầu vào 922.000 token. Fable 5.2 có ngữ cảnh 1M token ở mức giá tiêu chuẩn. Cả hai đều giới hạn đầu ra ở 128.000 token.
Tôi có thể dùng GPT-6.2 Astra trong Claude Code hoặc Fable 5.2 trong Codex không?
Mỗi mô hình thường được chạy trong agent lập trình của nhà cung cấp riêng: Astra trong Codex, Fable trong Claude Code. So sánh chúng thường có nghĩa là so sánh hai quy trình làm việc trọn vẹn, mô hình cộng với harness.
Làm sao để so sánh hai mô hình lập trình một cách công bằng?
Dùng cùng các tác vụ, tiêu chí chấp nhận được viết sẵn, mức effort cố định và các worktree được cô lập. Chấm điểm các kết quả được chấp nhận, được sửa lại và bị từ chối, rồi chia tổng chi phí cho số thay đổi được chấp nhận.
Sharkly có chọn mô hình cho Agent của tôi không?
Không. Bạn chọn mô hình mặc định cho mỗi Agent từ các mô hình mà Runtime của nó báo cáo. Sharkly không tự động định tuyến tác vụ giữa các mô hình.


