
Chi phí mỗi tác vụ của Gemini 4 Neon phụ thuộc vào nhiều thứ hơn mức giá 3 USD / 15 USD mỗi triệu token. Google cho biết ở mức suy luận high mặc định, Neon rẻ hơn 32% mỗi tác vụ so với Gemini 4 Carbon. Tính theo token, Neon đắt hơn 50% so với mức giá giới thiệu của Carbon và rẻ hơn 25% so với mức giá của Carbon từ ngày 1 tháng 12 năm 2026. Mô hình nào rẻ hơn cho các agent của bạn sẽ phụ thuộc vào số token mỗi tác vụ và số lần thử mà nhóm của bạn chấp nhận.
TL;DR
- Giá niêm yết của Neon: 3 USD cho 1 triệu token đầu vào, 15 USD cho 1 triệu token đầu ra (bao gồm cả thinking), 0,15 USD cho 1 triệu token đầu vào từ bộ nhớ đệm. Chỉ có gói trả phí.
- Giá niêm yết của Carbon: 2 USD / 10 USD đến hết ngày 30 tháng 11 năm 2026, sau đó là 4 USD / 20 USD từ ngày 1 tháng 12.
- Khẳng định của Google: rẻ hơn 32% mỗi tác vụ so với Carbon ở mức
high, dựa trên biểu đồ từ Artificial Analysis Intelligence Index. Bài viết không nói rõ biểu đồ dùng mức giá Carbon nào. - Điều đó có nghĩa là: Neon chỉ thắng mức giá giới thiệu của Carbon nếu hoàn thành cùng một tác vụ với ít hơn hai phần ba số token của Carbon. Sau ngày 1 tháng 12, Neon thắng trừ khi nó tiêu tốn nhiều hơn một phần ba số token so với Carbon.
- Cần đo lường: chi phí mỗi thay đổi được chấp nhận, chứ không phải chi phí mỗi lần thử.
Giá của Gemini 4 Neon so với Carbon và Hydrogen
Gemini 4 Neon là mô hình tầm trung trong dòng Gemini 4 của Google, ra mắt ngày 18 tháng 11 năm 2026 với tên gemini-4-neon. Model card mô tả nó được phát triển từ Carbon và xây dựng để cân bằng giữa "độ sâu và hiệu suất". Dưới đây là mức giá tiêu chuẩn của gói trả phí cho mỗi 1 triệu token từ trang định giá Gemini API:
| Mô hình | Đầu vào | Đầu ra (bao gồm thinking) | Đầu vào từ bộ nhớ đệm | Đầu vào / đầu ra theo lô | Gói miễn phí |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Không |
| Gemini 4 Carbon, đến hết ngày 30/11 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Không |
| Gemini 4 Carbon, từ ngày 1/12 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Không |
| Gemini 4 Hydrogen (gói trả phí) | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Có |
Cả ba mô hình đều chỉ dùng implicit caching. Hướng dẫn trên AI Studio của Neon cho biết implicit caching có hiệu lực với các prompt từ 4.096 token trở lên và giảm 95% chi phí cho đầu vào được lưu đệm. Neon không có explicit caching, vì vậy hãy xóa mọi trường cached_content khi chuyển một thiết lập từ Carbon sang.
Google tính phí "mọi token mà mô hình xử lý, bao gồm cả token thinking, hướng dẫn hệ thống của grounding nội bộ và khai báo hàm". Với một agent sử dụng nhiều công cụ, các khai báo đó đi kèm ở mỗi lượt.
Google đo chi phí mỗi tác vụ của Neon như thế nào
Chi phí mỗi tác vụ là tổng số tiền mà một mô hình phải tiêu để hoàn thành một tác vụ benchmark: số token đã dùng nhân với đơn giá. Bài viết ra mắt của Google cho biết ở mức high, Neon "đạt điểm cao trên Artificial Analysis Intelligence Index kèm chi phí mỗi tác vụ thấp hơn 32% so với Carbon". Biểu đồ được ghi nhãn "AA Index v5.01 cost per task".
Artificial Analysis là bên thứ ba, không phải Google. Bài viết còn đưa ra hai khẳng định về chi phí nữa, và không khẳng định nào liên quan đến Carbon:
- Neon chạy với "chi phí mỗi tác vụ thấp hơn khoảng 50% đến 80% so với các mô hình frontier đối đầu hàng đầu", không nêu tên đối thủ.
- Ở mức
xhigh, Neon vẫn rẻ hơn "36%+ mỗi tác vụ so với các mô hình đối đầu ở thiết lập cao nhất của chúng".
Bài viết không công bố số token hay mức giá Carbon đằng sau con số 32%. Khoảng trống này quan trọng hơn thường lệ, vì giá của Carbon sẽ tăng gấp đôi chưa đầy hai tuần sau khi Neon ra mắt.
Gemini 4 Neon có rẻ hơn Carbon không? Tùy vào thời điểm
Tính theo token, Neon nằm giữa hai mức giá của Carbon: gấp 1,5 lần mức giá giới thiệu và bằng 0,75 lần mức giá tháng 12. Vậy nên con số 32% chỉ có thể đến từ việc Neon dùng ít token hơn mỗi tác vụ. Kiểm chứng khẳng định này theo cả hai hướng:
| Nếu biểu đồ của Google định giá Carbon theo | Số token của Neon so với Carbon | Neon so với Carbon đến hết ngày 30/11 | Neon so với Carbon từ ngày 1/12 |
|---|---|---|---|
| $2 / $10 (giới thiệu) | khoảng 45% | rẻ hơn 32% | rẻ hơn khoảng 66% |
| $4 / $20 (tháng 12) | khoảng 91% | đắt hơn khoảng 36% | rẻ hơn 32% |
Cả hai dòng đều giả định hai mô hình phân bổ token đầu vào và đầu ra theo cùng một tỷ lệ — một sự đơn giản hóa. Dù theo hướng nào, từ ngày 1 tháng 12 Neon cũng rẻ hơn mỗi tác vụ theo chính số liệu của Google. Trước ngày 30 tháng 11, câu trả lời phụ thuộc vào chi tiết mà Google không công bố.
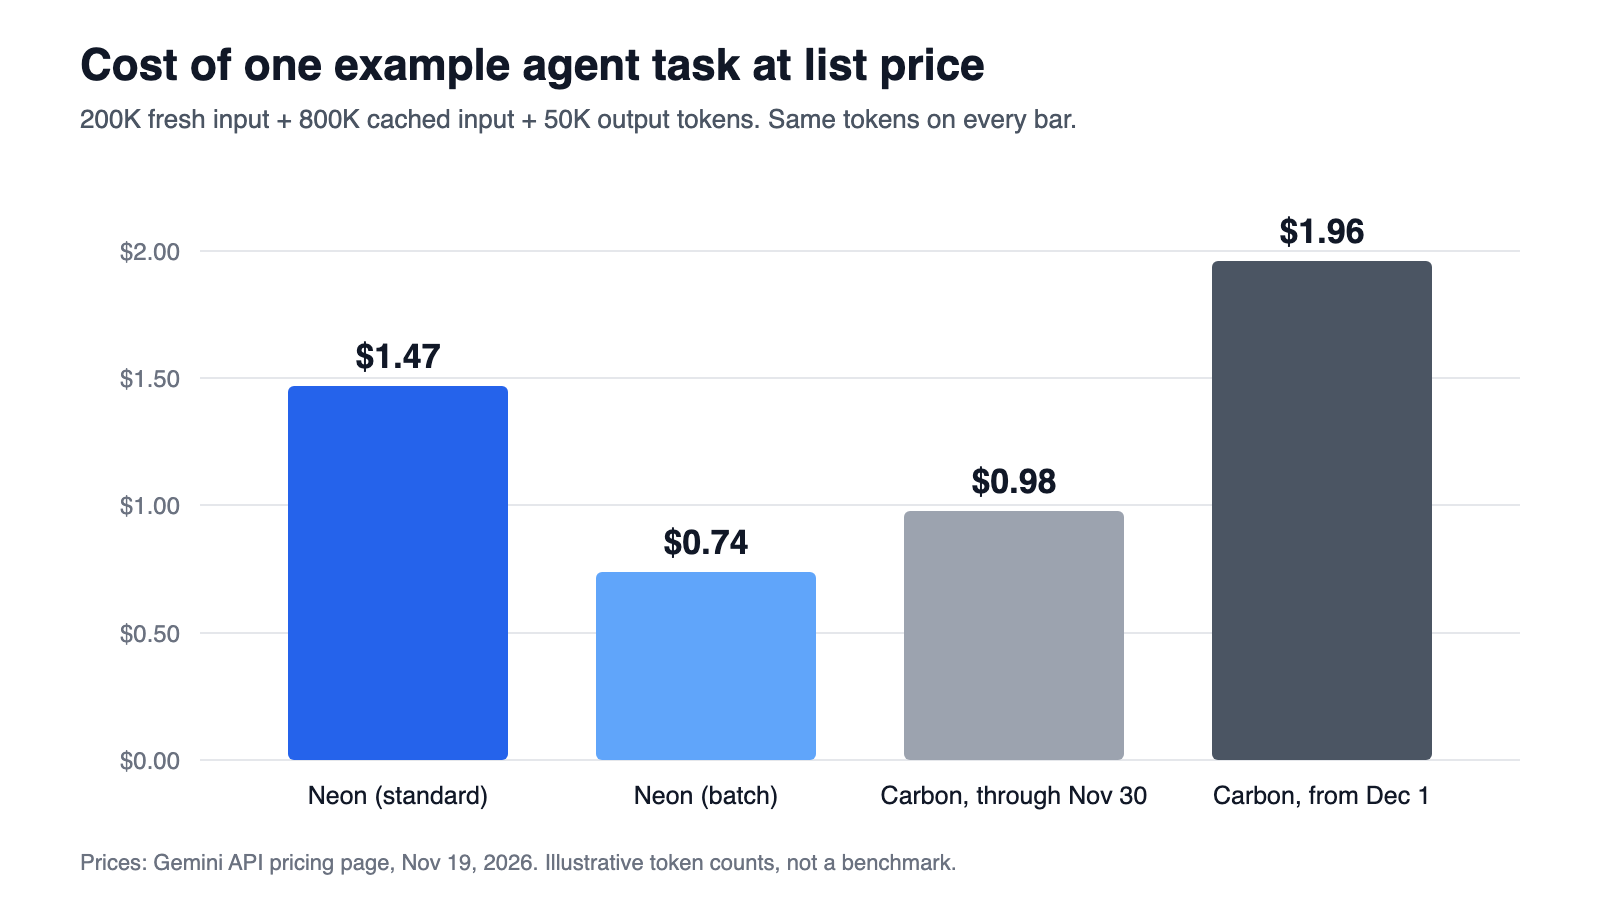
Một tác vụ agent tốn bao nhiêu theo giá niêm yết
Dưới đây là ví dụ tính toán với các con số tròn, không phải kết quả benchmark. Hãy hình dung một phiên làm việc của agent lập trình gửi 200K token đầu vào mới, nhận 800K token trúng bộ nhớ đệm khi đọc lại repository, và tạo ra 50K token đầu ra bao gồm cả thinking.
| Mô hình | Đầu vào mới | Đầu vào từ bộ nhớ đệm | Đầu ra | Tổng |
|---|---|---|---|---|
| Neon (tiêu chuẩn) | $0.60 | $0.12 | $0.75 | $1.47 |
| Neon (batch) | $0.30 | $0.06 | $0.375 | $0.74 |
| Carbon, đến hết ngày 30/11 | $0.40 | $0.08 | $0.50 | $0.98 |
| Carbon, từ ngày 1/12 | $0.80 | $0.16 | $1.00 | $1.96 |
Với cùng số token, Neon thua mức giá giới thiệu của Carbon và thắng mức giá tháng 12. Quy tắc hòa vốn rất đơn giản. So với mức giá giới thiệu, Neon phải hoàn thành với dưới 67% số token của Carbon. So với mức giá tháng 12, Neon vẫn rẻ hơn trừ khi cần hơn 133% số token của Carbon.
Trong ví dụ này, phần đầu ra chiếm một nửa hóa đơn của Neon, và token thinking được tính như đầu ra. Đó là lý do mức thinking bạn chọn ảnh hưởng đến chi phí nhiều hơn cả giá niêm yết.
Mức thinking: núm vặn chi phối chi phí mỗi tác vụ của Neon
Neon hỗ trợ bốn mức thinking: low, medium, high (mặc định) và xhigh. Hướng dẫn của Google nói thẳng về sự đánh đổi: xhigh "làm tăng độ trễ và lượng token dùng", và bạn nên "chọn mức thinking_level thấp nhất đáp ứng chuẩn chất lượng của bạn".
Một cách định tuyến thực tế cho công việc agent như sau:
low: các câu hỏi về codebase, tóm tắt diff, ghi chú phân loại.medium: các bản sửa có phạm vi hẹp, nơi bộ kiểm thử là trọng tài thực sự.high: refactor, debug và các phiên gọi công cụ dài. Đây là mức áp dụng cho khẳng định 32% của Google.xhigh: chỉ dành cho các tác vụ đã không qua được review ở mứchigh.
Đặt mức thinking theo từng yêu cầu trong code:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon từ chối mức minimal cũ với thông báo lỗi và bỏ qua temperature, top_p và top_k. Google cũng khuyến nghị đặt timeout phía client ít nhất 15 phút cho các prompt khó, điều mà các agent chạy dài thường gặp trước tiên.
Vì sao chi phí mỗi tác vụ vẫn không phải con số của bạn
Một tác vụ benchmark kết thúc khi hệ thống chấm điểm xong. Còn tác vụ của bạn kết thúc khi có người merge thay đổi đó. Số lần thử lại, diff bị từ chối và thời gian review nằm giữa hai điểm đó, và không biểu đồ chi phí nào hiển thị chúng.
Con số tương ứng với ngân sách của bạn là chi phí mỗi thay đổi được chấp nhận: tổng chi phí mô hình cho một tác vụ, tính trên mọi lần thử, chia cho số thay đổi bạn đã ship. Chúng tôi đã trình bày đầy đủ lập luận này trong bài khi mô hình rẻ hơn lại tốn kém hơn. Tóm tắt ngắn:
chi phí mỗi thay đổi được chấp nhận = chi phí mỗi lần thử / tỷ lệ chấp nhận
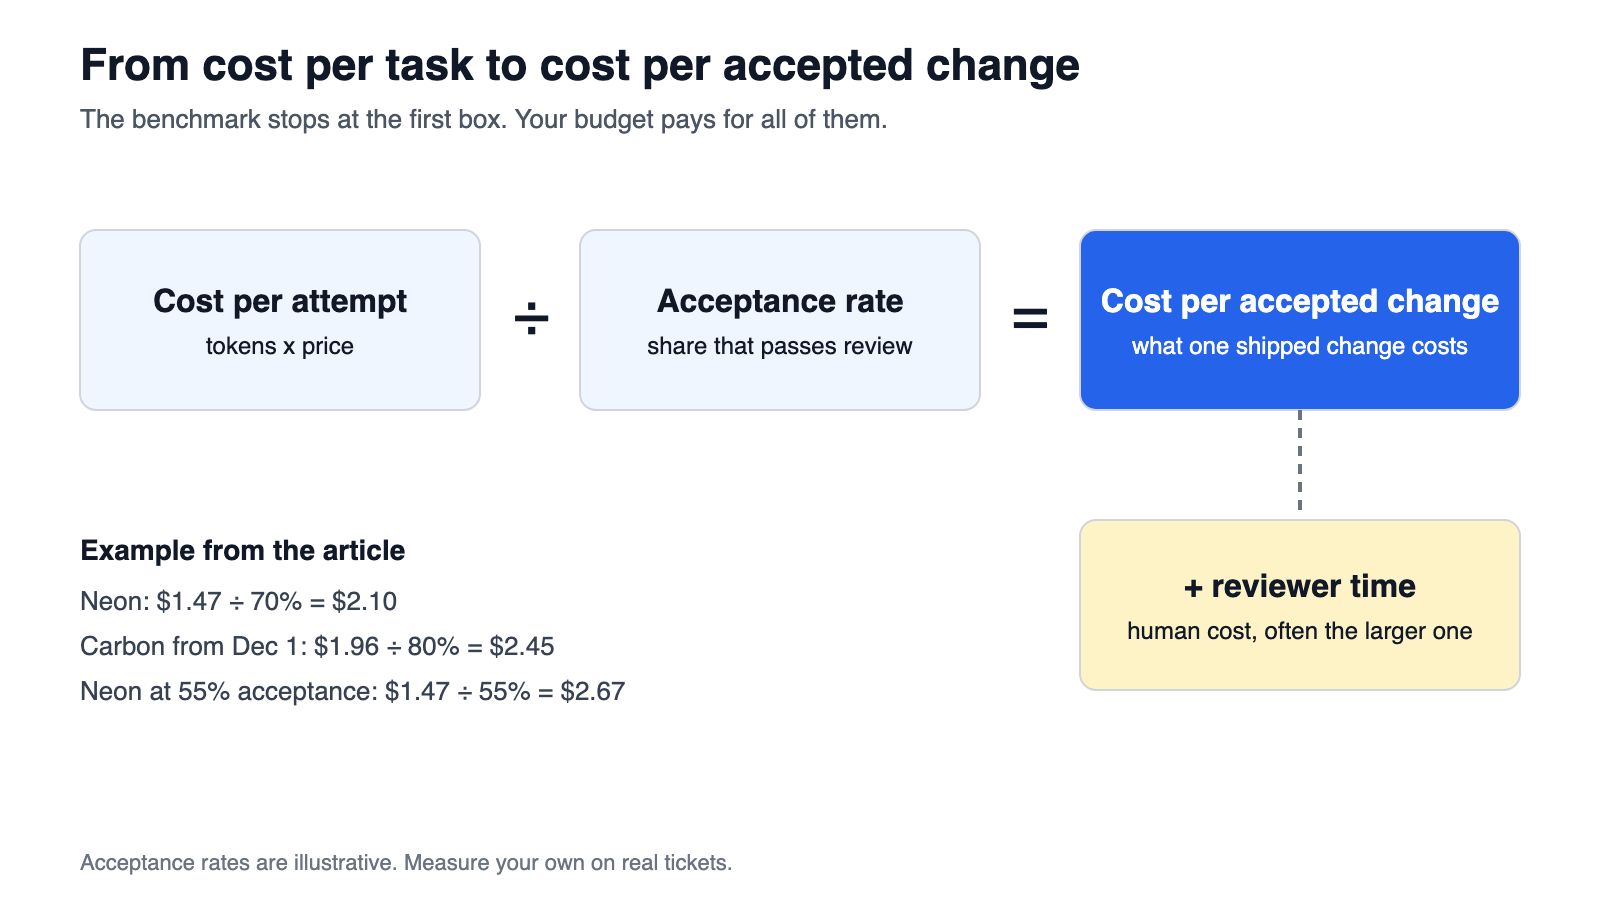
Chạy lại ví dụ ở trên. Nếu Neon qua review ở 70% lần thử đầu tiên, 1,47 USD mỗi lần thử thành 2,10 USD mỗi thay đổi được chấp nhận. Nếu Carbon ở mức giá tháng 12 đạt 80%, 1,96 USD thành 2,45 USD. Neon vẫn thắng. Nhưng nếu tỷ lệ chấp nhận của Neon giảm xuống 55%, chi phí là 2,67 USD mỗi thay đổi được chấp nhận, và Carbon thắng. Tỷ lệ chấp nhận của bạn, chứ không phải biểu đồ của Google, mới quyết định lựa chọn.
Thời gian của người review nằm ngoài công thức đó và thường tốn kém hơn cả token. Review của con người là điểm nghẽn đối với các agent chạy song song, nên càng ít diff bị từ chối thì bạn càng tiết kiệm phần tốn kém nhất.
Cách thử nghiệm Neon so với Carbon trên chính tác vụ của bạn
Bạn không cần benchmark mới. Bạn cần hai tuần ticket thực tế và một cách để biết mô hình nào làm gì. Sharkly cung cấp cho bạn bảng đó: mỗi tác vụ chứa lần chạy của agent, kết quả và trạng thái review cùng một nơi.
- Chọn 20 đến 30 tác vụ bình thường từ backlog của bạn: sửa lỗi, refactor nhỏ, bổ sung kiểm thử.
- Tạo hai Agent. Một Sharkly Agent theo mô hình mặc định của Runtime và không có bộ chọn mô hình, theo tài liệu Agents. Vì vậy hãy trỏ mỗi Agent vào một Runtime được cấu hình với mô hình khác nhau: một chạy
gemini-4-neon, một chạygemini-4-carbon. - Chia các tác vụ giữa hai Agent với độ khó tương đương ở mỗi phía.
- Ghi lại ba con số cho mỗi tác vụ: số token từ phần sử dụng Gemini API của bạn, số lần thử đến khi được chấp nhận, và số phút review.
- Tính chi phí mỗi thay đổi được chấp nhận cho từng mô hình, theo cả hai mức giá Carbon nếu quá trình thử nghiệm của bạn trải qua ngày 1 tháng 12.
Sharkly không bán token mô hình. Các lần chạy của bạn được tính phí qua khóa Gemini API đã cấu hình sẵn trên Runtime, nên phép so sánh vẫn khách quan: không có gì trong nền tảng làm lệch giá về phía một mô hình. Để có cái nhìn tổng quan hơn, xem vì sao một nền tảng agent không nên bán token cho bạn và theo dõi chi tiêu trên Claude Code, Codex và Gemini.
Neon, Carbon và Hydrogen phù hợp ở đâu
Model card của Google định vị Carbon cho "những dự án khó nhất, thời gian dài nhất" và Hydrogen cho "thực thi hàng ngày nhanh chóng", với Neon nằm giữa. Xét về chi phí, điều đó cho đội agent ba làn đường:
- Hydrogen ở mức 1,50 USD / 7,50 USD cho công việc khối lượng lớn, rủi ro thấp. Xem Gemini 4 Hydrogen cho coding agent.
- Neon ở mức
highlàm làn mặc định cho các ticket phức tạp, và làm vai trò dẫn dắt các subagent Hydrogen chạy song song. - Carbon cho các công việc dài hạn mà Neon thất bại ở mức
xhigh. Đánh giá về Carbon của chúng tôi cho thấy nó xứng đáng với mức giá ở đâu.
Hướng dẫn kết hợp Carbon và Hydrogen trình bày mô hình planner và workers; từ ngày 1 tháng 12, Neon đảm nhận vị trí planner với chi phí thấp hơn. Để định tuyến giữa các nhà cung cấp, xem định tuyến mô hình cho các đội agent.
Kết luận
Từ ngày 1 tháng 12, Gemini 4 Neon rẻ hơn Carbon mỗi tác vụ theo bất kỳ cách đọc nào về số liệu của Google. Trước ngày đó, câu trả lời phụ thuộc vào mức giá Carbon nào nằm đằng sau biểu đồ 32%, và Google không nói. Dù sao, giá niêm yết chưa bao giờ là con số quyết định: số token mỗi tác vụ, mức thinking và tỷ lệ chấp nhận mới là.
Hãy chạy thử nghiệm hai tuần trên chính backlog của bạn và định giá cả hai mô hình theo chi phí mỗi thay đổi được chấp nhận. Nếu bạn đã chạy nhiều coding agent, Sharkly mang đến cho bạn một bảng duy nhất để giao việc, so sánh kết quả của các Agent và giữ review trong một hàng đợi. Tài liệu Sharkly hướng dẫn từng bước kết nối một Computer và tạo các Agent.
Câu hỏi thường gặp
Gemini 4 Neon giá bao nhiêu?
3 USD cho 1 triệu token đầu vào, 15 USD cho 1 triệu token đầu ra bao gồm thinking, và 0,15 USD cho 1 triệu token đầu vào từ bộ nhớ đệm trên gói trả phí của Gemini API. Batch và Flex giảm một nửa còn 1,50 USD / 7,50 USD. Không có gói API miễn phí.
Gemini 4 Neon có rẻ hơn Gemini 4 Carbon không?
Tính theo token, không cho đến ngày 30 tháng 11 (3 USD / 15 USD so với 2 USD / 10 USD), và có từ ngày 1 tháng 12 (3 USD / 15 USD so với 4 USD / 20 USD). Tính theo tác vụ, Google báo cáo Neon ở mức high rẻ hơn Carbon 32%, nhưng không công bố đã dùng mức giá Carbon nào.
Gemini 4 Neon có gói miễn phí không?
Không. Trang định giá ghi "Not available" cho gói miễn phí của Neon ở mọi cấp dịch vụ. Gemini 4 Hydrogen thì có.
Token thinking có bị tính phí với Gemini 4 Neon không?
Có. Google tính phí token thinking theo giá đầu ra 15 USD mỗi 1 triệu, cùng với khai báo hàm và hướng dẫn hệ thống của grounding. Giảm thinking_level là cách chính để cắt giảm token.
Mức thinking nào rẻ nhất cho coding agent?
low dùng ít token nhất và xhigh dùng nhiều nhất. Google khuyến nghị thử cả bốn mức trên bộ dữ liệu đánh giá của bạn và chọn mức thấp nhất đáp ứng chuẩn chất lượng. Bắt đầu ở mức high cho các thay đổi code phức tạp.
Giá của Gemini 4 Carbon tăng khi nào?
Vào ngày 1 tháng 12 năm 2026. Giá đầu vào tăng từ 2 USD lên 4 USD mỗi 1 triệu token và đầu ra từ 10 USD lên 20 USD, theo trang định giá Gemini API.


