
TL;DR: Để AI agent của bạn có thể "nói chuyện", hãy đặt GPT-Live-1.1 của OpenAI làm front end giọng nói phía trước nó và giữ phần công việc thực sự cho các agent bạn đang vận hành. GPT-Live vừa nghe vừa nói và giao phần suy luận cùng các lệnh gọi công cụ cho một backend thông qua cơ chế delegation. Ở chế độ client delegation, ứng dụng của bạn sẽ bắt từng lượt bàn giao, khởi chạy một Sharkly Automation qua webhook của nó, rồi đọc kết quả thành lời.
GPT-Live-1.1 là gì?
GPT-Live-1.1 là mô hình giọng nói full-duplex của OpenAI dành cho hội thoại đa ngôn ngữ: nó có thể vừa nghe vừa nói, nên người dùng có thể ngắt lời nó như ngắt lời một đồng nghiệp. Mô hình chạy trên endpoint v1/live/sessions, hỗ trợ function calling và streaming, và có thể giao việc suy luận cùng việc dùng công cụ cho một agent backend thay vì tự làm.
Theo trang mô hình GPT-Live-1.1 của OpenAI, nó phiên âm giọng nói chính xác hơn GPT-Live-1 và giữ giọng đọc cùng accent nhất quán hơn trên nhiều ngôn ngữ. Đầu vào và đầu ra là âm thanh và văn bản. Nó không nhận hình ảnh trực tiếp.
Phần quan trọng nhất đối với các đội agent là delegation. Mô hình giọng nói được thiết kế để trò chuyện, không phải để chạy một đợt refactor kéo dài 20 phút. Nó sẽ giao công việc đó cho thứ khác và tiếp tục cuộc hội thoại trong lúc chờ.
Nếu nhóm của bạn đã phân công việc cho các coding agent trên một bảng chung, Sharkly có thể chính là "thứ khác" đó. Phần còn lại của bài hướng dẫn này sẽ chỉ bạn cách kết nối.
Vì sao một voice agent cần một đội backend
Giao diện giọng nói có giới hạn độ trễ rất khắt khe. Người dùng mong nhận được câu trả lời trong khoảng một giây, và sự im lặng lâu hơn thế cảm giác như hệ thống bị lỗi. Công việc agent thực sự không nằm vừa trong khung thời gian đó: đọc một repository, chạy test hay phân loại hàng đợi công việc đều mất vài phút.
Vì vậy, một voice agent cố tự làm mọi thứ sẽ thất bại theo một trong hai cách: hoặc trả lời nhanh nhưng nông cạn, hoặc im lặng trong lúc "suy nghĩ". Cả hai đều vô dụng khi bạn đang trên đường tới cuộc họp và muốn biết các agent run tối qua đã qua hay chưa.
Giải pháp là sự phân tách mà có thể bạn đã dùng cho văn bản: một front end nhanh đảm nhận hội thoại và một backend chậm hơn làm việc thực sự. GPT-Live xây sẵn sự phân tách đó vào API. Nếu bạn đã đọc bài của chúng tôi về handoffs agent-to-agent và agent-to-human, thì đây chính là mô hình đó gắn thêm micro.
Delegation của GPT-Live hoạt động thế nào
GPT-Live có hai chế độ delegation, được chọn khi bạn tạo session. Muốn đổi chế độ, bạn phải tạo session mới.
| Responses delegation | Client delegation | |
|---|---|---|
| Ai vận hành backend | OpenAI, thông qua Responses API | Ứng dụng của bạn |
| Cấu hình | delegation.type: "responses" cùng với model, instructions, tools |
delegation.type: "client" |
| Mô hình backend | Một mô hình bạn cấu hình, ví dụ gpt-6-luna |
Bất cứ thứ gì bạn gọi được |
| Kết quả quay về thế nào | Được xử lý sẵn cho bạn | session.commentary.append hoặc session.thinking.append |
| Phù hợp với | Các tra cứu và lệnh gọi công cụ mà OpenAI có thể chạy | Công việc nằm trong hệ thống của chính bạn |
Responses delegation là con đường ngắn. Bạn khai báo một mô hình backend, và OpenAI chạy nó với các công cụ bạn liệt kê. Hướng dẫn delegation khuyến nghị bắt đầu với gpt-6-luna và thử gpt-6-sol cho các tác vụ backend phức tạp hơn.
Client delegation là con đường dành cho các agent bạn đã vận hành. Khi mô hình giọng nói quyết định cần hỗ trợ, ứng dụng của bạn nhận một sự kiện session.delegation.created kèm delegation ID. Sự kiện này không mang theo lời của người dùng, nên ứng dụng phải dựng lại yêu cầu từ các sự kiện transcript và trạng thái riêng của nó. Khi công việc hoàn tất, bạn gửi kết quả trả về với cùng delegation ID và GPT-Live sẽ diễn đạt thành lời.
Mô hình: GPT-Live nói chuyện, đội agent của bạn làm việc
Đây là cấu trúc của một front end giọng nói đặt trên Sharkly. Sharkly nằm phía trên các coding agent của bạn (Claude Code, Codex, Gemini CLI và các công cụ khác) với vai trò là tầng nơi công việc được phân công, chạy trên các Computer đã kết nối và được review. Mô hình giọng nói không bao giờ đụng vào repository. Nó chỉ yêu cầu công việc, và bảng sẽ ghi nhận điều đó.
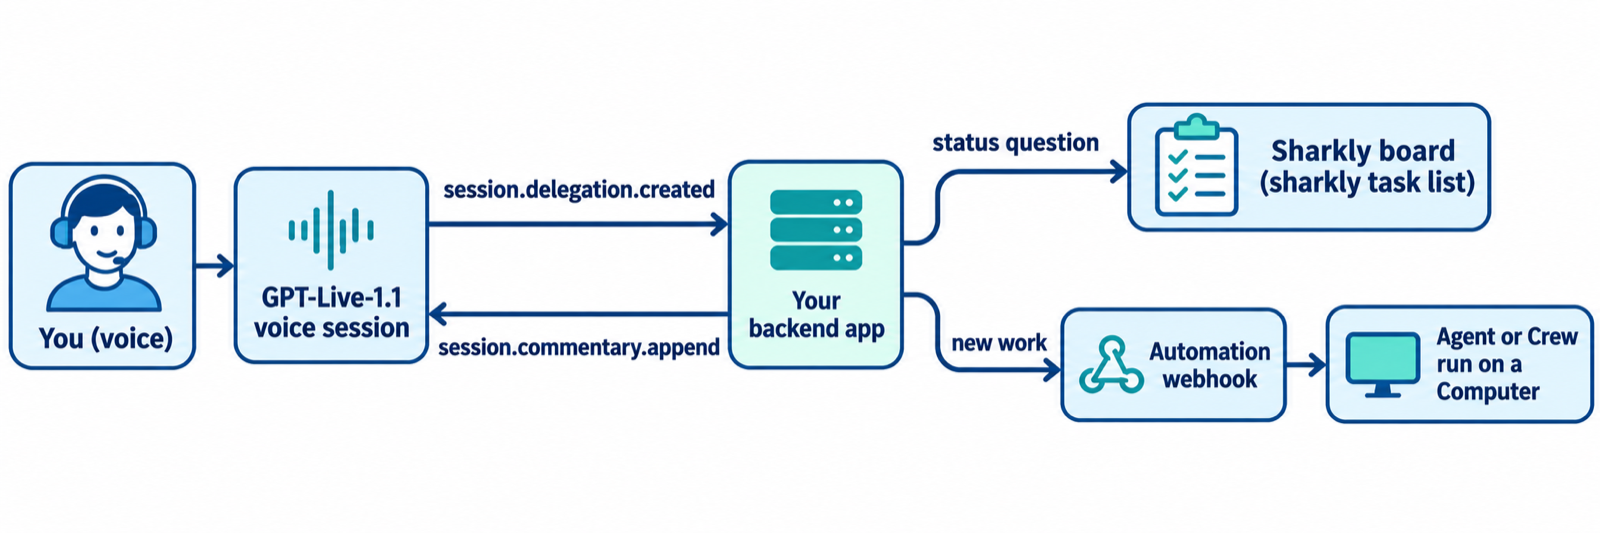
Ba loại yêu cầu sau chiếm phần lớn những gì người dùng hỏi một voice agent về đội agent của họ:
- Câu hỏi trạng thái ("Đợt test chạy đêm qua có qua không?"). Backend của bạn đọc bảng bằng CLI
sharklyvà trả lời trong vài giây. - Công việc mới ("Cho agent xem lại cái test login hay bị fail đó"). Backend của bạn gọi webhook của một Sharkly Automation, và một Agent hoặc Crew bắt đầu run.
- Quyết định ("Merge đi"). Backend của bạn từ chối và hướng dẫn người dùng nơi để review. Giọng nói không phải nơi thích hợp để phê duyệt thay đổi.
Quy tắc thứ ba là một lựa chọn thiết kế, không phải giới hạn của sản phẩm nào. Một lời "ok" qua giọng nói dễ bị nghe nhầm và khó kiểm toán. Hãy giữ việc phê duyệt ở nơi có bằng chứng — hướng dẫn của chúng tôi về human-in-the-loop coding agents đi sâu vào vấn đề này.
Cho AI agent của bạn có giọng nói: thiết lập từng bước
Bước 1: Tạo Automation và webhook trigger của nó
Trong Sharkly, một Automation là một định nghĩa thuộc Space cho công việc Agent hoặc Crew có thể lặp lại: hướng dẫn, người được giao, trigger và lịch sử run. Một webhook trigger tạo ra một URL bí mật chấp nhận yêu cầu POST từ dịch vụ bên ngoài. Tài liệu Automations lưu ý rằng URL đầy đủ chỉ được hiển thị một lần, khi trigger được tạo hoặc tạo lại, nên hãy lưu trữ nó như một secret ngay lập tức.
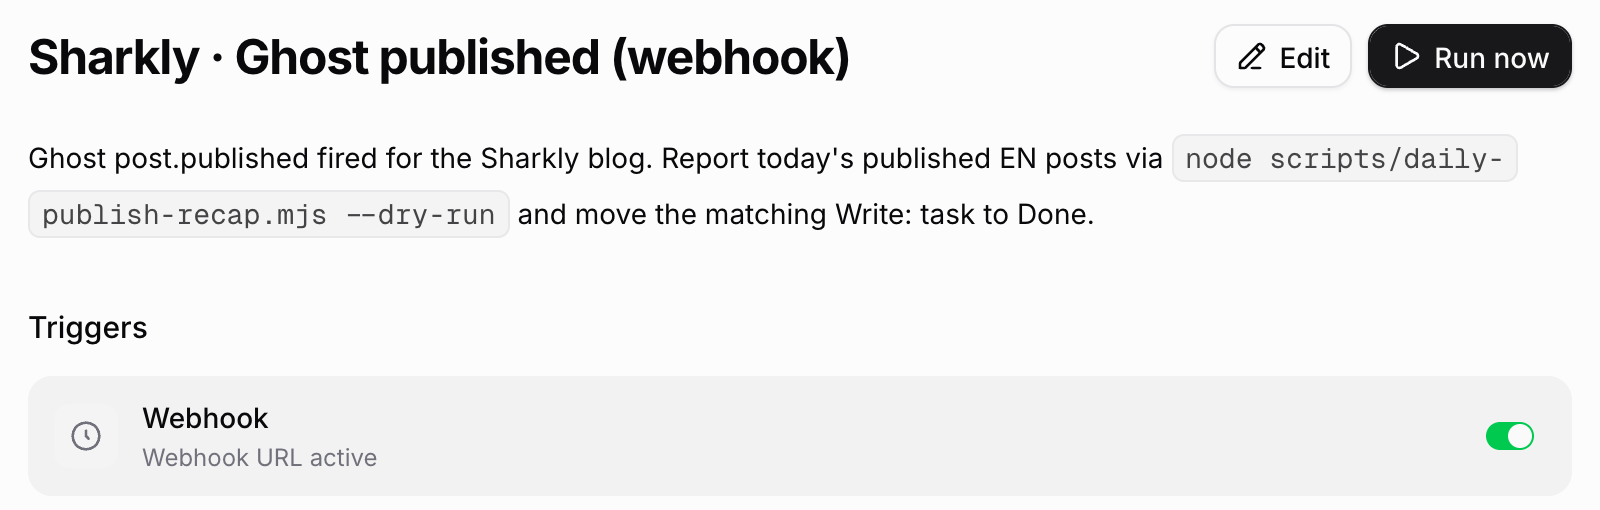
Hãy viết hướng dẫn để Agent đọc yêu cầu từ payload của trigger và ghi kết quả dưới dạng bình luận trên task. Nêu rõ những gì nó được phép thay đổi và khi nào cần người quyết định. Sau đó dùng Run now để thử nghiệm Agent cùng Computer của nó trước khi kết nối bất kỳ lưu lượng giọng nói nào. Bài hướng dẫn của chúng tôi về Automations trong Sharkly giới thiệu thêm các loại trigger khác.
Bước 2: Tạo một GPT-Live session ở chế độ client
Cấu hình session của bạn khai báo mô hình giọng nói và bật client delegation. Thiết lập acknowledgement_delay_ms cho ứng dụng của bạn thời gian để gửi thông điệp riêng trước khi GPT-Live nói một câu xác nhận chung chung.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI khuyến nghị WebRTC cho âm thanh trong ứng dụng trình duyệt, mobile và server, với WebSockets là phương án thay thế được hỗ trợ. Hướng dẫn bắt đầu với GPT-Live trình bày chi tiết phần thiết lập kết nối.
Bước 3: Định tuyến từng lượt delegation tới Sharkly
Khi session.delegation.created đến, hãy lưu delegation ID, dựng lại yêu cầu từ transcript, và quyết định nó đi theo hướng nào. Đoạn code Node minh họa này gửi công việc mới đến webhook của Automation và trả lời các câu hỏi trạng thái từ bảng.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Hãy để ý lời hứa trong câu trả lời bằng giọng nói. Nó nói rằng một run đã bắt đầu, chứ không nói công việc đã xong. Hướng dẫn của OpenAI nêu cùng điểm này với các đặt chỗ: chỉ gửi kết quả sau khi hành động đã thành công.
Bước 4: Đọc kết quả trên bảng, không bằng tai
Các agent run mất vài phút, và một phiên giọng nói có thể kết thúc trước khi công việc hoàn thành. Vì vậy bảng là bản ghi chính thức. Agent đăng kết quả lên task, lịch sử run hiển thị payload của trigger cùng kết quả đầu ra, và con người review tại đó. Lần tới khi bạn hỏi "cái test hay fail đó thế nào rồi?", luồng trạng thái sẽ đọc kết quả đó lại cho bạn nghe.
Chi phí và giới hạn cần tính trước
| Mục | GPT-Live-1.1 (tài liệu OpenAI, 2026-11-20) |
|---|---|
| Endpoint | v1/live/sessions |
| Session đang hoạt động | 0,05 USD mỗi phút |
| Chờ (standby) | 0,02 USD mỗi phút (các session WebRTC khi inference bị tạm dừng) |
| Thanh toán | Theo thời lượng; trang định giá của OpenAI cho biết GPT-Live tính theo giây |
| Session đồng thời | Giới hạn riêng khác với GPT-Live-1; xem trang giới hạn của tổ chức bạn |
| Lời gọi backend | Tính phí theo giá thông thường của mô hình được cấu hình |
Một buổi standup kiểm tra 10 phút tốn 0,50 USD chi phí giọng nói theo giá active, chưa tính các lời gọi backend. Để tham khảo, trang mô hình GPT-Live-1 liệt kê 50, 300 và 500 session đồng thời ở các gói Build, Launch và Grow, và không có quyền truy cập ở gói Free. GPT-Live-1.1 có giới hạn riêng.
Các agent run phía Sharkly được tính vào gói Claude Code, Codex, hoặc API đã gắn với từng Runtime. Sharkly không bán token. Nếu bạn định tuyến các câu hỏi trạng thái tới một mô hình backend giá rẻ, các ghi chú của chúng tôi về chạy agent GPT-6 Luna trong Sharkly áp dụng trực tiếp.
Những rào chắn đáng thêm ngay từ ngày đầu
- Ngắt lời không hủy công việc. Hướng dẫn của OpenAI cho biết việc ngắt cuộc hội thoại nói không dừng công việc backend. Nếu ai đó nói "thôi bỏ đi", backend của bạn phải tự xử lý, nếu không run vẫn tiếp tục.
- Coi webhook URL như một mật khẩu. Tài liệu của Sharkly mô tả nó mặc định là bearer secret. Hãy thêm signing secret và tạo lại URL nếu nó bị lộ.
- Giới hạn phạm vi của Automation. Bắt đầu với công việc có thể quan sát và hoàn tác được, như tài liệu Sharkly khuyến nghị, và review vài run trước khi mở rộng.
- Giữ delegation của Crew bên trong Sharkly. Nếu một yêu cầu cần nhiều agent, hãy trỏ webhook đến một Sharkly Crew và để leader của nó chia nhỏ công việc.
Khi nào front end giọng nói không phải công cụ phù hợp
Hãy bỏ qua nó khi yêu cầu cần một diff, một log, hay một ảnh chụp màn hình mới hiểu được. Giọng nói không thể hiện cho bạn một cái test đang fail. Nó cũng là kênh sai lầm cho bất cứ thứ gì cần chữ ký: phê duyệt, deploy và thay đổi quyền truy cập nên nằm trên task nơi có bằng chứng.
Giọng nói phát huy giá trị với các kiểm tra trạng thái nhanh, khởi chạy các run đã được định nghĩa rõ ràng, và những khoảnh khắc hai tay đang bận. Hãy xem nó như một cái điều khiển từ xa cho bảng agent của bạn, chứ không phải sự thay thế cho bảng đó.
Kết luận
GPT-Live-1.1 đảm nhận phần khó tự xây nhất của một voice agent: hội thoại full-duplex có ngắt lời. Delegation giao phần còn lại cho backend. Đặt đội agent hiện có của bạn phía sau backend đó, và bạn có thể hỏi về các run cũng như khởi chạy run mới chỉ bằng lời nói, trong khi mọi kết quả vẫn đổ về một bảng mà con người sẽ review.
Bước tiếp theo của bạn: tạo một Automation với webhook trigger trong Sharkly, thử nghiệm bằng Run now, rồi trỏ một GPT-Live session ở chế độ client vào đó. Tài liệu Sharkly trình bày chi tiết về Agents, Computers và Automations.
Câu hỏi thường gặp
Làm thế nào để AI agent của tôi có giọng nói?
Đặt một mô hình giọng nói như GPT-Live-1.1 phía trước agent và cho phép nó delegation. Mô hình giọng nói đảm nhận việc nghe và nói, còn backend của bạn chạy agent và trả về một kết quả ngắn gọn để mô hình giọng nói đọc thành lời.
GPT-Live-1.1 có sẵn trong API không?
Có. OpenAI liệt kê gpt-live-1.1 với endpoint v1/live/sessions, function calling và streaming. Nó không hỗ trợ trực tiếp v1/realtime hay v1/responses.
GPT-Live-1.1 giá bao nhiêu?
OpenAI liệt kê giá 0,05 USD mỗi phút cho session đang hoạt động và 0,02 USD mỗi phút ở chế độ standby. Các lời gọi mô hình backend qua delegation được tính phí riêng theo giá thông thường của chúng.
Responses delegation khác client delegation thế nào?
Với Responses delegation, OpenAI chạy một mô hình backend bạn cấu hình. Với client delegation, ứng dụng của bạn nhận từng yêu cầu và trả kết quả bằng session.commentary.append hoặc session.thinking.append.
GPT-Live-1.1 có thể chạy coding agent trực tiếp không?
Không. Nó chỉ delegation. Backend của bạn quyết định cái gì được chạy, ví dụ bằng cách gọi webhook của một Sharkly Automation để khởi chạy Agent hoặc Crew run trên một Computer đã kết nối.
Điều gì xảy ra nếu tôi ngắt voice agent giữa chừng khi nó đang làm việc?
Cuộc hội thoại dừng lại, nhưng công việc backend thì không. Hãy xử lý việc hủy trong backend của bạn, ví dụ bằng cách tạm dừng run hoặc bình luận trên task.


