

Tóm tắt nhanh: Giá GPT-6.2 là 8 USD cho một triệu token đầu vào và 40 USD cho một triệu token đầu ra với Astra, còn 2 USD và 10 USD với Sol. Đọc bộ đệm đầu vào (cached input) có giá 0,40 USD và 0,10 USD. Một tác vụ agent minh họa gồm 20 lượt chỉ tốn khoảng 3,23 USD trên Astra và 0,81 USD trên Sol khi prompt caching hoạt động, và gấp bốn lần nếu không có.
OpenAI đã phát hành GPT-6.2 Astra và GPT-6.2 Sol vào ngày 17 tháng 11 năm 2026. Astra là mô hình tiệm cận đỉnh dành cho những công việc khó nhất. Sol là mô hình hằng ngày, và trang mô hình của nó nói rằng nó được xây dựng để "vận hành agents ở quy mô lớn."
Giá trên một triệu token cho biết rất ít về việc một đội agent sẽ tốn bao nhiêu. Agents gửi lại toàn bộ ngữ cảnh mỗi lượt, vì vậy hóa đơn phụ thuộc vào caching, độ dài ngữ cảnh và số lượng agent chạy đồng thời. Bài hướng dẫn này chuyển bảng giá GPT-6.2 thành con số theo từng tác vụ và theo tháng, rồi chỉ ra các giới hạn giúp bạn kiểm soát chi phí. Nếu bạn đã chạy các coding agents song song, Sharkly là nơi bạn đặt giới hạn đó cho từng Agent.
Giá GPT-6.2 cho Astra và Sol
Đây là bảng giá API tiêu chuẩn từ trang mô hình Astra và trang mô hình Sol, kiểm tra vào ngày 20 tháng 11 năm 2026. Mọi mức giá tính trên một triệu token.
| Giá trên 1M token | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Đầu vào | $8.00 | $2.00 |
| Đầu vào từ bộ đệm (đọc) | $0.40 | $0.10 |
| Ghi bộ đệm (lưu 30 phút) | $10.00 | $2.50 |
| Ghi bộ đệm (lưu 12 giờ) | $20.00 | $5.00 |
| Đầu ra | $40.00 | $10.00 |
| Cửa sổ ngữ cảnh | 1.050.000 | 1.050.000 |
Sol có giá đúng bằng một phần tư của Astra trên mọi dòng. Cả hai mô hình dùng chung cửa sổ ngữ cảnh và giới hạn tốc độ như nhau, nên giá cả chính là yếu tố phân biệt chúng trên hóa đơn.
Những quy định định giá làm thay đổi tổng chi phí
Năm quy định trên các trang mô hình ảnh hưởng đến hóa đơn agent nhiều hơn mức giá quảng cáo:
- Phụ phí ngữ cảnh dài. Một yêu cầu có hơn 272K token đầu vào sẽ bị tính gấp đôi cho đầu vào và bộ đệm, và 1,5 lần cho đầu ra, áp dụng cho toàn bộ yêu cầu.
- Ghi bộ đệm tốn thêm chi phí. Ghi một tiền tố vào bộ đệm tốn 1,25 lần giá đầu vào thông thường cho 30 phút, hoặc 2,5 lần cho 12 giờ.
- Đọc bộ đệm rất rẻ. Trên GPT-6.2, một lượt đọc từ bộ đệm chỉ tốn 0,05 lần giá đầu vào thông thường, theo hướng dẫn prompt caching của OpenAI.
- Batch chỉ tốn 50 phần trăm mức giá tiêu chuẩn.
- Tốc độ cao tốn kém hơn. Chế độ Fast gấp 2 lần giá tiêu chuẩn. Ultrafast gấp 3 lần đến ngày 28 tháng 2 năm 2027, và gấp 6 lần từ ngày 1 tháng 3 năm 2027.
GPT-6.2 không hỗ trợ Flex processing. Thay thế cho nó là cửa sổ hoàn tất chạy nền (background completion) được giảm giá, được trình bày bên dưới.
Một tác vụ agent tốn bao nhiêu trên GPT-6.2
Hãy lấy một tác vụ lập trình minh họa: 20 lượt, 60.000 token đầu vào mỗi lượt và 2.000 token đầu ra mỗi lượt. Nghĩa là 1,2 triệu token đầu vào và 40.000 token đầu ra cho toàn bộ tác vụ. Số liệu của bạn sẽ khác, nên hãy thay bằng số của chính mình.
| Kịch bản | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Không trúng bộ đệm | $11.20 | $2.80 |
| 90 phần trăm trúng bộ đệm | $3.23 | $0.81 |
| 90 phần trăm trúng bộ đệm, cửa sổ nền 8 giờ | $1.94 | $0.49 |
Các dòng có bộ đệm giả định 90 phần trăm đầu vào được đọc từ bộ đệm và 10 phần trăm còn lại được tính như một lần ghi bộ đệm 30 phút. Đây là kịch bản bi quan, nên một lần chạy thực tế có bộ đệm sẽ ở mức bằng hoặc thấp hơn các con số này.
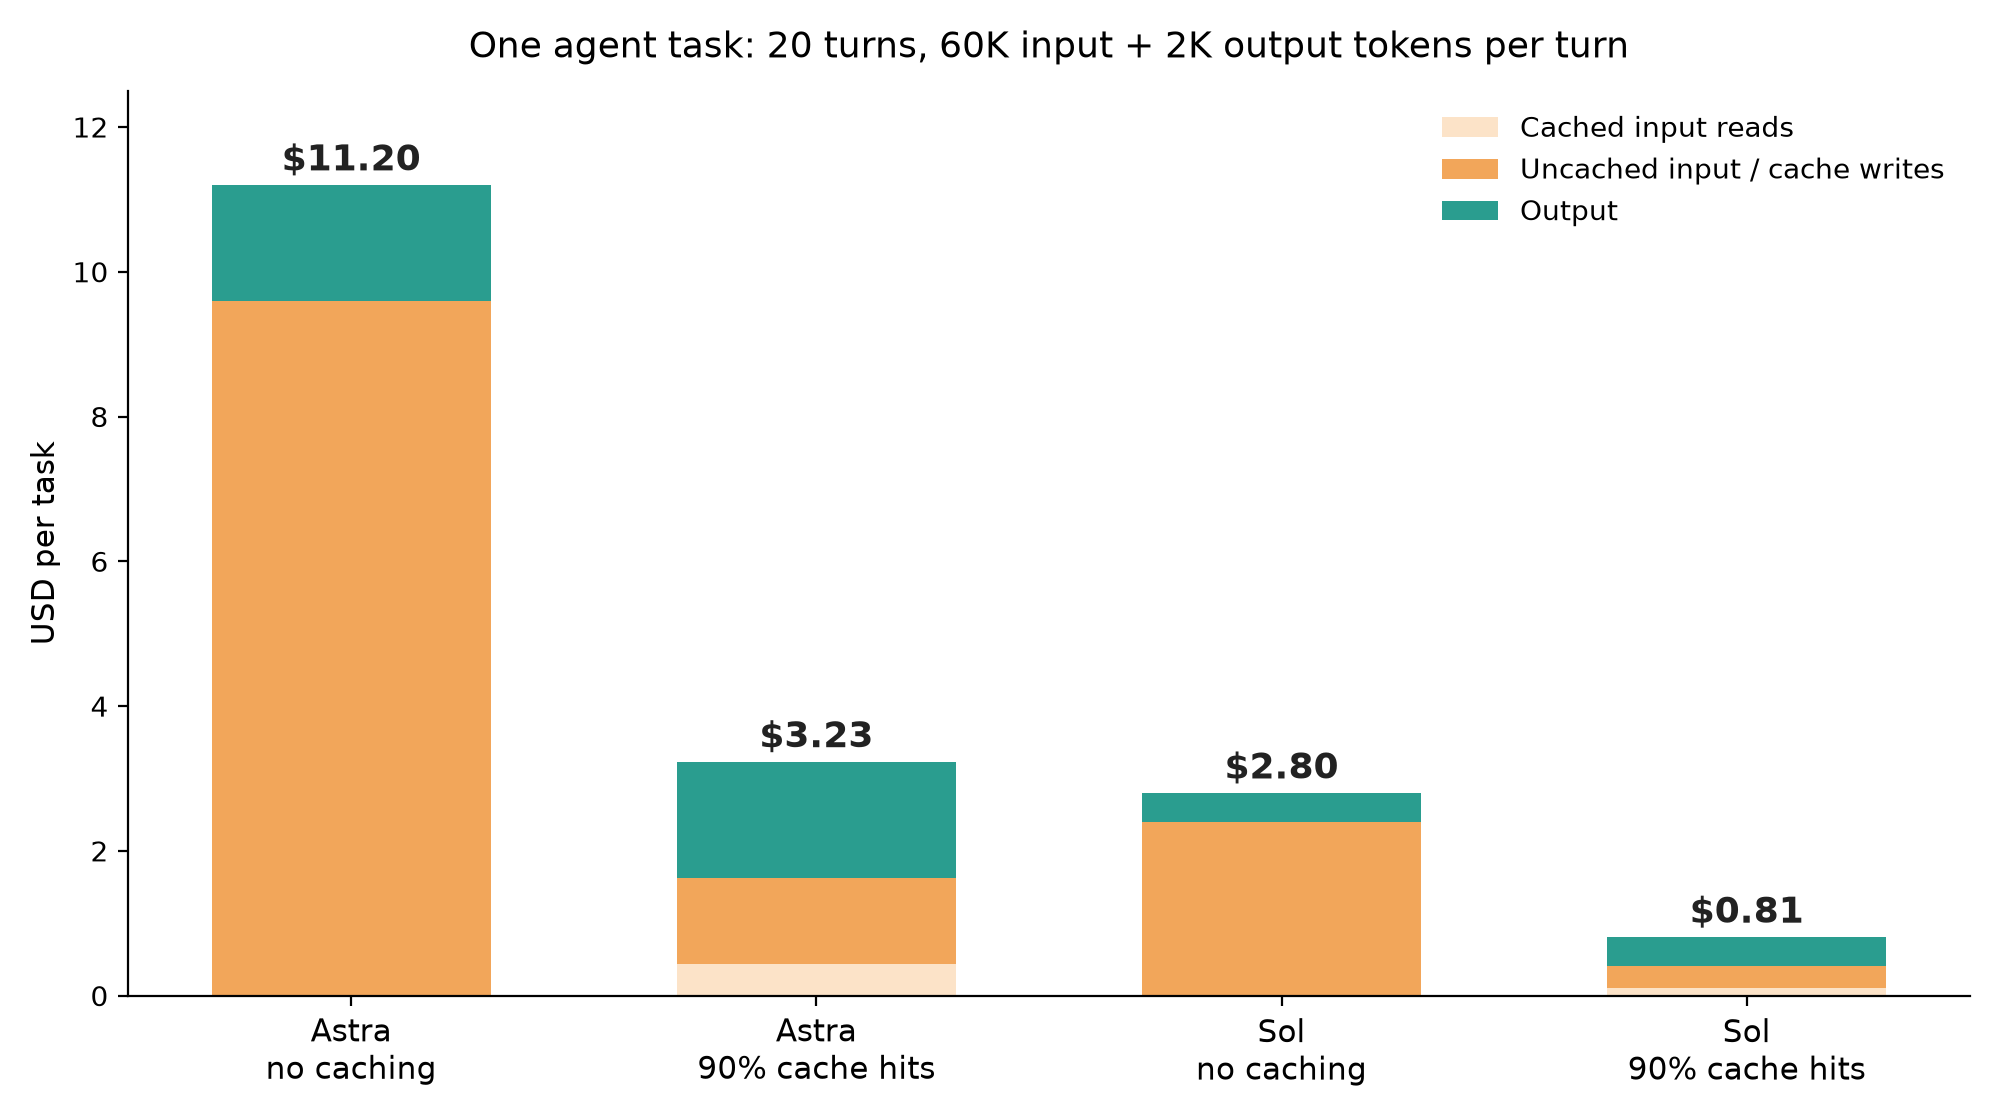
Hai con số nổi bật. Caching giảm chi phí tác vụ khoảng 71 phần trăm trên cả hai mô hình. Và một tác vụ Astra có bộ đệm chỉ tốn nhiều hơn chút ít so với tác vụ Sol không có bộ đệm. Mô hình rẻ với bộ đệm hỏng tốn gần bằng mô hình đắt với bộ đệm hoạt động tốt.
Phụ phí ngữ cảnh dài đánh vào đâu
Các coding agents đọc một nửa repository có thể vượt quá 272K token đầu vào mỗi lượt. So sánh hai lượt Sol, đều có 2.000 token đầu ra và không dùng bộ đệm:
- 270.000 token đầu vào: 0,54 USD đầu vào cộng 0,02 USD đầu ra, tổng 0,56 USD.
- 300.000 token đầu vào: 1,20 USD đầu vào cộng 0,03 USD đầu ra, tổng 1,23 USD.
Ngữ cảnh lớn hơn 11 phần trăm lại tốn hơn gấp đôi. Nếu hệ thống agent của bạn nén ngữ cảnh, hãy giữ dưới 272K. Cùng logic này nằm sau bài viết của chúng tôi về tại sao mô hình rẻ có thể tốn kém hơn: giá trên mỗi thay đổi được chấp nhận quan trọng hơn giá trên mỗi token.
Chi phí GPT-6.2 cho một đội agent mỗi tháng
Bây giờ hãy nhân rộng các con số có bộ đệm. Giả sử năm agent mỗi agent hoàn thành 8 tác vụ mỗi ngày trong 22 ngày làm việc. Đó là 880 tác vụ mỗi tháng.
| Cấu hình đội | Tác vụ mỗi tháng | Chi phí mô hình hàng tháng |
|---|---|---|
| Cả năm agent dùng Astra | 880 | $2,842 |
| Một agent trưởng Astra, bốn agent Sol | 176 + 704 | $1,139 |
| Cả năm agent dùng Sol | 880 | $713 |
Cấu hình kết hợp tốn ít hơn 60 phần trăm so với toàn Astra. Nó giữ mô hình tiệm cận đỉnh cho việc lập kế hoạch và review khó, còn gửi công việc thông thường cho Sol. Chúng tôi bàn về vai trò agent trưởng trong GPT-6 Astra làm agent trưởng đội của bạn, và cùng lý luận này thúc đẩy bài ngân sách như cũ, nhiều agent hơn với GPT-6 Sol.
Giá cả chỉ là một giới hạn. Token mỗi phút có thể chặn một đội agent trước khi tiền bạc làm điều đó ở các bậc sử dụng thấp hơn, điều mà hướng dẫn giới hạn tốc độ GPT-6.2 phân tích từng bậc một.
Gói Codex so với API key
Nếu các agent của bạn chạy Codex trên gói ChatGPT, bạn không trả theo token. Bạn tiêu một hạn mức. Trang định giá Codex ước tính 6 đến 50 tin nhắn cục bộ mỗi cửa sổ năm giờ cho GPT-6.2 Astra trên Plus và Standard Business, và 17 đến 180 cho Sol. Các phiên dài làm cạn hạn mức nhanh hơn, nên phép tính token ở trên vẫn dự đoán được tác vụ nào cạn trước.
Hướng dẫn GPT-6.2 Codex của chúng tôi trình bày cách thiết lập cho cả hai mô hình.
Cách giảm chi phí GPT-6.2 cho đội agent
Thứ tự dưới đây sắp xếp theo mức tiết kiệm nhiều nhất trước:
- Khiến caching hoạt động. Đặt hướng dẫn ổn định trong tin nhắn
developerở đầu đầu vào, và không bao giờ viết lại các lượt trước. Tiền tố thay đổi là một lần trượt bộ đệm. - Mặc định dùng Sol. Chỉ nâng tác vụ lên Astra khi nó vượt qua ranh giới dịch vụ hoặc Sol thất bại hai lần với cùng loại tác vụ.
- Giữ dưới 272K token đầu vào cho mỗi yêu cầu.
- Đẩy công việc hàng loạt vào cửa sổ nền khi bạn gọi API từ hệ thống riêng của mình.
- Dùng Batch cho evals và công việc ngoại tuyến, không bao giờ dùng cho agent tương tác.
- Tắt Fast và Ultrafast trừ khi có người đang chờ kết quả.
Cửa sổ nền giảm giá thay thế Flex
Hướng dẫn chế độ nền của OpenAI liệt kê hai cửa sổ hoàn tất giảm giá cho Responses API, ở giai đoạn public beta trên GPT-6.2: 2h thấp hơn 30 phần trăm so với tiêu chuẩn và 8h thấp hơn 40 phần trăm. Chúng dùng chung giới hạn tốc độ của Batch, không dùng giới hạn token trực tiếp của bạn.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Kiểm tra ID phản hồi sau, hoặc dùng webhook. Cách này phù hợp với việc sinh test, nâng cấp dependency và các lượt xử lý tài liệu mà không ai cần trước buổi sáng.
Kiểm soát chi tiêu GPT-6.2 cho từng Agent trong Sharkly
Sharkly không bán lại token. Mỗi lần chạy được tính vào gói Codex hoặc API key đã gắn với Runtime, nên hóa đơn OpenAI của bạn vẫn là nguồn sự thật duy nhất. Sharkly mang lại cho bạn quyền kiểm soát lượng công việc chảy vào hóa đơn đó.
Mỗi Agent có một dòng Default model liệt kê các mô hình mà Runtime của nó báo cáo. Đặt các Agent thông thường của bạn sang Sol và agent trưởng sang Astra. Khi một tác vụ cần nhiều hơn, tài liệu Sharkly mô tả tính năng ghi đè theo từng tác vụ: di chuột lên Agent trong phần chọn Assignee và chọn mô hình chỉ cho lần chạy đó.
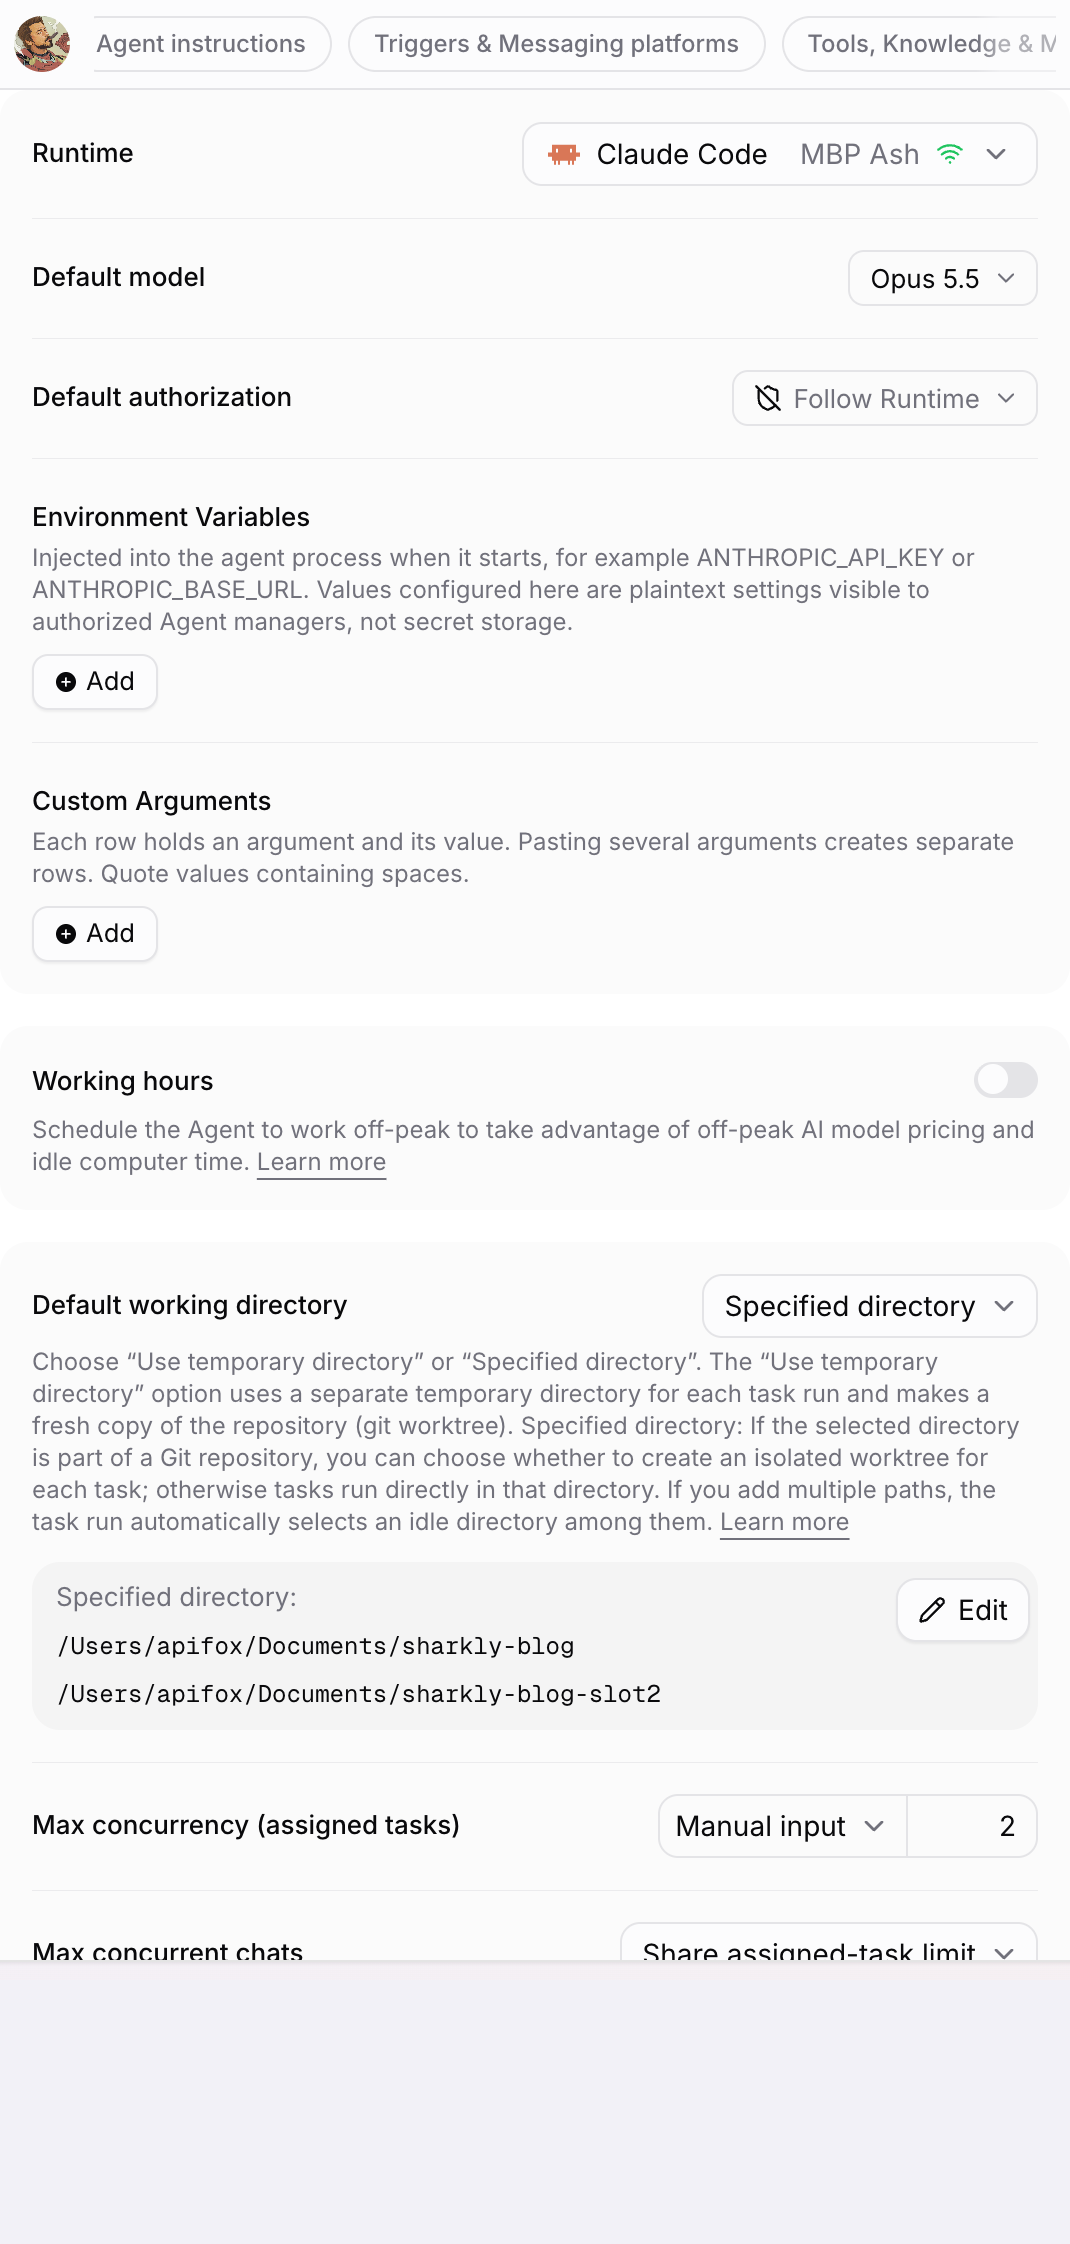
Cùng bảng điều khiển đó còn chứa Environment Variables, được chèn vào tiến trình agent khi khởi động. Cấp cho mỗi nhóm Agent một API key từ dự án OpenAI riêng của nó, và trang sử dụng OpenAI của bạn sẽ tách chi tiêu theo nhóm. Working hours lập lịch cho Agent vào các khung giờ thấp điểm, để các tác vụ hàng loạt chạy ban đêm và nhường năng lực ban ngày cho những người đang chờ.
Chi tiêu cũng cần một mức trần. Max concurrency giới hạn số tác vụ một Agent chạy đồng thời, Max run duration chấm dứt phiên chạy bị lặp vô hạn, và Queue timeout loại bỏ công việc chờ quá lâu.
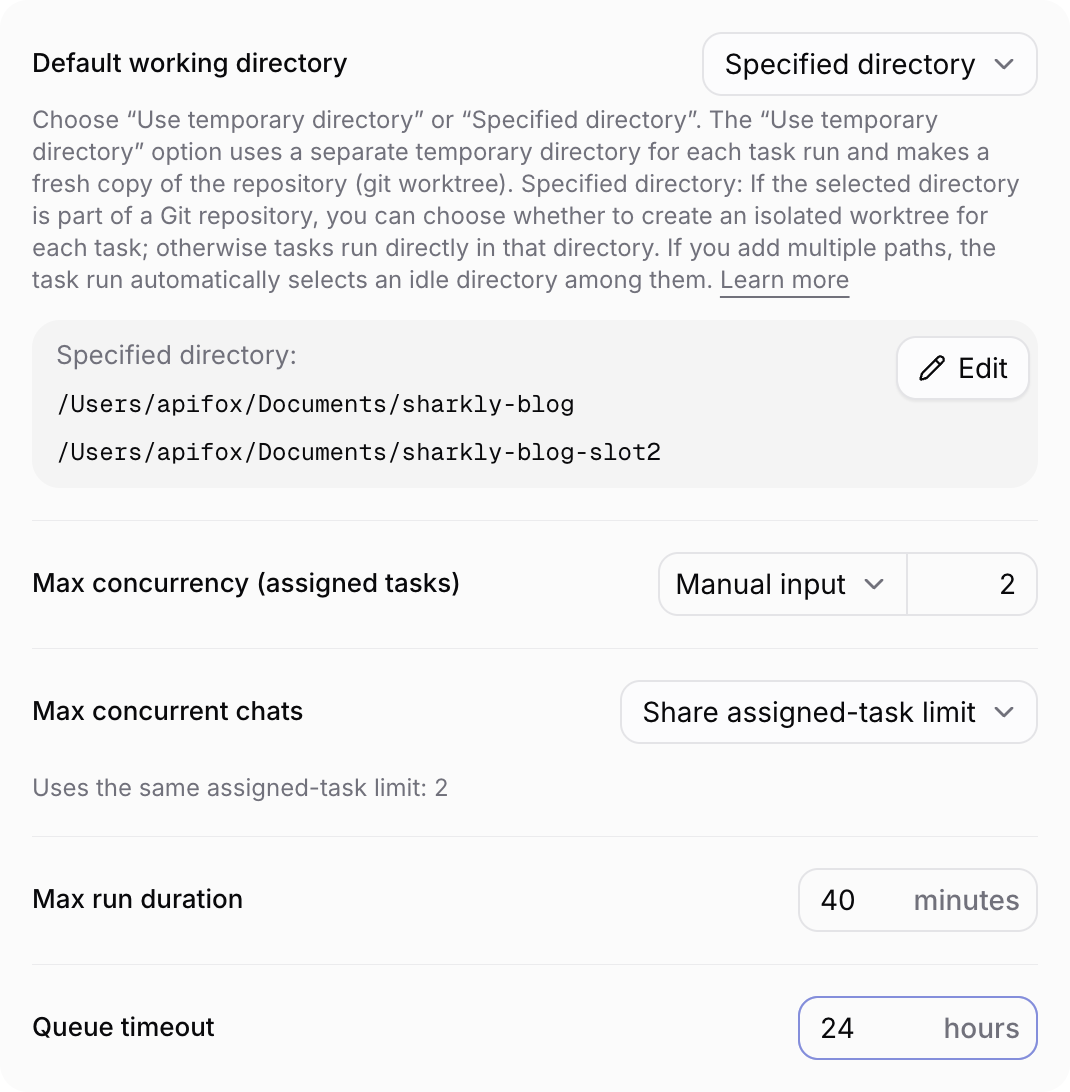
Mức trần 40 phút cho mỗi lần chạy trên một Agent Sol giới hạn trường hợp xấu nhất. Danh sách chạy trên mỗi Agent hiển thị số token mỗi lần chạy đã dùng, nên bạn có thể nhận ra loại tác vụ nào đốt gấp ba lần các tác vụ khác. Tác vụ đó cần mô tả chặt chẽ hơn hoặc mô hình rẻ hơn.
Kết luận
Giá GPT-6.2 nhìn có vẻ đơn giản: Astra đắt gấp bốn lần Sol trên mọi dòng. Hóa đơn agent thì không đơn giản. Caching làm thay đổi chi phí tác vụ khoảng 71 phần trăm, ngưỡng 272K có thể nhân đôi một lượt, và độ đồng thời nhân tất cả lên. Hãy đo một tác vụ thực tế, nâng tỷ lệ trúng bộ đệm lên, giao công việc thông thường cho Sol, và giới hạn những gì chạy đồng thời.
Hãy thử trên một Agent trước. Kết nối một Computer, tạo một Codex Agent trên GPT-6.2 Sol, đặt Max concurrency thành 2 và Max run duration thành 40 phút, rồi giao cho nó một tác vụ thông thường. Sau đó xem số token của lần chạy đó. Thêm về việc chạy cả đội song song trong bài cách chạy 10 AI coding agents cùng lúc.
Câu hỏi thường gặp
GPT-6.2 giá bao nhiêu?
GPT-6.2 Astra có giá 8 USD mỗi triệu token đầu vào và 40 USD mỗi triệu token đầu ra. GPT-6.2 Sol có giá 2 USD và 10 USD. Đọc bộ đệm đầu vào tốn 0,40 USD trên Astra và 0,10 USD trên Sol.
GPT-6.2 Sol có rẻ hơn Astra không?
Có. Sol có giá bằng một phần tư của Astra cho đầu vào, đầu ra, đọc bộ đệm và ghi bộ đệm. Cả hai dùng chung cửa sổ ngữ cảnh 1.050.000 token và giới hạn tốc độ như nhau.
Giá ngữ cảnh dài của GPT-6.2 là bao nhiêu?
Các yêu cầu trên 272K token đầu vào bị tính gấp đôi cho đầu vào và bộ đệm, và 1,5 lần cho đầu ra, áp dụng cho toàn bộ yêu cầu, chứ không chỉ các token vượt ngưỡng.
GPT-6.2 có hỗ trợ Flex processing không?
Không. OpenAI hướng các công việc chạy dài sang các cửa sổ hoàn tất nền được giảm giá: 2h giảm 30 phần trăm và 8h giảm 40 phần trăm, đang ở giai đoạn public beta.
GPT-6.2 Batch giá bao nhiêu?
Batch có giá bằng 50 phần trăm mức tiêu chuẩn trên cả hai mô hình. Nó phù hợp với evals và công việc ngoại tuyến, không phù hợp với agent tương tác.
Sharkly có thu phí token GPT-6.2 không?
Không. Sharkly chạy các coding agents bạn đã dùng, và việc sử dụng mô hình được tính vào gói Codex hoặc API key của chính bạn. Sharkly kiểm soát mô hình nào mỗi Agent dùng và bao nhiêu tác vụ chạy đồng thời.


