
Kurzantwort: Die Preise für Claude Fable 5.2 liegen in Anthropics Standard-API bei 8 $ pro Million Input-Token und 40 $ pro Million Output-Token. Der Fast-Modus kostet entsprechend 16 $ bzw. 80 $. Kalkulieren Sie jedoch den gesamten Workflow ein: wiederholten Kontext, Thinking-Phasen, Retries, koordinierende Agenten, Tools sowie manuelle Reviews. Stand der Preise: 10. November 2026.
Ein Token-Preis verrät Ihnen lediglich, was ein einzelner Modellaufruf kostet. Für Ihr Engineering-Budget zählen jedoch die Kosten für ein abgenommenes Ergebnis. Eine Migration, die drei Versuche, das Review eines weiteren Agenten und manuelle Korrekturen durch Menschen erfordert, verursacht für ein einziges Delivery gleich mehrere Kostenpunkte.
Wenn Sie mehrere Coding-Agenten parallel einsetzen, bietet Ihnen Sharkly einen zentralen Ort für deren Tasks und Ergebnisse. Beginnen Sie Ihre Kostenanalyse genau hier: Definieren Sie, was als fertiggestellt gilt, bevor Sie Modelle miteinander vergleichen.
Was kostet Claude Fable 5.2?
Anthropic rechnet Input- und Output-Token getrennt ab, mit unterschiedlichen Tarifen für Caching, Batch-Verarbeitung und den Fast-Modus. 1 MTok entspricht einer Million Token. Die folgenden US-Dollar-Preise stammen aus der offiziellen Preisdokumentation (Stand: 10. November 2026). Sie beziehen sich auf die API-Nutzung und nicht auf ein pauschales monatliches Coding-Abonnement.
| Abrechnungskategorie | Input pro MTok | Output pro MTok |
|---|---|---|
| Standard-API | $8 | $40 |
| Fast-Modus | $16 | $80 |
| Batch-API | $4 | $20 |
| Standard-Cache-Write (5 Minuten) | $10 | Nicht zutreffend |
| Standard-Cache-Write (1 Stunde) | $16 | Nicht zutreffend |
| Standard-Cache-Hit | $0.20 | Nicht zutreffend |
Cache-Writes und Cache-Hits fallen unter die Input-Kategorien und stellen keine Rabatte auf den Output dar. Die Cache-Preise im Fast-Modus wenden die Caching-Multiplikatoren auf die regulären Fast-Modus-Input-Preise an. Die Batch-Verarbeitung bietet einen Rabatt von 50 % auf Input und Output, allerdings lässt sich der Fast-Modus nicht mit Batch kombinieren.
Fable bietet das vollständige Kontextfenster von einer Million Token zu den regulären Token-Preisen. Dennoch bleibt ein großer Kontext kostspielig: Nicht gecachter Input summiert sich über aufeinanderfolgende Aufrufe hinweg auf. Von Partnern betriebene Cloud-Plattformen können abweichende Preise haben; prüfen Sie daher genau, über welchen Endpunkt Ihr Team abrechnet.
Wie kalkuliert man das Budget für einen Workflow?
Für einen regulären Aufruf ohne Caching multiplizieren Sie die Input-Token mit 8 $ pro Million und die Output-Token mit 40 $ pro Million und addieren beide Beträge. Wiederholen Sie das für jeden einzelnen Aufruf bei jedem Versuch. Rechnen Sie gesonderte Tool- und Infrastrukturkosten sowie die Zeit für manuelle Reviews hinzu, um die tatsächlichen Gesamtkosten pro Delivery abzuschätzen.
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
„Output“ bezeichnet hier den gesamten abrechenbaren Output – gegebenenfalls einschließlich des internen Denkprozesses (Thinking). Verwechseln Sie die sichtbare Textlänge der Antwort nicht mit dem vom Provider erfassten Verbrauch.
Angenommen, Sie führen 20 Tasks mit diesen Token-Zahlen aus. Fünf dieser Tasks erfordern jeweils einen identischen Retry. Nehmen wir an, dass ein koordinierender Agent insgesamt 2 $ kostet und ein Reviewer 15 Minuten investiert – bei internen Kosten von 80 $ pro Stunde.
| Hypothetische Komponente | Berechnung | Kosten |
|---|---|---|
| Ursprüngliche Versuche | 20 × $1.60 | $32 |
| Zusätzliche Versuche | 5 × $1.60 | $8 |
| Koordinator | Angenommene Gesamtausgaben für Modelle | $2 |
| Menschliches Review | 0,25 Stunden × $80 | $20 |
| Gesamt | Vor Tools, Infrastruktur und Steuern | $62 |
Werden alle 20 Tasks abgenommen, belaufen sich die Kosten in diesem Beispiel auf 3,10 $ pro abgenommener Task. Werden jedoch nur 16 abgenommen, steigen die Kosten derselben 62 $ auf etwa 3,88 $ pro abgenommener Task. Der Nenner entscheidet über die Wirtschaftlichkeit.
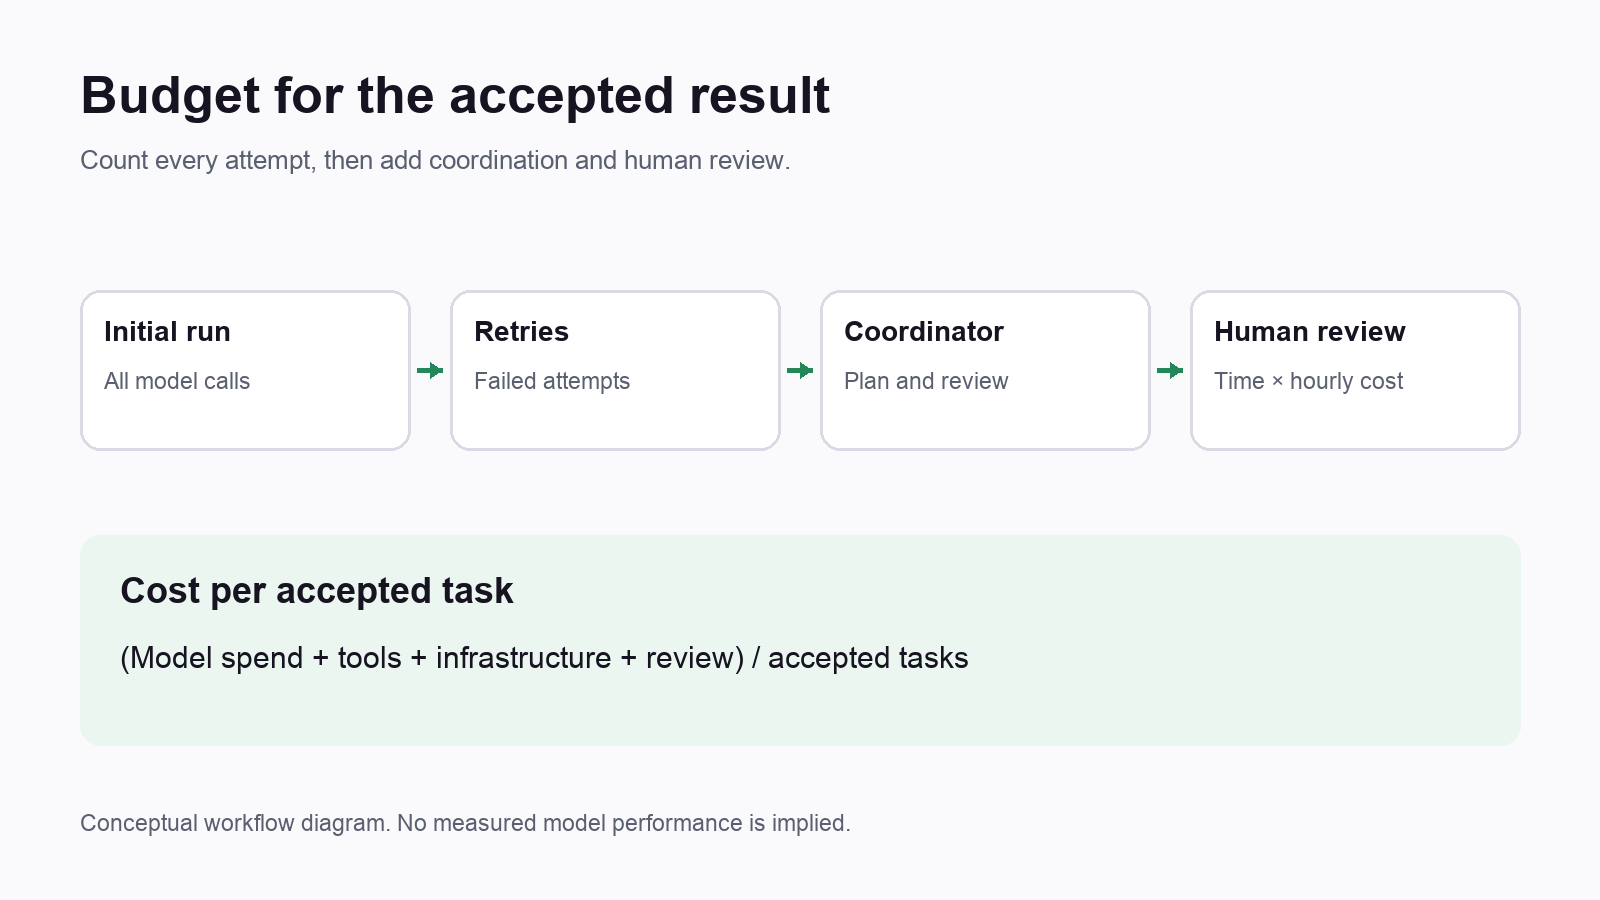
Hierbei handelt es sich um Planungsannahmen, nicht um gemessene Performance-Werte von Fable. Ersetzen Sie diese durch Ihre eigenen Token-Werte, Retry-Raten, Abnahmequoten und Review-Zeiten. Unser Leitfaden zur Kostenberechnung von Agent-Läufen pro abgenommener Änderung erläutert genauer, warum dieser Vergleich so wichtig ist.
Fast-Modus und Effort-Einstellungen beeinflussen unterschiedliche Kosten
Der Fast-Modus erhöht die Token-Preise, um die Generierungszeit zu verkürzen. Die Effort-Einstellung hingegen steuert, wie viel Arbeit das Modell investiert – einschließlich Denkprozessen und Tool-Aufrufen. Betrachten Sie beides als getrennte Stellschrauben: Eine schnellere Generierung garantiert noch keinen kürzeren End-to-End-Workflow, und ein niedrigerer Effort-Wert stellt keine feste Kostenobergrenze dar.
Laut Anthropics Ankündigung zum Launch generiert der Fast-Modus Token bis zu 2,5-mal schneller. Das ist allerdings eine Angabe des Anbieters zur reinen Token-Generierung – keine Garantie dafür, dass Builds, Tests, Netzwerkaufrufe oder manuelle Reviews ebenfalls 2,5-mal schneller abgeschlossen sind.
Bei identischer Token-Anzahl verdoppeln sich die Kosten aus unserem 1,60-$-Beispiel im Fast-Modus auf 3,20 $. Nutzen Sie den Fast-Modus, wenn der Nutzen kürzerer Wartezeiten den Aufpreis rechtfertigt. Für unbeaufsichtigte Hintergrundprozesse, bei denen die Latenz der Generierung keine Rolle spielt, empfiehlt sich der Standardmodus.
In der Effort-Dokumentation werden für Fable 5.2 die Stufen Low, Medium, High, Xhigh und Max aufgeführt. Der API-Standardwert ist High. In der Ankündigung wird Medium als Standard in den Claude-Apps und in Claude Code genannt. Halten Sie für Ihre Vergleiche stets das konkrete Produkt sowie die explizit gewählte Einstellung fest.
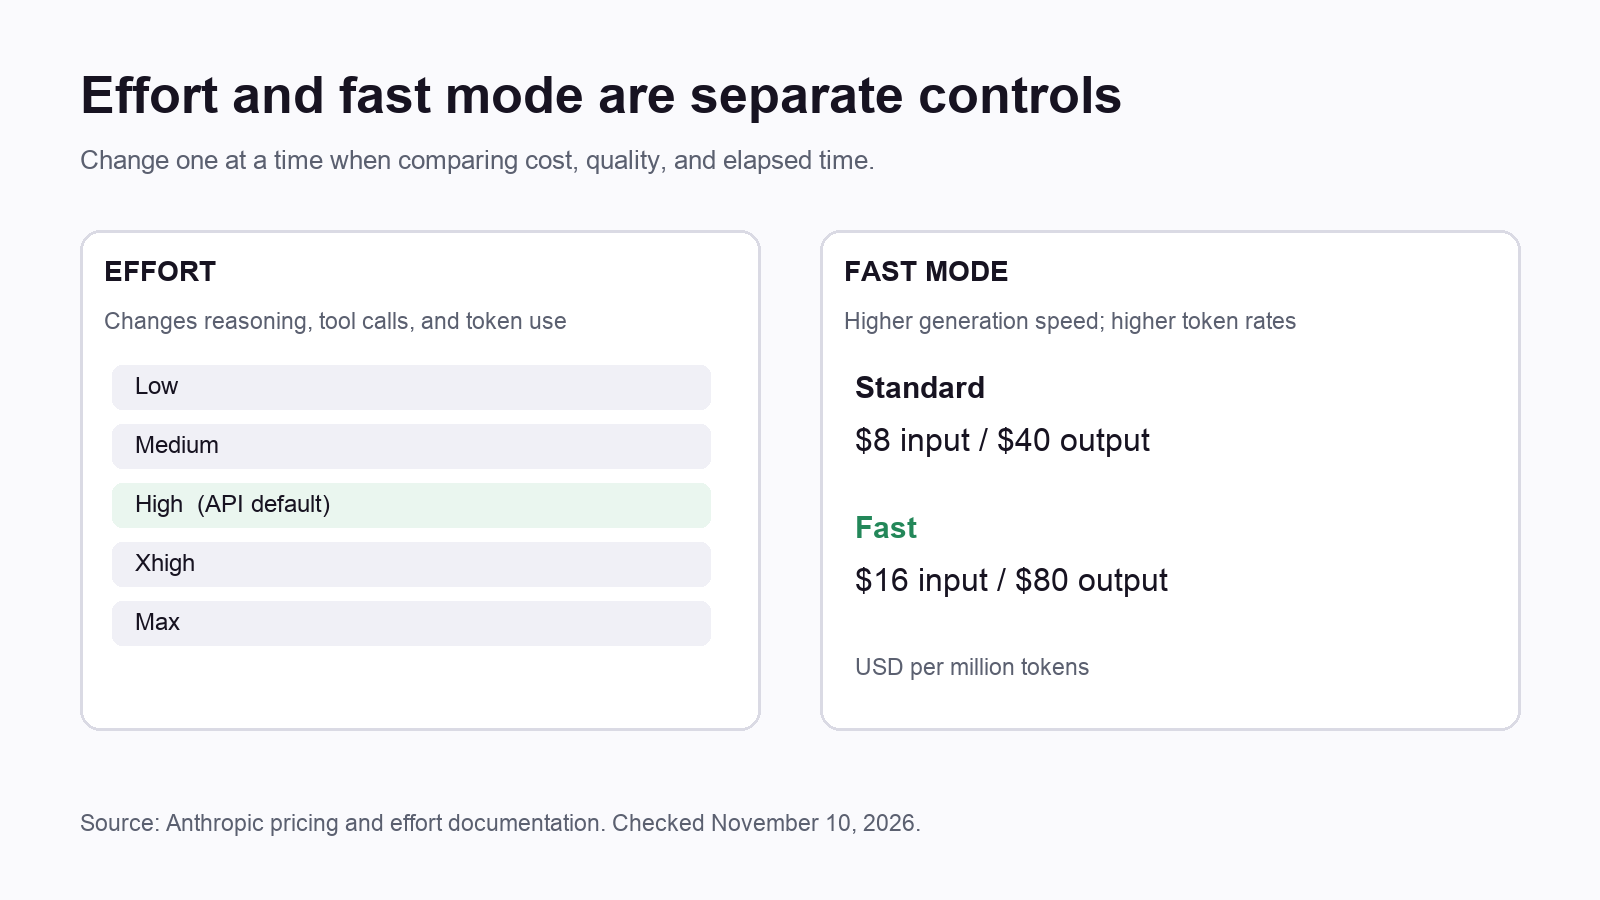
Anthropic empfiehlt, bei API-Workloads mit High zu beginnen, den Effort dort zu senken, wo Evaluierungen gleichbleibende Qualität bestätigen, und auf Xhigh hochzustufen, wenn komplexe Aufgaben nachweisbare Verbesserungen zeigen. Die Stufe Max maximiert die Fähigkeiten ohne Rücksicht auf Token-Kosten. Effort steuert das Modellverhalten; tatsächliche Ausgabenlimits müssen Sie jedoch direkt in Ihrer Anwendung und Ihren Betriebsprozessen durchsetzen.
Wiederholten Kontext, Retries und Orchestrierung im Griff behalten
Nutzen Sie diese sechs Hebel, bevor Sie die Zahl Ihrer Agenten erhöhen:
- Messen Sie jeden Versuch. Rechnen Sie fehlgeschlagene und abgebrochene Versuche den Gesamtkosten derselben Task zu.
- Cachen Sie stabilen Kontext. Verwenden Sie Repository-Anweisungen und unveränderte Dokumente wieder, sofern sich der Workload für Prompt Caching eignet.
- Begrenzen Sie Retries. Definieren Sie ein Retry-Limit und verlangen Sie eine Fehleranalyse, bevor ein weiterer kostspieliger Versuch gestartet wird.
- Routen Sie nach Schwierigkeitsgrad. Eskalieren Sie nur bei ungelösten Reasoning-Problemen, anstatt jeden einfachen Extraktions- oder Formatierungsschritt an Fable zu übergeben.
- Kalkulieren Sie Koordination ein. Erfassen Sie Aufrufe für Planung, Dispatching, Zusammenfassungen und Reviewer genauso wie die Aufrufe der eigentlichen Worker.
- Steuern Sie den Durchsatz für Reviews. Passen Sie die Menge fertiggestellter Arbeiten an die Kapazitäten an, die Ihre Reviewer tatsächlich prüfen können.
Tool-Definitionen und Tool-Ergebnisse vergrößern den Input des Modells. Einige serverseitige Tools verursachen zusätzliche Gebühren, wie in Anthropics Preisleitfaden erläutert wird. Ein Befehl, der ein riesiges Protokoll zurückgibt, kann die Kontextkosten späterer Aufrufe drastisch in die Höhe treiben – selbst wenn die Ausführung des Befehls selbst kaum etwas kostet.
Auch das Caching muss gemessen werden. Bei einem beispielhaften Prefix von 100.000 Token kostet ein Standard-Schreibvorgang in den Cache (5 Minuten) 1 $. Ein darauffolgender Cache-Hit kostet 0,02 $ im Vergleich zu 0,80 $ bei ungecachetem Input. Diese Zahlen berücksichtigen noch keinen neuen Input oder Output. Prüfen Sie die tatsächliche Cache-Hit-Rate, bevor Sie von Einsparungen ausgehen.
Eine verlässliche Richtlinie für das Routing finden Sie in der Modellübersicht. Anthropic empfiehlt Opus 5.5 für die meisten Workloads und Fable für anspruchsvolles Reasoning oder komplexe, längerfristige Aufgaben. Das ist ein guter Ausgangspunkt für Tests – aber kein Beweis dafür, welches Modell für Ihr spezifisches Repository am besten abschneidet.
Was sollten Sie in einer Pilotphase messen?
Halten Sie Task-Umfang und Akzeptanztests über alle Konfigurationen hinweg absolut identisch. Trennen Sie bei den Zeiterfassungen genau zwischen Queue-Zeiten, Modellgenerierung, Tool-Ausführung und menschlichem Review. Andernfalls kann eine langsame Test-Suite den Vorteil schnellerer Generierung verschleiern – oder eine Auswahl zu einfacher Tasks lässt eine teure Konfiguration fälschlicherweise wirtschaftlich erscheinen.
Erfassen Sie gecachten und ungecachten Input getrennt voneinander. Dokumentieren Sie die tatsächlichen Nutzungsdaten des Providers für jeden einzelnen Versuch, anstatt Token anhand von Dateigrößen zu schätzen. Wenn Sie eine Effort-Einstellung anpassen, vergleichen Sie nicht nur die erste Antwort, sondern auch die abgenommenen Ergebnisse und den Nachbesserungsaufwand. Ein kürzerer erster Durchlauf kann am Ende deutlich höhere Korrekturkosten nach sich ziehen.
Definieren Sie eine Abbruchbedingung, bevor Sie die Pilotphase starten: eine maximale Anzahl an Versuchen, ein Ausgabenlimit oder einen Review-Checkpoint. Ein Modell, das endlos weitersucht, kann Ihr Budget aufbrauchen, ohne dabei ein abnahmefähiges Ergebnis zu liefern.
Das Budget direkt an die Arbeit koppeln
Sharklys offizielle Produktbeschreibung vereint Tasks, Coding-Agenten, angebundene Computers und menschliche Reviews in einem einzigen Workspace. Die API-Konten oder Coding-Abonnements verbleiben dabei direkt in Ihren Tools konfiguriert; der Modellverbrauch wird über Ihre bestehenden Provider-Accounts abgerechnet.
Nutzen Sie diesen gemeinsamen Arbeitsverlauf, um Modell, Effort, Versuche, Nachweise (Evidence) und Review-Ergebnisse transparent festzuhalten. Bitten Sie den Agenten beispielsweise bei einer Migration, zusammen mit seinen Änderungen auch Testergebnisse und bekannte Einschränkungen zurückzugeben. Auf dieser Basis können Entwickler die Arbeit abnehmen oder Nachbesserungen anfordern. Lesen Sie unseren Leitfaden darüber, wie man KI-generierten Code anhand von Nachweisen auf Task-Ebene prüft, um eine praxisnahe Review-Struktur aufzubauen.
Für kleinere Fixes genügt ein einzelner Agent. Setzen Sie eine Crew ein, wenn getrennte Spezialisten und Koordination für die Aufgabe sinnvoll sind. Zusätzliche Agenten bedeuten jedoch mehr Aufrufe und Übergaben (Handoffs) – messen Sie also das Ergebnis, bevor Sie paralleles Arbeiten zum Standard machen. Der Leitfaden zu Mixed-Model-Crews geht näher auf diese Übergaben ein.
Starten Sie mit zehn repräsentativen Tasks. Erfassen Sie Gesamtausgaben, verstrichene Zeit, Abnahmequote und Review-Minuten für jede Konfiguration. Verbinden Sie einen Computer in Sharkly, weisen Sie eine klar abgegrenzte Task zu und fordern Sie die entsprechenden Nachweise bei der Fertigstellung an. Skalieren Sie erst, wenn Sie die Kosten pro abgenommenem Ergebnis fundiert begründen können.
FAQ
Ist der Fast-Modus von Claude Fable 5.2 doppelt so teuer?
Die offiziellen Tarife für Input- und Output-Token sind doppelt so hoch wie im Standardmodus. Die Gesamtkosten Ihres Workflows hängen jedoch zusätzlich von Token-Mengen, Caching, Tools und Retries ab.
Ändert ein mittlerer Effort (Medium) den Token-Preis?
Die Effort-Einstellung verändert das Verhalten des Modells und den Token-Verbrauch. Sie ersetzt die regulären Tarife für Input und Output nicht durch einen gesonderten Tarif.
Ist ein Abonnement-Budget dasselbe wie ein API-Budget?
Nein. Dieser Artikel kalkuliert die nutzungsbasierte Abrechnung über die API. Prüfen Sie die Konditionen und Limits Ihres jeweiligen Coding-Abonnements separat.
Kann Batch-Verarbeitung die Kosten senken?
Die Batch-API ist mit 4 $ pro Million Input-Token und 20 $ pro Million Output-Token für Fable gelistet. Nutzen Sie die asynchrone Verarbeitung überall dort, wo Workflows warten können; der Fast-Modus ist mit Batch nicht kombinierbar.
Bedeuten geringere Kosten pro Aufruf auch ein günstigeres Gesamtergebnis?
Nur wenn Retries, Abnahmequoten, Orchestrierung und Reviews diesen Vorteil nicht wieder zunichtemachen. Vergleichen Sie stets die Gesamtausgaben mit den abgenommenen Tasks unter denselben Akzeptanzkriterien.
Weitere Ressourcen
Für weiterführende Planungen zu Workflows empfehlen wir unsere Artikel über Kostenmanagement für Coding-Agenten und Review-Kapazitäten bei parallelen Agenten. Prüfen Sie Anthropics verlinkte Preis- und Effort-Dokumentation nochmals, bevor Sie diese Tarife in einem neuen Budget ansetzen.


