Am 30. Oktober 2026 tritt die Reduzierung des Codex-Limits für Pro-Abonnements in Kraft. Ab diesem Tag bietet der 200-Dollar-Tarif von ChatGPT Pro zum gleichen Preis ein geringeres Codex-Kontingent. Für Teams, die mehrere Codex-Agents parallel betreiben, wird die neue Obergrenze damit deutlich schneller erreicht sein als für Einzelentwickler. In diesem Leitfaden erfahren Sie, was sich genau ändert, für wen das bisherige Kontingent noch bis zum 29. Oktober gilt und mit welchen vier Strategien Ihre Arbeit reibungslos weiterläuft. Wenn Ihre Agents bereits auf einem gemeinsamen Board wie Sharkly organisiert sind, lassen sich die meisten der folgenden Lösungen über einfache Konfigurationsänderungen umsetzen – ganz ohne neue Workflows.
TL;DR: Was die Codex-Pro-Drosselung für Ihr Team bedeutet
Ab dem 30. Oktober 2026 wird das in bestehenden Pro-200-Abonnements enthaltene Nutzungskontingent reduziert; der Preis bleibt bei 200 US-Dollar pro Monat. Berichten Dritter zufolge sinkt das Kontingent von bisher dem 20-Fachen auf das 10-Fache des Plus-Tarifs. Um Arbeitsunterbrechungen zu vermeiden, empfiehlt es sich, Aufgaben auf mehrere Runtimes zu verteilen, Spitzen über API-Schlüssel oder Credits abzufedern, Routinearbeiten an günstigere Modelle zu delegieren und transparent zu erfassen, welche Aufgaben das Kontingent verbrauchen.
Was sich am 30. Oktober ändert
Auf OpenAIs Hilfeseite About ChatGPT Pro tiers werden drei monatliche Pro-Tarife sowie die Änderungen für bestehende Pro-200-Abonnements beschrieben.
| Vor dem 30. Oktober | Ab dem 30. Oktober | |
|---|---|---|
| Pro-200-Preis | 200 $ / Monat | 200 $ / Monat |
| Pro-200-Codex-Kontingent | Bisheriges Kontingent (laut Berichten 20x Plus) | „Geringeres enthaltenes Nutzungskontingent“ (laut Berichten 10x Plus) |
| Pro 100 | 100 $ / Monat | Keine Änderung angekündigt |
| Pro 500 | 500 $ / Monat, inklusive Ultrafast | Keine Änderung angekündigt |
| Zusätzliche Nutzung | Credits nach Aufbrauchen des enthaltenen Kontingents | Credits nach Aufbrauchen des enthaltenen Kontingents |
OpenAIs Seite gibt zwar die Richtung der Änderung vor, nennt jedoch keinen genauen Multiplikator. Die Angaben zum 20-Fachen und 10-Fachen stammen aus unabhängigen Berichten über die Tarife Pro 100 und Pro 200, in denen auch darauf hingewiesen wird, dass OpenAI zum Zeitpunkt der Veröffentlichung noch keine aktualisierten Nachrichtenbereiche bekannt gegeben hatte. Betrachten Sie diesen Multiplikator daher vorerst als Richtwert und prüfen Sie Ihre individuellen Zahlen in ChatGPT unter „Settings“ (Einstellungen) und anschließend „Usage“ (Nutzung).
Für wen gilt der Bestandsschutz bis zum 29. Oktober?
Sie behalten das bisherige Kontingent bis einschließlich 29. Oktober 2026, falls Sie zu einem beliebigen Zeitpunkt zwischen dem 22. September 2026 und dem 29. September 2026 um 10:00 Uhr pazifischer Zeit (PT) ein aktives Pro-200-Abonnement hatten. Nach diesem Stichtag wird das Abonnement auf das geringere Kontingent umgestellt. Neue Pro-200-Abonnements außerhalb dieses Zeitfensters starten direkt mit dem reduzierten Kontingent. Laut OpenAI werden ausschließlich betroffene Nutzer per E-Mail benachrichtigt.
Warum die Codex-Drosselung Teams härter trifft als Einzelnutzer
Ein einzelner Entwickler führt jeweils eine Codex-Sitzung aus und spürt das Limit allenfalls an einem etwas ruhigeren Freitagnachmittag. Ein Team, das parallele Codex-Agents einsetzt, verbraucht dasselbe Wochenkontingent jedoch von mehreren Seiten gleichzeitig – wodurch eine halbierte Obergrenze schon nach wenigen Tagen erreicht ist und nicht erst gegen Ende der Woche.
Drei Faktoren verschärfen die Situation zusätzlich:
- Parallele Ausführungen. Wenn fünf Agents an fünf Aufgaben arbeiten, verbrauchen sie das gemeinsame Kontingent fünfmal so schnell.
- Fast Mode. Laut OpenAI beansprucht der Fast Mode das enthaltene Nutzungskontingent 2,5-mal schneller als der Standardmodus desselben Modells.
- Fehlende Kostenzuordnung. Wenn ein einziges Abonnement zahlreiche Aufgaben speist, weiß niemand, welche Aufgabe das Budget aufgezehrt hat – bis das Limit plötzlich erreicht ist.
Einen Umweg über den Kundenservice gibt es nicht: OpenAI stellt klar, dass der Support ChatGPT- oder Codex-Limits nicht zurücksetzen kann.
Vier Strategien, wie Coding-Agents produktiv bleiben
Keine dieser Lösungen verlangt, dass Sie auf Codex verzichten. Sie verändern lediglich, wo eine Aufgabe ausgeführt wird und welche Kosten dabei anfallen.
1. Aufgaben auf mehrere Runtimes verteilen
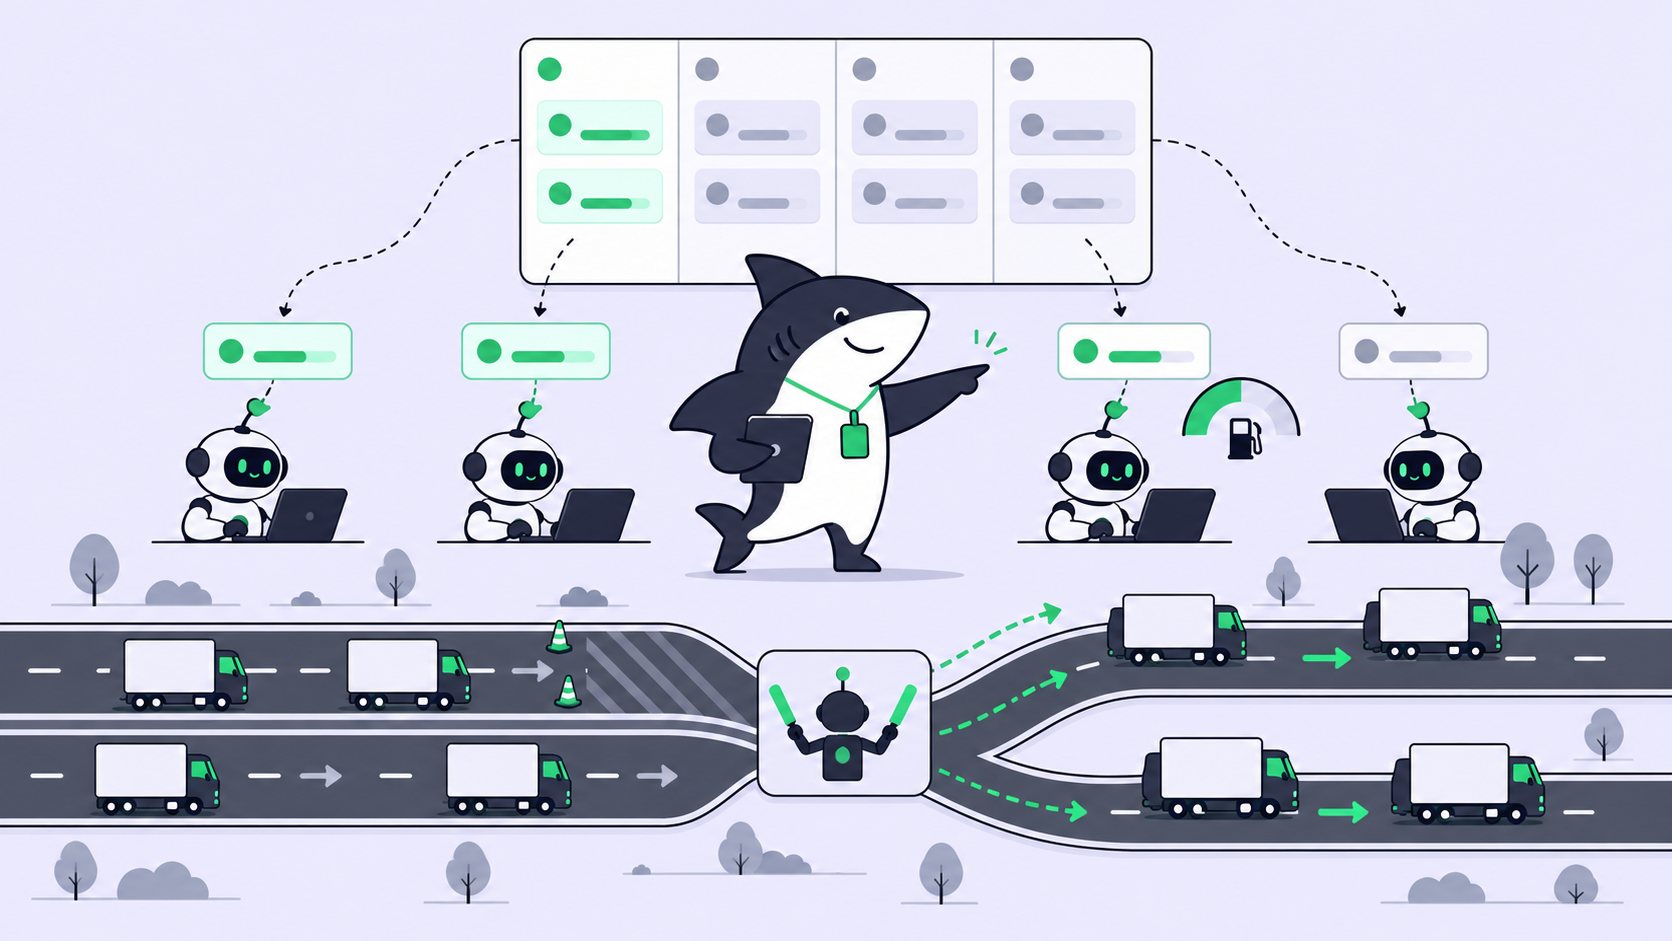
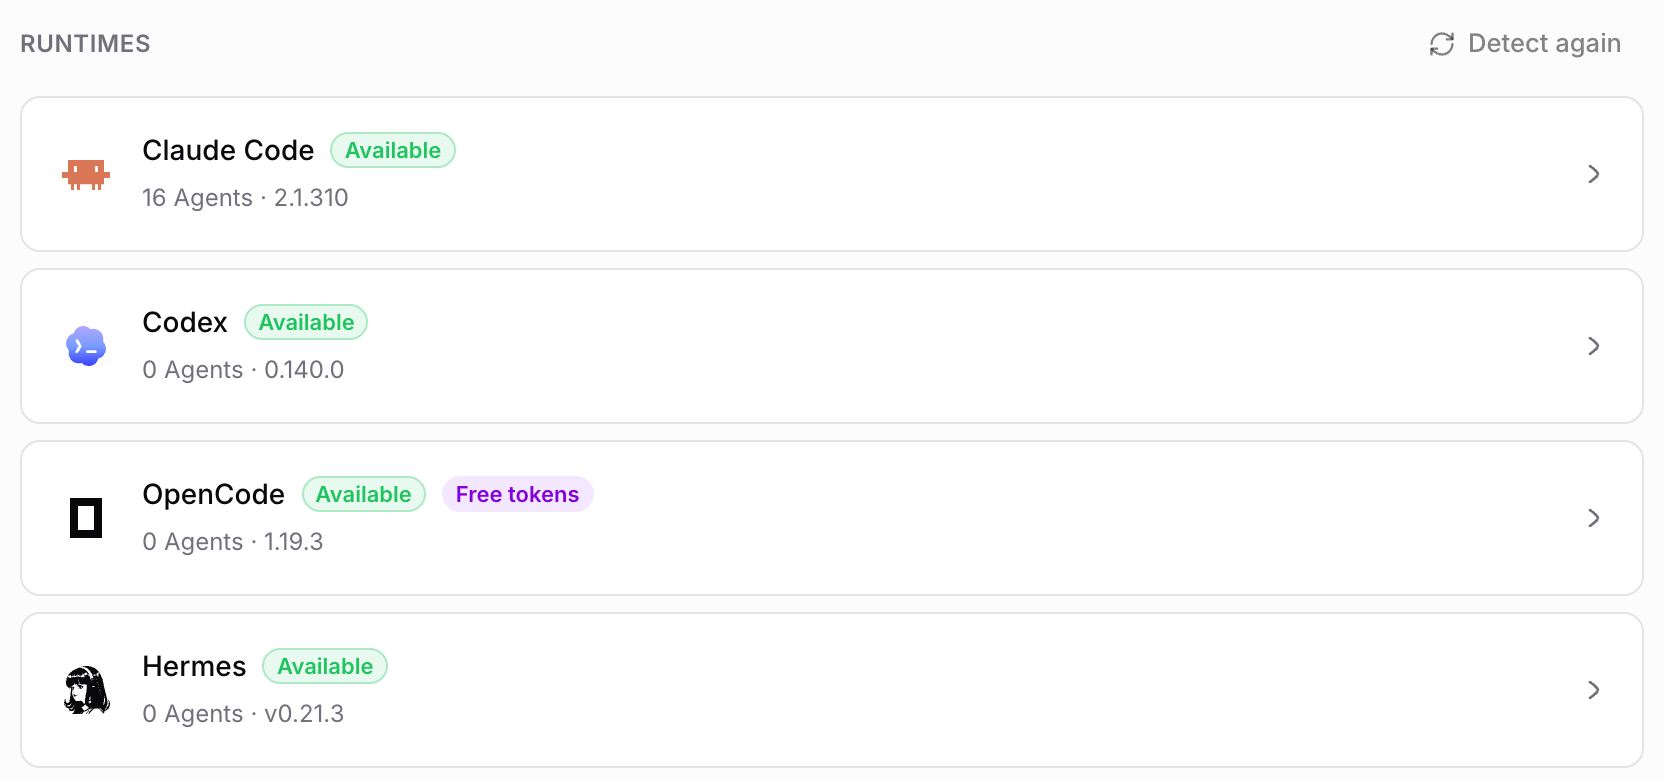
Codex ist nur einer von mehreren Coding-Agents, die Ihr Team einsetzen kann. Claude Code, Gemini und OpenCode bewältigen ähnliche Aufgaben mit eigenen Tarifen und Kontingenten. Teilen Sie die Warteschlange nach Aufgabentyp auf: Weisen Sie Refactorings einem Agent zu und das Schreiben von Tests einem anderen, damit ein einzelnes Limit niemals das gesamte Board lahmlegt. Unser Leitfaden zur gemeinsamen Nutzung von Claude Code und Codex auf einer Codebase erklärt die Einrichtung Schritt für Schritt.
2. Kontingentüberschreitungen über API-Schlüssel oder Credits abfangen
In berechtigten Tarifen ermöglicht OpenAI den Zukauf von Credits, die greifen, sobald das Inklusivkontingent erschöpft ist – konfigurierbar in ChatGPT unter „Settings“ > „Usage“ oder in Codex unter „Usage and Billing“. Die andere Option ist ein API-Schlüssel mit tokenbasierter Abrechnung. Legen Sie in jedem Fall vorab fest, welche Aufgaben in die kostenpflichtige Nutzung überlaufen dürfen. So wird das Abfangen von Spitzen zu einer kontrollierten Richtlinie statt zu einer bösen Überraschung auf der Monatsrechnung. Unser BYOK-Leitfaden erklärt, wie das Prinzip „Bring Your Own Key“ auf einer Agent-Plattform funktioniert.
3. Routineaufgaben an günstigere Modelle delegieren
Nicht jede Aufgabe erfordert das Spitzenmodell. Aktualisierungen von Abhängigkeiten, Linting-Korrekturen oder das Verfassen von Docstrings lassen sich problemlos mit schlankeren Modellen erledigen und kosten pro Nachricht deutlich weniger. Reservieren Sie das leistungsstärkste Modell für Aufgaben, bei denen komplexe logische Schlüsse den entscheidenden Unterschied machen, und deaktivieren Sie den Fast Mode für alle Vorgänge, bei denen kein Mensch unmittelbar auf das Ergebnis wartet.
4. Verbrauch pro Aufgabe überwachen, nicht nur pro Monat
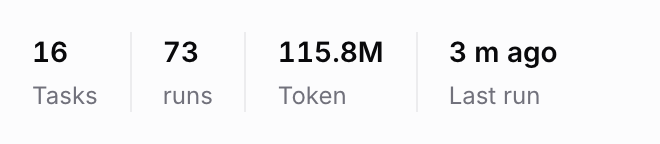
Das Nutzungslimit ist zwar eine monatliche oder wöchentliche Kennzahl, die operativen Entscheidungen fallen jedoch auf Aufgabenebene. Wenn jeder Durchlauf einer bestimmten Aufgabe zugeordnet ist, lässt sich schnell erkennen, ob etwa ein unzuverlässiger Integrationstest ein Drittel des Wochenbudgets verschlungen hat – sodass Sie gezielt dieses Problem beheben können, anstatt pauschal alle Ressourcen zu drosseln. In Sharkly zeigt der Header jedes Agents die Anzahl der Aufgaben, die Durchläufe sowie die verbrauchten Tokens an. Dadurch fallen ressourcenintensive Agents auf, lange bevor das Limit erreicht wird.
Wie Sharkly Teams mit unterschiedlichen Runtimes auf einem Board vereint
Sharkly agiert als übergeordnete Schicht über Ihren Coding-Agents. Die Plattform ersetzt Codex nicht, sondern orchestriert die Arbeit rund um Codex und jede andere Runtime, die Ihr Team verwendet.
So lassen sich die vier Lösungsansätze in Sharkly abbilden:
- Ein zentrales Board, mehrere Runtimes. Ein Agent in Sharkly läuft über eine Runtime auf einem angebundenen Computer. Zu den unterstützten Runtimes zählen unter anderem Claude Code, Codex, Gemini, OpenCode, OpenClaw und Hermes. Sobald eine Runtime ihr Limit erreicht, weisen Sie die Aufgabe einfach einem Agent auf einer anderen Runtime zu – der bisherige Verlauf bleibt dabei vollständig an der Aufgabe erhalten.
- Eigenes Abonnement nutzen (BYOS). Sharkly verkauft keine Tokens. Ein Durchlauf wird direkt über den Claude-Code-, Codex- oder API-Tarif abgerechnet, der in der Runtime hinterlegt ist; Ausweichschlüssel werden somit direkt im jeweiligen Tool konfiguriert.
- Modellauswahl verbleibt in der Runtime. Ein Agent greift standardmäßig auf das Modell seiner Runtime zurück. Um Routineaufgaben an ein schlankeres Modell zu übergeben, passen Sie das Modell einfach in der Tool-Konfiguration der Runtime oder des Computers an.
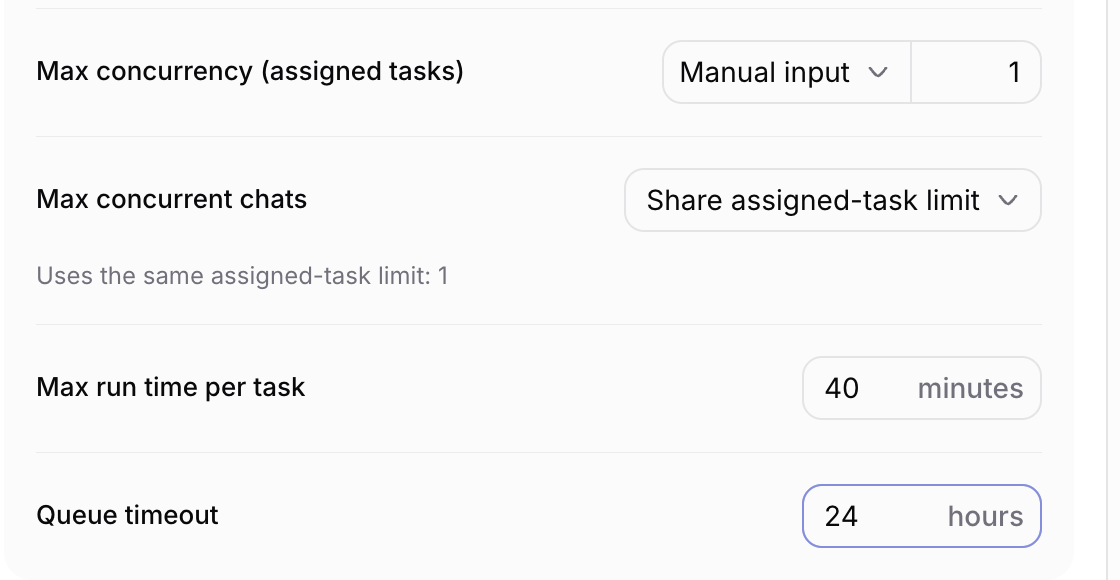
- Parallelitätsgrenzen pro Agent. In den Run-Settings eines Agents lassen sich die maximale Parallelität für zugewiesene Aufgaben, die maximale Laufzeit pro Aufgabe und die Verweildauer in der Warteschlange definieren. Wenn Sie das Limit Ihres Codex-Agents nach dem 30. Oktober reduzieren, verbleiben nachfolgende Aufgaben in der Warteschlange, anstatt das Kontingent vorzeitig aufzubrauchen.
- Jeder Durchlauf einer Aufgabe zugeordnet. Durchläufe, Ausführungsprotokolle und Ergebnisse sind direkt mit der jeweiligen Aufgabe verknüpft. Zudem enthält jeder Tarif ein Verbrauchs-Dashboard, mit dem Sie jederzeit nachvollziehen können, wofür das Kontingent eingesetzt wurde.
Sie können eine einzelne Runtime auch direkt über das Terminal überprüfen:
sharkly computer list
sharkly computer usage <computer-id> <runtime-id>
sharkly computer activity <computer-id> <runtime-id>
Wenn ein Durchlauf das Limit erreicht, unterscheidet die Sharkly-Dokumentation zwischen zwei Fehlerarten: Ein HTTP-Status 429 kann entweder ein Rate-Limit (Frequenzbegrenzung) oder ein erschöpftes Kontingent (Quota) bedeuten. Da OpenAI beides häufig pauschal als Rate-Limit ausweist, lohnt sich ein Blick auf error.code in den Fehlerdetails. Ein erneuter Versuch bei erschöpftem Kontingent ist zwecklos; wiederholen Sie den Vorgang erst, wenn neues Kontingent verfügbar ist oder ein anderes Konto eingerichtet wurde.
Sharkly ist für Organisationen mit bis zu 5 Personen derzeit kostenlos, und Agents, Crews, Computers sowie Runtimes belegen keine separaten Benutzerlizenzen (Seats). Details zum Team-Tarif finden Sie auf der Preisseite.
Was Sie vermeiden sollten
Teilen Sie kein gemeinsames Pro-Konto unter mehreren Entwicklern. Auf OpenAIs Pro-Seite wird ausdrücklich darauf hingewiesen, dass die Weitergabe von Zugangsdaten und der Weiterverkauf von Zugängen untersagt sind und bei Missbrauch Kontosperrungen drohen. Weitere Details finden Sie in den OpenAI-Nutzungsbedingungen. Jeder Entwickler behält sein eigenes Abonnement; Sharkly koordiniert die Arbeitsabläufe, nicht die Logins. Unser Beitrag über die produktive Nutzung von Codex im Team geht näher auf diesen Aufbau ein.
Erhöhen Sie nicht die Parallelität, um dem Reset zuvorzukommen. Mehr parallele Durchläufe leeren lediglich das Kontingent schneller – sie führen nicht dazu, dass mehr Arbeit erledigt wird.
Kalkulieren Sie nicht mit dem alten Faktor. Ermitteln Sie nach dem 30. Oktober Ihren tatsächlichen wöchentlichen Verbrauch neu, bevor Sie sich für Pro 100 mit zusätzlichen Credits, Pro 200 oder Pro 500 entscheiden.
Alternativen, wenn Codex allein das Arbeitsaufkommen nicht mehr bewältigt
Reicht das neue Kontingent nicht aus, vergleichen Sie die Möglichkeiten in unserem Überblick über kostenlose Alternativen zu Codex, Cursor und Claude Code und prüfen Sie, ob Codex in kleineren Tarifen kostenlos verfügbar ist. Falls Cloud-Aufgaben den Großteil Ihres Verbrauchs ausmachen, erklärt unser Artikel Codex Cloud im Vergleich zu eigenen Computern, wo Ausführungen stattfinden und welche Unterschiede sich daraus ergeben.
Praxisbeispiele zur Veranschaulichung
- Drei-Personen-Startup. Zwei Entwickler nutzen Pro 200, einer Claude Code. Feature-Entwicklungen laufen über Codex, Test- und Dokumentationsaufgaben übernimmt Claude Code, und die Parallelität des Codex-Agents wird von vier auf zwei reduziert.
- Plattform-Team. Codex wird für Reviews eingesetzt, während für nächtliche Batch-Fixes ein API-Schlüssel dient. Überlauf-Aufgaben werden gelabelt, sodass die API-Ausgaben eindeutig benannten Arbeitspaketen zugeordnet werden können.
- Solo-Gründer. Ein einzelnes Pro-200-Abonnement, standardmäßig deaktivierter Fast Mode und eine wöchentliche Auswertung, welche Aufgaben das meiste Budget beansprucht haben.
Fazit
Der Preis für Pro 200 bleibt unverändert, das Kontingent sinkt. Für Teams lautet die passende Antwort: intelligentes Routing. Setzen Sie auf mehrere Runtimes, definieren Sie klare Ausweichpfade für Lastspitzen, nutzen Sie schlankere Modelle für Standardaufgaben und ordnen Sie den Verbrauch transparent einzelnen Aufgaben zu. Binden Sie einen Computer an und führen Sie Ihre Codex- und Claude-Code-Agents auf einem gemeinsamen Board bei Sharkly zusammen – und passen Sie die Parallelität Ihres Codex-Agents rechtzeitig vor dem 30. Oktober an.
FAQ
Wann tritt die Limit-Reduzierung für Codex Pro in Kraft?
Am 30. Oktober 2026. Pro-200-Abonnenten mit Bestandsschutz behalten ihr bisheriges Kontingent bis zum 29. Oktober 2026 und werden danach auf das niedrigere Kontingent umgestellt.
Ändert sich der Preis für ChatGPT Pro (200 $)?
Nein. Laut OpenAI bleibt der Abopreis auch nach der Umstellung auf das geringere Kontingent bei 200 US-Dollar pro Monat.
Wird das neue Codex-Kontingent exakt halbiert?
Berichten zufolge wird das Kontingent von 20x Plus auf 10x Plus gesenkt. Auf OpenAIs Hilfeseite ist lediglich von einem „geringeren enthaltenen Nutzungskontingent“ ohne Nennung eines genauen Faktors die Rede – prüfen Sie daher am besten Ihre eigene Nutzungsseite.
Kann der OpenAI-Support mein Codex-Limit zurücksetzen?
Nein. Laut OpenAI kann der Support weder ChatGPT- noch Codex-Limits zurücksetzen; unberechtigt verbuchte Nutzung kann jedoch überprüft werden.
Kann mein Team ein gemeinsames Pro-Abonnement nutzen?
Nein. OpenAI verbietet das Teilen von Kontozugangsdaten. Richten Sie für jeden Entwickler ein eigenes Abonnement ein und koordinieren Sie die Aufgaben zentral an einem Ort.
Was passiert, wenn das Codex-Kontingent mitten in einer Aufgabe aufgebraucht ist?
Sofern Ihr Tarif dies unterstützt, können Sie zusätzliche Credits erwerben, auf den nächsten Reset warten oder die Aufgabe an einen Agent auf einer anderen Runtime übergeben.