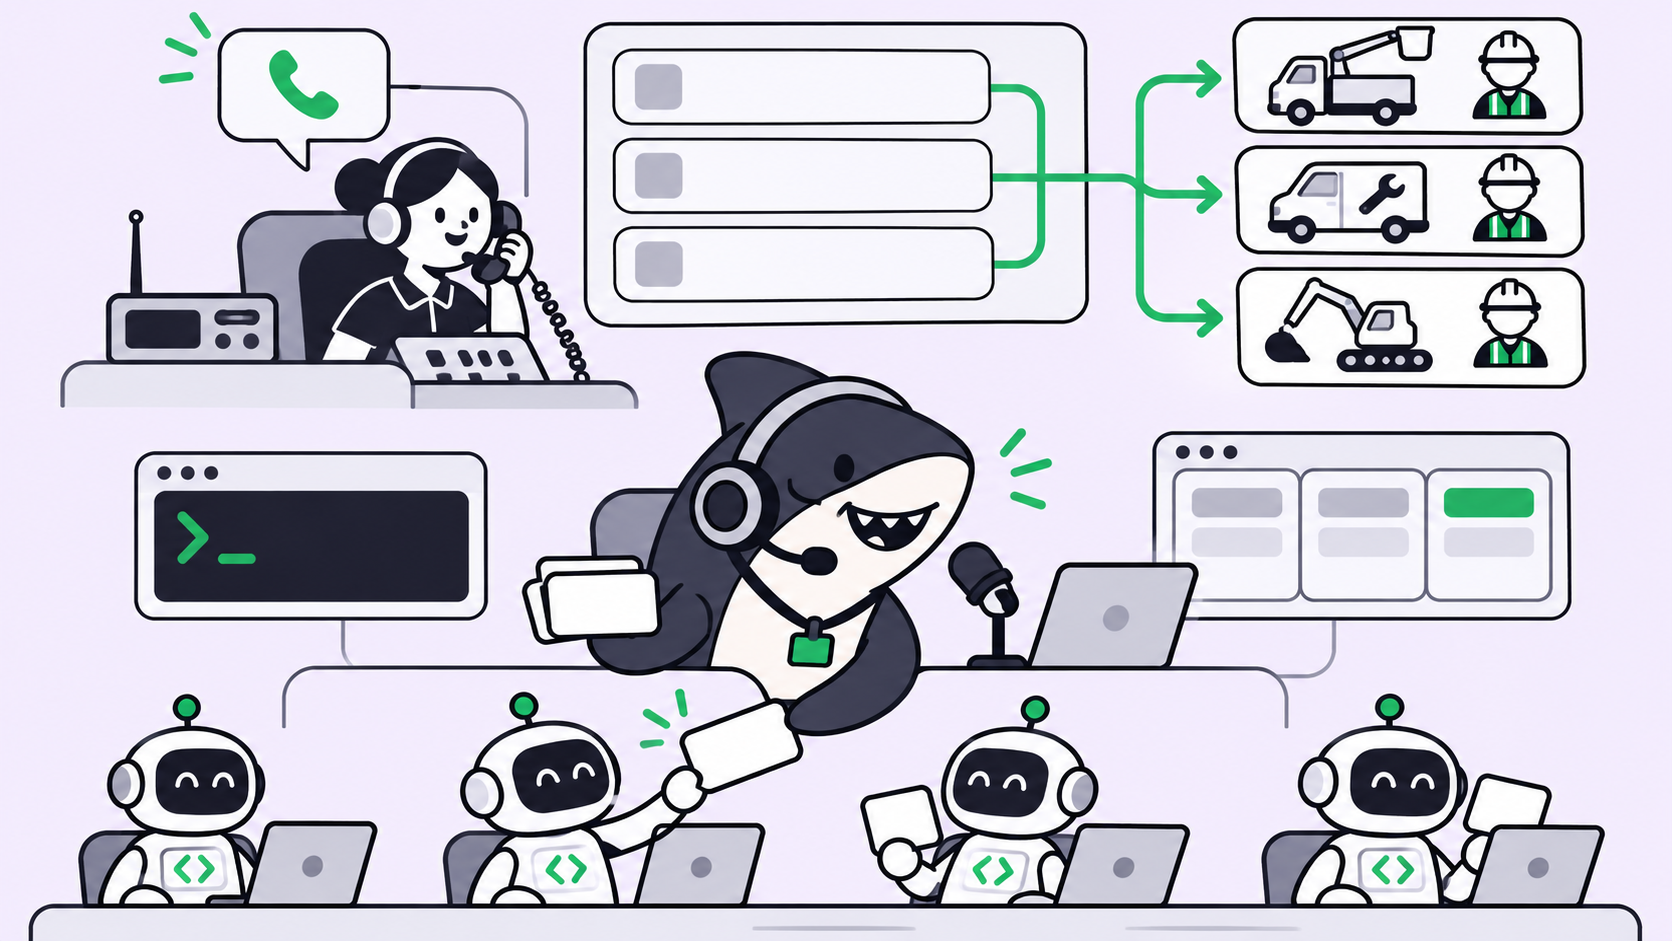
TL;DR: Wenn Sie Ihrem KI-Agenten eine Stimme geben möchten, schalten Sie OpenAIs GPT-Live-1.1 als Voice-Frontend vor ihn und lassen Sie die eigentliche Arbeit bei den Agenten, die Sie bereits betreiben. GPT-Live hört zu, während es spricht, und übergibt Reasoning- und Tool-Aufrufe per Delegation an ein Backend. Im Client-Delegation-Modus fängt Ihre App jede Übergabe ab, startet über deren Webhook eine Sharkly Automation und spricht das Ergebnis zurück.
Was ist GPT-Live-1.1?
GPT-Live-1.1 ist OpenAIs Vollduplex-Sprachmodell für mehrsprachige Konversationen: Es kann zuhören, während es spricht, sodass Menschen es unterbrechen können, wie sie einen Kollegen unterbrechen. Es läuft auf dem Endpunkt v1/live/sessions, unterstützt Function Calling und Streaming und kann Reasoning und Tool-Nutzung an einen Backend-Agenten delegieren, statt diese Arbeit selbst zu erledigen.
Laut OpenAIs GPT-Live-1.1-Modellseite transkribiert es Sprache genauer als GPT-Live-1 und hält über Sprachen hinweg einen konsistenteren Akzent und eine konsistentere Stimme bei. Ein- und Ausgabe sind Audio und Text. Bilder nimmt es nicht direkt entgegen.
Der Teil, der für Agent-Teams entscheidend ist, ist die Delegation. Das Sprachmodell ist zum Reden gebaut, nicht zum Ausführen eines 20-minütigen Refactorings. Es gibt diese Arbeit an etwas anderes ab und hält das Gespräch aufrecht, während es wartet.
Wenn Ihr Team Aufgaben bereits über ein gemeinsames Board an Coding-Agenten verteilt, kann Sharkly dieses „etwas andere“ sein. Der Rest dieses Guides zeigt die Verdrahtung.
Warum ein Voice-Agent ein Backend-Team braucht
Eine Sprachschnittstelle hat ein hartes Latenzbudget. Menschen erwarten eine Antwort innerhalb von etwa einer Sekunde, und längere Stille wirkt kaputt. Echte Agenten-Arbeit passt nicht in dieses Fenster: Das Lesen eines Repositorys, das Ausführen von Tests oder das Sichten einer Queue dauert Minuten.
Ein Voice-Agent, der alles selbst erledigen will, scheitert also auf eine von zwei Arten. Er antwortet entweder schnell und oberflächlich, oder er verstummt, während er nachdenkt. Beides ist nutzlos, wenn man auf dem Weg zu einem Meeting wissen möchte, ob die nächtlichen Agent-Läufe durchgegangen sind.
Die Lösung ist eine Aufteilung, die Sie für Text vielleicht bereits nutzen: ein schnelles Frontend, das die Konversation führt, und ein langsamereres Backend, das die Arbeit macht. GPT-Live baut diese Aufteilung direkt in die API ein. Wenn Sie unseren Beitrag zu Agent-zu-Agent- und Agent-zu-Mensch-Übergaben gelesen haben: Es ist dasselbe Muster – nur mit Mikrofon.
So funktioniert die GPT-Live-Delegation
GPT-Live hat zwei Delegationsmodi, die Sie beim Erstellen der Session wählen. Um den Modus zu wechseln, starten Sie eine neue Session.
| Responses-Delegation | Client-Delegation | |
|---|---|---|
| Wer betreibt das Backend | OpenAI, über die Responses API | Ihre Anwendung |
| Konfiguration | delegation.type: "responses" plus model, instructions, tools |
delegation.type: "client" |
| Backend-Modell | Eines, das Sie konfigurieren, z. B. gpt-6-luna |
Alles, was Sie aufrufen können |
| Rückgabe der Ergebnisse | Wird für Sie übernommen | session.commentary.append oder session.thinking.append |
| Geeignet für | Lookups und Tool-Aufrufe, die OpenAI ausführen kann | Arbeit, die in Ihren eigenen Systemen liegt |
Die Responses-Delegation ist der kurze Weg. Sie benennen ein Backend-Modell, und OpenAI führt es mit den von Ihnen gelisteten Tools aus. Der Delegation-Guide empfiehlt, mit gpt-6-luna zu starten und für komplexere Backend-Aufgaben gpt-6-sol zu testen.
Die Client-Delegation ist der Weg für Agenten, die Sie bereits betreiben. Wenn das Sprachmodell entscheidet, dass es Hilfe braucht, erhält Ihre App ein session.delegation.created-Event mit einer Delegation-ID. Dieses Event enthält nicht die Worte des Nutzers, also rekonstruiert Ihre App die Anfrage aus den Transkript-Events und ihrem eigenen Zustand. Ist die Arbeit erledigt, senden Sie das Ergebnis mit derselben Delegation-ID zurück, und GPT-Live gibt es laut wieder.
Das Muster: GPT-Live spricht, Ihr Agenten-Team arbeitet
So sieht ein Voice-Frontend auf Basis von Sharkly aus. Sharkly sitzt über Ihren Coding-Agenten (Claude Code, Codex, Gemini CLI und andere) als die Ebene, auf der Arbeit zugewiesen, auf verbundenen Computern ausgeführt und geprüft wird. Das Sprachmodell berührt nie ein Repository. Es fordert Arbeit an, und das Board hält sie fest.
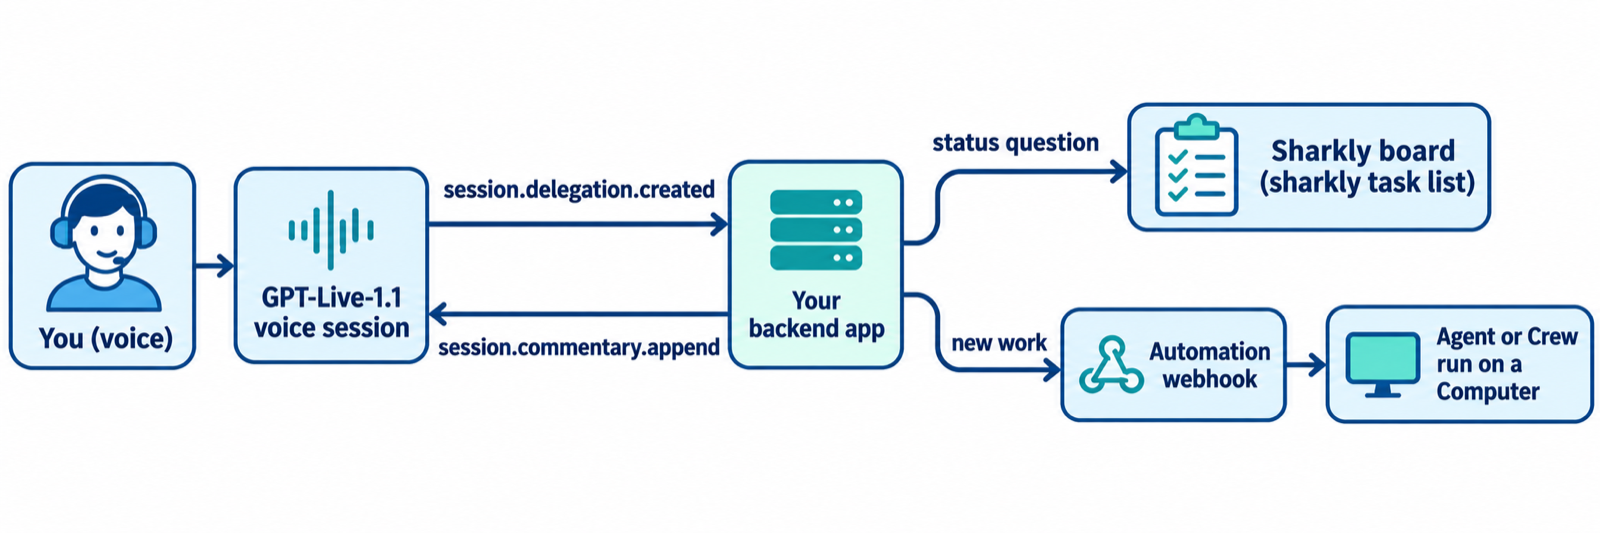
Drei Anfragetypen decken das meiste ab, was Menschen einen Voice-Agenten über ihr Agenten-Team fragen:
- Statusfragen („Ist der nächtliche Testlauf durchgegangen?“). Ihr Backend liest das Board mit der
sharkly-CLI und antwortet in Sekunden. - Neue Arbeit („Lass einen Agenten den instabilen Login-Test ansehen“). Ihr Backend ruft einen Sharkly-Automation-Webhook auf, und ein Agent oder eine Crew startet einen Run.
- Entscheidungen („Mergen“). Ihr Backend lehnt ab und sagt der Person, wo sie prüfen soll. Sprache ist ein schlechter Ort, um Änderungen freizugeben.
Diese dritte Regel ist eine Designentscheidung, keine Einschränkung eines der Produkte. Ein gesprochenes „Ja“ ist leicht falsch zu hören und schwer nachvollziehbar. Halten Sie Freigaben dort, wo die Belege liegen – unser Guide zu Coding-Agenten mit Human-in-the-Loop geht darauf ausführlich ein.
Ihrem KI-Agenten eine Stimme geben: Schritt-für-Schritt-Einrichtung
Schritt 1: Automation und Webhook-Trigger erstellen
In Sharkly ist eine Automation eine Space-eigene Definition für wiederholbare Agent- oder Crew-Arbeit: Anweisungen, ein Assignee, Trigger und Run-Historie. Ein Webhook-Trigger erzeugt eine geheime URL, die einen POST-Request von einem externen Dienst entgegennimmt. Die Automations-Dokumentation weist darauf hin, dass die vollständige URL nur einmal angezeigt wird – beim Erstellen oder Neuerzeugen des Triggers –, also speichern Sie sie sofort als Secret.
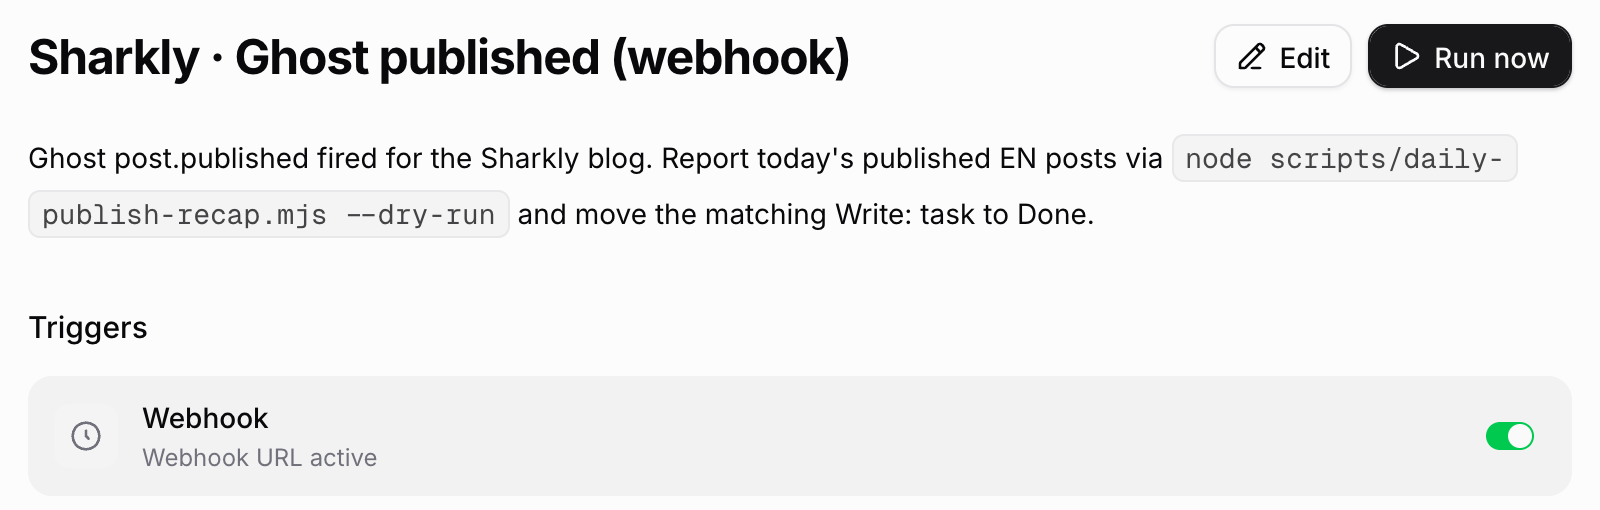
Schreiben Sie die Anweisungen so, dass der Agent die Anfrage aus dem Trigger-Payload liest und sein Ergebnis als Aufgabenkommentar festhält. Legen Sie fest, was er ändern darf und wann eine Person entscheiden muss. Testen Sie dann mit Run now den Agenten und seinen Computer, bevor Sie Voice-Traffic anbinden. Unser Walkthrough zu Automations in Sharkly zeigt weitere Trigger-Typen.
Schritt 2: GPT-Live-Session im Client-Modus erstellen
Ihre Session-Konfiguration benennt das Sprachmodell und aktiviert die Client-Delegation. Die Einstellung acknowledgement_delay_ms gibt Ihrer App Zeit, ein eigenes Update zu senden, bevor GPT-Live eine generische Bestätigung ausgibt.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI empfiehlt WebRTC für Audio in Browser-, Mobile- und Server-Apps, mit WebSockets als unterstützter Alternative. Der GPT-Live-Einstiegsleitfaden behandelt das Connection-Setup.
Schritt 3: Jede Delegation an Sharkly weiterleiten
Wenn session.delegation.created eintrifft, speichern Sie die Delegation-ID, rekonstruieren die Anfrage aus dem Transkript und entscheiden, welchen Weg sie nimmt. Dieser Node-Sketch sendet neue Arbeit an den Automation-Webhook und beantwortet Statusfragen aus dem Board.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Achten Sie darauf, was die Voice-Antwort verspricht. Sie sagt, dass ein Run gestartet wurde – nicht, dass die Arbeit erledigt ist. OpenAIs Guide macht denselben Punkt am Beispiel von Buchungen: Senden Sie das Ergebnis erst, nachdem die Aktion erfolgreich war.
Schritt 4: Ergebnisse auf dem Board lesen, nicht nach Gehör
Agent-Runs dauern Minuten, und eine Voice-Session kann enden, bevor die Arbeit abgeschlossen ist. Das Board ist also der Datensatz. Der Agent postet sein Ergebnis an der Aufgabe, die Run-Historie zeigt Trigger-Payload und Output, und eine Person prüft es dort. Wenn Sie das nächste Mal fragen „Was ist mit dem instabilen Test passiert?“, liest der Status-Pfad dieses Ergebnis vor.
Kosten und Limits, mit denen Sie planen sollten
| Posten | GPT-Live-1.1 (OpenAI-Dokumentation, 2026-11-20) |
|---|---|
| Endpunkt | v1/live/sessions |
| Aktive Session | 0,05 $ pro Minute |
| Standby | 0,02 $ pro Minute (WebRTC-Sessions, während die Inferenz pausiert) |
| Abrechnung | Nach Dauer; OpenAIs Preisseite gibt an, dass GPT-Live pro Sekunde abrechnet |
| Gleichzeitige Sessions | Getrennte Limits von GPT-Live-1; siehe die Limits-Seite Ihrer Organisation |
| Backend-Aufrufe | Abgerechnet zu den normalen Preisen des konfigurierten Modells |
Ein 10-minütiger Standup-Check-in kostet 0,50 $ an Sprachzeit zum aktiven Tarif – vor allen Backend-Aufrufen. Zur Referenz: Die GPT-Live-1-Modellseite listet 50, 300 und 500 gleichzeitige Sessions auf den Tiers Build, Launch und Grow sowie keinen Zugang auf dem Free-Tier. GPT-Live-1.1 hat eigene Limits.
Agent-Runs auf Sharkly-Seite werden gegen den Claude-Code-, Codex- bzw. API-Plan abgerechnet, der bereits an jede Runtime gebunden ist. Sharkly verkauft keine Tokens. Wenn Sie Statusfragen an ein günstiges Backend-Modell weiterleiten, gelten unsere Hinweise zu GPT-6-Luna-Agenten in Sharkly direkt.
Guardrails, die sich vom ersten Tag an lohnen
- Unterbrechungen brechen die Arbeit nicht ab. OpenAIs Guide stellt klar: Das Unterbrechen des gesprochenen Gesprächs stoppt keine Backend-Arbeit. Wenn jemand „egal“ sagt, muss Ihr Backend das behandeln – sonst läuft der Run weiter.
- Behandeln Sie die Webhook-URL wie ein Passwort. Sharklys Dokumentation beschreibt sie standardmäßig als Bearer-Secret. Fügen Sie ein Signing-Secret hinzu und erzeugen Sie die URL neu, falls sie durchsickert.
- Begrenzen Sie die Automation. Beginnen Sie mit beobachtbarer und umkehrbarer Arbeit, wie die Sharkly-Dokumentation empfiehlt, und prüfen Sie mehrere Runs, bevor Sie den Umfang erweitern.
- Halten Sie die Crew-Delegation innerhalb von Sharkly. Wenn eine Anfrage mehrere Agenten braucht, richten Sie den Webhook auf eine Sharkly Crew und lassen Sie deren Leader die Arbeit aufteilen.
Wann ein Voice-Frontend das falsche Werkzeug ist
Verzichten Sie darauf, wenn die Anfrage einen Diff, ein Log oder einen Screenshot braucht, um verständlich zu sein. Sprache kann Ihnen keinen fehlschlagenden Test zeigen. Sie ist auch der falsche Kanal für alles, was eine Freigabe braucht: Approvals, Deployments und Zugriffsänderungen gehören auf die Aufgabe, an der die Belege liegen.
Sprache bewährt sich bei schnellen Statusabfragen, beim Starten klar definierter Runs und in Momenten, in denen die Hände gebunden sind. Betrachten Sie es als Fernbedienung für Ihr Agenten-Board – nicht als Ersatz dafür.
Fazit
GPT-Live-1.1 übernimmt den Teil eines Voice-Agenten, der sich schwer selbst bauen lässt: Vollduplex-Konversation mit Unterbrechungen. Die Delegation gibt alles andere an ein Backend weiter. Schalten Sie Ihr bestehendes Agenten-Team hinter dieses Backend, und Sie können über Runs sprechen und neue laut starten – während jedes Ergebnis weiterhin auf einem Board landet, das eine Person prüft.
Ihr nächster Schritt: Erstellen Sie in Sharkly eine Automation mit Webhook-Trigger, testen Sie sie mit Run now und richten Sie dann eine GPT-Live-Session im Client-Modus darauf. Die Sharkly-Dokumentation behandelt Agents, Computer und Automations im Detail.
FAQ
Wie gebe ich meinem KI-Agenten eine Stimme?
Schalten Sie ein Sprachmodell wie GPT-Live-1.1 vor den Agenten und lassen Sie es delegieren. Das Sprachmodell übernimmt Zuhören und Sprechen, Ihr Backend führt den Agenten aus und gibt ein kurzes Ergebnis zurück, das das Sprachmodell vorliest.
Ist GPT-Live-1.1 in der API verfügbar?
Ja. OpenAI listet gpt-live-1.1 mit dem Endpunkt v1/live/sessions, Function Calling und Streaming. v1/realtime und v1/responses werden nicht direkt unterstützt.
Was kostet GPT-Live-1.1?
OpenAI listet 0,05 $ pro Minute für aktive Sessions und 0,02 $ pro Minute im Standby. Backend-Modellaufrufe über Delegation werden separat zu ihren normalen Preisen abgerechnet.
Was ist der Unterschied zwischen Responses-Delegation und Client-Delegation?
Bei der Responses-Delegation betreibt OpenAI ein von Ihnen konfiguriertes Backend-Modell. Bei der Client-Delegation empfängt Ihre App jede Anfrage und gibt Ergebnisse mit session.commentary.append oder session.thinking.append zurück.
Kann GPT-Live-1.1 Coding-Agenten direkt ausführen?
Nein. Es delegiert. Ihr Backend entscheidet, was ausgeführt wird – etwa indem es einen Sharkly-Automation-Webhook aufruft, der einen Agent- oder Crew-Run auf einem verbundenen Computer startet.
Was passiert, wenn ich den Voice-Agenten mitten in einer Aufgabe unterbreche?
Das Gespräch stoppt, die Backend-Arbeit jedoch nicht. Behandeln Sie Abbrüche in Ihrem Backend, etwa indem Sie den Run pausieren oder die Aufgabe kommentieren.