
La réponse se divise en deux, parce que la facture aussi. La ligne plateforme peut réellement être à zéro : Sharkly est gratuit pour les organisations de 5 personnes maximum et ne vend pas de tokens de modèles. La ligne modèles, elle, ne peut pas être à zéro pour un Crew qui continue de travailler pendant que vous faites autre chose. Sur les trois modèles livrés par les laboratoires le 22 septembre 2026, un seul dispose d'un accès gratuit : GPT-6 Luna pour les utilisateurs Free et Go dans l'application de bureau ChatGPT. Or une application de bureau, c'est un siège pour une personne, pas un identifiant qu'une exécution peut utiliser. Coordonner ne coûte rien, exécuter coûte quelques centimes, et ni l'un ni l'autre ne rend la relecture gratuite.
Le coût d'un Crew comporte deux lignes que l'on confond souvent en une seule : la ligne des sièges, pour la plateforme où le travail est assigné, suivi et accepté, et la ligne des tokens, pour le Runtime qui exécute. Elles évoluent indépendamment. La ligne des sièges est un prix publié que vous pouvez consulter dès aujourd'hui. La ligne des tokens est variable, elle dépend de vos propres comptes fournisseurs, et le 22 septembre 2026, elle a chuté brutalement.
TL;DR
La ligne des sièges de Sharkly est de 0 $ jusqu'à 5 personnes, puis de 7 $ par utilisateur et par mois en facturation annuelle au-delà, l'usage des modèles relevant du bring-your-own-key. Côté modèles, GPT-6 Luna est gratuit pour les utilisateurs Free et Go dans l'application de bureau ChatGPT, GPT-6 Sol ne l'est pas, et Claude Opus 5.5 n'est pas disponible du tout sur Claude Free. Un droit d'accès sur poste de travail ne peut pas lancer une exécution sans supervision. La voie réellement bon marché, c'est l'API : Luna à 0,10 $ et 0,50 $ par million de tokens, Sol à 2 $ et 10 $, et 90 % de remise sur les lectures d'entrée mises en cache. Rien de tout cela ne change la seule ligne qui n'a jamais eu d'offre gratuite : la personne qui accepte le travail.
La ligne des sièges : ce que « gratuit » signifie sur la plateforme
La tarification de Sharkly ne comporte qu'une variable : le nombre de personnes. L'offre Free est à 0 $ pour les organisations de 5 personnes maximum. L'offre Team est à 7 $ par utilisateur et par mois en facturation annuelle pour les organisations plus grandes. Le self-hosted est facturé au cas par cas. Free et Team correspondent au même produit : le plan ne conditionne donc pas l'accès aux fonctionnalités.
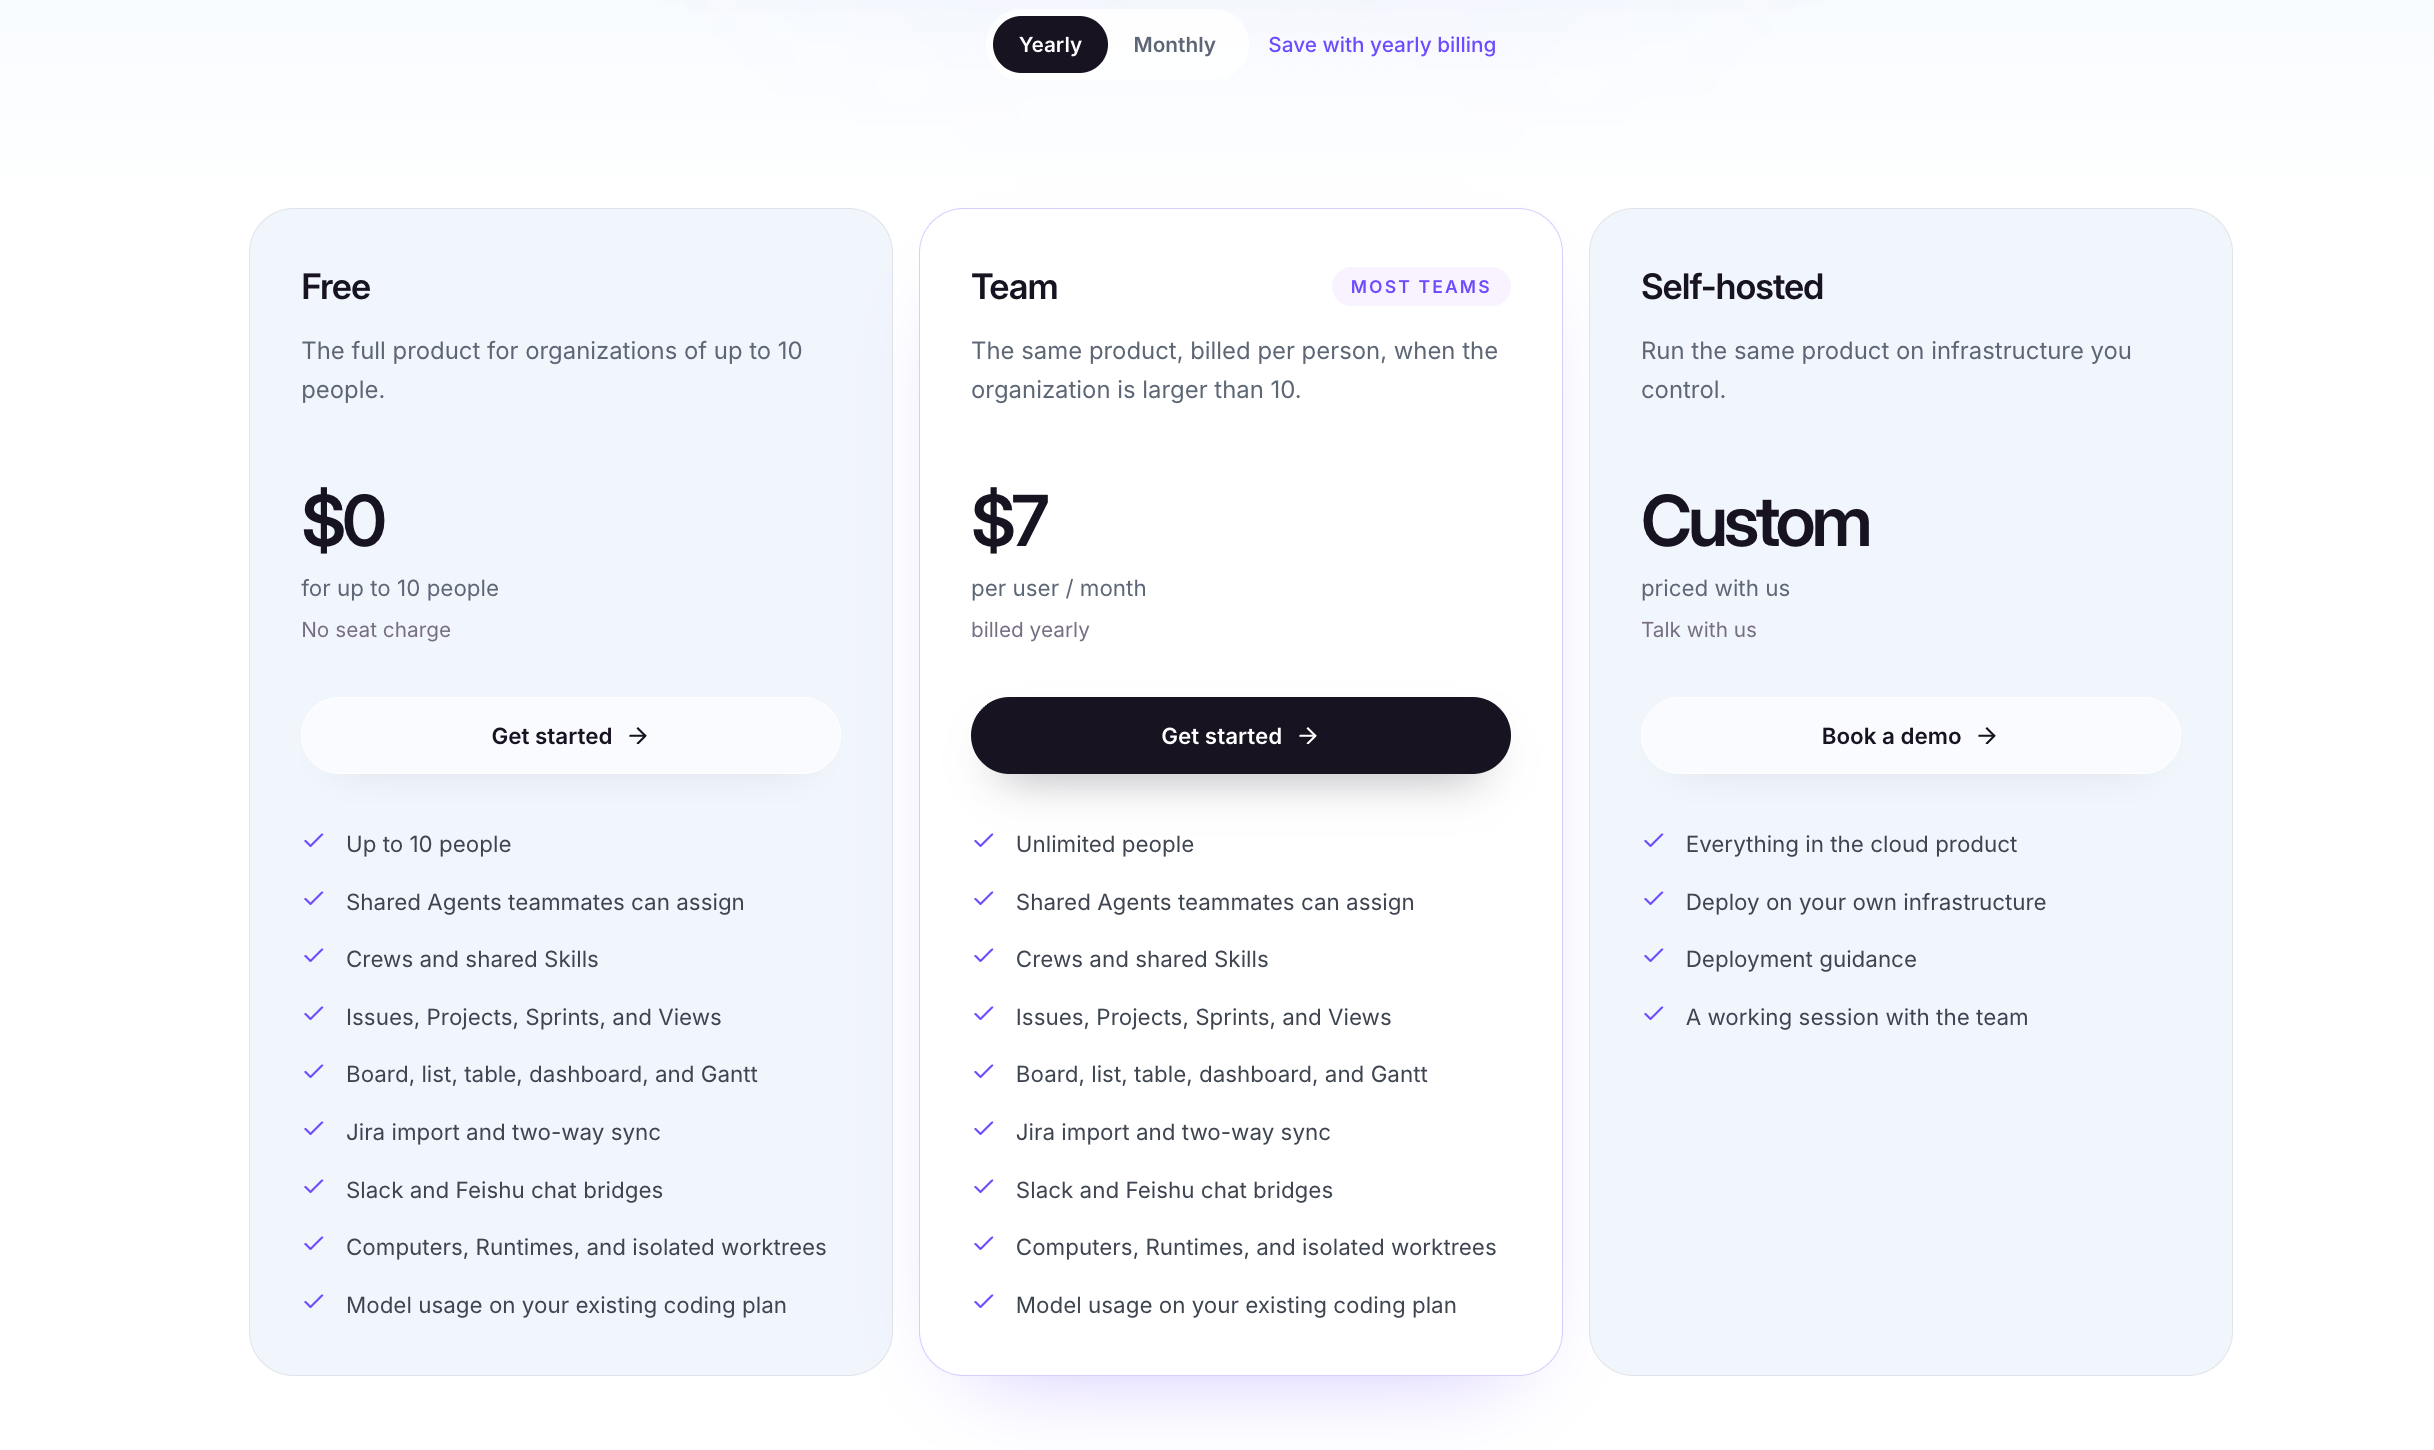
Le point qui compte pour un Crew : les invités, les Agents, les Crews, les Computers et les Runtimes n'occupent pas de siège. Un siège correspond à une personne dans l'organisation. Ajouter un sixième Agent, un deuxième Computer ou un troisième Runtime ne change rien à la ligne des sièges. Un sixième collègue, si.
Deux réserves, en toute honnêteté. Sharkly est gratuit aujourd'hui, et le montant de l'offre Team correspond au prix de siège publié : la formulation exacte est donc « gratuit pour le moment », et non « gratuit à vie ». Et Sharkly ne vend pas de tokens : une exécution est facturée sur le plan Claude Code, Codex ou API déjà associé au Runtime qui l'exécute. C'est pourquoi les deux lignes restent distinctes ici, et pourquoi aucun des éléments économiques sur les modèles ci-dessous ne dépend de la plateforme par laquelle vous passez. Mécanique des offres : la tarification Sharkly expliquée.
La ligne des tokens : quels nouveaux modèles sont accessibles sans rien payer
| Modèle | Accès gratuit | Ce que cet accès n'est pas | Entrée payante |
|---|---|---|---|
| GPT-6 Luna | Utilisateurs Free et Go, dans l'application de bureau ChatGPT | Pas encore dans Chat, et pas une clé API | API gpt-6-luna, 0,10 $ / 0,50 $ par million de tokens |
| GPT-6 Sol | Aucun | Réservé à Plus, Pro, Business, Enterprise et Edu, dans ChatGPT Work et Codex | API gpt-6-sol, 2 $ / 10 $ par million de tokens |
| Claude Opus 5.5 | Aucun. Claude Free embarque Sonnet et Haiku | Claude Code est inclus dans les offres payantes, pas dans Free | Pro à 17 $/mois en annuel (200 $ d'avance) ou 20 $ par mois ; Max à partir de 100 $/mois ; API claude-opus-5-5, 4 $ / 20 $ par million de tokens |
Deux réponses sur trois sont négatives, et la troisième est assortie d'une condition qui change tout.
Un droit d'accès sur application de bureau n'est pas une clé API
C'est la distinction que la plupart des comparatifs d'offres gratuites passent sous silence, et c'est elle qui détermine si un modèle gratuit est utile à un Crew.
Sharkly distingue les rôles : l'Agent définit la manière dont le travail doit être traité, le Computer fournit l'hôte, le Runtime exécute la session proprement dite, et la Task reste l'enregistrement partagé. Une exécution démarre lorsqu'une Task dotée d'un Agent prêt atteint un Computer disposant d'un Runtime disponible, et ce Runtime s'authentifie à l'aide de l'abonnement ou de la clé API configuré dans l'outil installé sur ce Computer.
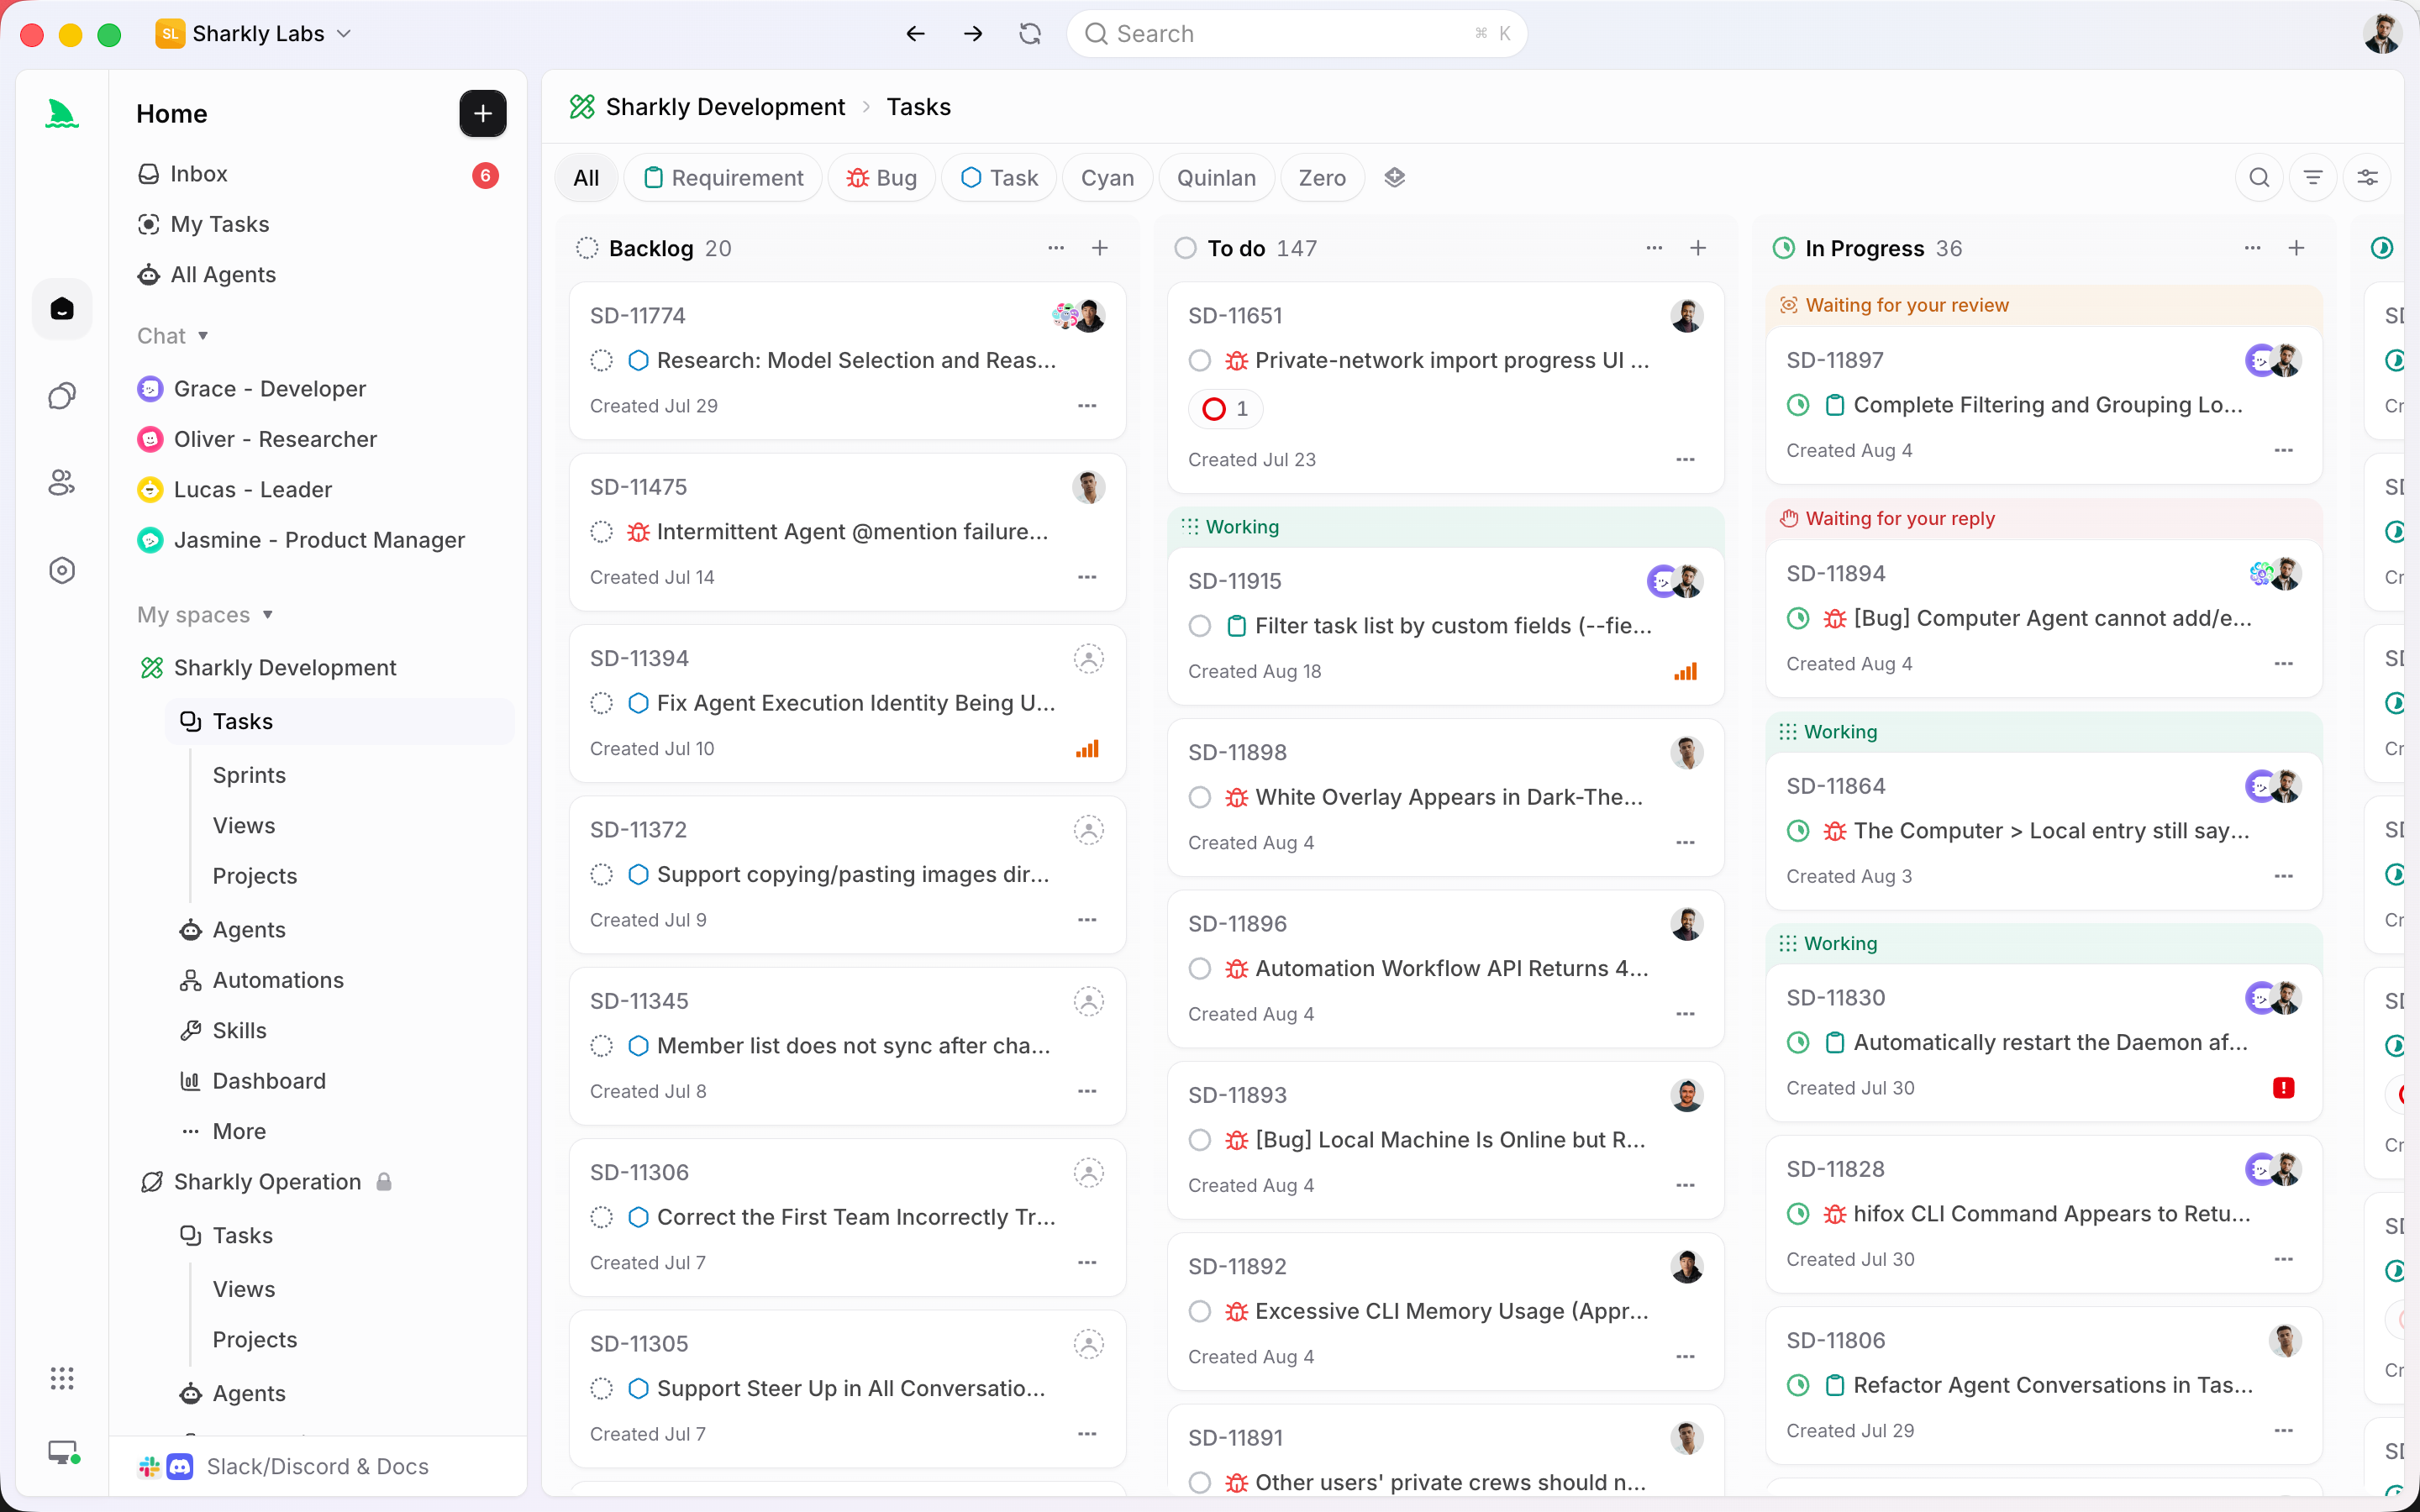
Un droit d'accès gratuit à ChatGPT sur poste de travail ne fait pas partie de ces identifiants. C'est une personne connectée à une application sur son propre ordinateur portable, en train de taper. Rien en lui ne se rattache à un Runtime, et rien en lui ne démarre pendant que son propriétaire dort. Un modèle gratuit dans une application de bureau vous donne un modèle à évaluer. Il ne donne pas à un Crew de quoi exécuter.
L'accès gratuit vaut quand même la peine d'être utilisé ; voici donc les deux cas de figure.
Recourez au droit d'accès gratuit sur poste de travail quand une personne est présente et que la question relève du jugement : la manière dont un modèle raisonne sur votre base de code, la solidité d'une approche avant d'y consacrer un Sprint, l'opportunité même d'intégrer ce modèle à votre règle de routage. C'est un véritable après-midi d'évaluation, sans frais.
Utilisez un abonnement payant ou une clé API quand l'exécution doit démarrer sans vous. Tasks en file d'attente, missions assignées pour la nuit, tout ce qu'un collègue déclenche pendant que vous êtes en réunion. Les exécutions qui se déroulent en votre absence ont besoin d'un identifiant, pas d'un droit d'accès.
Une remarque pour la planification : OpenAI indique que ces modèles ne sont pas encore disponibles dans Chat. Un accès gratuit qui n'existe que sur une seule interface aujourd'hui peut disparaître le mois prochain ; raison de plus pour formaliser votre règle de routage plutôt que de bâtir un workflow autour de l'offre qui se trouvait être gratuite ce trimestre.
La voie économique qui, elle, fait vraiment tourner un Crew
| Modèle du Runtime | Entrée / sortie par million de tokens | Levier de cache | Autres leviers |
|---|---|---|---|
gpt-6-luna |
0,10 $ / 0,50 $ | 90 % de remise sur les lectures d'entrée mises en cache | Meilleurs taux de succès du cache par défaut, tableau de bord du cache, outil de diagnostic |
gpt-6-sol |
2 $ / 10 $ | 90 % de remise sur les lectures d'entrée mises en cache | Points de rupture de cache explicites |
claude-opus-5-5 |
4 $ / 20 $ | Lectures en cache à 0,20 $, écritures de cache à 5 $ | API Batch à -50 % ; le mode rapide est à 8 $ / 40 $, donc à éviter |
OpenAI présente Sol et Luna comme 50 % moins chers que le tarif promotionnel de GPT-5.6. Le qualificatif vient d'OpenAI lui-même, et il compte : la comparaison porte sur un tarif promotionnel, pas sur un tarif catalogue.
Le cache reste de toute façon le levier le plus important. GPT-6 augmente les taux de succès par défaut, applique une remise de 90 % sur les lectures d'entrée mises en cache, fournit un tableau de bord du cache et un outil de diagnostic, et n'invalide plus le cache lorsque vous modifiez l'effort de raisonnement ou la disponibilité des outils. GitHub rapporte plus de 50 % de tokens de prompt en moins à retraiter sur des milliards de requêtes. Opus 5.5 lit l'entrée mise en cache à 0,20 $, contre 4 $ pour l'entrée standard. Pour un Crew qui relit le même dépôt toute la journée, c'est là que se joue la facture, pas sur le tarif affiché.
Ce que coûte réellement une semaine
OpenAI a publié un chiffre qui se traduit directement en budget : Sol en raisonnement extra high obtient 33,2 % sur AutomationBench 1.0.6, à 0,27 $ par tâche. D'après notre propre calcul, un Crew qui réalise 40 tâches de ce type en une semaine dépense environ 11 $ sur la ligne des modèles. Votre dépôt n'est pas AutomationBench et votre chiffre sera différent, mais à l'échelle d'une petite équipe, la ligne des modèles n'est plus qu'un détail négligeable face à une heure d'ingénieur.
Les comparaisons sous-jacentes : Sol en extra high surpasse Claude Opus 5 en raisonnement max pour 9 % du coût par tâche d'Opus 5, et Luna en max obtient 66,6 % sur DeepSWE 1.1 pour 93 % de moins par tâche qu'Opus 5. Une correction s'applique à l'ensemble. La référence d'OpenAI est partout Opus 5, car Anthropic a livré Opus 5.5 à 4 $ et 20 $ quelques heures après la publication de cet article, soit 20 % de moins que les 5 $ et 25 $ d'Opus 5 et 40 % moins cher à l'usage. Aucun des deux laboratoires n'a évalué le modèle actuel de l'autre : considérez donc les deux tableaux comme indicatifs et choisissez en fonction de l'usage de chaque Runtime, pas d'un classement.
Pour l'autre extrémité de l'échelle : OpenAI indique que la dépense médiane de ses propres chercheurs en agents de codage dépasse 600 $ par jour, avec un 90e percentile à 7 000 $. Rien n'empêche un Crew de dépenser autant, sinon une règle de routage écrite et un plafond convenu, ce qui relève d'une décision de management plutôt que d'une offre à choisir. Si les dépenses sont déjà réparties entre plusieurs outils, le suivi des coûts entre agents passe avant toute comparaison de prix.
Là où l'offre gratuite cesse d'aider
Additionnez les deux lignes à petite échelle et le total est réellement modeste : 0 $ de sièges jusqu'à 5 personnes, quelques dizaines de dollars de tokens par semaine sur les offres économiques. Aucune des deux lignes ne contient l'étape coûteuse.
Les Agents font la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. L'acceptation n'a ni offre gratuite, ni offre économique, ni remise, et elle évolue avec le nombre de personnes plutôt qu'avec les dollars. La relecture humaine est le facteur limitant, quel que soit le prix du Runtime. L'offre gratuite jusqu'à 5 personnes et les 0,10 $ par million de tokens d'entrée rendent économique le lancement de dix exécutions cet après-midi ; ils ne rendent pas moins cher la lecture de dix résultats ce soir. Ce que change la couche de management, ce n'est pas le prix d'une exécution mais l'endroit où elle atterrit : l'exécution, les blocages, les résultats et la discussion de suivi reviennent dans la Task, de sorte que le contexte, l'avancement, les blocages, les résultats et la relecture humaine restent visibles de la demande à la livraison, et que le travail en attente d'une personne devient un chiffre plutôt qu'un sentiment qui vous tombe dessus le vendredi.
La ligne qui n'a jamais été gratuite
Gratuit et bon marché sont désormais deux questions distinctes. La question de la plateforme a une réponse publiée : 0 $ jusqu'à 5 personnes, 7 $ par utilisateur et par mois en facturation annuelle au-delà, avec vos propres clés et abonnements. La question des modèles a une réponse plus modeste que ne le laissent croire les gros titres, car le seul accès gratuit passe par une application de bureau qu'aucune exécution sans supervision ne peut utiliser, et les deux autres n'existent pas.
La conclusion utile n'est pas de savoir quelle offre choisir. C'est que la facture de modèles n'est plus ce qui limite ce que votre Crew livre, et que rien de ce que les deux laboratoires ont livré le 22 septembre 2026 ne lit un diff à votre place.
Si vous faites déjà tourner plusieurs agents de codage, Sharkly vous offre un seul endroit pour voir quel Runtime a produit quel résultat, quelles preuves y sont jointes, et quelle part se trouve en ce moment même devant une personne. Connectez un Computer, créez un Agent et confiez-lui une tâche ennuyeuse. À cinq personnes ou moins, cette partie ne coûte rien.


