
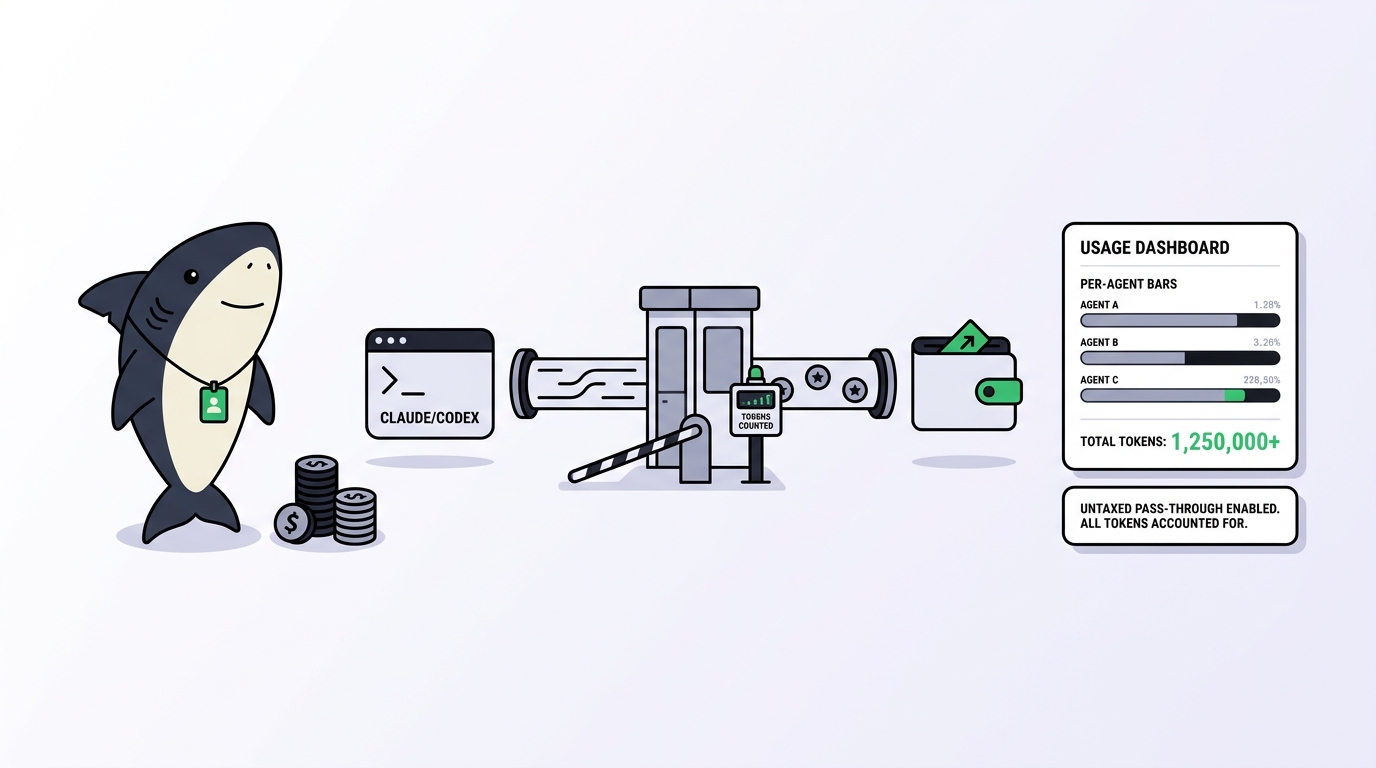
La plupart des plateformes d'agents s'interposent entre vous et le fournisseur du modèle, puis facturent une marge sur chaque token qui transite. Ce n'est pas ce que fait Sharkly. L'usage des modèles repose sur le principe du bring-your-own-key : une exécution est facturée sur le forfait Claude Code, Codex ou API déjà rattaché au Runtime qui la prend en charge, et non sur un solde de tokens que Sharkly vous vendrait. C'est une promesse plus modeste qu'elle n'en a l'air, et il vaut la peine d'être honnête sur ce que cela vous coûte autant que sur ce que cela vous fait économiser, avant de décider si cela compte pour vous.
Ce qu'un modèle de revente fait à vos incitations
Commençons par la plateforme qui vous vend effectivement des tokens, car c'est le modèle par défaut dans cette catégorie et il vaut mieux le dire clairement plutôt que de tourner autour du pot.
Quand une plateforme revend l'accès au modèle, son chiffre d'affaires dépend du nombre de tokens que vos Agents consomment. Ce n'est pas un défaut caché, c'est le modèle économique qui fonctionne comme prévu, et il génère une incitation prévisible : la plateforme n'a aucune raison de rendre une exécution moins chère. Un prompt plus efficace, une fenêtre de contexte plus réduite, un Runtime qui termine en moins de tokens — tout cela fait baisser le chiffre d'affaires que la plateforme tire de votre compte. Rien n'oblige un revendeur de tokens à répercuter les baisses de prix consenties par le fournisseur du modèle sous-jacent, et rien ne le récompense s'il vous aide à dépenser moins. Vous payez une marge pour la coordination, mais cette marge est libellée dans la devise dont la plateforme veut que vous consommiez davantage.
Le deuxième coût est plus discret et n'apparaît qu'avec le temps. Si votre équipe dispose déjà d'un forfait Claude Code ou Codex, ou d'un engagement de dépenses API auprès d'un fournisseur, vous avez probablement négocié les tarifs correspondants : un palier d'abonnement, une remise sur volume, un tarif d'engagement. Faites passer cet usage par un revendeur, et vous payez deux fois pour le même avantage : une fois au revendeur pour le privilège de l'accès, et vous perdez le bénéfice du tarif que vous aviez déjà obtenu en direct, puisque c'est désormais celui du revendeur qui s'applique. La relation tarifaire que vous avez construite avec le fournisseur du modèle ne vous suit pas dans une plateforme qui revend des tokens sous son propre compte.
Mettons-y un ordre de grandeur. Une équipe qui fait tourner une poignée d'Agents via un revendeur, avec une marge par token même modeste, en plus d'un engagement de dépenses déjà contracté directement auprès du fournisseur du modèle, paie deux fois les mêmes tokens : une fois au tarif négocié qu'elle ne peut plus utiliser, une fois au tarif que le revendeur a décidé d'appliquer. Rapportez cela à une Sprint entière d'exécutions, et non à une seule Task, et l'écart se creuse exactement dans le sens que souhaite le revendeur.
Rien de tout cela ne rend la revente de tokens malhonnête. Cela en fait un modèle où les intérêts de la plateforme et vos intérêts de coût pointent dans des directions opposées, et cela vaut la peine de le savoir avant de confier vos exécutions à un prestataire.
Ce que le BYOK vous coûte réellement
Cette séparation n'est pas gratuite non plus du côté de Sharkly, et un article qui ne listerait que les avantages du bring-your-own-key ressemblerait à du marketing plutôt qu'à un exposé honnête du compromis. Disons donc les coûts clairement.
Vous gérez vous-même les clés et les quotas. Personne, au niveau de la couche de coordination, ne surveille en votre nom la limite de débit de votre forfait Claude Code ni le crédit restant de votre compte API. Si votre équipe fait tourner cinq Agents avec une seule clé API Anthropic et que cette clé atteint sa limite de débit, c'est une contrainte que vous devez repérer et anticiper, exactement comme si une personne de votre équipe effectuait ces appels directement depuis un terminal.
Une exécution peut échouer pour une raison qui n'a rien à voir avec Sharkly. Si le forfait Claude Code rattaché à un Runtime atteint sa limite de débit, ou si le compte API qui le finance n'a plus de crédit, l'exécution s'arrête, et la panne se manifeste par une erreur de token ou d'authentification venant du fournisseur du modèle, et non par une panne de Sharkly. Pour diagnostiquer cela, il faut vérifier deux systèmes au lieu d'un : la Task est-elle bloquée à cause de quelque chose dans Sharkly, ou parce que le forfait sous-jacent est à sec ? C'est une véritable frontière, et c'est le prix direct à payer pour ne pas disposer d'un pool de tokens contrôlé par la plateforme qui lisserait tout cela.
La visibilité des dépenses est répartie sur deux endroits. Le tableau de bord d'usage de Sharkly indique la consommation par Agent, mais la facture elle-même apparaît sur votre facture Claude Code, Codex ou fournisseur d'API, et non sur une ligne Sharkly unique. Si votre équipe financière veut un seul chiffre pour « combien nous a coûté le codage assisté par IA ce mois-ci », elle doit rapprocher deux sources au lieu de lire un seul récapitulatif, et ce rapprochement est un travail manuel que quelqu'un doit réellement accomplir.
Il y a aussi un coût de mise en route, et il vaut mieux le nommer que de faire comme s'il n'existait pas. Chaque Runtime que vous connectez doit avoir sa propre clé ou son propre forfait configuré, quelqu'un dans l'équipe doit être responsable du renouvellement et de la rotation de ces identifiants, et une nouvelle recrue qui veut faire tourner des Agents a besoin d'un accès au compte du fournisseur sous-jacent, pas seulement d'une invitation à Sharkly. Une plateforme de revente peut masquer tout cela derrière une seule inscription. Le BYOK ne le fait pas, par conception, et une équipe qui évalue Sharkly devrait prévoir une bonne heure ou deux de configuration par Runtime plutôt que de compter sur zéro.
Rien de tout cela n'est une raison d'éviter le BYOK. C'est la liste honnête de ce que vous assumez en échange du fait de ne pas payer de marge sur les tokens, et une équipe devrait le savoir dès le départ plutôt que de le découvrir en pleine incident.
Là où la couche de gestion mérite encore sa place
Étant donné que Sharkly ne vous vend pas de tokens et ne lisse pas les limites de débit des fournisseurs, il est légitime de se demander ce que fait réellement la couche de coordination. Trois choses, concrètement.
Elle décide sur quel Computer une exécution se déroule. Le Runtime d'un Agent a besoin d'un hôte, local ou cloud, disposant des dépôts et des ressources que requiert une Task, et cette affectation incombe à Sharkly, peu importe qui paie les tokens consommés par l'exécution. La facturation des tokens et le placement de l'exécution sont deux préoccupations distinctes, et le BYOK ne retire la plateforme que de la première.
Elle maintient un humain dans le circuit d'approbation. Les Agents recherchent, exécutent, testent et rendent compte ; les personnes donnent la direction, accordent l'autorité et acceptent le résultat. Cette étape de revue — qui valide une Task avant qu'elle soit fusionnée ou clôturée — ne dépend pas de qui paie l'appel au modèle en dessous. Une marge de revendeur plus faible ne vous achète pas un meilleur processus de revue, et un modèle BYOK ne vous en coûte pas un non plus.
Et elle vous offre un tableau de bord d'usage qui indique la consommation par Agent, même si les tokens eux-mêmes sont facturés ailleurs. Vous pouvez voir quel Agent a le plus consommé au cours d'une Sprint, quels types de Tasks coûtent cher à automatiser et où un Runtime tourne à plein régime, sans que cette visibilité implique que Sharkly soit celui qui vous facture les tokens qu'il vous rapporte. L'utilité du tableau de bord ne dépend pas du fait que Sharkly détienne la facture.
Voilà la forme réelle de cette séparation : Sharkly gère l'endroit où le travail s'exécute, qui le révise et ce qu'il vous coûte, sans avoir besoin d'être aussi le vendeur de ce qui est mesuré.
Décider si ce compromis en vaut la peine
Si votre équipe est petite, dispose d'un seul Runtime et tombe rarement sur une limite de débit, la question du revendeur contre le BYOK ne changera probablement pas grand-chose à votre quotidien, dans un sens comme dans l'autre. Le compromis devient concret dès que vous faites tourner plusieurs Agents sur un même forfait sous-jacent, que vous coordonnez des Crews sur plus d'un Computer, ou que vous cherchez à répondre à « combien le codage assisté par IA nous a-t-il réellement coûté cette Sprint » pour plusieurs équipes. À ce stade, une plateforme dont l'incitation cachée est de maintenir vos dépenses de tokens élevées représente un coût que vous ne pouvez pas pleinement voir, tandis qu'une plateforme qui se contente de vous dire ce que vous avez dépensé, sans être aussi celle qui vous le vend, vaut bien la contrainte des deux tableaux de bord.
Le pari de Sharkly, c'est que le problème de coordination, et non celui de la mesure, est celui qui mérite d'être facturé. C'est la couche au-dessus des agents que vous faites déjà tourner, et non un second prestataire entre vous et les tokens qu'ils consomment. Si vous payez déjà Claude Code ou Codex en direct et que vous voulez des exécutions assignables, révisables et visibles, sans marge ajoutée sur les tokens, c'est précisément la couche que Sharkly a été conçue pour être. Consultez la grille tarifaire actuelle pour voir exactement à quoi ressemble la partie « siège » de tout cela.


