
Votre agent de codage sait écrire un service, refactoriser un module et expliquer une stack trace. Demandez-lui ce qui s'est dit sur la sortie d'une bibliothèque la semaine dernière : il cale. Demandez-lui de résumer une conférence : il n'a pas accès à la transcription. Les informations dont un agent a le plus besoin se trouvent sur des plateformes qui facturent l'accès ou le bloquent.
Agent-Reach est une CLI unique qui contourne cet obstacle et, avec 77 134 étoiles, c'est la réponse la plus adoptée au problème. Elle résout la lecture. Elle ne résout pas ce qu'il advient de ce que l'agent a lu, et c'est précisément là que les équipes perdent un temps précieux.
TL;DR
Ceci est l'une des cinq analyses approfondies issues de notre sélection d'outils open source qui étendent les agents de codage.
Agent-Reach connecte tout agent capable d'exécuter des commandes shell à X, Reddit, YouTube, GitHub, RSS, Bilibili, XiaoHongShu, Facebook, Instagram, aux podcasts et à la recherche web généraliste, en passant par des voies d'accès gratuites plutôt que par les API payantes des plateformes. Chaque plateforme passe par un backend principal, avec des solutions de repli : quand une voie d'accès casse, le basculement se fait en amont, pas de votre côté. Commencez par les plateformes sans configuration, relisez les conditions d'utilisation avant de connecter celles qui reposent sur les cookies, et donnez à vos recherches un endroit où atterrir autre que le scrollback d'un terminal.
La barrière qu'il fait tomber
Chacune de ces plateformes a son propre obstacle, et chaque contournement constitue à lui seul un petit projet d'intégration :
| Plateforme | La barrière | Configuration dans Agent-Reach |
|---|---|---|
| Twitter/X | API payante, environ 215 $/mois pour un usage modéré | Cookie du navigateur |
| Adresses IP de serveurs bloquées sur les endpoints anonymes | Session ou cookie de navigateur | |
| YouTube | Transcriptions non exposées | Aucune configuration |
| GitHub | Authentification requise au-delà des lectures publiques | Aucune configuration, gh auth login pour aller plus loin |
| Pages web | Bruit du balisage | Aucune configuration |
| Recherche web | Clés d'API | Configuration automatique à l'installation |
Configurez vous-même cinq plateformes et vous vous retrouvez avec cinq choses qui tombent en panne indépendamment les unes des autres. La promesse, ici : une seule installation, puis l'invisibilité.
L'installation
Le chemin d'installation sort de l'ordinaire : vous confiez à votre agent une URL de documentation plutôt que de lancer une commande.
Install Agent Reach: https://raw.githubusercontent.com/Panniantong/agent-reach/main/docs/install.md
L'agent installe le paquet Python, vérifie l'environnement et indique ce qui est prêt. Le mode par défaut est en lecture seule, et toute modification au niveau système exige un flag explicite.
pip install https://github.com/Panniantong/agent-reach/archive/main.zip
agent-reach install --env=auto
agent-reach doctor
agent-reach doctor affiche ce qui fonctionne, ce qui ne fonctionne pas et comment corriger chaque point. Pour un outil dont le métier repose sur des accès tiers fragiles par nature, fournir un contrôle de santé comme commande de premier ordre est le bon réflexe.
La décision de conception qui mérite d'être reprise
N'importe qui peut enrober un scraper. Ce qui fait tenir ce projet, c'est la chaîne de repli : chaque plateforme possède un backend principal et une liste ordonnée d'alternatives ; quand une voie d'accès meurt, le projet bascule le défaut et publie une mise à jour. Leur propre exemple : Bilibili qui a commencé à renvoyer des erreurs 412 à un backend en juin 2026, sans que les utilisateurs ne remarquent quoi que ce soit.
Cela évite le mode de défaillance qui finit par tuer les versions maison. Votre scraper fonctionne pendant quatre mois, casse un mardi, et vous l'apprenez quand un agent affirme avec assurance qu'un sujet ne suscite aucune discussion, au lieu de signaler que la requête a échoué. Un agent incapable de distinguer un résultat vide d'une requête échouée affirmera les deux avec la même assurance.
Là où le modèle d'accès gratuit impose un choix
Les plateformes sans configuration sont simples : API publiques, CLI GitHub officielle, RSS et un fournisseur de recherche qui veut ce trafic.
Les plateformes basées sur les cookies, c'est une autre histoire. Lire X, Reddit ou Instagram via votre propre session connectée ne constitue pas une voie d'accès API autorisée. Le projet gère cela de manière responsable : les cookies restent en local et ne sont jamais téléversés, et comme il est open source, vous pouvez le vérifier. Ce qu'il ne peut pas faire, en revanche, c'est modifier les conditions que vous avez acceptées sur ces comptes.
Utilisez-le pour de la recherche personnelle sur vos propres comptes, ce pourquoi la plupart des gens l'installent. Relisez les conditions applicables avant tout usage commercial, et utilisez un compte dont vous pouvez accepter la perte. Ne traitez pas un accès non officiel comme un flux de données de production.
La recherche est un travail de longue haleine, et ce travail a besoin d'une Task
Voici le problème qui apparaît dès la deuxième semaine, et il n'est pas technique.
Les sessions de recherche sont longues. Un agent qui fouille X, Reddit, Hacker News et GitHub pendant deux heures produit quelque chose de précieux : des sources, des citations, des dates, des liens, une synthèse. Puis la session se termine. Un collègue demande d'où vient une affirmation, et la réponse est introuvable. Pire encore : quelqu'un refait la même recherche le mois suivant parce que personne ne savait qu'elle avait eu lieu.
La Task est l'unité de travail principale dans Sharkly. Elle rassemble la demande, le contexte, l'exécution et le résultat dans un même espace partagé, au lieu de les disperser entre des prompts privés et des sessions de terminal. Exécution, blocages, résultats et discussions de suivi reviennent dans la timeline de la task, si bien que les sources sont encore là le trimestre suivant.
Trois éléments de ce modèle comptent tout particulièrement pour le travail de recherche.
Un Agent est une configuration enregistrée : instructions, runtime, compétences, dépôts et environnement. Une configuration de recherche que vous avez ajustée une fois, y compris les plateformes qu'elle a le droit d'utiliser, est réutilisée plutôt que reconstruite.
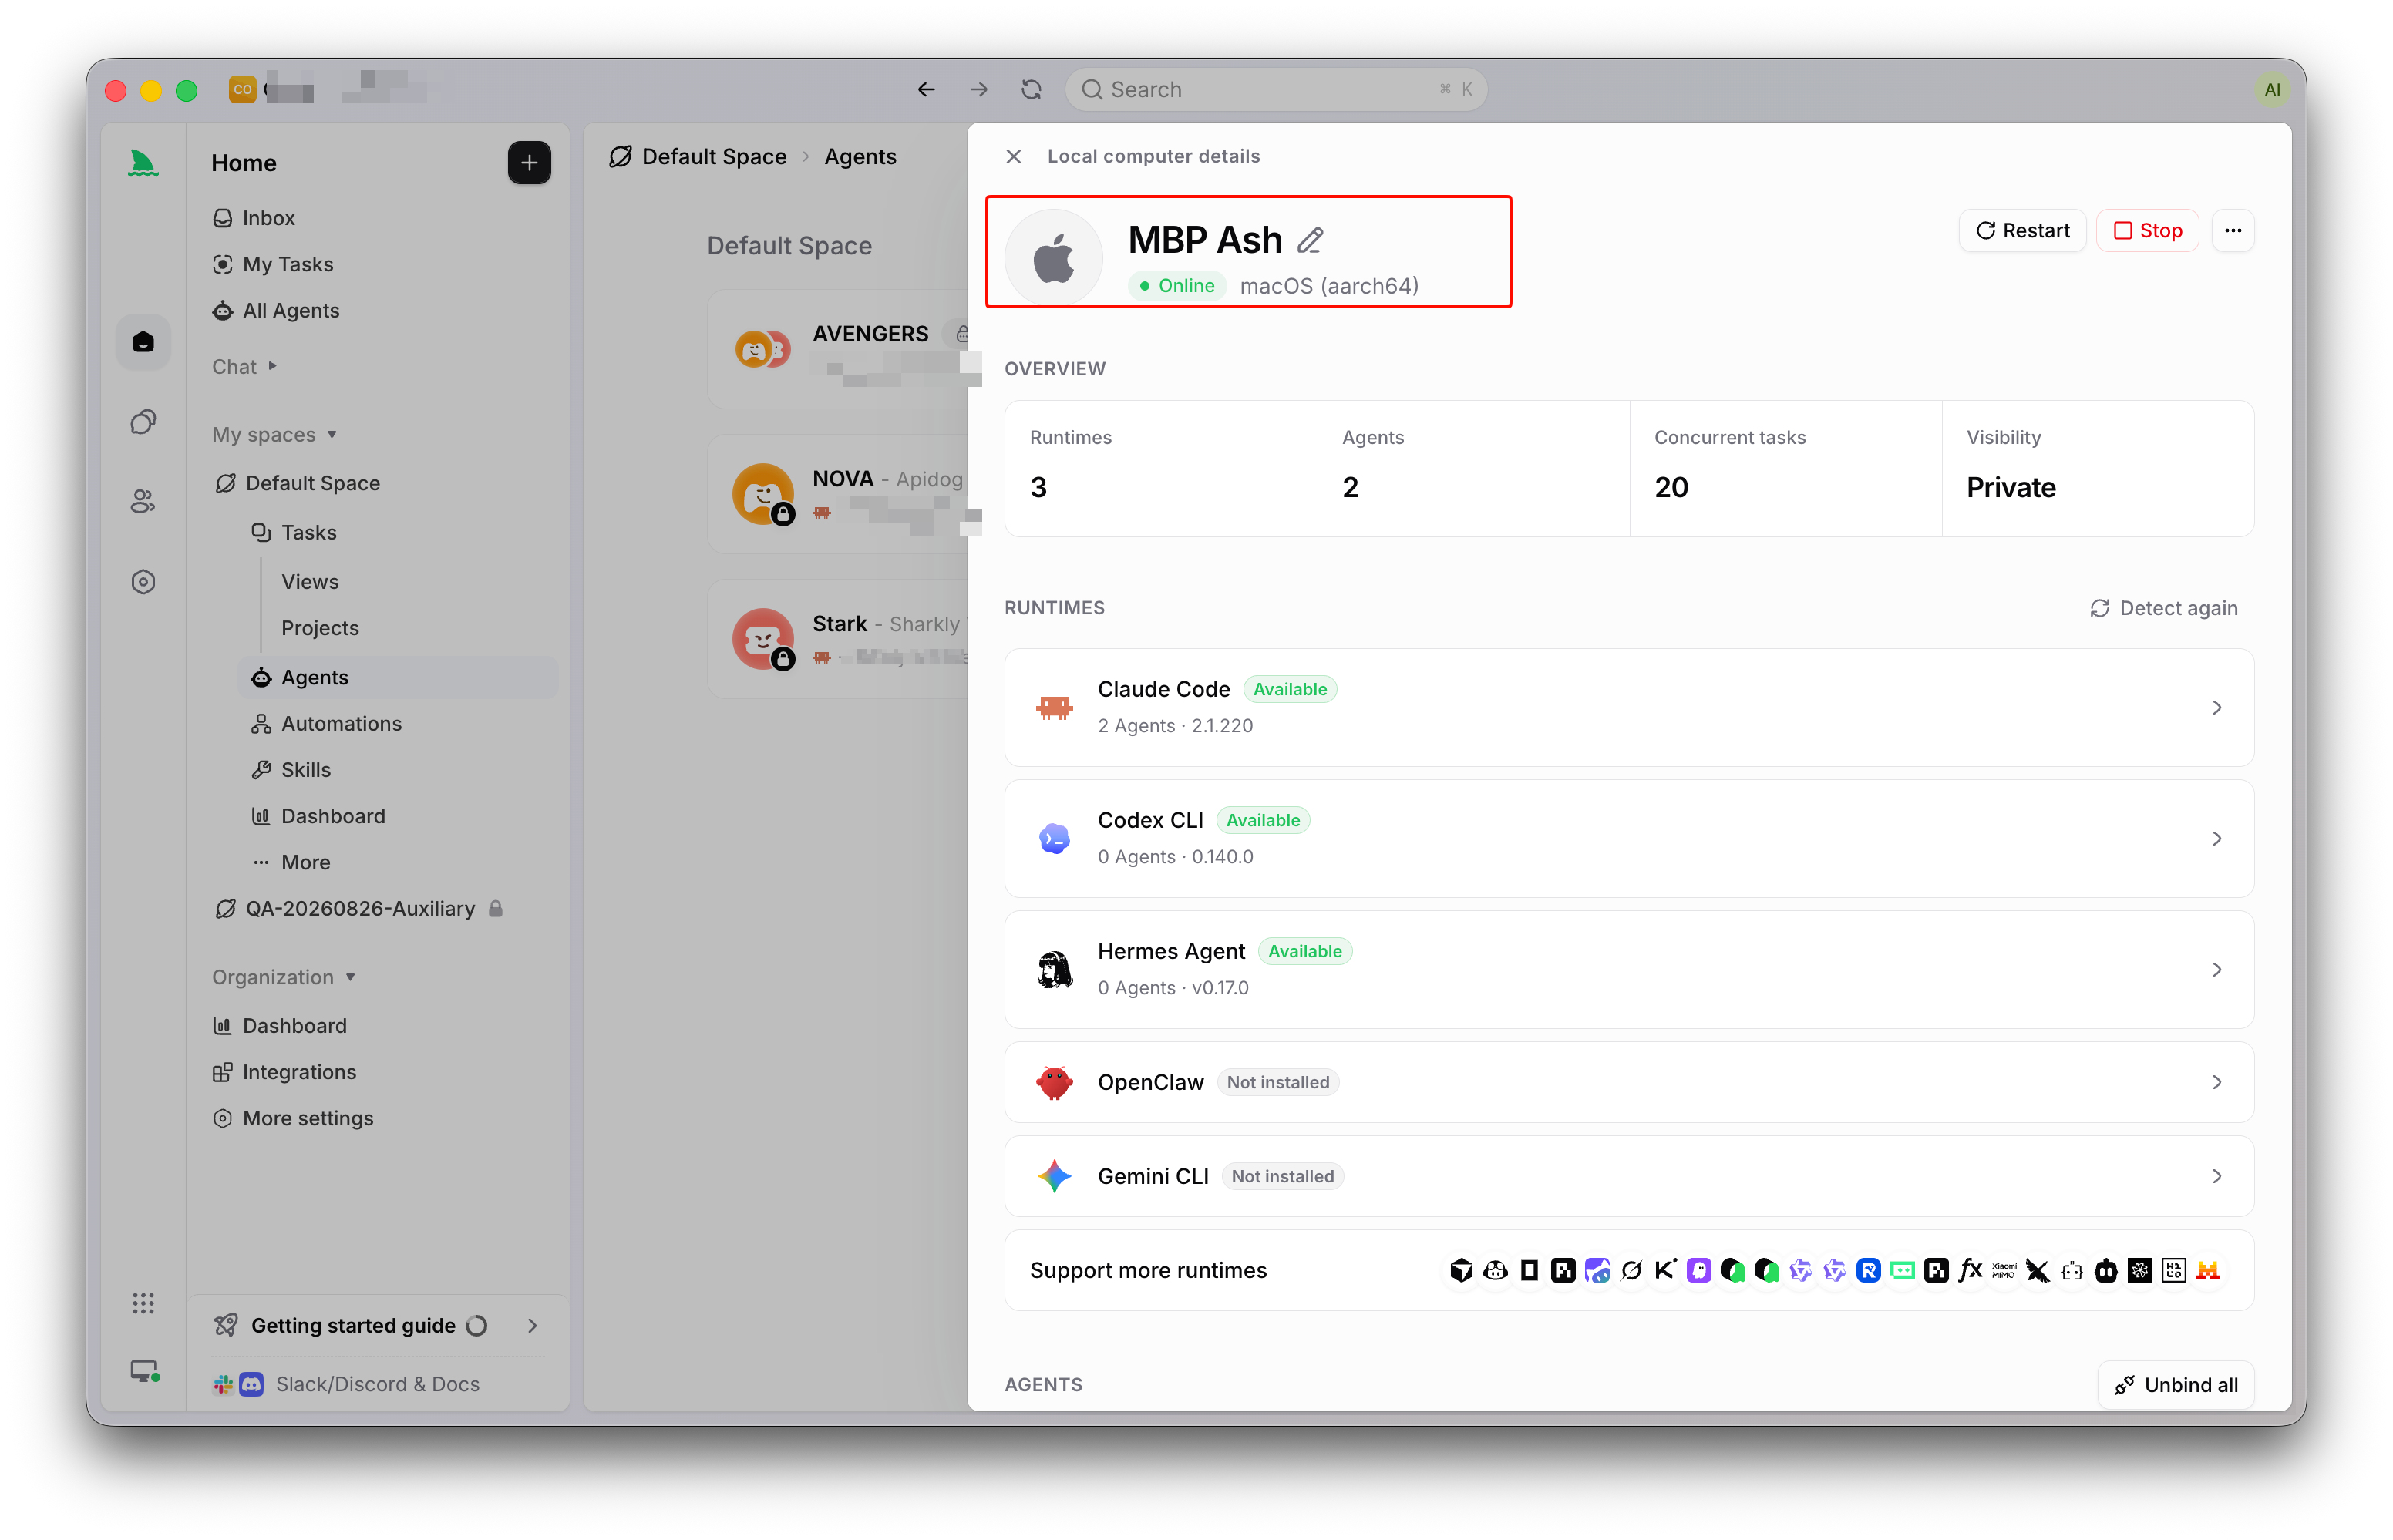
Un Computer fournit l'hôte et les ressources locales, et le Runtime y exécute la session. Ici, rien d'abstrait. Les plateformes d'Agent-Reach basées sur les cookies ont besoin d'un vrai navigateur connecté sur une machine précise : le choix du Computer sur lequel tourne une task de recherche est donc une véritable décision opérationnelle, et non le hasard du portable resté ouvert.
Une Task en Backlog ne déclenche aucune exécution. Vous pouvez mettre en file vos sujets de recherche dès qu'ils vous viennent à l'esprit, sans consommer de quota au moment où vous les notez.
Sharkly ne remplace ni Agent-Reach ni l'outil de codage qui l'exécute. Il ajoute autour d'eux la couche de task partagée, de Computer, de contexte, de contrôle et de relecture.
Utilisez-le directement, ou donnez-lui un endroit où rendre compte
Utilisez Agent-Reach seul quand vous répondez à une question pour vous-même, aujourd'hui. Installez, demandez, lisez, passez à autre chose. Rien de plus ne se justifie.
Recourez à un système de travail partagé quand les conclusions éclairent une décision que quelqu'un d'autre prendra, quand une affirmation finira dans un document ou dans un échange client, ou quand la même recherche serait sinon refaite par un collègue qui ignorait son existence.
Une règle s'impose dans les deux cas. Considérez chaque conclusion comme non vérifiée jusqu'à ce qu'une personne ouvre le lien. Un agent peut lire un post qui revendique un résultat de benchmark ; il ne peut pas vous dire si ce benchmark était réel. Les agents cherchent, exécutent, testent et rendent compte. Les humains fixent la direction, accordent l'autorité et acceptent le résultat.
Questions fréquentes
Avec quels agents Agent-Reach fonctionne-t-il ? Avec tout agent capable d'exécuter des commandes shell, notamment Claude Code, Cursor, Windsurf, OpenClaw et Codex. OpenClaw doit d'abord activer son autorisation exec, car le profil de messagerie par défaut ne peut pas lancer de commandes.
Est-ce vraiment gratuit ? Les outils sont open source et les voies d'accès ne sont pas facturées. Un proxy serveur coûte environ un dollar par mois si l'IP de votre machine est bloquée ; les machines locales n'en ont pas besoin. L'absence de facturation d'un fournisseur ne signifie pas l'absence de contraintes liées aux conditions d'utilisation.
Mes cookies sont-ils en sécurité ? Le projet affirme que les cookies restent en local et ne sont jamais téléversés, et le code source est consultable pour le vérifier. Le risque réel n'est pas l'exfiltration, mais que votre compte soit limité ou signalé par la plateforme.
Est-ce que ça cassera quand les plateformes changent ? Oui, et c'est prévu. Chaque plateforme dispose de solutions de repli et le projet bascule les défauts en amont. Lancez agent-reach doctor quand quelque chose semble anormal.
Comment cela s'articule-t-il avec l'exécution de plusieurs agents en parallèle ? Recherche et code fonctionnent bien en parallèle, et chaque exécution de Task dispose de son propre worktree isolé, donc rien ne se percute. Les conclusions reviennent dans leur propre Task.
En bref
Agent-Reach lève une vraie limite. Un agent capable de lire les discussions réelles autour d'une bibliothèque, de regarder la conférence et de consulter le suivi des issues répond mieux qu'un agent qui travaille à partir d'une date de coupure d'entraînement, et la conception avec replis lui permet de continuer à fonctionner après l'inévitable panne.
Installez-le d'abord pour les plateformes sans configuration, et réfléchissez avant de connecter des cookies. Décidez ensuite où vont les conclusions. Une recherche qui ne vit que dans un scrollback finit par être refaite. Sharkly assure l'autre moitié : la Task est l'enregistrement partagé, l'exécution tourne sur les Computers que vous connectez, et les résultats reviennent là où une personne peut les examiner.


