
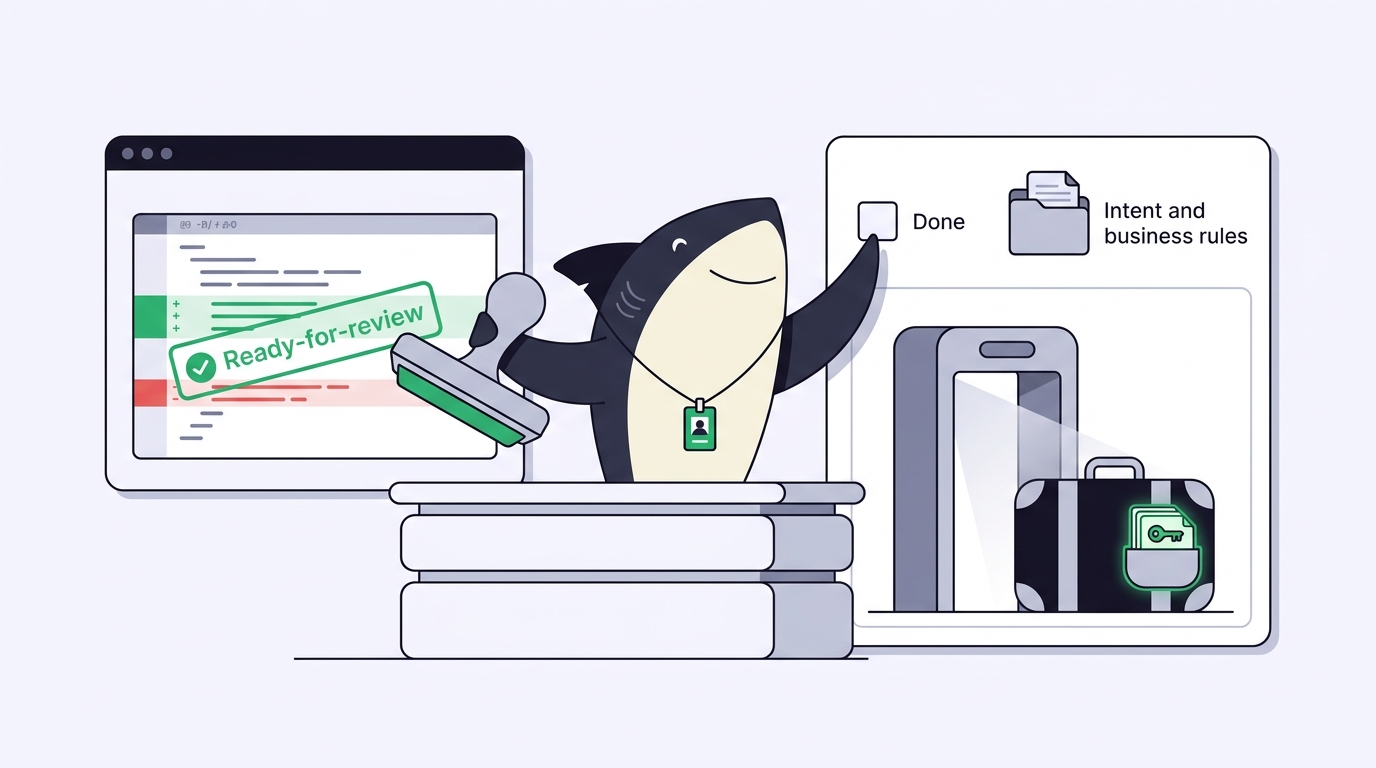
Vous avez branché un agent de revue de code IA dans votre pipeline, et ça a marché. Il a signalé un contrôle de nullité manquant, repéré un import inutilisé et laissé trois commentaires bien propres sur le nommage. Vous avez mergé. Deux jours plus tard, un client est tombé sur un bug que l'agent avait lu sans le voir : la modification était propre en interne, mais elle faisait la mauvaise chose. L'agent de revue a validé le code. Il n'a pas pu valider l'intention.
Cet écart résume tout ce qu'il faut savoir sur les agents de revue de code IA. Ils excellent sur une catégorie de problèmes précise et vérifiable, et restent aveugles à une autre catégorie qui, dans un diff, a exactement la même apparence. Confondez leur approbation avec une acceptation, et vous livrez la catégorie aveugle. Sachez où se situe la frontière, et vous obtenez une première passe rapide qui libère vos relecteurs pour le jugement que seuls des humains peuvent porter.
Cet article trace cette frontière : ce qu'un agent de revue de code IA peut vérifier, ce qu'il ne peut pas, et le modèle de fonctionnement qui maintient la distinction. Sharkly est la couche que nous allons parcourir, l'espace de travail partagé où la revue par l'agent et l'acceptation humaine sont deux statuts distincts sur une même Tâche, et non un seul tampon. Vous avez déjà des agents de codage ; l'enjeu ici est de relire leur production sans prétendre qu'un second agent ferme la boucle.
Ce qu'un agent de revue de code IA peut vérifier
Un agent de revue de code IA est un programme qui lit un diff, exécute des vérifications dessus et remonte ses constats comme un relecteur humain laisserait des commentaires. Sa zone de fiabilité couvre tout ce qu'un relecteur attentif pourrait confirmer en lisant la modification et son voisinage immédiat :
- Correction mécanique : syntaxe, types, gestion évidente des valeurs nulles et des cas limites, rejets de promesses non gérés, fuites de ressources visibles dans le diff.
- Logique locale : erreurs de décalage d'un cran (off-by-one), conditions inversées, branches mortes, variable lue avant d'être initialisée.
- Conventions : nommage, formatage, hygiène des imports, présence d'un test à côté d'une nouvelle fonction.
- Anti-patterns connus : SQL construit par concaténation de chaînes, secrets commités en clair, méthode publique sans validation des entrées.
Tous ces points partagent un même trait : la preuve se trouve à l'intérieur du diff. L'agent n'a pas besoin de connaître votre métier pour les détecter, et il les détecte plus vite et avec plus de constance qu'un humain fatigué à 18 h. C'est une valeur bien réelle, et c'est pourquoi les équipes se tournent vers ces outils. Le guide de revue de code de Google considère cette passe mécanique comme un prérequis, afin que l'attention humaine puisse se porter sur la conception. Un relecteur IA est un moyen patient de franchir cette étape à chaque fois.
Ce qu'il ne peut pas vérifier
Voici la frontière, dite sans détour : un agent de revue de code IA ne peut pas vérifier que la modification est la bonne. Tout ce qui suit exige un contexte que le diff ne contient pas.
- Intention vs spécification. Le code peut être irréprochable et résoudre le mauvais problème. Seuls les critères d'acceptation du ticket en décident, et l'agent les a rarement sous les yeux.
- Justesse métier. Savoir si une règle de remise, un calcul de taxe ou une frontière de permissions correspond au fonctionnement réel de l'entreprise relève du jugement, pas d'une règle de lint.
- Comportement inter-systèmes. Une modification qui se lit très bien dans un fichier peut casser un appelant situé trois services plus loin. Le Top Ten de l'OWASP regorge de failles comme le contrôle d'accès défaillant, qui n'apparaissent qu'en suivant l'intégralité du chemin d'une requête, et non le diff.
- L'honnêteté des tests. Un agent peut confirmer qu'un test existe et qu'il passe. Il ne peut pas vous dire que ce test vérifie bien ce qui compte, ni que l'agent qui a écrit le code a aussi écrit un test calibré pour passer.
Ce dernier point est le piège propre au code écrit par l'IA. Quand une même catégorie de système produit à la fois la modification et la revue, un diff propre et une coche verte peuvent être vrais tous les deux et pourtant passer complètement à côté de l'essentiel. Une approbation venant d'un agent de revue est donc un signal, pas une décision. L'agent rend compte ; c'est une personne qui accepte.
Le modèle de fonctionnement qui comble l'écart
La solution n'est pas un meilleur agent de revue. C'est un modèle de fonctionnement où le travail de l'agent de revue et celui de l'humain correspondent à des états différents, et où aucun des deux n'est sauté.
Sharkly rend ces états explicites sous forme de statut de Tâche. Une Tâche passe par En cours, puis Prêt pour revue, puis Terminé. La règle est simple et structurante : les agents font passer le travail à Prêt pour revue ; les personnes le font passer à Terminé. Un agent, qu'il ait écrit le code ou qu'il l'ait relu, ne peut jamais marquer son propre travail comme accepté. Les agents explorent, exécutent, testent et rendent compte. Les personnes donnent la direction, accordent l'autorité et acceptent le résultat. L'automatisation s'arrête là où le jugement de l'équipe est requis.
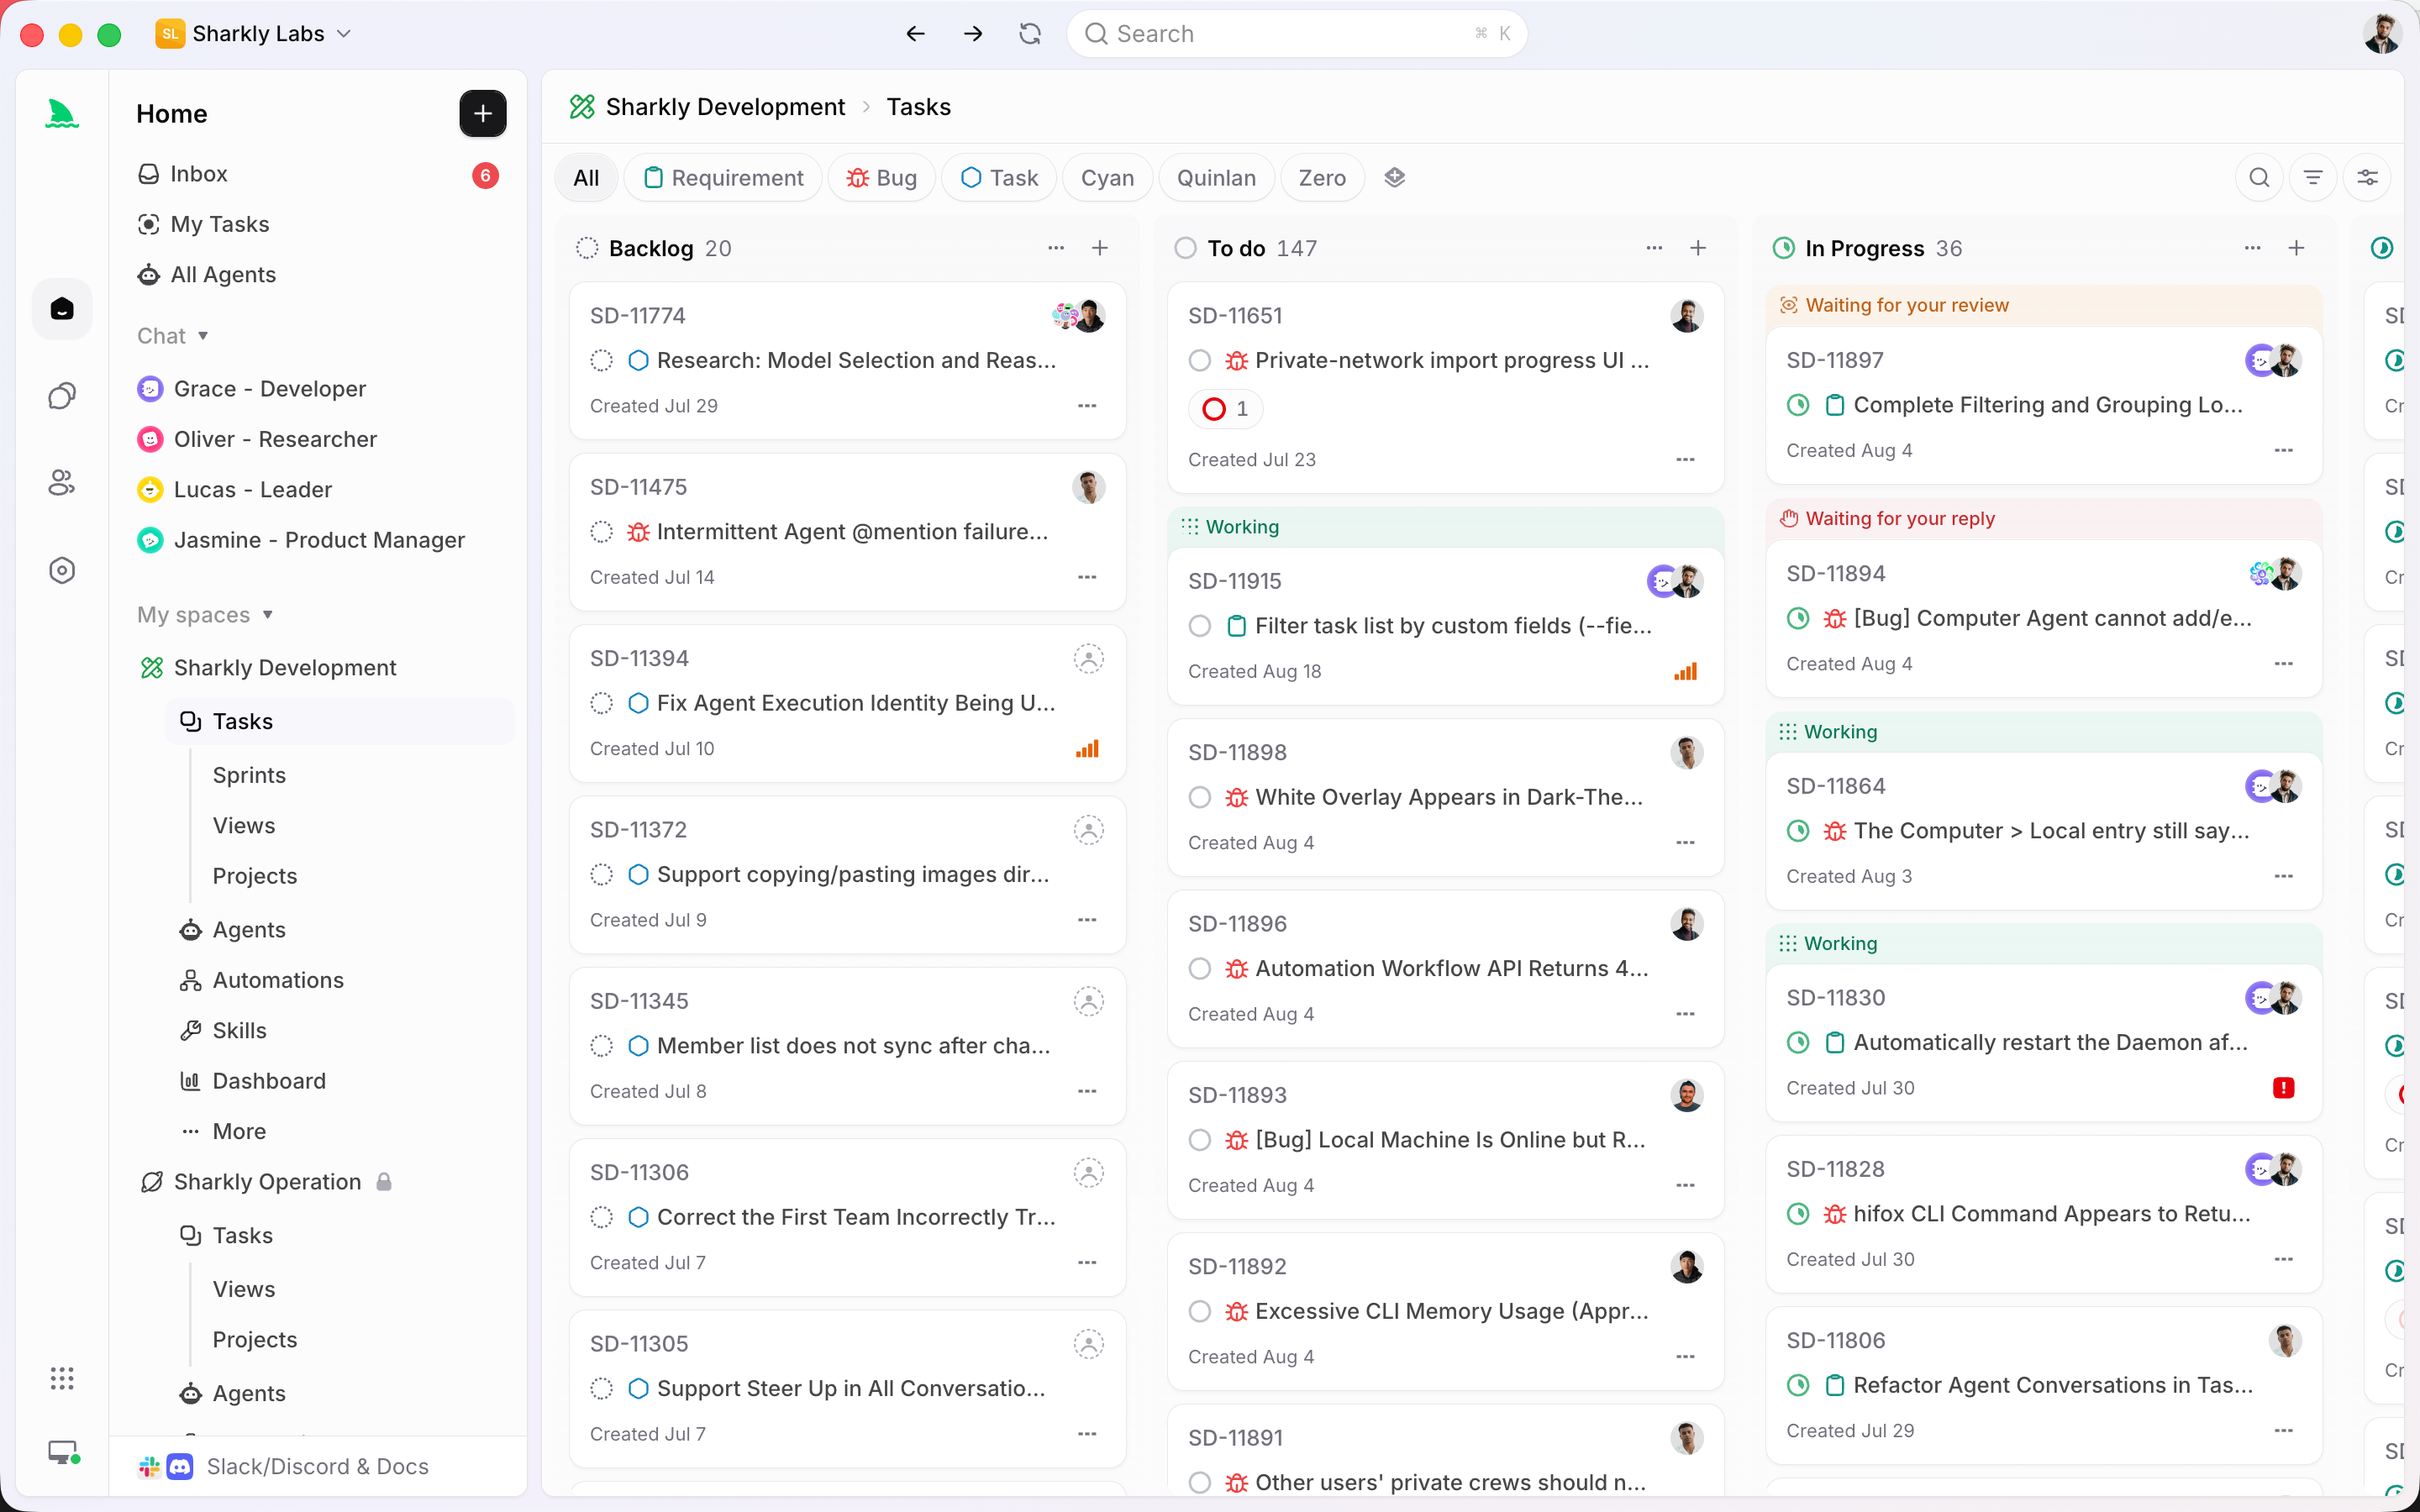
Chaque rôle a une seule mission. L'Agent de codage produit la modification. L'Agent de revue exécute la passe mécanique et joint ses constats. Le relecteur humain lit ces constats, confronte la modification à l'intention du ticket et tranche. Le tout revient à la Tâche : le diff, les commentaires de l'Agent de revue, la sortie des tests et la décision humaine vivent sur une même chronologie, au lieu d'être éparpillés entre une PR, un chat et la mémoire de quelqu'un.
Utilisez un agent de revue comme premier point de contrôle quand la modification est mécanique et autonome — un refactoring, une mise à jour de dépendance, une correction de bug bien délimitée ; laissez-le éliminer le bruit pour que la passe humaine soit rapide. Ne vous appuyez pas sur lui comme unique point de contrôle quand la modification touche à l'argent, à l'authentification, aux migrations de données ou aux contrats publics ; là, l'humain lit en premier et la passe de l'agent est une checklist, pas un verdict.
Un exemple concret : du ticket à la PR mergée
Prenons SH-312 : « Rejeter les codes promo expirés au moment du paiement ». Une personne rédige les critères d'acceptation et assigne la Tâche. Un Agent de codage la prend en charge, travaille dans un worktree isolé et renvoie vers la Tâche un diff accompagné d'un test qui passe, ce qui la fait passer à Prêt pour revue.
C'est maintenant au tour de l'Agent de revue. Il confirme les types, signale un garde-fou de nullité manquant et note que le test couvre le cas expiré. Passe impeccable. Selon l'ancienne habitude, cette approbation suffirait à merger.
Au lieu de cela, le relecteur humain ouvre la Tâche et lit en confrontant à l'intention. Le code rejette bien les coupons expirés, exactement comme écrit. Mais les critères d'acceptation sous-entendaient aussi que les coupons déjà utilisés devaient être rejetés, et ni l'Agent de codage ni l'Agent de revue ne le savaient, parce que cette information vit dans la tête du relecteur et dans la spec produit, pas dans le diff. Le relecteur demande une modification. SH-312 repasse à En cours avec une note précise, l'Agent la complète, et c'est seulement alors qu'une personne la fait passer à Terminé et merge la pull request.
L'agent de revue a bien fait son travail et aurait tout de même laissé passer un trou. Le modèle de fonctionnement l'a rattrapé, parce que l'acceptation était un acte distinct, accompli par une personne disposant du contexte. C'est la même discipline que celle qui sous-tend le fait de relire du code généré par IA avec des preuves au niveau de la tâche : l'unité de revue est la Tâche et son intention, pas le diff isolé.
Où placer vos points de contrôle de revue
La vraie question n'est pas de savoir s'il faut utiliser des agents de revue de code IA. Elle est de savoir où leur passe compte et où un humain doit lire en premier. Quelques règles qui tiennent :
- Laissez l'agent contrôler le style, le formatage et les bugs mécaniques sur chaque modification. C'est la passe où il excelle et celle que les humains ratent le plus quand ils sont fatigués.
- Exigez un point de contrôle humain sur tout ce qui touche à l'authentification, à la facturation, aux migrations de données ou à une API publique. C'est là que se concentre la zone aveugle.
- Dimensionnez vos points de contrôle en fonction de votre capacité de revue. Les agents produisent plus vite que les humains n'acceptent, alors réservez la passe humaine là où l'agent est aveugle.
- Faites de la validation un statut, pas une habitude. Un point de contrôle d'approbation documenté qui bloque le passage à Terminé est applicable ; une norme du type « quelqu'un devrait y jeter un œil » ne l'est pas. Garder un humain dans la boucle ne fonctionne que si la boucle est une étape exigée par le workflow.
Un agent de revue de code IA ne remplace pas un relecteur humain. C'est la première passe, celle qui rend la passe humaine plus rapide et plus affûtée. Si vous faites déjà tourner plusieurs agents de codage et que vous voulez relire et accepter leur production au même endroit plutôt que dans cinq onglets de PR, c'est précisément le problème autour duquel Sharkly est conçu : assigner, suivre et relire le travail des agents sur des Tâches partagées, avec les constats de l'Agent de revue et la décision humaine qui reviennent tous deux au même enregistrement. Gardez les agents de codage et l'agent de revue que vous utilisez déjà, puis ajoutez la couche qui décide quand leur passe suffit.


