
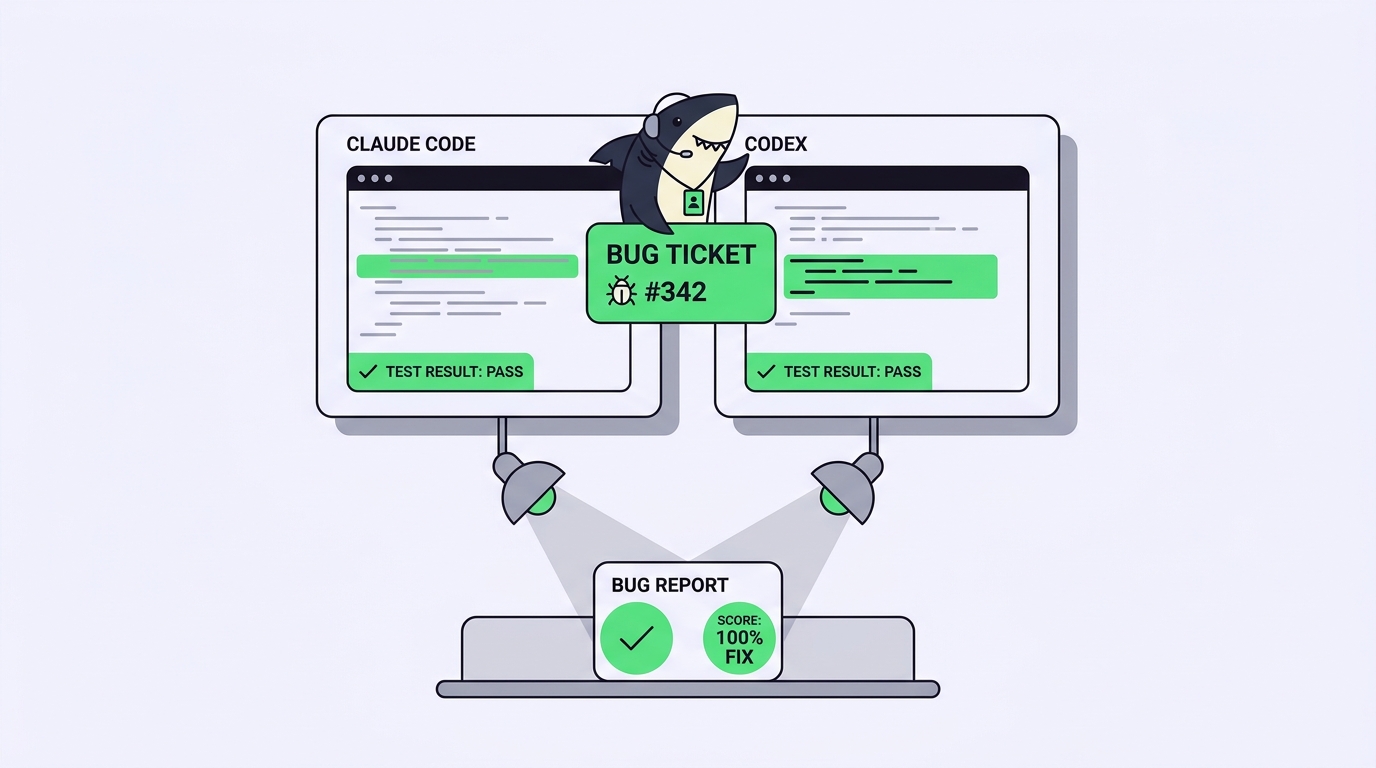
Vous avez un vrai bug ouvert et deux agents capables de le corriger : Claude Code et Codex. Les onglets débordent d'avis sur celui qui est le plus intelligent, et aucun ne vous dit lequel pointer vers ce bug, dans ce dépôt, aujourd'hui. Les chiffres des benchmarks publics ne le font pas non plus. Un classement mesure un ensemble figé de problèmes open source avec un harnais bien réglé. Votre bug est un problème privé : vos conventions, votre test instable, le module qu'une seule personne comprend.
La façon honnête de répondre à « Claude Code ou Codex » consiste à lancer les deux sur le même bug, dans les mêmes conditions, et à lire ce que chacun vous rend. Cela semble simple et vire très vite au chaos : deux agents qui modifient les mêmes fichiers, deux terminaux, deux jeux de sorties de tests, et aucun moyen propre de les comparer côte à côte. La comparaison que vous voulez porte sur les agents. Le travail qui vous attend consiste à les empêcher d'entrer en collision.
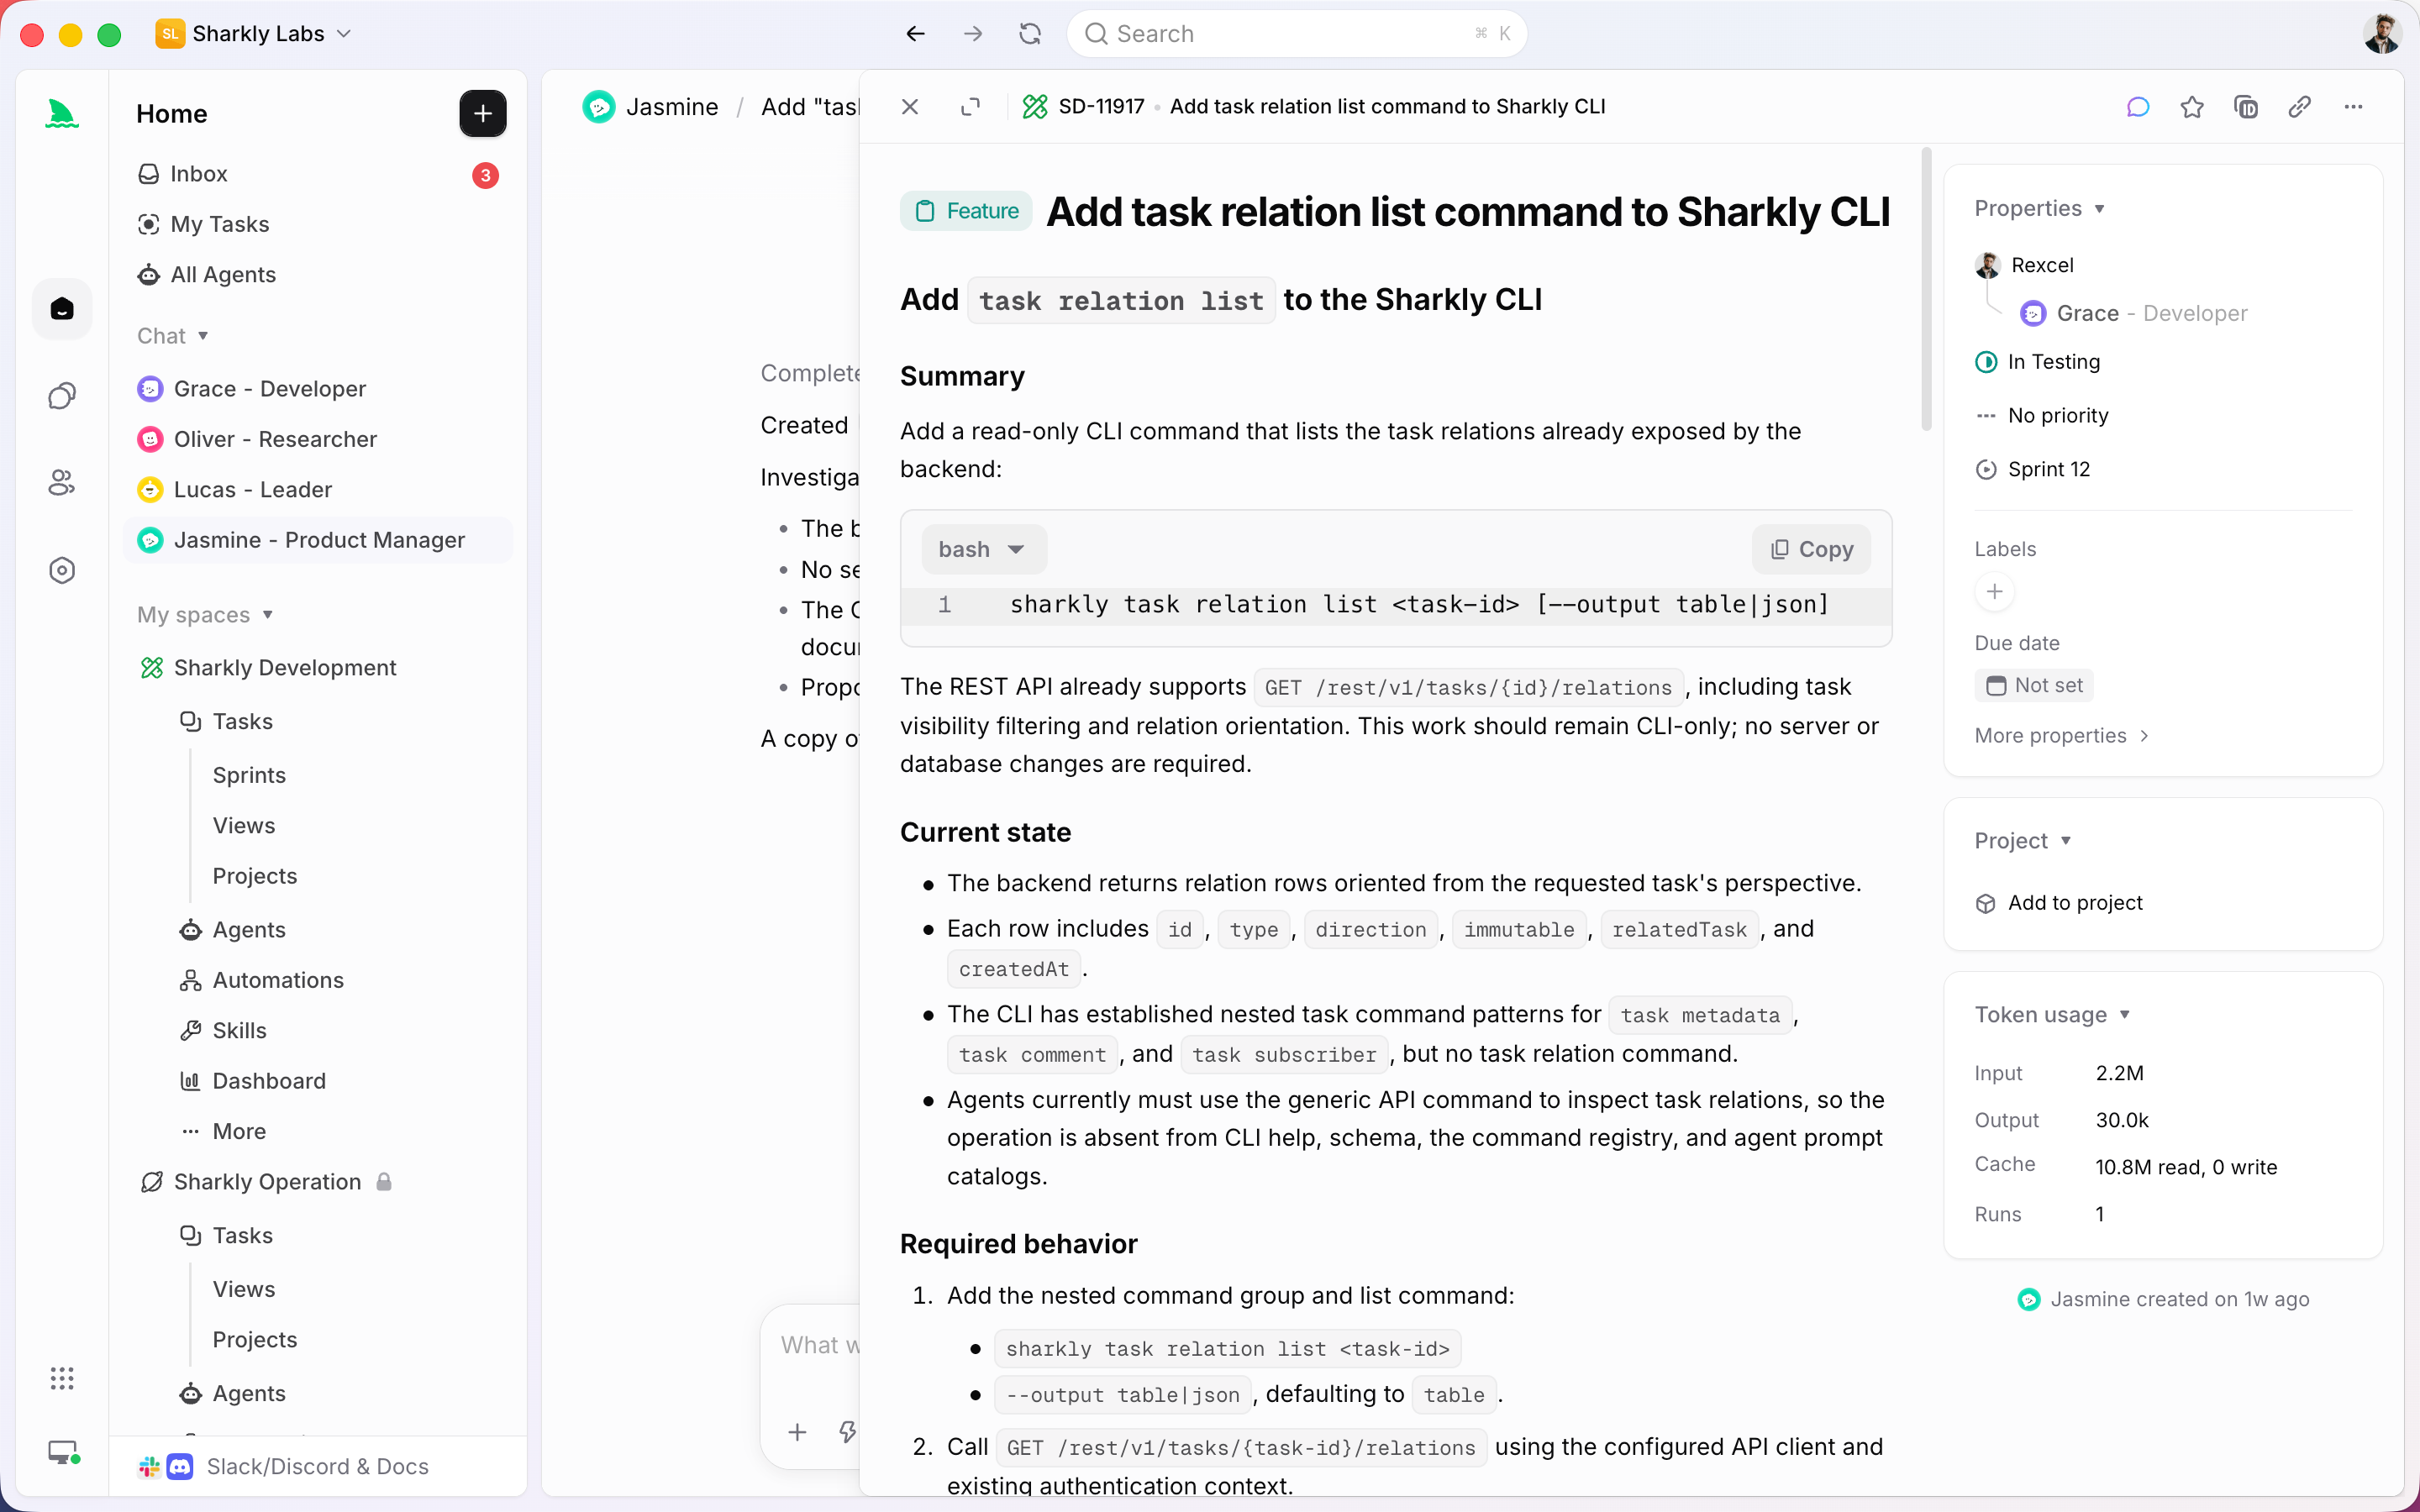
C'est cette collision que Sharkly élimine. Sharkly est une plateforme tout-en-un de commande et de gestion d'Agents : vous assignez la même Task à deux Agents différents, chacun s'exécute sur un Computer connecté, dans son propre worktree isolé, et chaque exécution renvoie son diff, ses résultats de tests et sa revue au même endroit. Sharkly ne remplace ni Claude Code ni Codex, et ce n'est pas un harnais de benchmark. C'est la couche qui rend un face-à-face équitable possible sans ouvrir un second terminal. Ce guide déroule la méthode, une grille d'évaluation pour un bug unique, et les points sur lesquels chaque agent a tendance à l'emporter.
La réponse rapide
Pour comparer Claude Code et Codex honnêtement, donnez aux deux le bug identique, le même commit de départ et le même test d'acceptation, chacun tournant dans sa meilleure configuration. Évaluez ensuite ce qui revient : le correctif passe-t-il, le diff reste-t-il dans le périmètre, et combien de temps vous faut-il pour relire la modification. L'agent qui gagne sur un bug a gagné sur un bug. Répétez la méthode sur plusieurs bugs avant de faire confiance au verdict.
Pourquoi « lequel est le meilleur » est la mauvaise question
Claude Code et Codex sont tous deux des agents de codage pensés pour le terminal. Ils lisent votre dépôt, modifient des fichiers, exécutent des commandes et rendent compte. Ils diffèrent par leur configuration et leur comportement sous pression, mais aucun n'est universellement en avance sur le travail qui remplit un sprint ordinaire.
Un classement mondial unique masque précisément ce qui vous intéresse. « Lequel est le meilleur » réduit tout à un chiffre qui ne survit pas au contact de votre base de code. « Lequel est le meilleur sur ce type de bug, dans mon dépôt, au moment de la revue » est une question à laquelle on peut répondre, et c'est la seule qui vaille l'effort. Si vous hésitez encore sur le modèle que chaque agent doit exécuter, associer les modèles aux rôles des agents est une meilleure première question que n'importe quel classement.
Lancer les deux sur le même bug : une méthode fiable
Une comparaison équitable garde tout constant, sauf l'agent. Quatre règles le garantissent.
- Choisissez un vrai bug, pas un prompt jouet. Prenez un défaut bien délimité dans votre backlog, avec un test d'acceptation exécutable et un diff lisible en quelques minutes. Rédigez-le comme le ferait votre outil de suivi : une tâche du type
SH-312: fix the timezone drift in the invoice export. « Créer une application de todo » ne vous apprend rien sur votre code. - Donnez aux deux exactement la même entrée. Même description de tâche, même commit de départ, mêmes critères d'acceptation. Si Claude Code reçoit un prompt plus riche que Codex, vous mesurez votre prompt, pas l'agent.
- Lancez chacun dans sa meilleure configuration. Donnez à Claude Code son
CLAUDE.md, à Codex sonAGENTS.mdet sa config, et accordez à chacun les permissions et le modèle recommandés par sa propre documentation. Comparer un agent bien configuré à un agent nu revient à mesurer lequel vous avez pris la peine de configurer. - Isolez les deux exécutions. Chaque agent a besoin de sa propre copie de travail. Deux agents dans un même checkout vont s'écraser mutuellement, et vous passerez l'après-midi à démêler un merge au lieu de lire deux tentatives propres. C'est à cela que servent les worktrees isolés.
Lancez les deux tentatives, puis jetez la branche perdante. Vous gardez le correctif en lequel vous avez confiance et les preuves qui l'expliquent.
Une grille d'évaluation pour un correctif de bug
« Est-ce que ça passe » ne fournit qu'un seul bit d'information. Un vrai correctif se juge sur bien plus que cela, et coucher la grille par écrit avant de regarder garde la comparaison honnête.
| Ce que vous évaluez | La question à laquelle cela répond | Pourquoi c'est important |
|---|---|---|
| Exactitude | Le test d'acceptation passe-t-il, sans rien casser d'autre ? | Le plancher. Un agent qui affiche « terminé » n'a rien validé. |
| Discipline de périmètre | Le diff ne touche-t-il que ce que le bug exigeait ? | Un correctif qui réécrit quatre fichiers sans rapport coûte plus cher à relire qu'il ne rapporte. |
| Qualité des tests | L'agent a-t-il ajouté ou mis à jour un test qui attraperait la régression ? | Un correctif sans test est un correctif que vous referez. |
| Temps de revue | Combien de temps vous a-t-il fallu pour faire confiance à la modification ? | Souvent le vrai goulot d'étranglement, et facile à ignorer jusqu'à ce qu'il vous coûte un après-midi. |
| Honnêteté | L'agent a-t-il signalé ses propres limites et hypothèses ? | L'exécution digne de confiance est celle qui vous dit ce qu'elle n'a pas vérifié. |
Évaluez les deux tentatives sur ces cinq mêmes critères, sur le même bug, et le vainqueur cesse d'être une affaire de goût. Le temps de revue mérite un poids supplémentaire : deux agents peuvent tous deux terminer en vingt minutes et coûter quand même une heure chacun à vérifier. Cette heure est souvent la véritable limite à la quantité de travail d'agent qu'une équipe peut absorber.
Où chacun a tendance à l'emporter
Aucun chiffre inventé ici, juste ce qu'il faut surveiller. Claude Code s'appuie sur la mémoire de projet de son CLAUDE.md et a tendance à rester dans les conventions du dépôt sur les modifications multi-fichiers, ce qui se voit sur les refactorisations couvrant plusieurs modules. Codex est à l'aise dans un environnement sandboxé piloté par la config et structure souvent proprement le nouveau code et ses tests, ce qui se voit sur les correctifs bien délimités. Les deux s'égarent davantage à mesure que le dépôt grossit, et les deux vous remettront avec assurance une modification qui ne passe pas. Testez votre propre bug avant de tenir tout cela pour acquis.
Voici la partie honnête que la plupart des comparaisons passent sous silence. Si vous n'utilisez qu'un seul agent et vivez dans un unique terminal, vous n'avez pas besoin d'une plateforme pour appliquer cette méthode. Une session Claude Code bien réglée dans un worktree, ou une exécution Codex, suffit, et vous pouvez juger le diff à l'œil nu. L'équation change dès que vous comparez deux agents, sur plus d'un bug, et que vous voulez les résultats sous une forme lisible par quelqu'un d'autre.
Lancer le face-à-face dans Sharkly
C'est là que Sharkly gagne sa place. Vous créez une seule Task pour le bug, puis vous l'assignez à la fois à un Agent Claude Code et à un Agent Codex. Chaque Agent s'exécute sur un Computer connecté, dans son propre worktree, de sorte que les deux tentatives ne touchent jamais les mêmes fichiers. L'exécution, les blocages, les résultats et le résumé des modifications reviennent dans la timeline de la Task, et vous lisez les deux diffs et les deux exécutions de tests l'un contre l'autre dans une seule vue, au lieu de vous rappeler quel terminal contenait quoi.
La répartition des rôles reste claire. Les agents explorent, exécutent, testent et rendent compte. Les humains donnent la direction et acceptent le résultat. L'automatisation s'arrête là où votre jugement est requis, et Sharkly garde le contexte, la progression, les blocages, les résultats et la revue humaine visibles de la demande à la livraison. Vous ne confiez pas la décision à un outil ; vous obtenez les deux tentatives présentées côte à côte pour que cela prenne quelques minutes. Si vous souhaitez conserver les deux agents pour le travail quotidien plutôt que pour un test ponctuel, faire tourner Claude Code et Codex ensemble sur une même base de code est le même workflow, passé dans la routine.
Lequel choisir, selon la taille de l'équipe
Le bon choix dépend de qui choisit et de ce que la comparaison doit endurer.
| Taille de l'équipe | Ce qui pèse le plus | Vers quoi se tourner |
|---|---|---|
| Développeur solo | Temps de revue et exécution sur sa propre machine | L'agent que vous relisez le plus vite ; vous êtes le seul lecteur |
| Petite équipe | Exécutions parallèles et visibilité partagée | Les deux, assignés via une même Task pour que tout le monde voie les mêmes preuves |
| Équipe plateforme | Intégrations et neutralité vis-à-vis des fournisseurs | Gardez les deux ; le workflow doit survivre à l'agent qui mènera au trimestre suivant |
Cette dernière ligne est la vraie raison de lancer la comparaison plutôt que de choisir un favori et de le défendre. Le meilleur agent de ce trimestre ne sera peut-être pas le meilleur au suivant, et reconstruire votre processus à chaque changement de leader a son propre coût. Comparer sur vos propres bugs, dans un workflow capable de faire tourner n'importe quel agent, vous laisse libre de changer quand la réponse évolue.
Si vous voulez continuer à utiliser plusieurs agents de codage plutôt que de vous engager dans un seul écosystème, c'est le problème autour duquel Sharkly est conçu. Téléchargez Sharkly, connectez un Computer, et assignez le même vrai bug aux deux agents. Le verdict que vous obtenez porte sur votre base de code, la seule qui prédit votre semaine.
FAQ
Claude Code ou Codex est-il meilleur pour corriger des bugs ? Aucun ne l'emporte de façon générale. Sur le même bug, à leur meilleure configuration, l'un dépasse généralement l'autre, et lequel change selon le type de bug et la taille du dépôt. Lancez les deux sur un vrai défaut de votre backlog et évaluez l'exactitude, le périmètre, les tests et le temps de revue.
Puis-je lancer Claude Code et Codex sur le même bug en même temps ? Oui, à condition que chacun dispose de sa propre copie de travail. Deux agents dans un même checkout s'écrasent mutuellement. Donnez à chacun un worktree isolé, ou assignez la Task aux deux dans Sharkly et laissez chaque Agent s'exécuter sur son propre Computer.
Les scores de benchmark m'indiquent-ils quel agent utiliser ? Ils vous indiquent quels agents valent la peine d'être testés, pas comment l'un d'eux se comporte dans votre dépôt. Un jeu de données public ne contiendra jamais vos bibliothèques internes, votre config de lint ou votre module non testé. Considérez le classement comme un filtre, puis lancez la comparaison qui compte sur votre propre code.
Sharkly remplace-t-il Claude Code ou Codex ? Non. Sharkly est la couche d'assignation, de contexte et de revue autour des agents de codage que votre équipe utilise déjà. Les agents se chargent de l'exécution ; Sharkly gère la Task, garde les exécutions visibles et laisse l'acceptation aux humains.
Combien de bugs comparer avant de décider ? Un bug vous renseigne sur un bug. Appliquez la méthode sur une poignée de types de défauts avant de faire confiance à un schéma, et gardez la même grille à chaque fois pour que les résultats s'accumulent.


