
TL;DR : une équipe du MIT CSAIL a fait lire et modifier à un modèle de pointe les poids de Qwen3.5-0.8B dans un bac à sable Python, avec un budget strict de passes forward et un journal complet de chaque étape. Les auteurs rapportent que MATH-500 passe de 7,9 % à 48,1 %. Vous pouvez laisser un agent de codage modifier les poids d'un modèle de la même manière : cinq tâches sur un tableau, le budget inscrit dans chaque tâche, un second agent sur l'évaluation, et une personne qui approuve le fichier modifié.
Le 2 novembre 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab ont publié Sparks of Weight-Space Programming. Le modèle de leur étude, GPT-6 Astra, a ouvert des tenseurs de poids, écrit du numpy et du PyTorch pour les manipuler, formulé une hypothèse, et modifié 131 072 nombres dans un modèle de 0,8B.
Lisez le dispositif et tout paraît familier : un bac à sable, un budget d'outils, un journal de chaque prompt et de chaque cellule exécutée. C'est un agent de codage doté d'un harness, et c'est le harness que votre équipe peut copier dès aujourd'hui.
Ce que l'équipe du MIT a fait, en chiffres
La programmation dans l'espace des poids (weight-space programming) désigne le fait qu'un LLM lit les paramètres d'un réseau comme des données et les modifie directement, sans descente de gradient ni entraînement. L'article du MIT décrit cela sur de petits modèles, sous des limites d'outils strictes, avec chaque tour consigné.
Le résultat phare est la modification de Qwen3.5-0.8B :
| Métrique (chiffres des auteurs) | Modèle de base | Modèle modifié |
|---|---|---|
| MATH-500 | 7,9 % | 48,1 % |
| GSM8K | 13,8 % | 67,1 % |
| IFEval | 21,0 % | 62,3 % |
| Exécutions ayant atteint la limite de 32 768 tokens | 93,0 % | 33,1 % |
Astra a rattaché l'habitude du modèle de boucler jusqu'à épuisement des tokens à une direction écrite par les MLP des couches 15 et 19, puis l'a soustraite dans 64 colonnes de sortie de chacune : 131 072 poids, soit 0,016 % du modèle. Le checkpoint publié est sous licence Apache-2.0, et sa fiche indique que seuls deux tenseurs diffèrent du modèle de base : les matrices down_proj.weight de ces deux couches.
Pourquoi le harness décide du résultat
Deux constats de l'article comptent davantage pour une équipe que le résultat phare.
Le budget a changé le résultat. Chaque passe forward traitait en moyenne un batch de 64 séquences. Avec 10 passes, MATH-500 atteignait 12,3 %. Avec 25, 14,1 %. Avec 50, 48,1 %. Même modèle, même tâche, plafond différent sur le nombre de fois où l'agent pouvait tester une idée.
Les outils ont changé le résultat. Avec pour seule information les poids de deux variantes de Gemma 3 270M, Astra n'a pas réussi à déterminer laquelle était flagorneuse, et ce lors de ses quatre tentatives. Avec un outil qui renvoyait les poids d'attention sur jusqu'à 16 textes de sa composition, il a identifié le flagorneur dans les trois paires.
Deux leviers, donc : ce que l'agent peut dépenser et ce qu'il peut examiner. Les deux doivent être écrits noir sur blanc avant le début de l'exécution.
Les limites sont tout aussi nettes. Astra n'a pas pu améliorer Gemma 3 270M sur MATH-500 : partant d'une base de 6,8 %, sa meilleure modification atteignait 7,7 %. Les auteurs y voient une modification qui retire un obstacle, et non qui ajoute une capacité absente du modèle. Ils qualifient ces résultats de préliminaires, et plusieurs reposent sur une seule exécution. Concevez votre propre expérience comme un test, pas comme un correctif.
Comment laisser un agent de codage modifier les poids d'un modèle en toute sécurité
Une expérience sûre dans l'espace des poids présente cinq propriétés :
- Les poids d'origine sont en lecture seule pour tous les agents.
- Le budget de passes forward est un nombre inscrit dans la tâche, appliqué par le bac à sable.
- Le jeu d'évaluation que voit l'éditeur est distinct du jeu de régression que lance le relecteur.
- Le journal de chaque exécution reste attaché à l'étape à laquelle il appartient.
- Une personne approuve le fichier modifié avant que quoi que ce soit ne le charge en dehors du bac à sable.
Sharkly ne compte pas les passes forward et n'inspecte pas les tenseurs. C'est votre script de bac à sable qui s'en charge, et votre runtime (Claude Code, Codex ou un autre agent que vous utilisez déjà) qui assure la lecture et la modification. Sharkly conserve le travail : qui est responsable de chaque étape, ce qu'elle peut dépenser, ce qui en est revenu et qui a validé. Le dépôt de journaux de l'équipe du MIT contient un dossier harness/ avec une configuration Codex et un script de bac à sable, une référence utile pour le volet bac à sable.
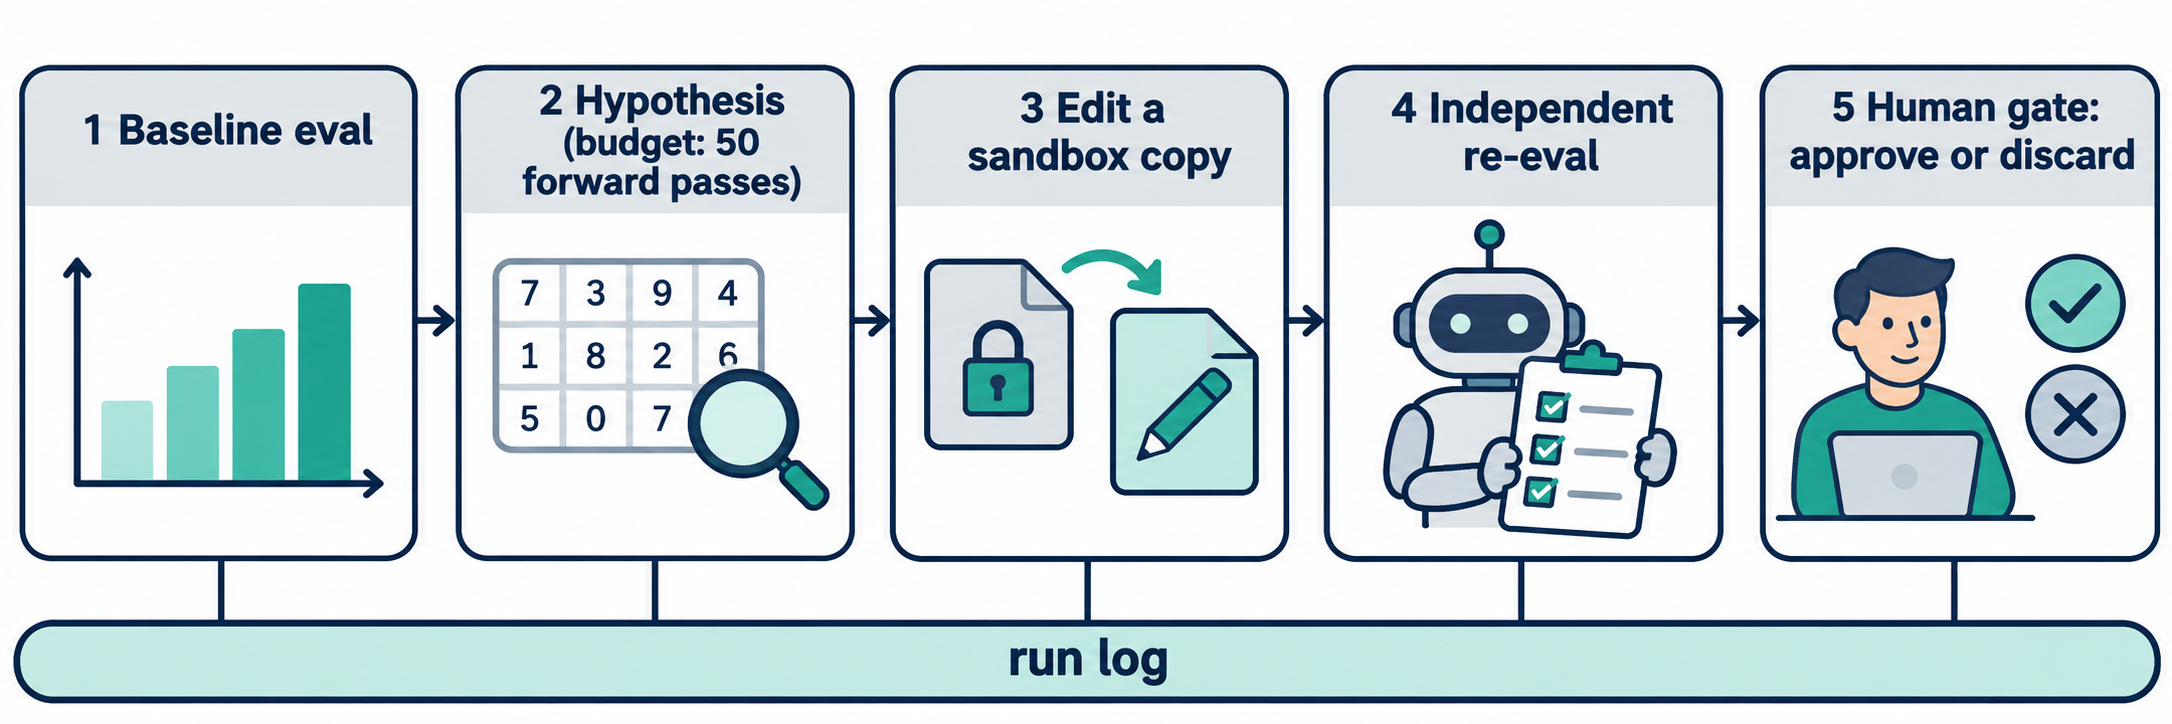
Étape 1 : évaluation de référence du modèle intact
La première tâche exécute votre évaluation sur le checkpoint d'origine et consigne les scores ainsi que les endroits où le modèle échoue. Pour Qwen3.5-0.8B, 93,0 % des exécutions atteignaient la limite de tokens. La tâche d'hypothèse a besoin de cette description des échecs.
Étape 2 : lire les poids et formuler une hypothèse
C'est la tâche qui comporte le budget. Inscrivez le nombre dans le corps, sous une forme que l'agent ne peut pas mal interpréter :
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
Le budget inscrit dans la tâche est une promesse ; celui du wrapper du bac à sable est la garantie. Écrivez les deux, et faites afficher par le wrapper le nombre de passes utilisées pour que le chiffre atterrisse dans le journal d'exécution.
Étape 3 : effectuer la modification dans une copie en bac à sable
L'agent éditeur modifie une copie du checkpoint et rapporte le diff. Il n'obtient jamais l'accès en écriture à l'original. Sur Sharkly, chaque exécution de tâche dispose de son propre répertoire isolé, et le travail sur le dépôt peut utiliser un worktree distinct par exécution, de sorte que l'étape 3 ne peut pas toucher à ce que l'étape 1 a mesuré.
Étape 4 : réévaluation indépendante par un agent relecteur
Confiez cette étape à un agent différent de celui qui a effectué la modification. Il relance l'évaluation de l'étape 1 et y ajoute un jeu de régression que l'éditeur n'a jamais vu. Si vous utilisez un Crew, le responsable peut confier la modification à un membre et la réévaluation à un autre. Le schéma correspond à un Crew multi-modèles avec un relecteur distinct : l'agent qui a écrit la modification n'est pas celui qui la note.
L'éditeur a optimisé en fonction de ce qu'il pouvait voir : un gain qui n'apparaît que sur ces problèmes-là ne prouve pas grand-chose.
Étape 5 : validation humaine du diff
La dernière tâche parvient à une personne avec trois pièces jointes : la liste des tenseurs modifiés, le tableau avant/après et les résultats de régression du relecteur. Rien ne charge le checkpoint modifié en dehors du bac à sable tant que cette tâche n'a pas avancé.
Ce court script produit la première pièce jointe. Il compare deux checkpoints safetensors et liste tous les tenseurs qui ont changé :
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
Sur le checkpoint publié, la fiche du modèle indique que vous devriez voir exactement deux tenseurs down_proj.weight. Si votre propre modification touche des tenseurs que l'hypothèse n'a jamais nommés, c'est une raison de la rejeter.
Piloter le tableau sur Sharkly
Voici le tableau correspondant à une expérience. Chaque ligne est une tâche avec son responsable, son statut et son historique d'exécution.
| Tâche | Responsable | Budget ou validation | Terminée quand |
|---|---|---|---|
| 1. Évaluation de référence | Agent d'évaluation | Jeu d'évaluation uniquement | Scores et notes d'échec publiés |
| 2. Hypothèse à partir des poids | Agent éditeur | 50 passes forward | Hypothèse publiée, passes utilisées consignées |
| 3. Modification en bac à sable | Agent éditeur | Copie uniquement, original en lecture seule | Diff et fichier modifié dans le bac à sable |
| 4. Réévaluation et régression | Agent relecteur | Jeu de régression tenu à l'écart | Tableau avant/après publié |
| 5. Approuver ou rejeter | Une personne | Validation humaine | Décision consignée sur la tâche |
Reliez les étapes par des relations blocks pour que le tableau affiche la chaîne. Les relations entre tâches de Sharkly sont honnêtes sur leur portée : une relation affiche la dépendance et la progression sur la carte, mais elle ne déplace pas une tâche et ne lance pas d'exécution à elle seule. Gardez chaque étape en Backlog jusqu'à ce que la précédente soit terminée. Une tâche assignée à un agent ne déclenche pas d'exécution tant qu'elle reste en Backlog : c'est donc son déplacement qui sert de déclencheur.
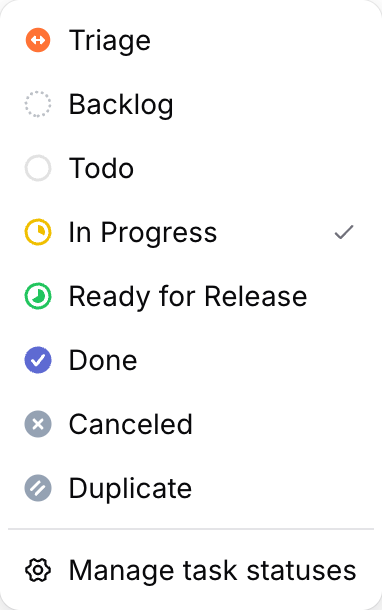
Une fois l'étape 4 terminée, l'agent peut laisser la tâche en attente de relecture humaine, et la personne la voit dans Inbox. Le journal d'exécution enregistre pour chaque exécution son début, sa fin, ses appels d'outils et son déclencheur : votre piste d'audit, conservée à l'étape à laquelle elle appartient. Pour en savoir plus sur où arrêter les agents, consultez les points de validation pour les agents de codage.
Limites pratiques avant de commencer
- Commencez petit. L'étude a utilisé des modèles de 0,8B et 270M avec accès aux tenseurs sur CPU. Choisissez un modèle que vous pouvez évaluer en quelques minutes.
- N'attendez aucun gain sur les compétences manquantes. Le résultat sur Gemma indique qu'une modification peut débloquer un modèle, pas lui apprendre quelque chose.
- Considérez une seule exécution comme une anecdote. Répétez l'expérience avec un agent neuf avant de faire confiance à la modification.
Conclusion
La leçon réutilisable de l'article du MIT, c'est le harness : un budget écrit, des outils limités, un journal complet et des résultats vérifiables par quelqu'un d'autre. Ce sont les contrôles que vous voulez déjà autour d'un agent de codage qui modifie du code.
Pour essayer, créez les cinq tâches dans un Space Sharkly, assignez les étapes 1 à 4 à des agents sur votre Computer connecté, et gardez l'étape 5 pour vous. Sharkly est gratuit pour démarrer sur sharkly.ai.
FAQ
Un agent de codage peut-il modifier les poids d'un modèle ?
Dans l'étude du MIT CSAIL, oui. GPT-6 Astra a lu les tenseurs de Qwen3.5-0.8B dans un bac à sable Python et modifié 131 072 poids. Les auteurs rapportent que MATH-500 passe de 7,9 % à 48,1 %. Ces travaux sont préliminaires, portent sur de petits modèles, et plusieurs résultats reposent sur une seule exécution.
Qu'est-ce que la programmation dans l'espace des poids ?
Un LLM lit les paramètres d'un réseau comme des données et les modifie directement, sans entraînement. Il analyse les tenseurs avec du code, formule une hypothèse, modifie les poids et mesure l'effet à l'aide d'un nombre limité de passes forward.
Pourquoi le budget de passes forward est-il important ?
Dans l'ablation menée par les auteurs sur Qwen, 10 passes atteignaient 12,3 % sur MATH-500, 25 atteignaient 14,1 % et 50 atteignaient 48,1 %. Le budget détermine combien d'idées l'agent peut tester. Inscrivez-le dans la tâche et faites-le appliquer par le bac à sable.
La modification des poids peut-elle ajouter de nouvelles capacités à un modèle ?
L'étude suggère que non. La meilleure modification d'Astra a fait passer Gemma 3 270M de 6,8 % à 7,7 % sur MATH-500. Les auteurs concluent que la modification a retiré un obstacle dans Qwen, plutôt que d'ajouter une capacité.
Comment empêcher des poids modifiés d'atteindre la production ?
Montez l'original en lecture seule, modifiez une copie, lancez une réévaluation indépendante, et exigez qu'une personne approuve le diff des tenseurs avant que quoi que ce soit ne charge le fichier en dehors du bac à sable.


