
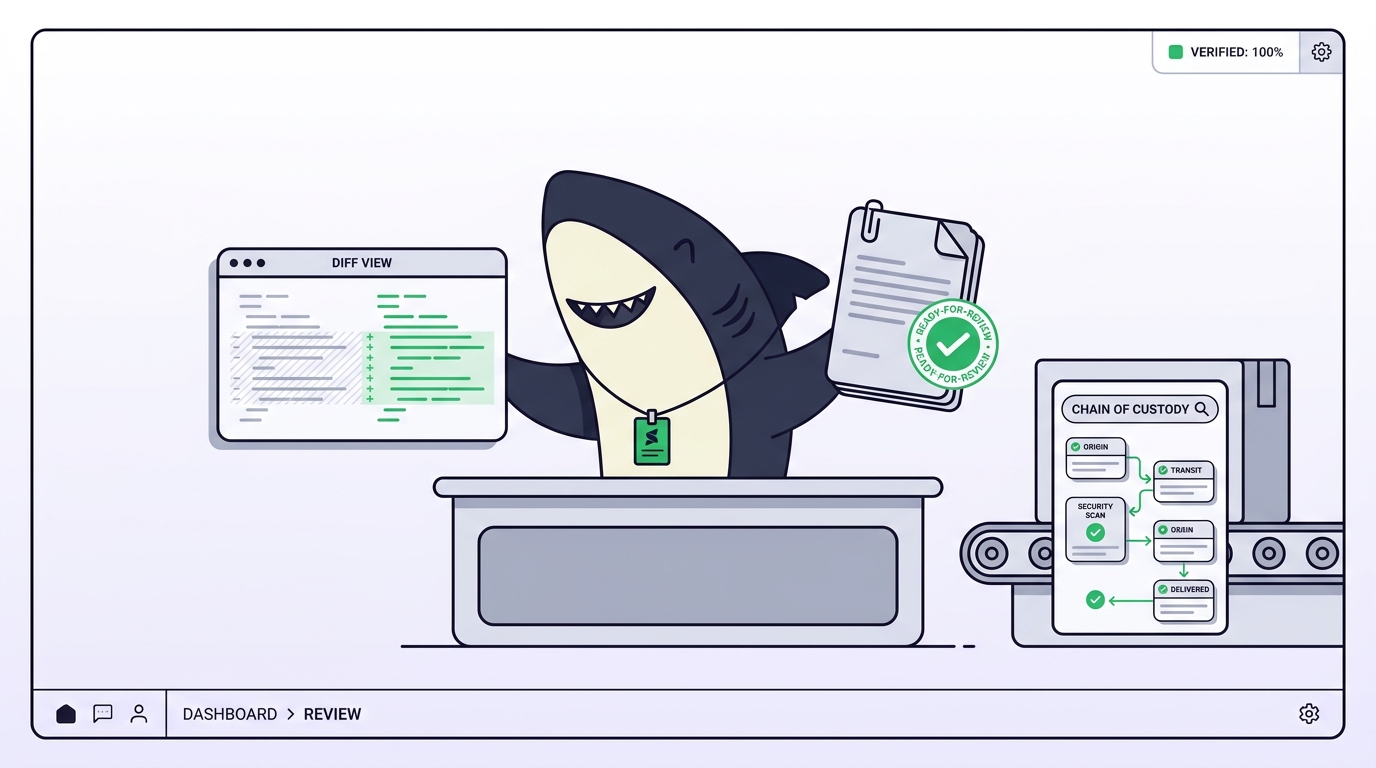
Une pull request débarque dans votre file d'attente : 340 lignes modifiées réparties sur neuf fichiers. C'est un agent de codage qui l'a écrite. Le diff ne vous dit pas ce qu'on a demandé à l'agent, quelles approches il a essayées puis abandonnées, ce qu'il a exécuté pour se convaincre que la modification fonctionne, ni où il sait qu'il a coupé les coins ronds. Vous avez alors deux options : survoler et approuver, ou reconstruire toute la modification depuis zéro. La première, c'est ainsi que du mauvais code part en production. La seconde, c'est que l'agent ne vous a fait gagner aucun temps.
Bien réviser du code généré par IA, c'est un métier différent de la relecture de la PR d'un collègue, parce que l'auteur ne peut pas s'asseoir à côté de vous pour expliquer son raisonnement. La solution consiste à réviser le diff accompagné de ses preuves : l'objectif, les vérifications exécutées et les limites que l'agent a déjà signalées. C'est autour de cette idée qu'est conçu Sharkly. Sharkly se place au-dessus de vos agents de codage (Claude Code, Codex, Gemini, et les autres) et regroupe l'objectif, la modification, les résultats de vérification et la revue humaine de chaque exécution dans un seul Task, au lieu de les éparpiller entre terminaux et descriptions de PR.
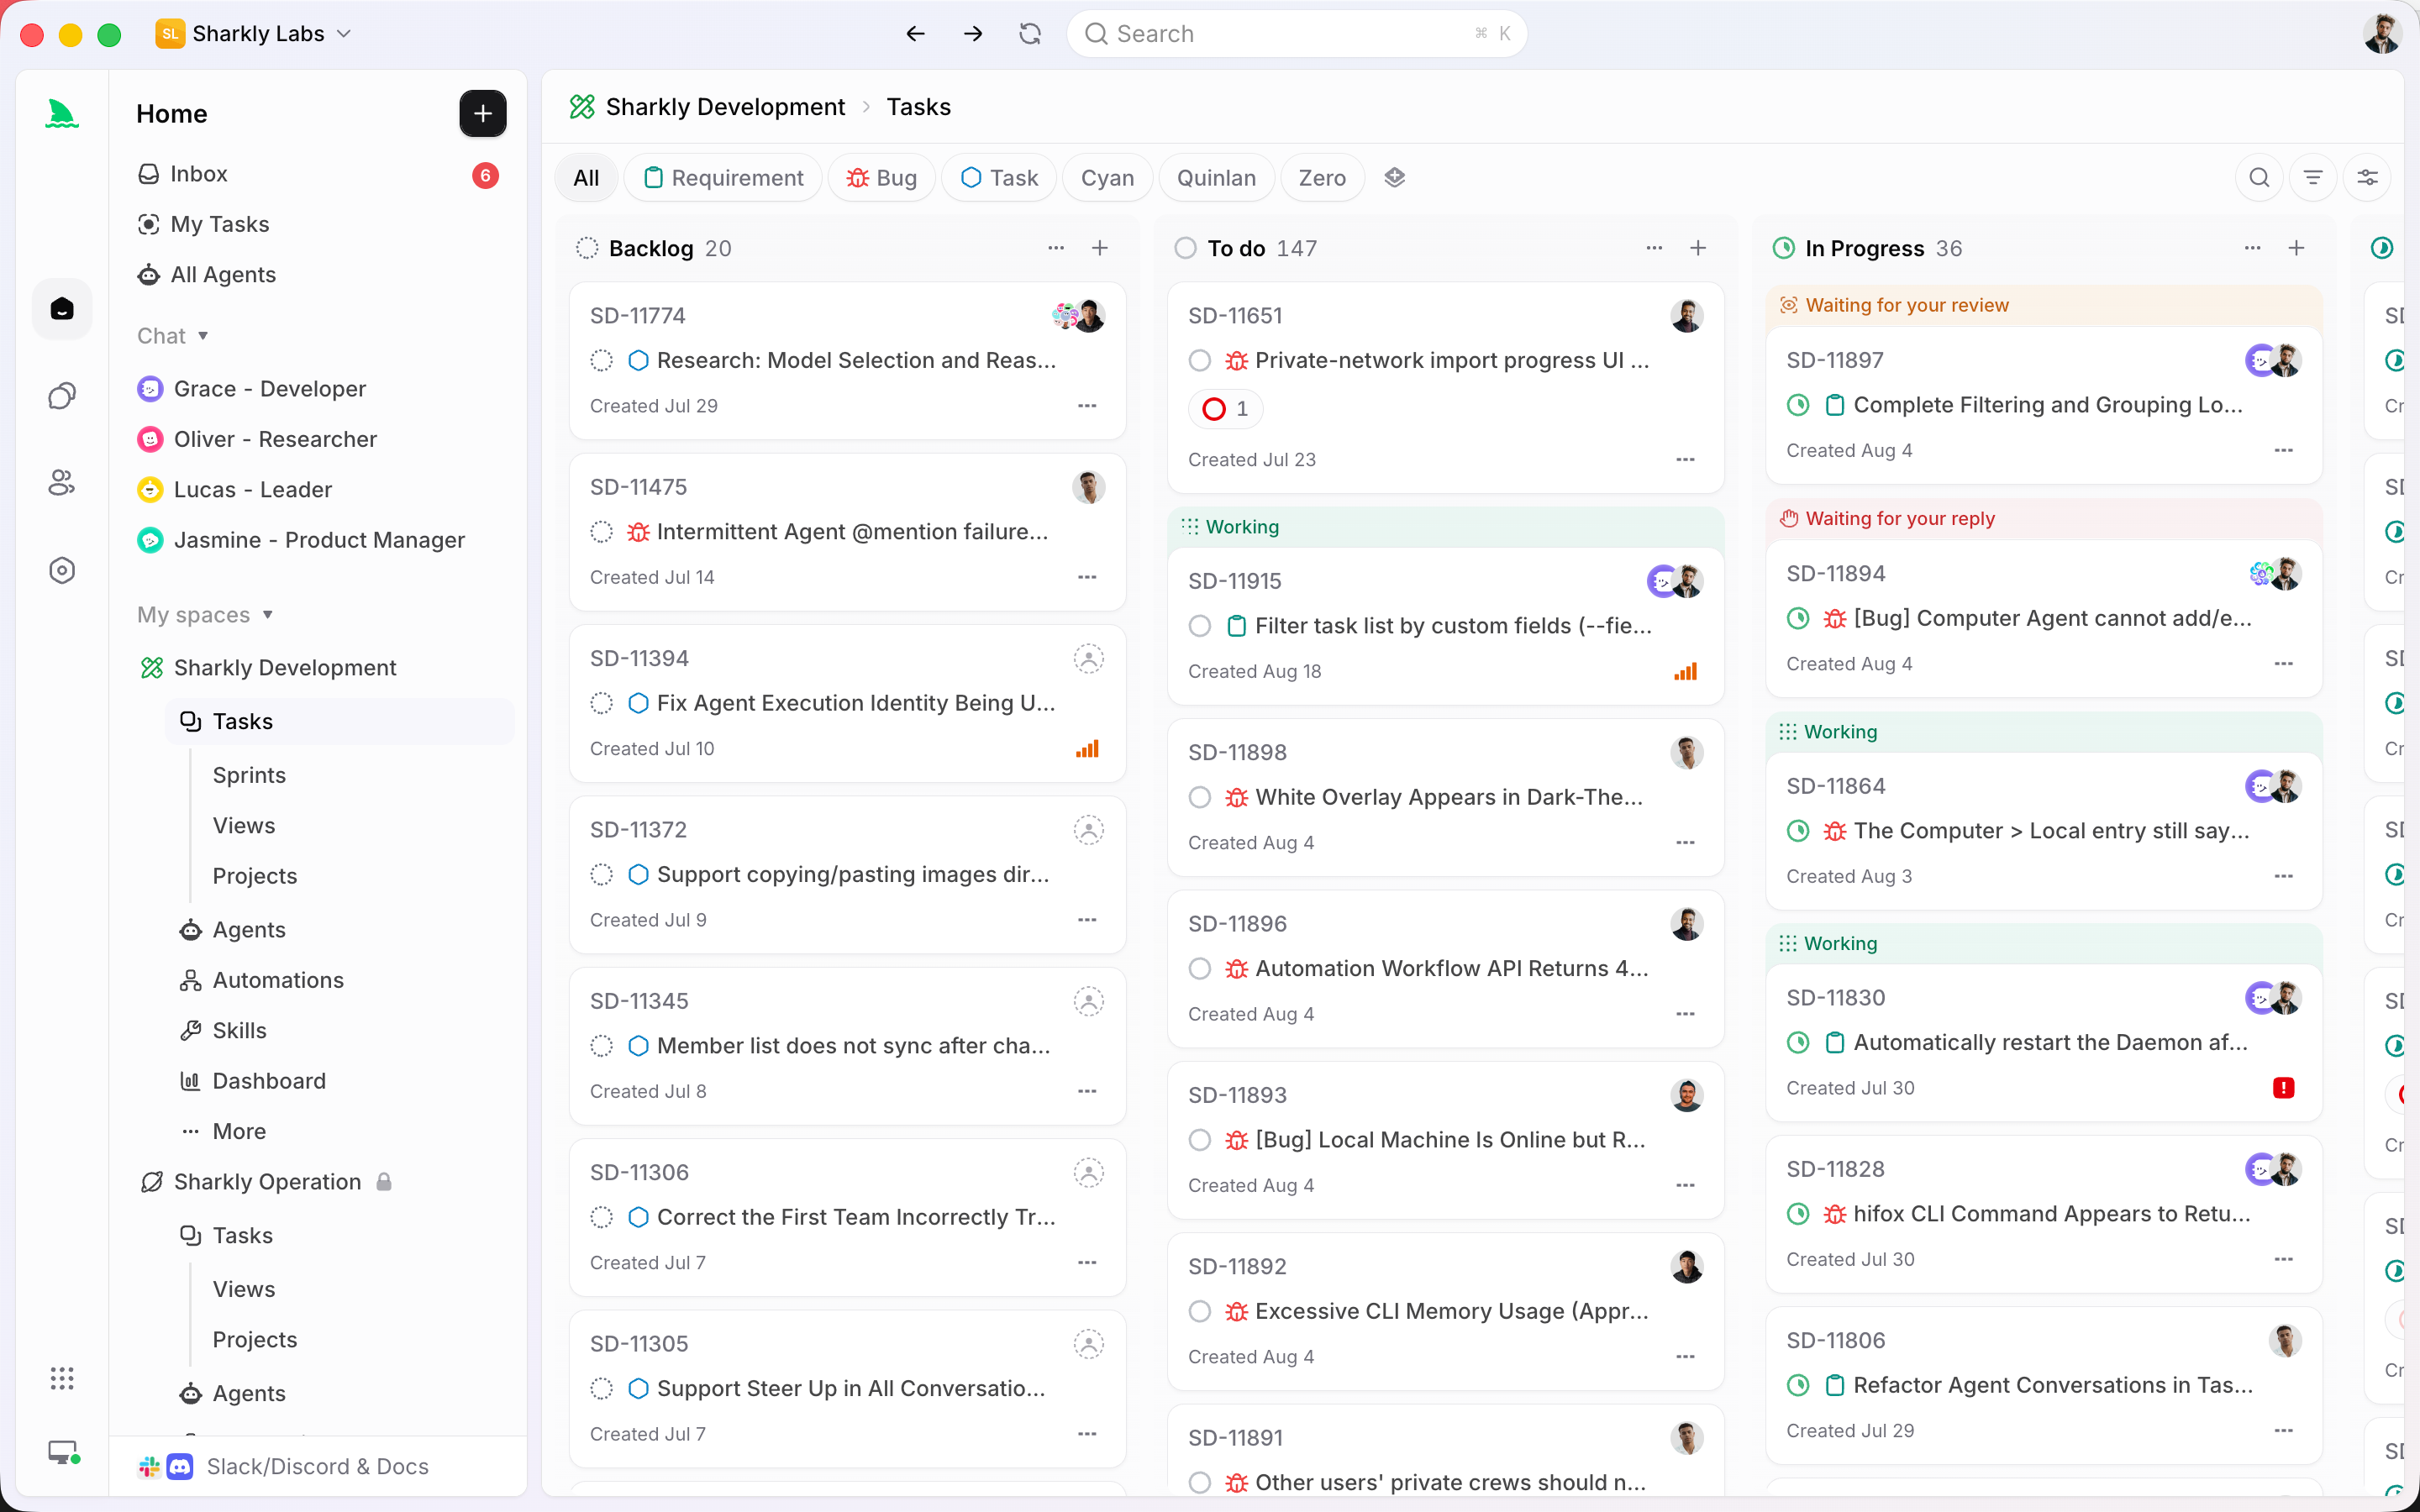
Ce guide présente le modèle opérationnel qui sous-tend tout cela : qui assigne le travail, qui l'exécute, qui le révise, qui l'accepte, les statuts et les points de contrôle qui séparent le travail de l'agent de celui de l'humain, et un exemple concret, du ticket à la PR fusionnée.
Réponse rapide
Révisez le code généré par IA au niveau du Task, pas du diff. Demandez à l'agent de joindre à un Task partagé un résumé des modifications, les résultats de typecheck/tests/build qu'il a exécutés et les limites connues, puis faites passer ce Task dans un statut de revue. Un humain lit les preuves en parallèle du diff, demande des modifications ou approuve, et prend la décision de fusion. Les agents produisent et vérifient ; les humains acceptent.
Pourquoi réviser le diff seul ne fonctionne pas
Lire du code est plus difficile que d'en écrire. C'est une réalité bien documentée de la revue de code : le relecteur dispose de moins de contexte que l'auteur, et quand l'auteur est un agent, l'écart est total. Un diff GitHub vous montre la destination, jamais le trajet. Vous ne pouvez pas voir que l'agent a d'abord tenté une couche de cache, rencontré une condition de concurrence, puis fait marche arrière. Vous ne pouvez pas voir qu'il a lancé la suite de tests et qu'un test instable a échoué, sans lien avec la modification.
Sans ce contexte, la revue se réduit à deux modes d'échec. Valider sans regarder revient à approuver du code d'apparence plausible qui casse discrètement un cas limite auquel l'agent n'a jamais pensé. Tout reconstruire vous oblige à refaire le raisonnement vous-même, et l'avantage de vitesse de l'agent disparaît. Aucune des deux approches ne tient l'échelle quand trois agents ouvrent des PR en même temps. La sortie de secours : rendre le travail de l'agent révisable, et pas seulement son résultat.
Ce que signifie vraiment « preuve au niveau du Task »
Une preuve au niveau du Task, c'est le dossier qu'un Agent joint à son Task : l'objectif sur lequel il a travaillé, la modification produite, les vérifications effectuées et les limites qu'il connaît. Au lieu d'un diff brut, vous obtenez un diff accompagné de sa traçabilité.
Concrètement, le dossier de preuves contient quatre éléments :
- L'objectif et les critères d'acceptation, dans la description du Task, pour que la revue se mesure à ce qui a été demandé et non à ce qui paraît raisonnable.
- Le résumé des modifications, dans les mots de l'agent : ce qu'il a touché et pourquoi.
- Les résultats de vérification : la sortie du typecheck, des tests et du build que l'agent a exécutés avant de passer la main.
- Les limites connues : les cas limites, les hypothèses et les suites à donner que l'agent a signalés au lieu de les cacher.
Tout cela revient dans le Task. Exécution, blocages, résultats et échanges de suivi vivent sur une seule chronologie : le relecteur ouvre un dossier unique au lieu de recoller une PR, un fil Slack et un prompt à moitié oublié. C'est la discipline qui sous-tend un flux de travail traçable des exigences au code : les preuves font partie de la livraison.
Le modèle opérationnel : qui assigne, qui exécute, qui révise, qui accepte
Une bonne revue repose sur des rôles clairs. Le contrat est simple : les agents explorent, exécutent, testent et rendent compte ; les humains donnent la direction, accordent l'autorité et acceptent le résultat. L'automatisation s'arrête là où le jugement de l'équipe est requis.
| Rôle | Qui | Mission |
|---|---|---|
| Assignateur | Une personne (généralement le Task Owner) | Décrit le besoin, fixe les critères d'acceptation, assigne le Task |
| Exécutant | Un Agent, sur un Computer connecté, via un Runtime | Prend le Task en charge, exécute dans un worktree isolé, joint les preuves |
| Relecteur | Une personne | Lit le diff au regard des preuves, demande des modifications ou approuve |
| Approbateur | Une personne (le Owner ou un approbateur désigné) | Prend la décision finale d'acceptation et de fusion/publication |
Sharkly ne remplace pas Claude Code, Codex ou les autres outils d'exécution. Il ajoute la couche partagée de Task, de Computer, de contexte et de revue autour des outils que votre équipe utilise déjà. Le runtime écrit le code ; Sharkly décide dans quelle file d'attente arrive la revue et quelles preuves doivent être présentes avant qu'un humain ne regarde. Pour aller plus loin sur le volet assignation, voir qui assigne et qui accepte le travail des agents.
Statuts et points de contrôle : les agents passent à Ready for review, les humains à Done
Le point de contrôle de revue est une frontière de statut. Dans Sharkly, chaque statut de tâche appartient à une catégorie fixe porteuse de sens pour le système : Backlog (en attente), Unstarted (prêt, non démarré), Started (en cours) et Completed (terminal). Plusieurs statuts visibles peuvent partager une même catégorie : le workflow d'un type de tâche peut donc faire passer Development et Ready for review comme deux statuts Started distincts avant que quoi que ce soit n'atteigne Completed.
C'est cette structure qui rend le point de contrôle réel. Un Agent peut faire passer un Task de Development à Ready for review, et laisser le Task en attente de revue humaine. Il n'a pas le droit de faire passer seul le Task dans un statut Completed. L'acceptation est une transition humaine, par conception.
| Statut | Catégorie | Qui le fait passer ici |
|---|---|---|
| Backlog | Backlog | Une personne, lorsqu'elle met le travail de côté |
| Todo | Unstarted | Une personne, quand le Task est prêt |
| Development | Started | L'Agent, quand il prend le Task en charge et le traite |
| Ready for review | Started | L'Agent, une fois les preuves jointes |
| Done | Completed | Une personne, après acceptation |
Configurez le workflow pour que la transition vers votre statut Completed exige une personne, et vous obtenez un point de contrôle de revue qui tient même quand les agents produisent plus vite que vous ne pouvez suivre. C'est la version mécanique du fait de garder un humain dans la boucle pour les agents de codage, et c'est là que vous décidez où arrêter les agents avant qu'ils ne fusionnent.
Un exemple concret : du ticket à la PR fusionnée
Prenons SH-312 : « Ajouter une limitation de débit sur le point de terminaison de recherche public, 60 requêtes par minute et par clé d'API. »
- Une personne crée SH-312 avec cet objectif et deux critères d'acceptation : les requêtes au-delà de la limite renvoient une erreur HTTP 429, et la limite s'applique par clé, pas par IP. Le Task démarre en Todo.
- Un Agent le prend en charge, le fait passer en Development et s'exécute dans un worktree isolé, pour que son checkout n'entre jamais en collision avec d'autres agents travaillant sur le même dépôt. (Les worktrees sont ce qui garde les exécutions parallèles propres ; voir un checkout par tâche.)
- L'Agent implémente un limiteur à seau de jetons, ouvre une PR et joint ses preuves à SH-312 : un résumé des modifications, le typecheck et les tests unitaires au vert, le résultat du build et une limite connue : « Le seau vit en mémoire du processus ; les compteurs se réinitialisent donc à chaque déploiement et ne sont pas partagés entre les instances. »
- L'Agent fait passer SH-312 en Ready for review. Le Task arrive dans la file d'attente d'un humain, avec le diff et les preuves réunis.
- Le relecteur lit d'abord la note sur les limites connues, juge que le seau en mémoire suffit pour l'instant et demande une modification : renvoyer l'en-tête
Retry-Aftersur une réponse 429. L'Agent applique la modification et joint la sortie de tests mise à jour. - Le relecteur approuve, fusionne la PR et fait passer SH-312 en Done, avec un ticket de suivi pour un limiteur partagé déjà lié.
La revue a pris quelques minutes, parce que le relecteur n'a jamais eu à reconstruire la modification : les preuves s'en sont chargées. C'est la même boucle que la gestion de projet Claude Code, de l'issue à la revue, le dossier de preuves rendant la revue rapide plutôt que bloquante.
Comment réviser les preuves rapidement, et quand alléger
Toutes les modifications ne méritent pas le traitement complet. Appliquez une règle de décision.
Allez-y à fond quand la modification touche à l'authentification, à la facturation, aux migrations de données, aux API publiques ou à tout ce qui est difficile à annuler : lisez le diff ligne par ligne, relancez les tests vous-même et confrontez la note sur les limites connues à vos propres cas limites. Allégez quand il s'agit d'un ajustement de texte, d'une refactorisation interne bien testée ou d'une mise à jour de dépendance avec des vérifications au vert : lisez le résumé, parcourez le diff, confirmez que la vérification est passée, puis approuvez.
Une checklist rapide pour une revue approfondie :
- Le diff satisfait-il chaque critère d'acceptation, et pas seulement le cas nominal ?
- L'agent a-t-il réellement exécuté les vérifications, ou s'est-il contenté de l'affirmer ? Vérifiez la sortie jointe.
- Lisez la note sur les limites connues. Une de ces limites est-elle bloquante plutôt qu'un simple suivi ?
- La modification reste-t-elle dans le périmètre de la demande, ou l'agent a-t-il touché des fichiers sans rapport ?
Si vous faites déjà tourner plusieurs agents de codage, c'est le workflow que Sharkly vous permet de piloter depuis un seul endroit : assignez le Task, laissez l'agent joindre ses preuves, révisez au point de contrôle. Vous pouvez assembler ces briques à la main avec des worktrees, des modèles de PR et un tableau de statuts, ou télécharger Sharkly et obtenir le Task, les preuves et le point de contrôle en un seul système.
FAQ
Qu'est-ce qu'une preuve au niveau du Task pour du code généré par IA ? C'est le dossier qu'un agent joint à son Task en plus du diff : l'objectif, un résumé des modifications, les résultats de typecheck/tests/build qu'il a exécutés et les limites connues. Réviser ce dossier est plus rapide et plus sûr que de réviser un diff seul.
Un agent IA peut-il approuver son propre code ? Non, et c'est tout l'intérêt d'un point de contrôle de revue. Un agent peut faire passer un Task en Ready for review, mais la transition vers un statut Completed est une décision humaine. Les agents produisent et vérifient ; les humains acceptent.
Comment réviser du code IA plus vite sans approuver à l'aveugle ? Adaptez l'effort au risque. Lisez les preuves pour chaque modification, mais réservez la lecture ligne par ligne et la relance des tests aux zones à haut risque comme l'authentification et les migrations. Voyez comment la capacité de revue évolue quand les agents dépassent les humains.
Est-ce que j'utilise encore des pull requests ? Oui. Les agents ouvrent de vraies pull requests sur GitHub ; la couche Task ajoute les preuves et le point de contrôle autour d'elles, pour que la PR ne soit pas le seul endroit où vit le contexte.


