
Quatre agents de codage terminent dans la même heure et ouvrent quatre pull requests. L'une touche un chemin de retry de facturation, une autre renomme un helper de test, une troisième ajoute une migration, la dernière corrige une faute de frappe dans un README. Le goulot d'étranglement n'est ni le code ni les tests. C'est la question à laquelle une personne répond avant même de lire le moindre diff : par laquelle commencer ? Nous avons déjà expliqué que la relecture humaine est le goulot d'étranglement dès que les agents tournent en parallèle. Cet article traite la partie mécanique du problème — ordonner la file d'attente — et la façon dont un modèle décisionnel comme Jev peut en décharger le relecteur sans pour autant s'approprier la relecture.
Qu'est-ce que Jev ?
Jev est un System One Model de TypeSafe AI : vous lui envoyez un état et un ensemble de questions typées, et il renvoie une réponse pour chaque question, assortie d'une probabilité calibrée, jamais de texte libre. Précision sur le nom : il s'agit bien du modèle Jev de TypeSafe, pas du YouTubeur ni du vaccin contre l'encéphalite japonaise. L'article de lancement de TypeSafe le résume ainsi : « de l'état non structuré en entrée, des décisions probabilistes typées en sortie ». L'API tient en un seul endpoint, POST https://api.typesafe.ai/v1/systemone, une clé Bearer, le modèle jev-latest, et trois types de questions : noul (probabilité oui/non), choice (un choix parmi 255 options maximum) et score (une position sur une grille de 2 à 10 niveaux). Texte uniquement, 64k tokens par requête dont 32k pour l'état, 0,042 $ par million de tokens d'entrée, sortie non facturée. Notre article jumeau sur Jev comme couche décisionnelle pour les agents de codage présente le modèle de façon générale ; ici, nous l'utilisons pour une seule tâche.
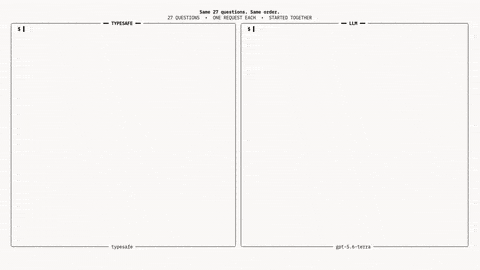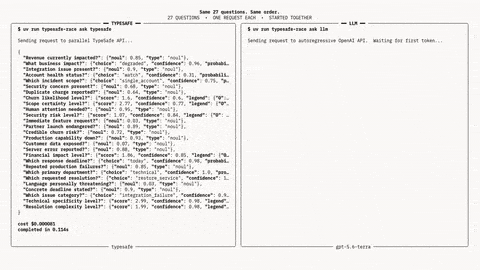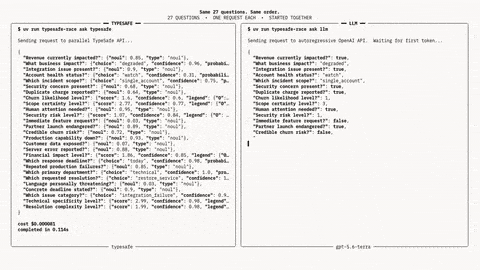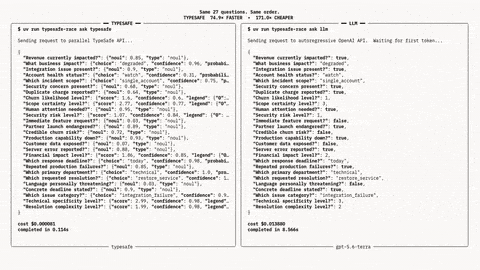
Les trois questions de relecture
Chaque PR ouverte par un agent de codage soulève les mêmes trois questions, et chacune correspond à une primitive. L'état est identique pour les trois : un résumé du diff, le résultat des tests et les chemins touchés. Pas le diff complet. Un résumé permet de rester dans le budget de la requête et amène le modèle à répondre à la question d'aiguillage plutôt qu'à refaire la relecture du code.
Cette modification doit-elle être lue par un humain avant la fusion ? Un noul. C'est le filtre. Il détermine si une PR entre dans la file humaine ou attend dans une voie à faible priorité.
Quel relecteur ou quelle file ? Un choice parmi les files que votre équipe utilise réellement. La réponse contient le choix retenu et la distribution complète : un partage 0,48 / 0,44 entre deux files vous indique que la PR chevauche une frontière de responsabilité, ce qui est déjà une information utile en soi.
Quel niveau de risque porte-t-elle ? Un score sur une grille ordonnée. Le résultat est une position pondérée par les probabilités : une modification peut ainsi se situer à 2,6, entre « changement de logique couvert par des tests » et « touche à l'authentification, à la facturation ou aux données ». Ce nombre sert de clé de tri pour la file.
Une seule requête répond aux trois :
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
La réponse contient trois réponses typées sous les mêmes clés. Pour SH-418, attendez-vous à needs_human proche de 0,9, à queue qui choisit payments, et à risk près du haut de la grille. Un correctif de retry de facturation avec des tests au vert passe quand même en tête de la file payments, car des tests au vert ne répondent pas à la question « un humain doit-il lire ceci ? ».
Les seuils et le rôle de chaque bande
Une probabilité ne devient utile que lorsque du code la transforme en action. Les bandes ci-dessous sont un point de départ, pas une recommandation pour votre dépôt ; ajustez-les après une semaine d'exécutions.
needs_human |
Action |
|---|---|
| 0,85 et plus | Tête de la file humaine, triée par risk décroissant |
| 0,15 à 0,85 | File humaine, triée par risk, après la bande ci-dessus |
| moins de 0,15 | Voie à faible priorité ; un humain fusionne quand même, à son propre rythme |
Deux règles garantissent l'honnêteté du dispositif. Premièrement, un risk en haut de la grille fait toujours passer une PR dans la bande de tête, quoi que dise needs_human. Un modèle qui n'est sûr qu'à 0,12 qu'une migration de schéma nécessite une relecture a vu un résumé de diff bien propre, pas la production. Deuxièmement, un choice dont les deux premières options se tiennent à moins de 0,1 l'une de l'autre est aiguillé vers les deux files, et non vers aucune. Une ambiguïté de responsabilité justifie que deux personnes jettent un œil à une modification, pas qu'aucune ne le fasse.
Remarquez ce qui reste à la personne dans toutes les bandes : la fusion. Les bandes changent l'ordre et la profondeur de lecture. Elles ne changent jamais qui décide.
Utiliser Jev pour la file, pas pour le verdict
Recourez à Jev lorsque la question admet un ensemble fixe de réponses, que l'état est un résumé fidèle et que vous voulez dépenser l'attention humaine dans un meilleur ordre : qui lit ceci, quand, dans quelle file. Ces questions se posent sur chaque PR et sont assez bon marché, à ce tarif, pour être posées à chaque exécution.
Faites appel à une personne, ou à un modèle de langage capable de montrer son raisonnement, lorsque la question est de savoir si la modification est correcte. Une probabilité qu'une modification doive être relue n'est pas une relecture. Jev n'a ni compilateur, ni lanceur de tests, ni accès au fichier qu'il évalue : seulement le résumé que vous lui avez envoyé. Un 0,96 sur « peut être fusionné sans risque » est une bonne raison de placer cette PR en haut de la liste de quelqu'un, jamais une raison de se passer de ce quelqu'un. La porte d'approbation se situe après le modèle, et le modèle n'a aucun moyen de l'ouvrir.
Ce que la communauté a construit
Quelques jours après le lancement, un développeur a publié jev-review, que son README décrit comme « un petit workflow de revue de code construit avec TypeSafe Jev ». L'outil analyse soit un diff Git, soit l'ensemble d'une base de code, contrôle la correction, la sécurité, la fiabilité, la compatibilité et la couverture de tests, sélectionne des régions de code avant d'en évaluer l'impact, applique des seuils et des politiques de workflow dans le code, et affiche les résultats dans un tableau de bord local. Le README reste prudent sur le périmètre : il qualifie le projet d'« expérience de composition de jugements typés rapides au sein d'un workflow de revue » et précise qu'il « n'intègre pas encore les diagnostics de compilateur, les analyseurs statiques, l'indexation de dépôt ni les explications générées ».
Deux aspects de cette conception méritent d'être repris : l'orchestration vit dans le code et Jev ne répond qu'à des questions délimitées ; et le travail est découpé en étapes — choisir une région, puis l'évaluer — plutôt qu'une seule question géante sur tout le diff. Jev est également disponible sur Vercel AI Gateway sous le nom typesafe-ai/jev via experimental_evaluate dans AI SDK 7 ; la documentation de Gateway précise que cet accès passe uniquement par l'AI SDK.
Où cela s'inscrit chez Sharkly
Sharkly n'appelle pas Jev à votre place et n'est pas un modèle décisionnel. C'est la couche partagée de tâches, de Computer, de contexte et de relecture autour des agents de codage que votre équipe utilise déjà. Ce dont une file classée a besoin de cette couche, c'est d'un endroit où s'exécuter et d'un endroit où atterrir.
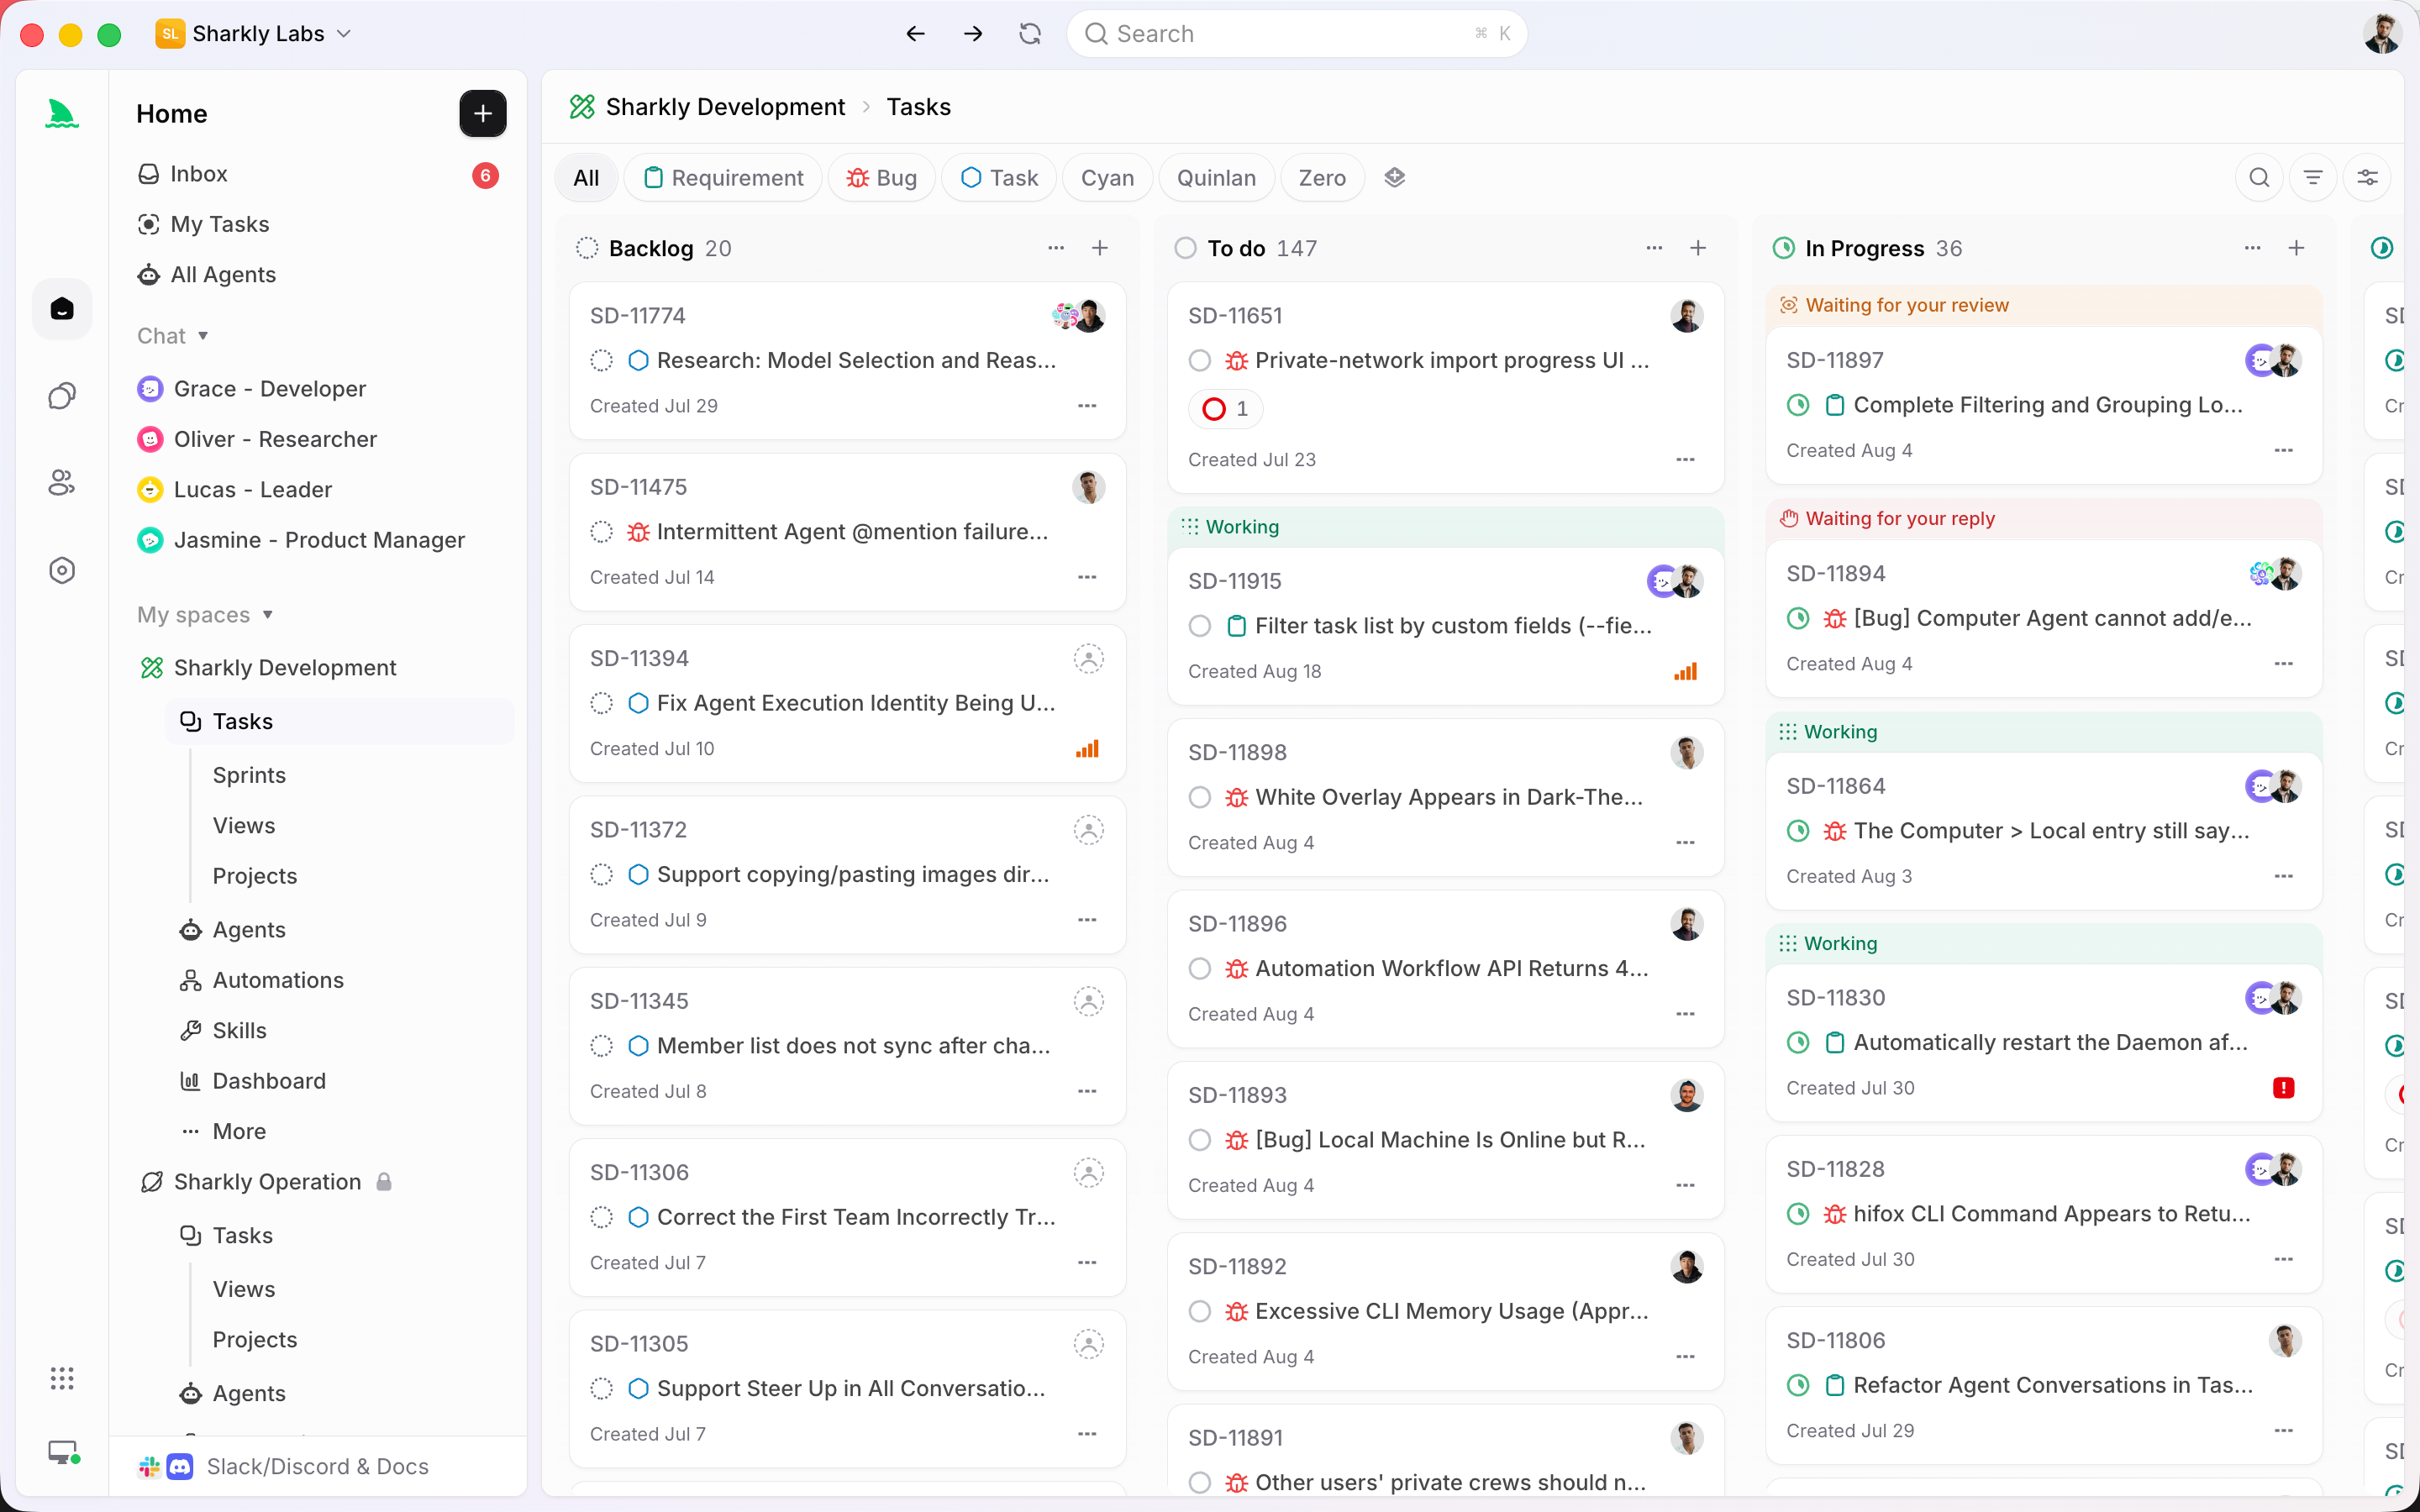
L'endroit où s'exécuter est une Automation : une règle rattachée à un Space qui lance un Agent avec un ensemble d'instructions sur un déclencheur, et l'un de ces déclencheurs est le passage d'une tâche dans un statut donné. Pointez-la vers le statut que vos Agents atteignent lorsqu'une PR est ouverte, et les instructions deviennent : lire le résumé de diff, le résultat des tests et les chemins touchés de la Task ; appeler Jev avec les trois questions ; réécrire les réponses et la bande en commentaire sur la Task ; poser un libellé pour la file. La documentation est explicite : une exécution terminée « ne garantit pas que tous les résultats métier en aval soient corrects », soit exactement la même limite que celle tracée par les bandes de relecture.
L'endroit où atterrir est la Task elle-même. La bande, la file et le score de risque reviennent dans la Task, là où le relecteur regarde déjà, à côté du résumé des changements et des résultats de vérification de l'exécution. La personne ouvre le tableau trié par risque et voit pourquoi chaque PR se trouve là où elle est. Les agents ouvrent la pull request, lancent les tests et rendent compte. Les humains lisent dans l'ordre suggéré par la file, puis acceptent ou rejettent. L'ordre vient d'une probabilité ; la décision, non.
Si vous faites déjà tourner plusieurs agents et que c'est la file de relecture qui fait mal, c'est exactement le workflow que met en place bien démarrer avec Sharkly : un Computer, un Agent, une Task avec les éléments de preuve dont un classement a besoin.
FAQ
Jev peut-il lire le diff complet plutôt qu'un résumé ?
Il accepte jusqu'à 32k tokens d'état, donc un petit diff passe. Envoyez quand même un résumé : les diffs d'agents explosent le budget, et un résumé maintient la question au niveau de l'aiguillage. Le diff complet, c'est ce que lit l'humain, accompagné des preuves au niveau de la tâche.
Et si l'agent a lui-même rédigé le résumé du diff ?
Le résumé peut alors être erroné à l'avantage de l'agent, et le classement en hérite. Privilégiez un résumé produit à partir du diff par une étape distincte, et laissez toujours un risk élevé primer sur un needs_human faible. Les limites de la revue de code par IA s'appliquent ici : le modèle peut classer ce qu'on lui montre, il ne peut pas vérifier ce qu'on ne lui montre pas.
Une bande basse signifie-t-elle que la PR est fusionnée automatiquement ?
Non. Une bande basse signifie qu'une personne la fusionnera plus tard, à son rythme, sans l'avoir lue en premier dans la file. La responsabilité de la fusion, comme celle du travail produit par l'agent, reste celle d'une personne nommée, dans toutes les bandes.
Jev est-il gratuit via Sharkly ?
Sharkly ne revend pas Jev ni aucun autre modèle ; vous utilisez votre propre clé TypeSafe ou Gateway, de la même façon que les exécutions sont facturées sur les abonnements rattachés à vos Runtimes. Sharkly est actuellement gratuit pour les organisations jusqu'à 5 personnes.


