
L’article de lancement de Muse Wonder par Meta décrit un comportement baptisé « Active Focus » : le modèle poursuit ses efforts vers un objectif complexe, teste des approches alternatives, surmonte les obstacles et, selon les termes de Meta, demande des éclaircissements si nécessaire tout en sollicitant une validation avant toute action importante. Meta recommande également une confirmation humaine avant chaque action lourde de conséquences, et son guide sur les agents de développement livre Muse Code avec les approbations et un bac à sable activés dès la première exécution.
C’est la bonne approche. Mais cela soulève une question que toute équipe faisant tourner des agents en parallèle ne connaît que trop bien : lorsque le modèle s’interrompt pour poser une question, qui est là pour y répondre, à quelle vitesse et avec quel contexte ? Une demande de validation qui atterrit dans un terminal que personne ne surveille, c’est une exécution bloquée. Une demande qui arrive dans une boîte de réception partagée, rattachée à la tâche d’origine, devient une étape de revue. Cet article explique comment mettre en place la seconde approche.
Ce que produit l’Active Focus
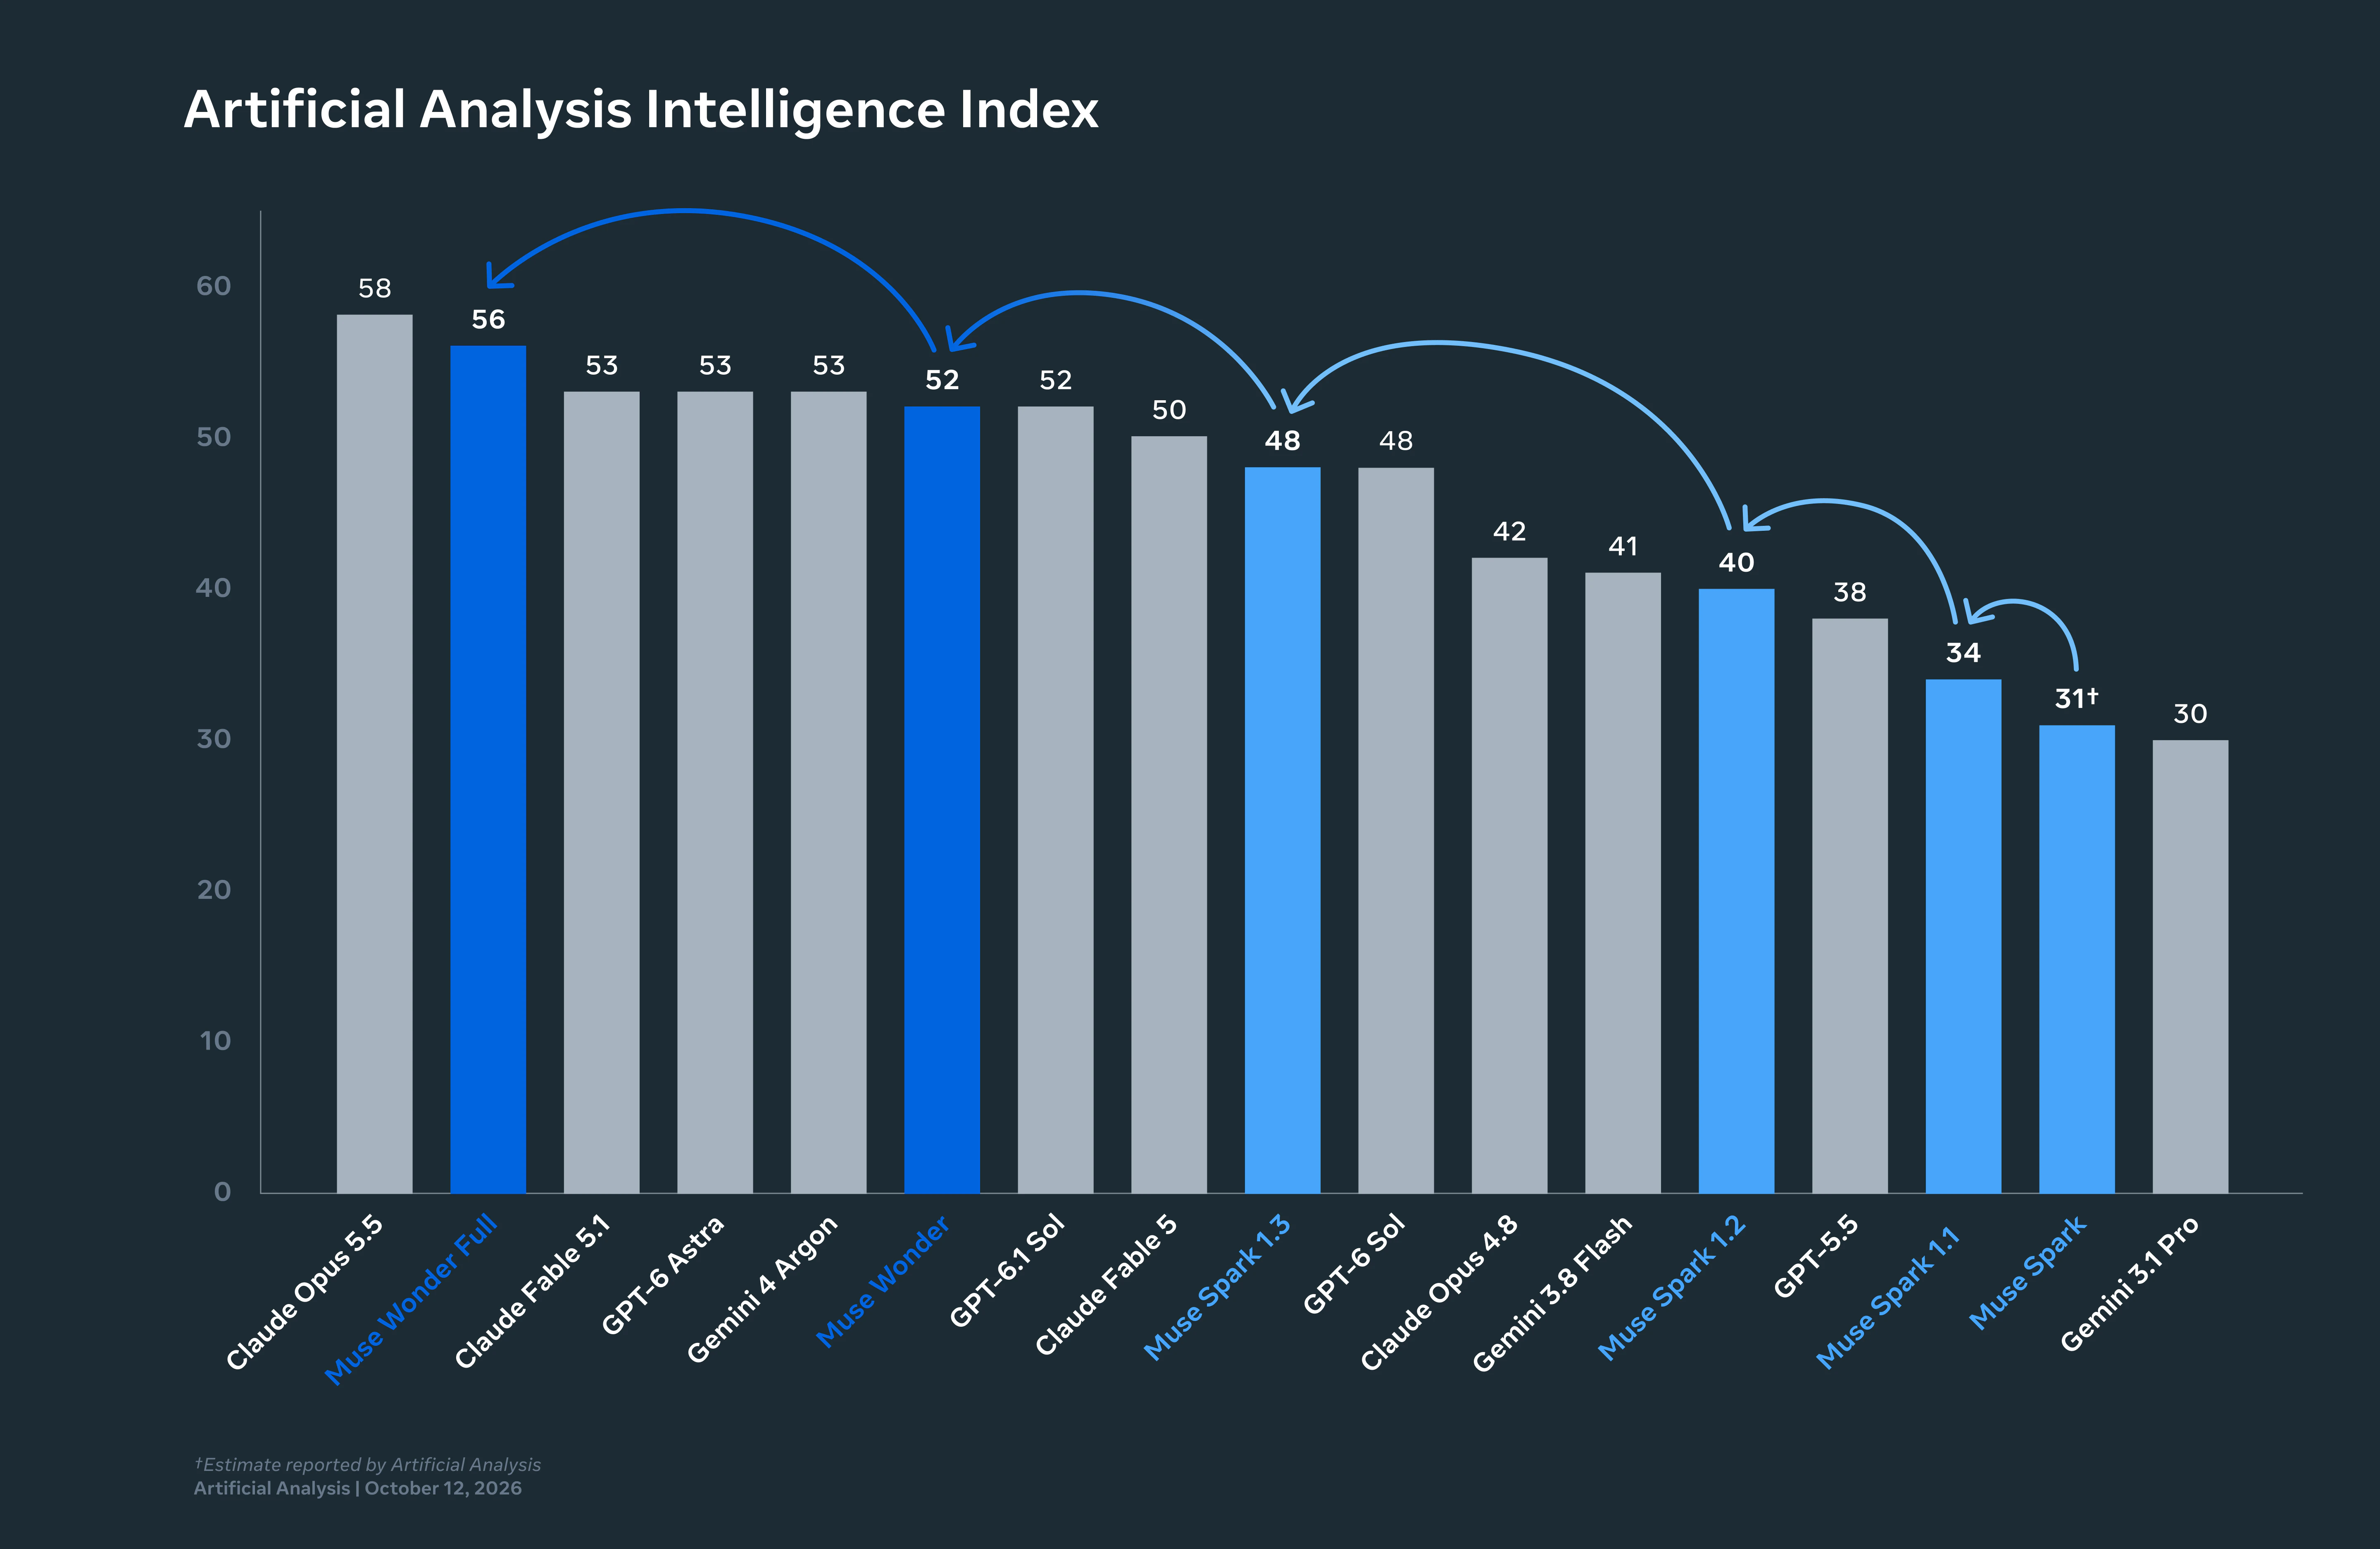
Meta a entraîné son modèle pour trois comportements précis et les évalue sur un benchmark interne nommé FocusBench, où Muse Wonder Full arrive en tête avec 54,2 % et la version de Wonder disponible via API atteint 44,9 %, derrière GPT-6 Astra et Claude Opus 5.5. Laissons les scores de côté ; ce sont ces comportements qui comptent sur un tableau de suivi :
- Persistance. Le modèle continue d’avancer malgré les échecs. Sur SWE-Marathon, le benchmark de codage sur des sessions longues, Wonder affiche un score de 53,1 contre 46,3 pour Opus 5.5. Des exécutions plus longues, davantage de tentatives, et donc plus de matière à relire.
- Demande d’éclaircissement. Le modèle pose des questions lorsque la tâche est ambiguë au lieu de deviner. Sur un tableau de tâches, cela prend la forme d’un commentaire ; dans un terminal, c’est une invite qui attend une saisie clavier.
- Points de contrôle. Le modèle s’interrompt avant une action qu’il juge importante. Les recommandations de Meta préconisent d’en faire une confirmation humaine pour toute action conséquente.
Chacun de ces points modifie la physionomie de la file d’attente de revue. La persistance augmente le volume par tâche. La clarification crée des interruptions. Les points de contrôle introduisent des décisions qui bloquent l’exécution tant que personne ne s’est prononcé.
Où atterrissent les demandes de validation
Dans Muse Code, une invite d’approbation s’affiche dans le terminal de l’utilisateur et l’exécution se met en pause. Les exécutions sans interface graphique (muse exec) ne disposent d’aucune invite interactive ; la documentation de Meta conseille donc d’adopter une stratégie capable d’aller à son terme de façon autonome, ou d’accepter que les actions en suspens ne soient jamais traitées. C’est le compromis incontournable : soit une personne est devant son clavier, soit le modèle s’exécute sans approbations, soit l’action attend indéfiniment.
Sur un tableau Sharkly, l’exécution est une tâche assignée à un agent sur une machine. Lorsque l’agent s’interrompt pour poser une question, celle-ci est ajoutée sous forme de commentaire à la tâche et transmise à la boîte de réception. La tâche conserve l’ensemble du contexte : la demande formulée, ce que l’agent a déjà accompli, le journal d’exécution des appels d’outils et les événements d’exécution. La personne qui s’en charge répond directement sur la tâche, et l’exécution peut reprendre avec un état préservé. Le point de contrôle reste une décision humaine ; mais une décision humaine avec un historique, une file d’attente et plusieurs interlocuteurs possibles.
C’est toute la différence entre un garde-fou et un blocage. Le comportement du modèle reste identique. C’est l’environnement mis en place qui détermine si un point de contrôle prend une minute ou une journée.
Rédiger les instructions de l’agent pour des points de contrôle utiles
Une demande de validation ne vaut que par la pertinence de la question posée. Définissez ce standard directement dans les instructions de l’agent :
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
La première règle fixe la limite. Le modèle de Meta décide de lui-même ce qui relève de l’important ; cette instruction lui indique ce qui compte pour l’équipe. La deuxième règle permet à quiconque de répondre au commentaire en trente secondes, même sans avoir suivi l’exécution. La troisième règle évite que le modèle ne demande confirmation pour tout et n’importe quoi — l’écueil typique qui transforme un agent prudent en source de nuisance. L’article sur les garde-fous pour Opus 5.5 aborde cette même limite sous l’angle des injections de prompts : le sas de revue constitue le véritable point de contrôle, quelles que soient les garanties affichées par le modèle.
Dimensionner la file d’attente
La persistance implique davantage de revues par tâche, pas moins. Anticipez ce besoin.
| Couloir | Exécution type | Ce qui arrive dans la file |
|---|---|---|
| Muse Wonder sur une tâche longue | De nombreuses étapes, plusieurs pistes abandonnées | Un diff plus long, des journaux plus volumineux, zéro à trois points de contrôle |
| Opus 5.5 sur la même tâche | Moins d’étapes, plus direct | Un diff plus court, ou une tâche rendue à moitié terminée |
| N’importe quel modèle, sans surveillance la nuit | Ce que la politique autorisait | Soit des actions bloquées, soit des actions que personne n’a confirmées |
Trois bonnes pratiques permettent de maintenir la file d’attente fluide. Attribuez les validations à un relecteur désigné par couloir plutôt qu’à toute l’équipe, afin qu’une question ne reste pas en suspens au sein d’un groupe. Configurez le délai d’expiration (timeout) par tâche de l’agent pour qu’une exécution bloquée sur un point de contrôle échoue de manière visible au lieu de rester active pendant des heures. Enfin, lisez le journal d’exécution et pas seulement le diff pour les sessions avec Wonder : le cheminement à travers trois tentatives infructueuses est précisément ce qu’apporte un modèle persistant, et c’est là que se nichent les erreurs subtiles. L’article Faire tourner des agents de code en votre absence aborde le travail de nuit, et La revue humaine reste le goulot d’étranglement détaille pourquoi rien de tout cela ne coûte moins cher avec un meilleur modèle.
À quoi ressemble une bonne demande de validation sur le tableau
Voici la forme que prennent les retours produits par les consignes ci-dessus, sous forme d’un commentaire de tâche qu’un relecteur peut traiter depuis son téléphone :
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
Quatre lignes, une décision, deux scénarios déjà anticipés. Le relecteur saisit « oui » ou « non, conserve-la » sur la tâche, l’exécution reprend et les journaux enregistrent l’auteur de la décision. Comparez cela avec une invite de terminal qui affiche Allow? [y/N] à une personne n’ayant pas assisté aux quarante étapes précédentes.
Deux ajustements une fois que le couloir a tourné pendant une semaine : si un relecteur prend en charge la majorité des validations, attribuez un second relecteur désigné à l’agent de ce couloir pour qu’une réunion l’après-midi ne bloque pas toutes les exécutions longues. Et si l’agent demande systématiquement confirmation pour un même type d’action, ce cas d’usage doit être inscrit dans les instructions sous forme d’approbation ou de refus permanent, plutôt que d’encombrer la file.
Le cas de l’interaction avec l’ordinateur
Meta compte l’utilisation de l’ordinateur (« computer use ») parmi les capacités de Wonder : manipuler des navigateurs, des environnements de bureau et des applications mobiles. C’est là que les points de contrôle sont les plus cruciaux et qu’une invite de terminal s’avère la moins adaptée, car l’action correspond à un clic sur un écran que le relecteur ne voit pas. Les règles exposées dans l’article sur les garde-fous du « computer use » avec Astra s’appliquent ici : l’agent s’exécute sur une machine choisie par l’équipe, la demande de validation précise l’écran et l’action en jeu, et la personne qui confirme peut consulter le journal de la tâche avant de donner son accord. Un modèle demandant l’autorisation de cliquer sur « Envoyer » n’est sécurisé que si l’on peut savoir ce que déclenche ce bouton.
Ce que cette approche n’est pas
L’Active Focus est un comportement du modèle, et les comportements d’un modèle ne constituent en rien des garanties. La fiche technique de Meta précise elle-même que les modèles peuvent commettre des erreurs sur des tâches en plusieurs étapes inédites, et son rapport complet sur la sécurité est toujours attendu. Le point de contrôle est une fonctionnalité qui vient enrichir un bon système de revue ; il ne le remplace pas. Une équipe qui interprète la formulation « sollicite une validation avant les actions importantes » comme un feu vert pour faire tourner des agents sans surveillance commet un contresens. Une équipe qui associe chaque validation à une tâche, un relecteur et un délai d’expiration a conçu le système exact pour lequel cette fonctionnalité a été pensée.
Rien de tout cela n’apparaît sur la facture de Sharkly. L’utilisation du modèle passe par la clé Meta configurée sur la machine. Le modèle a évolué le 12 octobre. Le contexte, l’avancement, les blocages, les résultats et la revue humaine sont restés visibles, de la demande initiale jusqu’au déploiement. Vous pouvez concevoir cette organisation manuellement à l’aide d’arbres de travail (worktrees), ou vous appuyer sur Sharkly pour gérer ce flux.


