
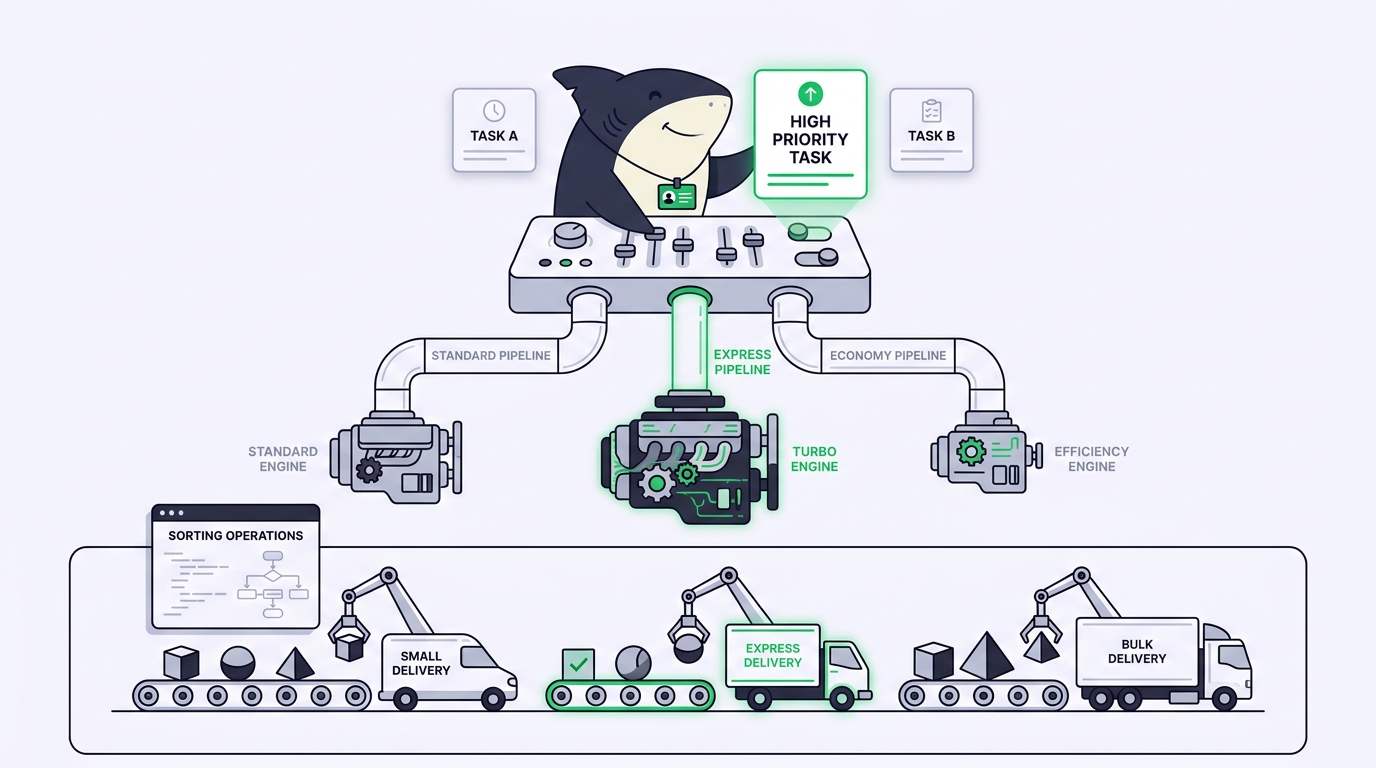
TL;DR : Arrêtez de chercher le modèle unique qui serait le meilleur. Faites plutôt correspondre chaque modèle à la forme de la tâche qui se présente : un raisonnement profond pour l'architecture et les refactorings multi-fichiers, un modèle rapide et économique pour le code répétitif et les tests, un grand contexte pour les questions portant sur l'ensemble du dépôt, un suivi d'outils régulier pour les modifications en plusieurs étapes. Choisir terminal par terminal fonctionne avec un ou deux agents. Dès que vous enchaînez plusieurs tâches sur plusieurs dépôts, cette correspondance doit vivre dans un Agent enregistré, et non dans votre tête. Voici la cartographie, un exemple concret et une checklist à appliquer dès aujourd'hui.
Vous avez cinq terminaux ouverts. Dans l'un, un refactoring coriace ; dans l'autre, une série de tests unitaires à produire ; dans un troisième, des questions sur une base de code dont vous ne vous souvenez qu'à moitié ; dans le quatrième, un test d'intégration instable à traquer ; dans le dernier, un symbole à renommer dans quarante fichiers. Chacun pose la même question silencieuse : quel modèle doit s'en charger ? Confiez le renommage à un modèle de raisonnement lourd et vous brûlez des tokens et des minutes sur un travail qu'un modèle rapide expédie proprement. Confiez le changement d'architecture à un modèle rapide et il passe à côté d'une dépendance située trois fichiers plus loin. La complainte récurrente n'est que rarement « les modèles sont mauvais ». C'est « je ne sais pas lequel utiliser ».
La solution n'est pas un classement. Les classements bougent toutes les quelques semaines, et le vainqueur d'un benchmark généraliste est souvent le mauvais choix pour votre tâche précise. La démarche qui tient dans la durée consiste à faire correspondre le modèle à la forme de la tâche : quelle profondeur de raisonnement elle exige, quel volume de contexte il doit retenir, avec quelle fiabilité il doit suivre les outils, et combien chaque exécution vous coûtera. Ces propriétés-là ne bougent quasiment pas, même quand les noms des modèles changent.
C'est là qu'une couche dédiée aux tâches gagne sa place. Sharkly est une plateforme tout-en-un de pilotage et de gestion d'Agents. Elle se place au-dessus de vos agents de codage, de sorte que « quel modèle pour quelle tâche » cesse d'être une décision à reprendre dans chaque terminal. Vous enregistrez la décision une fois pour toutes sous forme d'Agent — une configuration réutilisable d'un rôle, d'un runtime et de ses règles — puis vous assignez la Tâche à l'Agent dont le profil correspond. Vous avez déjà des agents de codage. Sharkly en fait une équipe.
Adapter le modèle à la forme de la tâche, pas au classement
Le choix d'un modèle, c'est en réalité quatre questions, à se poser dans l'ordre.
- Profondeur de raisonnement. La tâche exige-t-elle une planification en plusieurs étapes à travers plusieurs fichiers, ou s'agit-il d'une modification locale et mécanique ? L'architecture, les refactorings délicats et le débogage de cause racine récompensent un modèle de raisonnement plus puissant. Les renommages, le formatage et l'échafaudage, non.
- Taille du contexte. Le modèle doit-il retenir d'un coup tout un dépôt, une longue spécification ou un journal volumineux ? Les questions portant sur l'ensemble de la base de code et les grosses migrations récompensent un modèle à grand contexte, même s'il raisonne un cran moins profondément.
- Fiabilité dans le suivi des outils. Le travail en plusieurs étapes (modifier, lancer les tests, lire la sortie, modifier à nouveau) tient ou s'effondre selon la constance avec laquelle le modèle utilise les outils sans sortir du script. Un modèle qui raisonne brillamment mais oublie de lancer le test est ici moins bon qu'un modèle plus régulier.
- Vitesse et coût. Le travail volumineux et à faible enjeu (tests, code répétitif, docstrings) doit aller au modèle le plus rapide et le moins cher qui franchit la barre. Gardez le raisonnement coûteux pour les tâches qui en dépendent.
Utilisez un modèle de raisonnement lourd quand une erreur vous coûte un après-midi de débogage. Utilisez un modèle rapide et économique quand la tâche est mécanique et facile à vérifier. La plupart du temps, vous avez besoin des deux, sur des tâches différentes, en même temps. C'est pourquoi un réglage global unique du modèle sonne faux : il impose une seule réponse à des tâches qui en veulent différentes.
Une cartographie approximative, du type de tâche au rôle du modèle
Les noms de tâches ci-dessous survivront à n'importe quelle version de modèle. Lisez la fiche modèle actuelle de l'éditeur avant d'associer une catégorie à un nom, puis gardez la catégorie.
| La tâche qui se présente | À optimiser | Rôle du modèle |
|---|---|---|
| Architecture, refactoring multi-fichiers, revue de conception | Profondeur de raisonnement | Raisonneur lourd |
| Débogage de cause racine, chasse aux tests instables | Raisonnement + outils réguliers | Raisonneur lourd |
| Q&R sur tout le dépôt, grosse migration, travail sur de longues spécifications | Taille du contexte | Modèle à grand contexte |
| Tests unitaires, code répétitif, docstrings, échafaudage | Vitesse et coût | Modèle rapide et économique |
| Renommage mécanique, formatage, édition en masse | Vitesse | Modèle rapide et économique |
| Boucle d'agent en plusieurs étapes (modifier, tester, recommencer) | Fiabilité dans le suivi des outils | Utilisateur d'outils régulier |
Deux remarques honnêtes. Premièrement, « lourd » ne veut pas dire « toujours meilleur ». Sur un renommage, un modèle de raisonnement profond est plus lent, plus cher et pas plus juste qu'un modèle rapide. Deuxièmement, un runtime comme Claude Code, Codex ou Gemini CLI embarque son propre modèle par défaut, et l'usage du modèle se poursuit via les abonnements ou les clés API configurés dans l'outil : vos vrais choix sont donc les modèles que votre équipe paie déjà, associés à ces catégories. Les benchmarks publics de tâches comme SWE-bench vous indiquent en gros dans quel palier se situe un modèle, pas quel modèle votre tâche exacte réclame.
Là où le choix d'un modèle par terminal cesse de passer à l'échelle
Avec un ou deux agents, le choix manuel fait l'affaire. Vous ouvrez un terminal, réglez le modèle, et vous vous souvenez de ce qui est où, puisqu'il n'y en a que deux. La configuration qui fonctionne aujourd'hui, c'est une personne et deux ou trois outils.
Les ennuis commencent avec le volume. Lancez six tâches sur trois dépôts et la correspondance modèle-tâche ne vit plus que dans votre tête : quel terminal est le moins cher, quel dépôt vous avez basculé sur le raisonneur mardi dernier, pourquoi la migration se traîne (vous l'avez laissée sur le modèle rapide). Quand un collègue reprend votre travail, la correspondance ne suit pas la tâche ; elle reste dans votre mémoire, et les résultats se dispersent dans des terminaux privés au lieu de revenir dans un espace partagé.
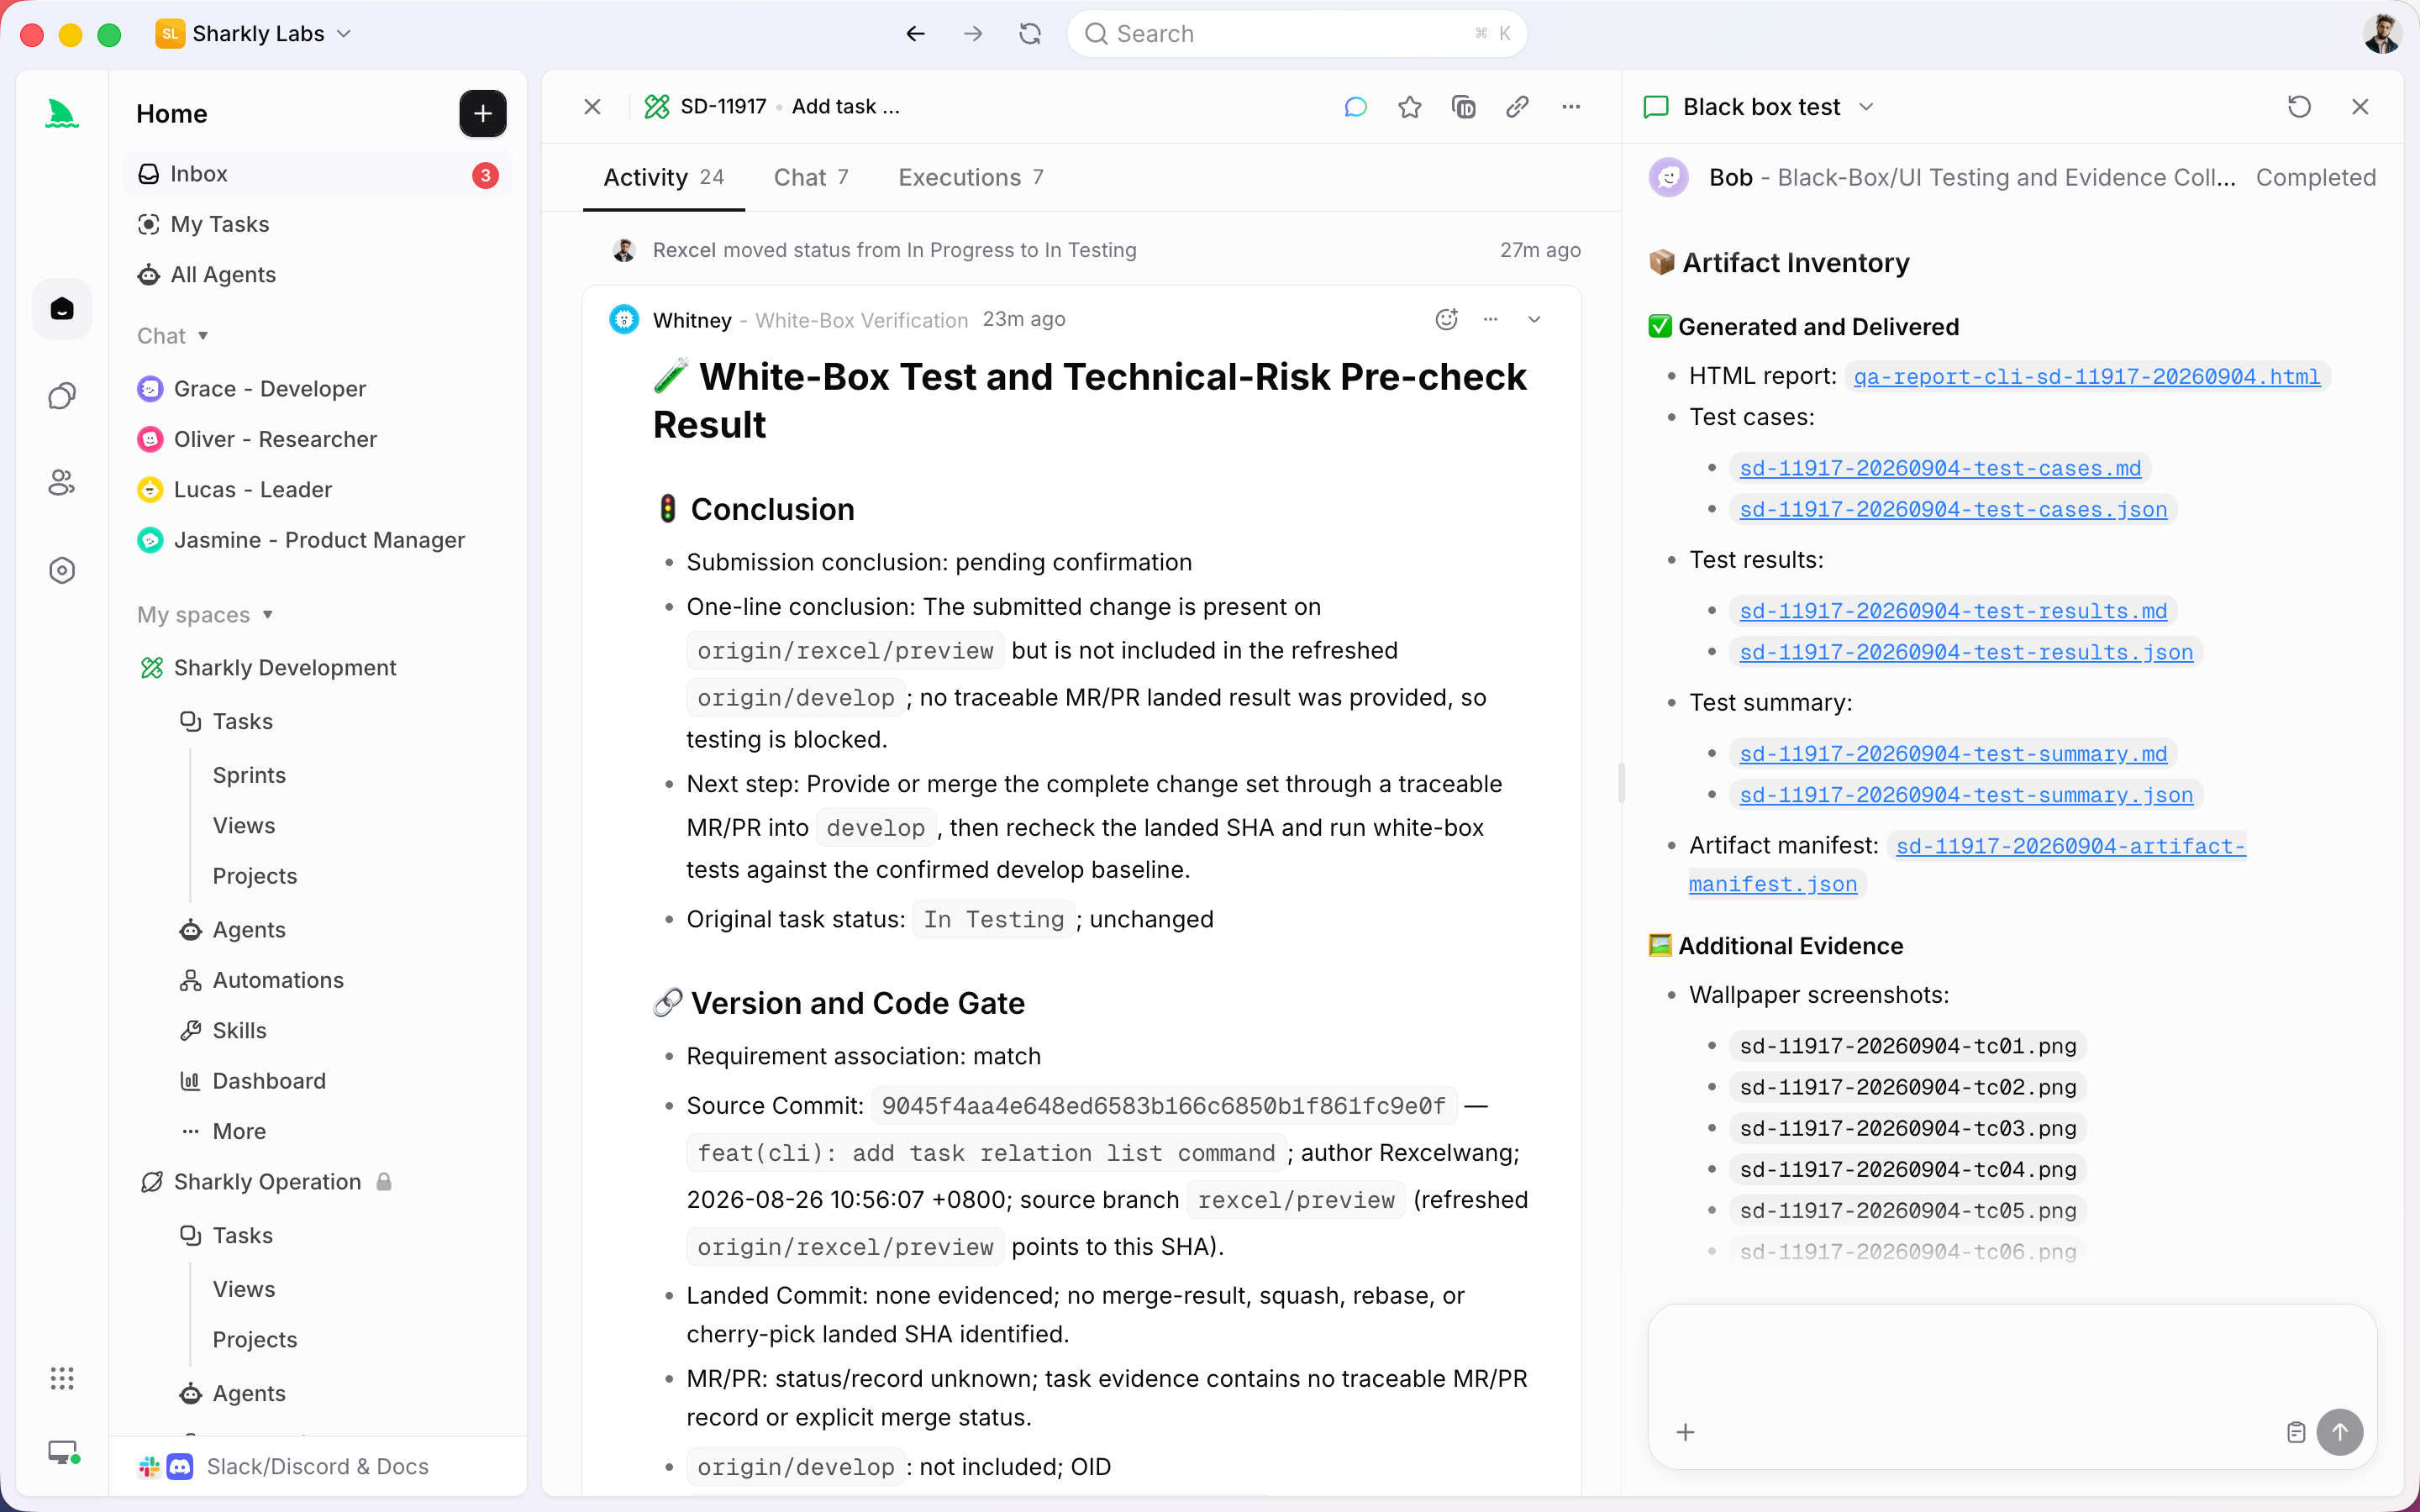
Un Agent est une configuration enregistrée de la manière dont un type de travail doit être traité : un rôle, un runtime et son modèle, ainsi que les règles qui les accompagnent. Au lieu de redécider du modèle à chaque terminal, vous créez l'Agent une fois pour toutes (« Rédacteur de tests » sur un modèle rapide, « Refactoreur » sur un raisonneur) et vous assignez la Tâche à l'Agent dont le profil convient. Le choix du modèle devient réutilisable, et non un jeu de mémoire. Les Agents font la recherche, exécutent, testent et rendent compte ; les humains donnent la direction et valident le résultat. Exécution, blocages et résultats reviennent à la Tâche, si bien que le raisonnement derrière chaque choix de modèle reste visible de la demande à la livraison, et non enfoui dans un historique de terminal.
Sharkly ne remplace ni Claude Code, ni Codex, ni les autres outils d'exécution. Il ajoute la couche partagée de tâches, de contexte et de revue autour des modèles que votre équipe utilise déjà. Si vous ne lancez jamais qu'un seul agent dans un seul terminal, vous n'en avez pas besoin. Dès que vous faites tourner plusieurs agents en parallèle, la décision d'appariement des modèles est précisément ce qui mérite d'être enregistré.
Un exemple concret : trois tâches, trois Agents
Imaginons qu'un sprint dépose trois tâches dans la file.
- SH-312 : renommer
UserSessionenAuthSessiondans tout le dépôt. Mécanique, facile à vérifier. Orientez-la vers un Agent « Renommeur » sur un modèle rapide et économique. Il modifie, lance le vérificateur de types et renvoie un diff propre. Dépenser des tokens de raisonneur ici n'apporte rien. - SH-318 : le tunnel de paiement débite deux fois lors d'un nouvel essai. Débogage de cause racine à travers plusieurs services. Orientez-la vers un Agent « Débogueur » sur un raisonneur lourd, avec un usage régulier des outils. Il doit planifier, lire les journaux, formuler une hypothèse et la tester. Un modèle rapide se contenterait ici de deviner et ferait perdre un cycle de revue.
- SH-324 : répondre à « comment notre facturation se réconcilie-t-elle avec Stripe ? » à partir de la base de code. Question portant sur tout le dépôt. Orientez-la vers un Agent « Analyste de code » sur un modèle à grand contexte, capable de retenir les fichiers pertinents d'un coup.
Chaque Agent s'exécute dans son propre worktree isolé, de sorte que trois modèles traitent trois tâches en même temps sans se marcher sur les pieds. Chaque résultat revient à sa Tâche avec un résumé des modifications et les preuves associées. Vous relisez trois livraisons terminées, et non trois terminaux que vous devez reconstituer de mémoire. L'automatisation s'arrête là où votre jugement est requis : vous acceptez, demandez des modifications ou décidez de la fusion.
La checklist à appliquer dès aujourd'hui
Parcourez-la avant votre prochaine série de tâches confiées aux agents.
- [ ] Pour chaque tâche, nommez d'abord sa forme : forte en raisonnement, forte en contexte, forte en boucles d'outils, ou volumineuse et mécanique.
- [ ] Assignez le modèle le moins cher qui franchit la barre pour cette forme. Réservez le raisonneur aux tâches où une erreur coûte vraiment du temps.
- [ ] Confiez le travail à grand contexte à un modèle à grand contexte, et non à votre raisonneur préféré par habitude.
- [ ] Pour les boucles en plusieurs étapes, privilégiez la fiabilité dans le suivi des outils plutôt que le rang brut au benchmark.
- [ ] Consignez la correspondance une fois pour toutes sous forme d'Agent réutilisable par rôle, pour que vous et vos collègues cessiez de la redécider terminal par terminal.
- [ ] Gardez un humain pour la validation finale. Le modèle choisit le chemin ; vous approuvez le résultat.
Faites correspondre le modèle à la tâche, enregistrez cette correspondance sous forme d'Agent, et la question qui a ouvert cet article (« lequel utiliser ? ») ne se pose plus qu'une fois par rôle, au lieu d'une fois par terminal.
Si vous voulez continuer à utiliser plusieurs agents de codage plutôt que de tout miser sur un seul modèle, c'est exactement le problème autour duquel Sharkly a été conçu. Vous pouvez choisir un modèle à la main dans chaque terminal, ou piloter tout le flux de travail au même endroit et laisser chaque résultat revenir à la Tâche.
FAQ
Ne devrais-je pas simplement utiliser le modèle le mieux classé pour tout ? Non. Le meilleur modèle généraliste est plus lent et plus cher que nécessaire sur du travail mécanique, et pas plus juste pour autant. Le classement vous dit dans quel palier se situe un modèle ; la forme de votre tâche vous dit de quel palier vous avez besoin. Faire coïncider les deux vaut mieux que de se rabattre par défaut sur le vainqueur du classement.
Comment choisir un modèle quand je ne connais pas encore la difficulté de la tâche ? Commencez petit et montez en puissance. Confiez d'abord la tâche à un modèle rapide. S'il cale, devine ou échoue à la revue, c'est le signal que la tâche est exigeante en raisonnement : faites-la passer à un modèle plus puissant. C'est à l'étape de revue avec humain dans la boucle que vous repérez l'inadéquation avant qu'elle ne soit livrée.
Est-ce Sharkly qui choisit le modèle à ma place ? Sharkly ne choisit pas le modèle de lui-même. Vous liez un rôle à un runtime et à son modèle lorsque vous créez un Agent, puis vous assignez les Tâches à l'Agent dont le profil correspond au travail. Le choix reste le vôtre ; Sharkly le rend réutilisable et conserve le résultat de chaque exécution sur la Tâche, plutôt que dans un terminal privé.


