
この問いへの答えは2つに分かれます。請求項目そのものが2つに分かれているからです。プラットフォーム側の費用は実際にゼロに抑えられます。Sharklyは5人以下の組織なら無料で利用でき、モデルのトークン販売も行っていません。しかし、人間が別の作業をしている間も動き続けるCrew(クルー)にとって、モデル側の費用をゼロにすることは不可能です。2026年9月22日に各AIラボからリリースされた3つのモデルのうち、完全無料で利用できるルートが存在するのは1つだけです。それはChatGPTデスクトップアプリのFreeプランおよびGoプランのユーザー向けに提供されているGPT-6 Lunaですが、デスクトップアプリは人間が着席して使うためのものであり、自律的な実行処理で利用できる認証情報ではありません。連携や調整は無料、実行にはわずかなコストがかかり、そして成果物のレビューはいずれにしても決して無料ではありません。
Crewのコストには、多くの人が混同しがちな2つの項目があります。作業の割り当て・追跡・承認を行うプラットフォームの「シート費用」と、実際の処理を実行するRuntimeの「トークン費用」です。この2つは連動していません。シート費用は公開されている定額料金です。一方、トークン費用は従量課金であり、各ユーザーが契約しているプロバイダーのアカウントに請求されるもので、2026年9月22日に劇的に値下がりしました。
要点まとめ
Sharklyのシート費用は5人以下なら0ドル、それを超える場合は年払い請求で1ユーザーあたり月額7ドルとなっており、モデルの利用にはBYOK(APIキー持ち込み)方式を採用しています。モデル側を見ると、GPT-6 LunaはChatGPTデスクトップアプリのFreeおよびGoユーザー向けに無料で提供されている一方、GPT-6 Solは無料ではなく、Claude Opus 5.5はClaude Freeでは一切提供されていません。デスクトップアプリの利用権限では、人間の手を介さない無人実行を開始することはできません。真に安価な選択肢はAPIの活用です。Lunaは100万トークンあたり0.10ドル/0.50ドル、Solは2ドル/10ドルで、キャッシュされた入力の読み取りには90%の割引が適用されます。しかし、これらの恩恵をもってしても、これまで無料枠など一度も存在したことがない費用項目――すなわち「成果物をレビュー・承認する人間のコスト」――を削減することはできません。
シート費用:プラットフォームにおける「無料」の定義
Sharklyの料金体系を決める変数はただ1つ、「人数」です。Freeプランは5人以下の組織なら0ドルです。それを超える組織向けのTeamプランは、年払いで1ユーザーあたり月額7ドルとなります。Self-hosted(セルフホスト)プランは個別見積もりです。FreeとTeamは機能差のない同一の製品であるため、プランによって機能が制限されることはありません。
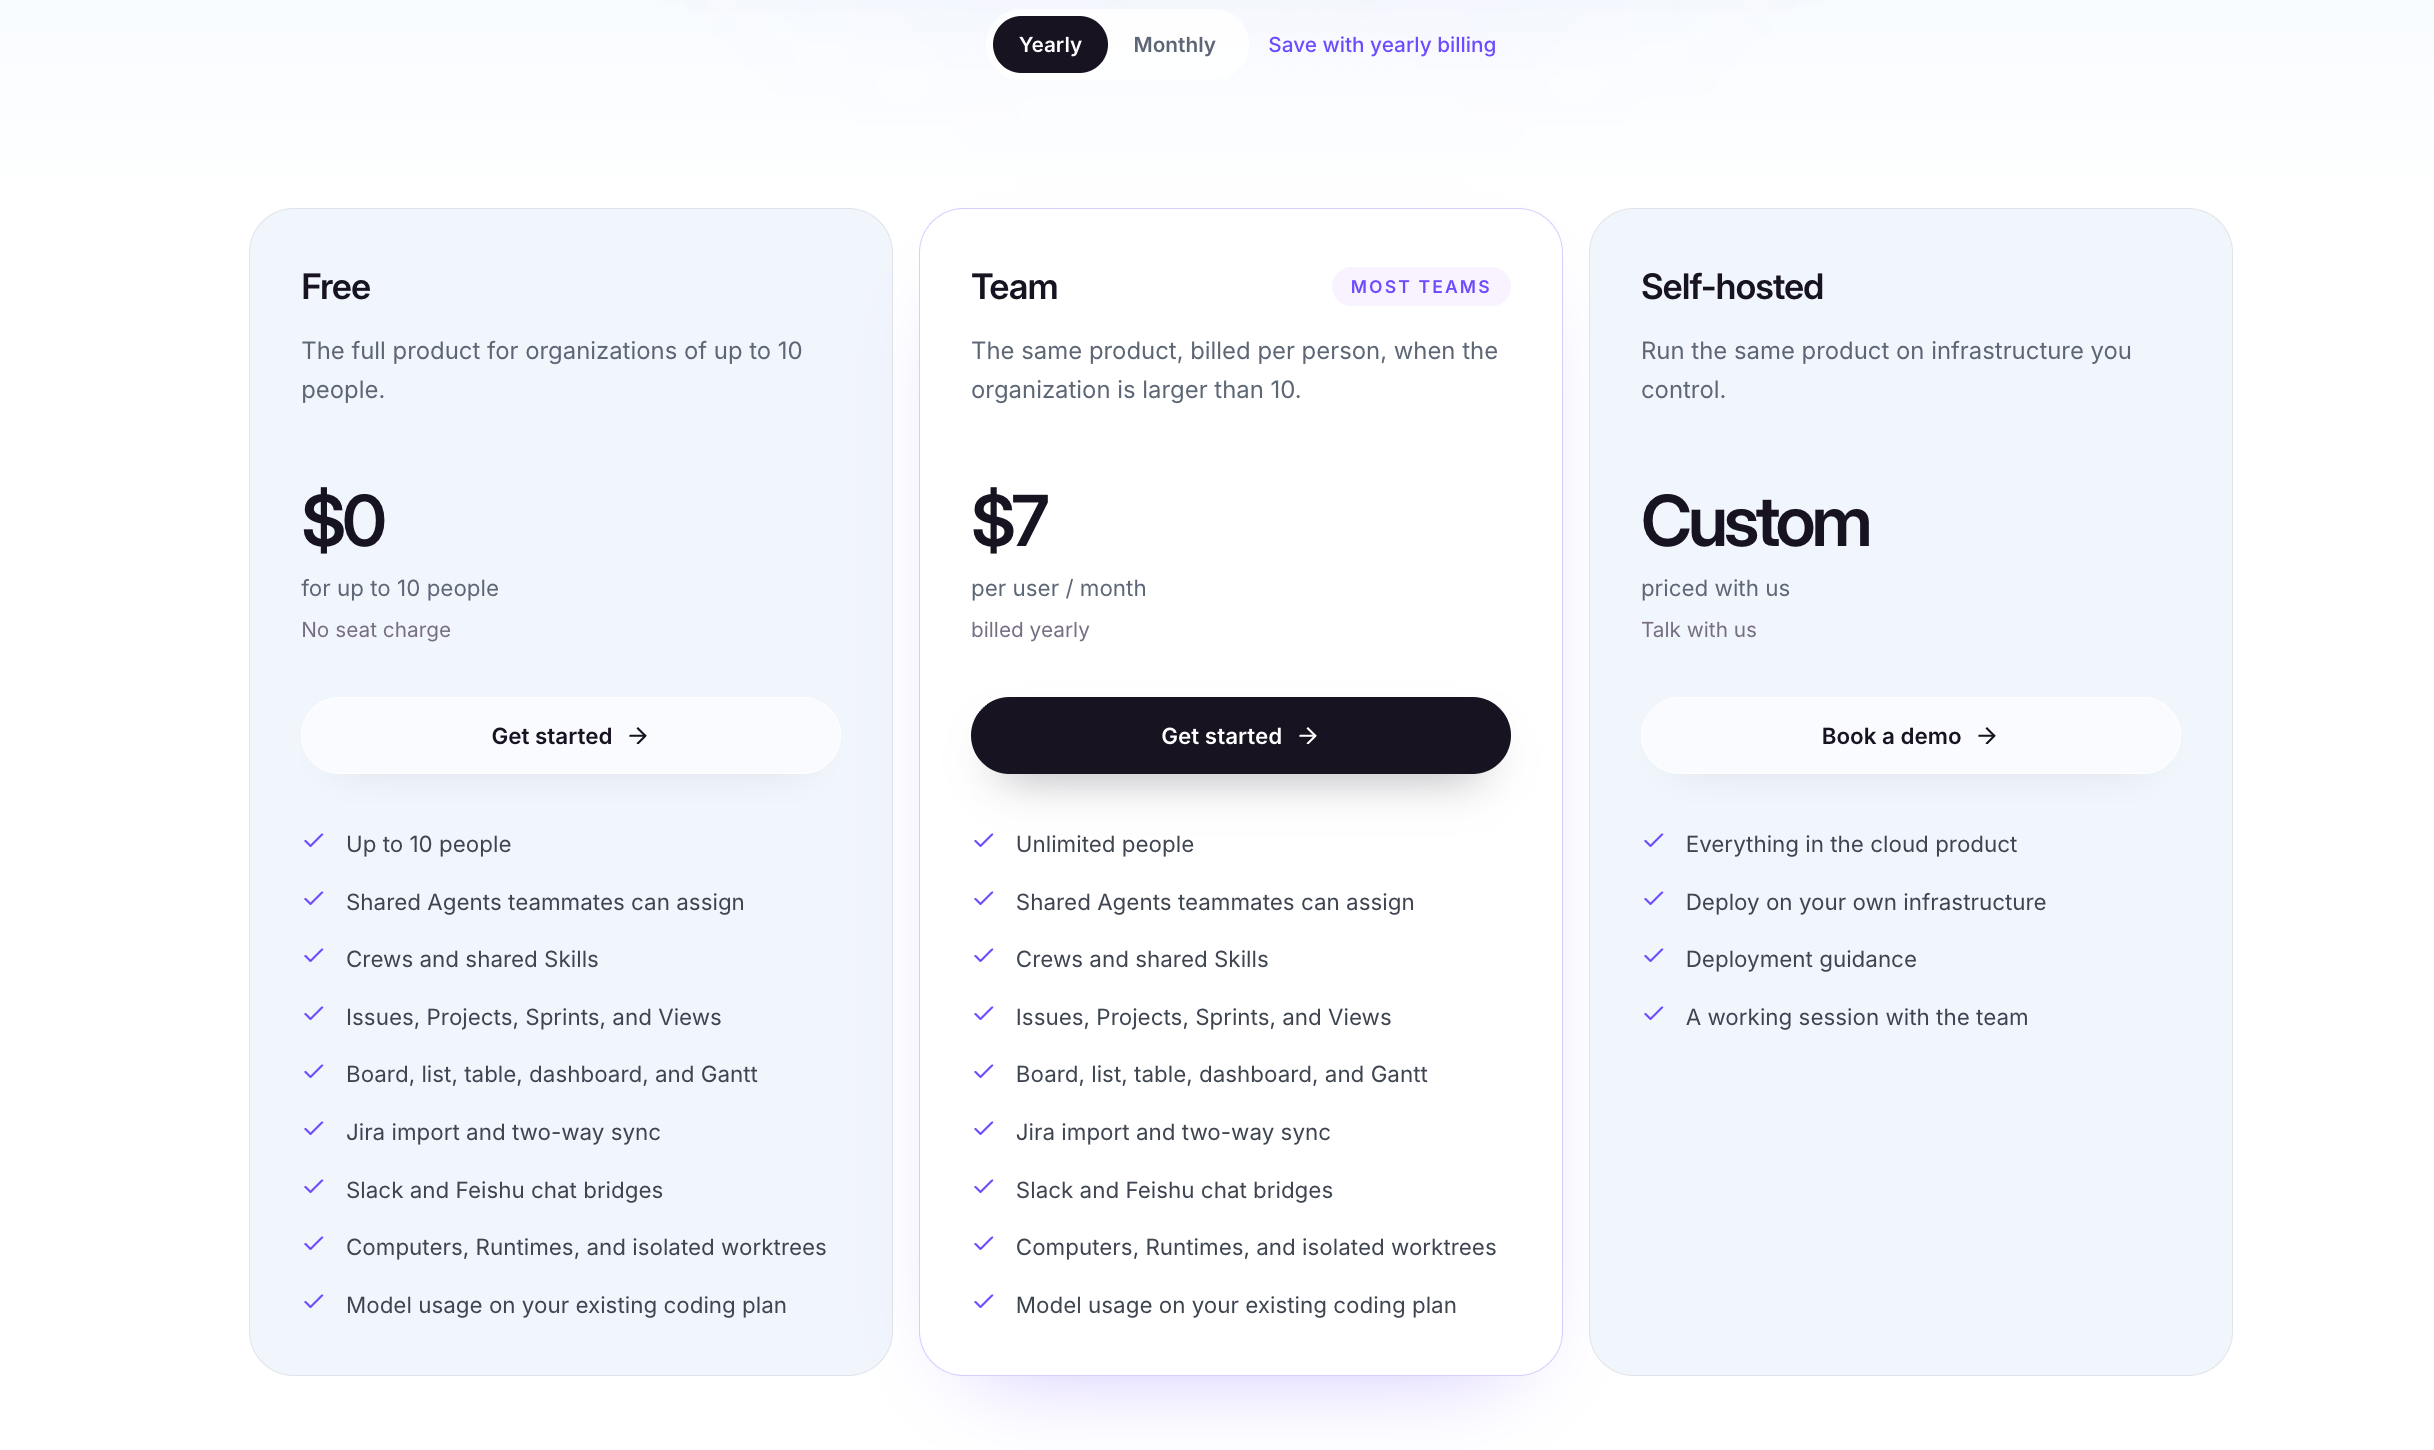
Crewを運用する上で極めて重要なのは、ゲスト、Agent、Crew、Computer、Runtimeはシートを消費しないという点です。シートとしてカウントされるのは、組織に属する実際の人間の数だけです。6体目のAgent、2台目のComputer、あるいは3つ目のRuntimeを追加しても、シート費用は1円も変わりません。追加の費用が発生するのは、6人目の同僚がチームに加わったときだけです。
ここで率直な注意点が2つあります。Sharklyが現在無料で利用でき、Teamプランの金額が公開されたシート価格であることは事実ですが、これは「現時点で無料」という正確な表現にとどまり、「永久に無料」を保証するものではありません。また、Sharklyはトークンの販売を行っていません。タスクの実行にかかる費用は、それを実行するRuntimeに紐付けられているClaude Code、Codex、または各種APIプランに対して直接請求されます。だからこそ、これら2つの費用項目は明確に分離されており、後述するモデルの利用コストはどのプラットフォームを経由するかには一切左右されません。プランの詳しい仕組みについては、Sharkly pricing explained(料金解説)をご覧ください。
トークン費用:無料で利用できる最新モデルの実際
| モデル | 無料ルート | 提供されない形態 | 有料プランの導入ライン |
|---|---|---|---|
| GPT-6 Luna | ChatGPTデスクトップアプリ(FreeおよびGoユーザー) | Web版Chatでは未提供、APIキーとしての利用不可 | API gpt-6-luna(100万トークンあたり $0.10 / $0.50) |
| GPT-6 Sol | なし | ChatGPT WorkおよびCodex内のPlus、Pro、Business、Enterprise、Edu限定 | API gpt-6-sol(100万トークンあたり $2 / $10) |
| Claude Opus 5.5 | なし(Claude FreeはSonnetとHaikuを提供) | Claude Codeは有料プランにのみ含まれ、Freeでは利用不可 | Pro(年払いで月額$17・一括$200、または月払い月額$20)、Max(月額$100〜)、API claude-opus-5-5(100万トークンあたり $4 / $20) |
3つのうち2つは「無料枠なし」、そして残る1つにも、すべてを左右する重大な条件がついています。
デスクトップアプリの利用権限はAPIキーではない
これは無料プランの比較記事で見落とされがちな決定的な違いであり、無料モデルがCrewの実用に耐えうるかどうかを分けるポイントです。
Sharklyでは役割が明確に分かれています。Agentが作業の手順を定義し、Computerがホスト環境を提供し、Runtimeが実際のセッションを実行し、Taskが共有ログとして記録されます。準備の整ったAgentが設定されたTaskが、利用可能なRuntimeを持つComputerに届いた時点で実行が開始され、そのRuntimeは該当Computerのツールに設定されたサブスクリプションまたはAPIキーを使って認証を行います。
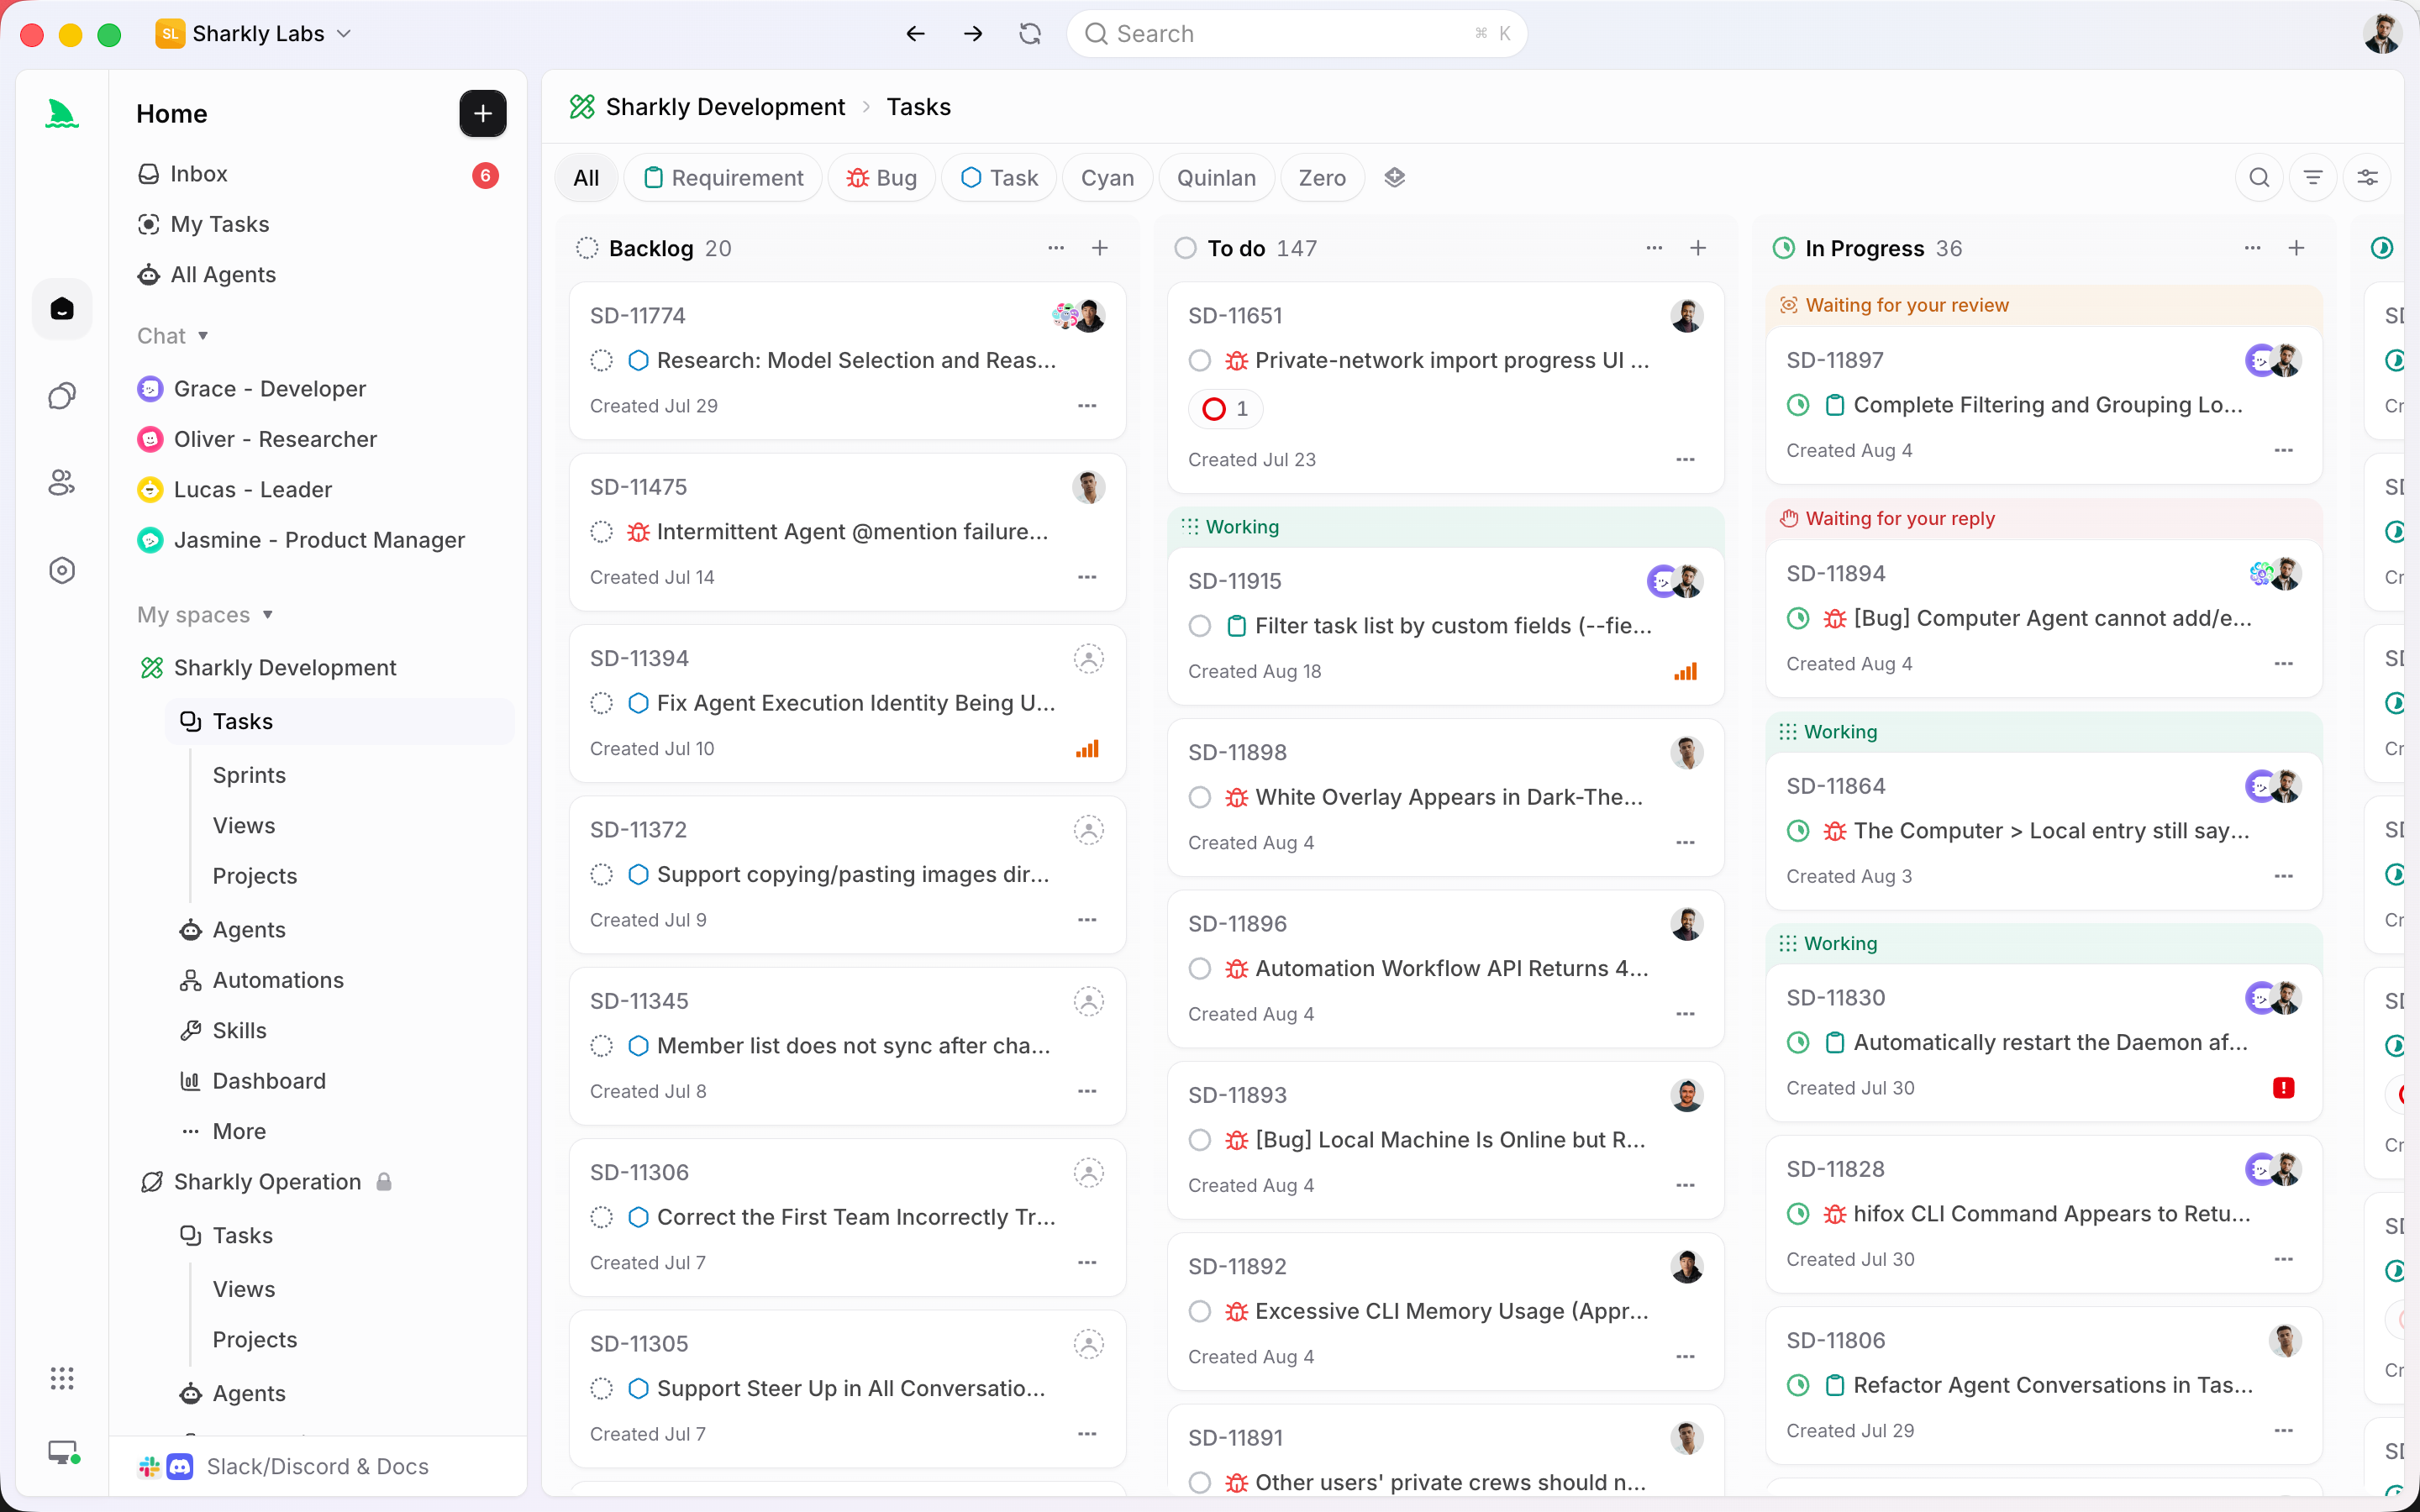
ChatGPTデスクトップアプリの無料利用枠は、こうした認証情報には該当しません。それはあくまで、人間が自分のノートPCでアプリにサインインし、キーボードで入力するためのものです。Runtimeに接続できる要素は一切なく、ユーザーが寝ている間に勝手に処理を開始することもできません。デスクトップアプリの無料モデルは「評価・検証」には使えますが、Crewを自律稼働させる「実行環境」にはならないのです。
とはいえ、無料ルートにも価値はあります。以下のように使い分けるのが適切です。
人間が直接向き合って判断を下す場面では、デスクトップの無料枠を活用してください。モデルがコードベースをどのように読み解くか、スプリントの工数を割く前にアプローチの妥当性を確かめたいとき、あるいはルーティングルールにそのモデルを組み込むべきかを検証したいときなどです。これなら、費用をかけずに午後の数時間で十分な検証が行えます。
一方、人間の介入なしに実行を開始させたい場合は、有料サブスクリプションまたはAPIキーを使用してください。キューに溜まったTask、夜間のバッチ処理、自分がミーティングに出ている間にチームメンバーがトリガーしたジョブなどがこれに該当します。離席中に自動実行させるには、利用権限(entitlement)ではなく認証資格情報(credential)が必要不可欠です。
計画上の補足として、OpenAIはこれらのモデルをWeb版Chatではまだ提供していないと明言しています。現在特定のインターフェース上でのみ提供されている無料枠は、翌月には変更される可能性があります。今期たまたま無料になっている枠に合わせてワークフローを構築するのではなく、ルーティングルールを明文化して管理すべきなのはこのためです。
Crewを実際に動かす、真に安価な選択肢
| Runtime対応モデル | 入力 / 出力(100万トークンあたり) | キャッシュによるコスト削減 | その他の優位性 |
|---|---|---|---|
gpt-6-luna |
$0.10 / $0.50 | キャッシュされた入力読み取りが90%オフ | デフォルトのヒット率向上、キャッシングダッシュボード、診断ツール |
gpt-6-sol |
$2 / $10 | キャッシュされた入力読み取りが90%オフ | 明示的なキャッシュブレークポイントの設定が可能 |
claude-opus-5-5 |
$4 / $20 | キャッシュ読み取り $0.20、キャッシュ書き込み $5 | Batch APIが50%オフ(fastモードは $8 / $40 と高額なため非推奨) |
OpenAIはSolおよびLunaについて、GPT-5.6の「プロモーション価格」と比較して50%安価であると説明しています。この表現には注意が必要です。比較対象は定価ではなく、あくまで一時的なプロモーション価格です。
実運用においてより大きなコスト削減要因となるのは、いずれにせよプロンプトキャッシングです。GPT-6ではデフォルトのキャッシュヒット率が引き上げられ、キャッシュされた入力読み取りが90%割引されるほか、キャッシングダッシュボードや診断ツールが追加され、推論エフォート(reasoning effort)やツールの設定を変更してもキャッシュが無効化されなくなりました。GitHubの報告によると、数十億件のリクエスト全体で、新規処理が必要なプロンプトトークンが50%以上削減されたとのことです。またOpus 5.5では、標準入力が4ドルであるのに対し、キャッシュ入力の読み取りはわずか0.20ドルで済みます。同一のリポジトリを1日中繰り返し読み込むCrewにとって、最終的な請求額を左右するのは基本単価ではなく、このキャッシュ効率なのです。
1週間の実際の運用コスト
OpenAIは、予算試算に直結する具体的な数値を公開しています。Solを推論エフォート「extra high」で実行した場合、AutomationBench 1.0.6で33.2%のスコアを記録し、1タスクあたりのコストは0.27ドルでした。この数値を基に試算すると、Crewが同様のタスクを週に40件完了させた場合、モデル費用はおよそ11ドルになります。もちろん実際のリポジトリはAutomationBenchとは異なるため費用も変わってきますが、少人数チームの作業量であれば、モデル費用は今やエンジニア1名分の人件費(1時間分)と比べても誤差の範囲に収まります。
その背景にある比較データとして、Sol(extra high)はClaude Opus 5(max reasoning)を上回るスコアを、Opus 5のタスクあたり費用のわずか9%で達成しています。また、Luna(max)はDeepSWE 1.1において66.6%を記録し、Opus 5よりタスクあたり93%低いコストを実現しました。ただし、ここには1つ修正すべき前提があります。OpenAIの比較基準は一貫して旧型のOpus 5になっていますが、これはAnthropicが当該記事の公開から数時間後にOpus 5.5(入力4ドル/出力20ドル。Opus 5の5ドル/25ドルより20%安く、実行コストは40%削減)をリリースしたためです。どちらのラボも相手の最新モデルを反映したベンチマークは行っていません。したがって、先述の表はいずれも大まかな目安として捉え、単なるリーダーボードの順位ではなく各Runtimeの用途や適性に基づいて選定すべきです。
コストの上限についても見ておきましょう。OpenAIの報告によると、同社の研究者がコーディングエージェントにかける費用の1日あたりの中央値は600ドルを超え、上位10%(90パーセンタイル)では7,000ドルに達します。Crewが際限なく費用を消費してしまうのを防ぐ手立ては、明文化されたルーティングルールと合意に基づく上限設定以外にありません。これはプラン選びの問題ではなく、マネジメント上の意思決定です。すでに複数のツールにコストが分散している場合は、価格比較を行う前にまずエージェント全体のコスト追跡と管理を整えることが先決です。
無料プランが通用しなくなる境界線
小規模な環境であれば、2つの費用を合算しても総額は極めて少額で済みます。5人以下ならシート費用は0ドル、安価なティアのAPIを使えばトークン費用も週に数十ドル程度です。しかし、真に高価なプロセスはどちらの費用項目にも含まれていません。
Agentは調査、実行、テスト、報告を担当します。一方で、方針を決定し、実行権限を与え、成果物を検収・承認するのは人間です。この「承認作業」には無料枠も格安プランも値下げも存在せず、コストはAPI利用料ではなく人間の稼働リソースに比例して増大します。Runtimeの利用料がいくらであれ、人間のレビュー作業こそがボトルネックになります。5人まで無料かつ100万入力トークンあたり0.10ドルという環境なら、今日の午後に10件の実行ジョブを走らせることは格安で可能です。しかし、今夜その10件の結果に目を通す作業が安くなるわけではありません。マネジメントレイヤーを導入する価値は、実行にかかるコストを下げることではなく、その成果の集約先を整理することにあります。実行状況、障害、成果物、そしてその後の議論がすべてTaskへと集約されるため、要件定義からリリースに至るまでのコンテキスト、進捗、ブロッカー、結果、そして人間によるレビュー状況が一目で把握できるようになります。これにより、人間の対応待ちになっているタスクの量が、金曜日に感じる漠然とした不安ではなく、明確な数値として可視化されるのです。
最初から無料ではなかったコスト
「無料」と「低価格」は、今や完全に別の問題です。プラットフォーム側に関しては、5人まで0ドル、それ以降は年払いで月額7ドル、APIキーやサブスクリプションは自前のものを持ち込むという明確な料金がすでに提示されています。一方のモデル側については、見出しから期待するほど甘い話ではありません。無料枠の1つは自動実行には使えないデスクトップアプリ経由であり、残る2つにはそもそも無料枠が存在しないからです。
ここで導き出される実用的な結論は、「どのプランを選ぶべきか」ではありません。モデルの利用コストは、Crewのアウトプット量を制限する要因ではなくなったということ、そして2026年9月22日に両社から発表されたどのモデルも、コード差分(diff)のレビューを人間の代わりにやってくれるわけではないということです。
複数のコーディングエージェントをすでに稼働させているなら、Sharklyを導入することで、どのRuntimeがどの成果物を生成したのか、どんなエビデンスが添付されているのか、そして現在どれだけの作業が人間の確認待ちになっているのかを1箇所で把握できます。まずは1台のComputerを接続し、1体のAgentを作成して、定型的なタスクを割り当ててみてください。5人以下のチームなら、そこにかかる費用はゼロです。


