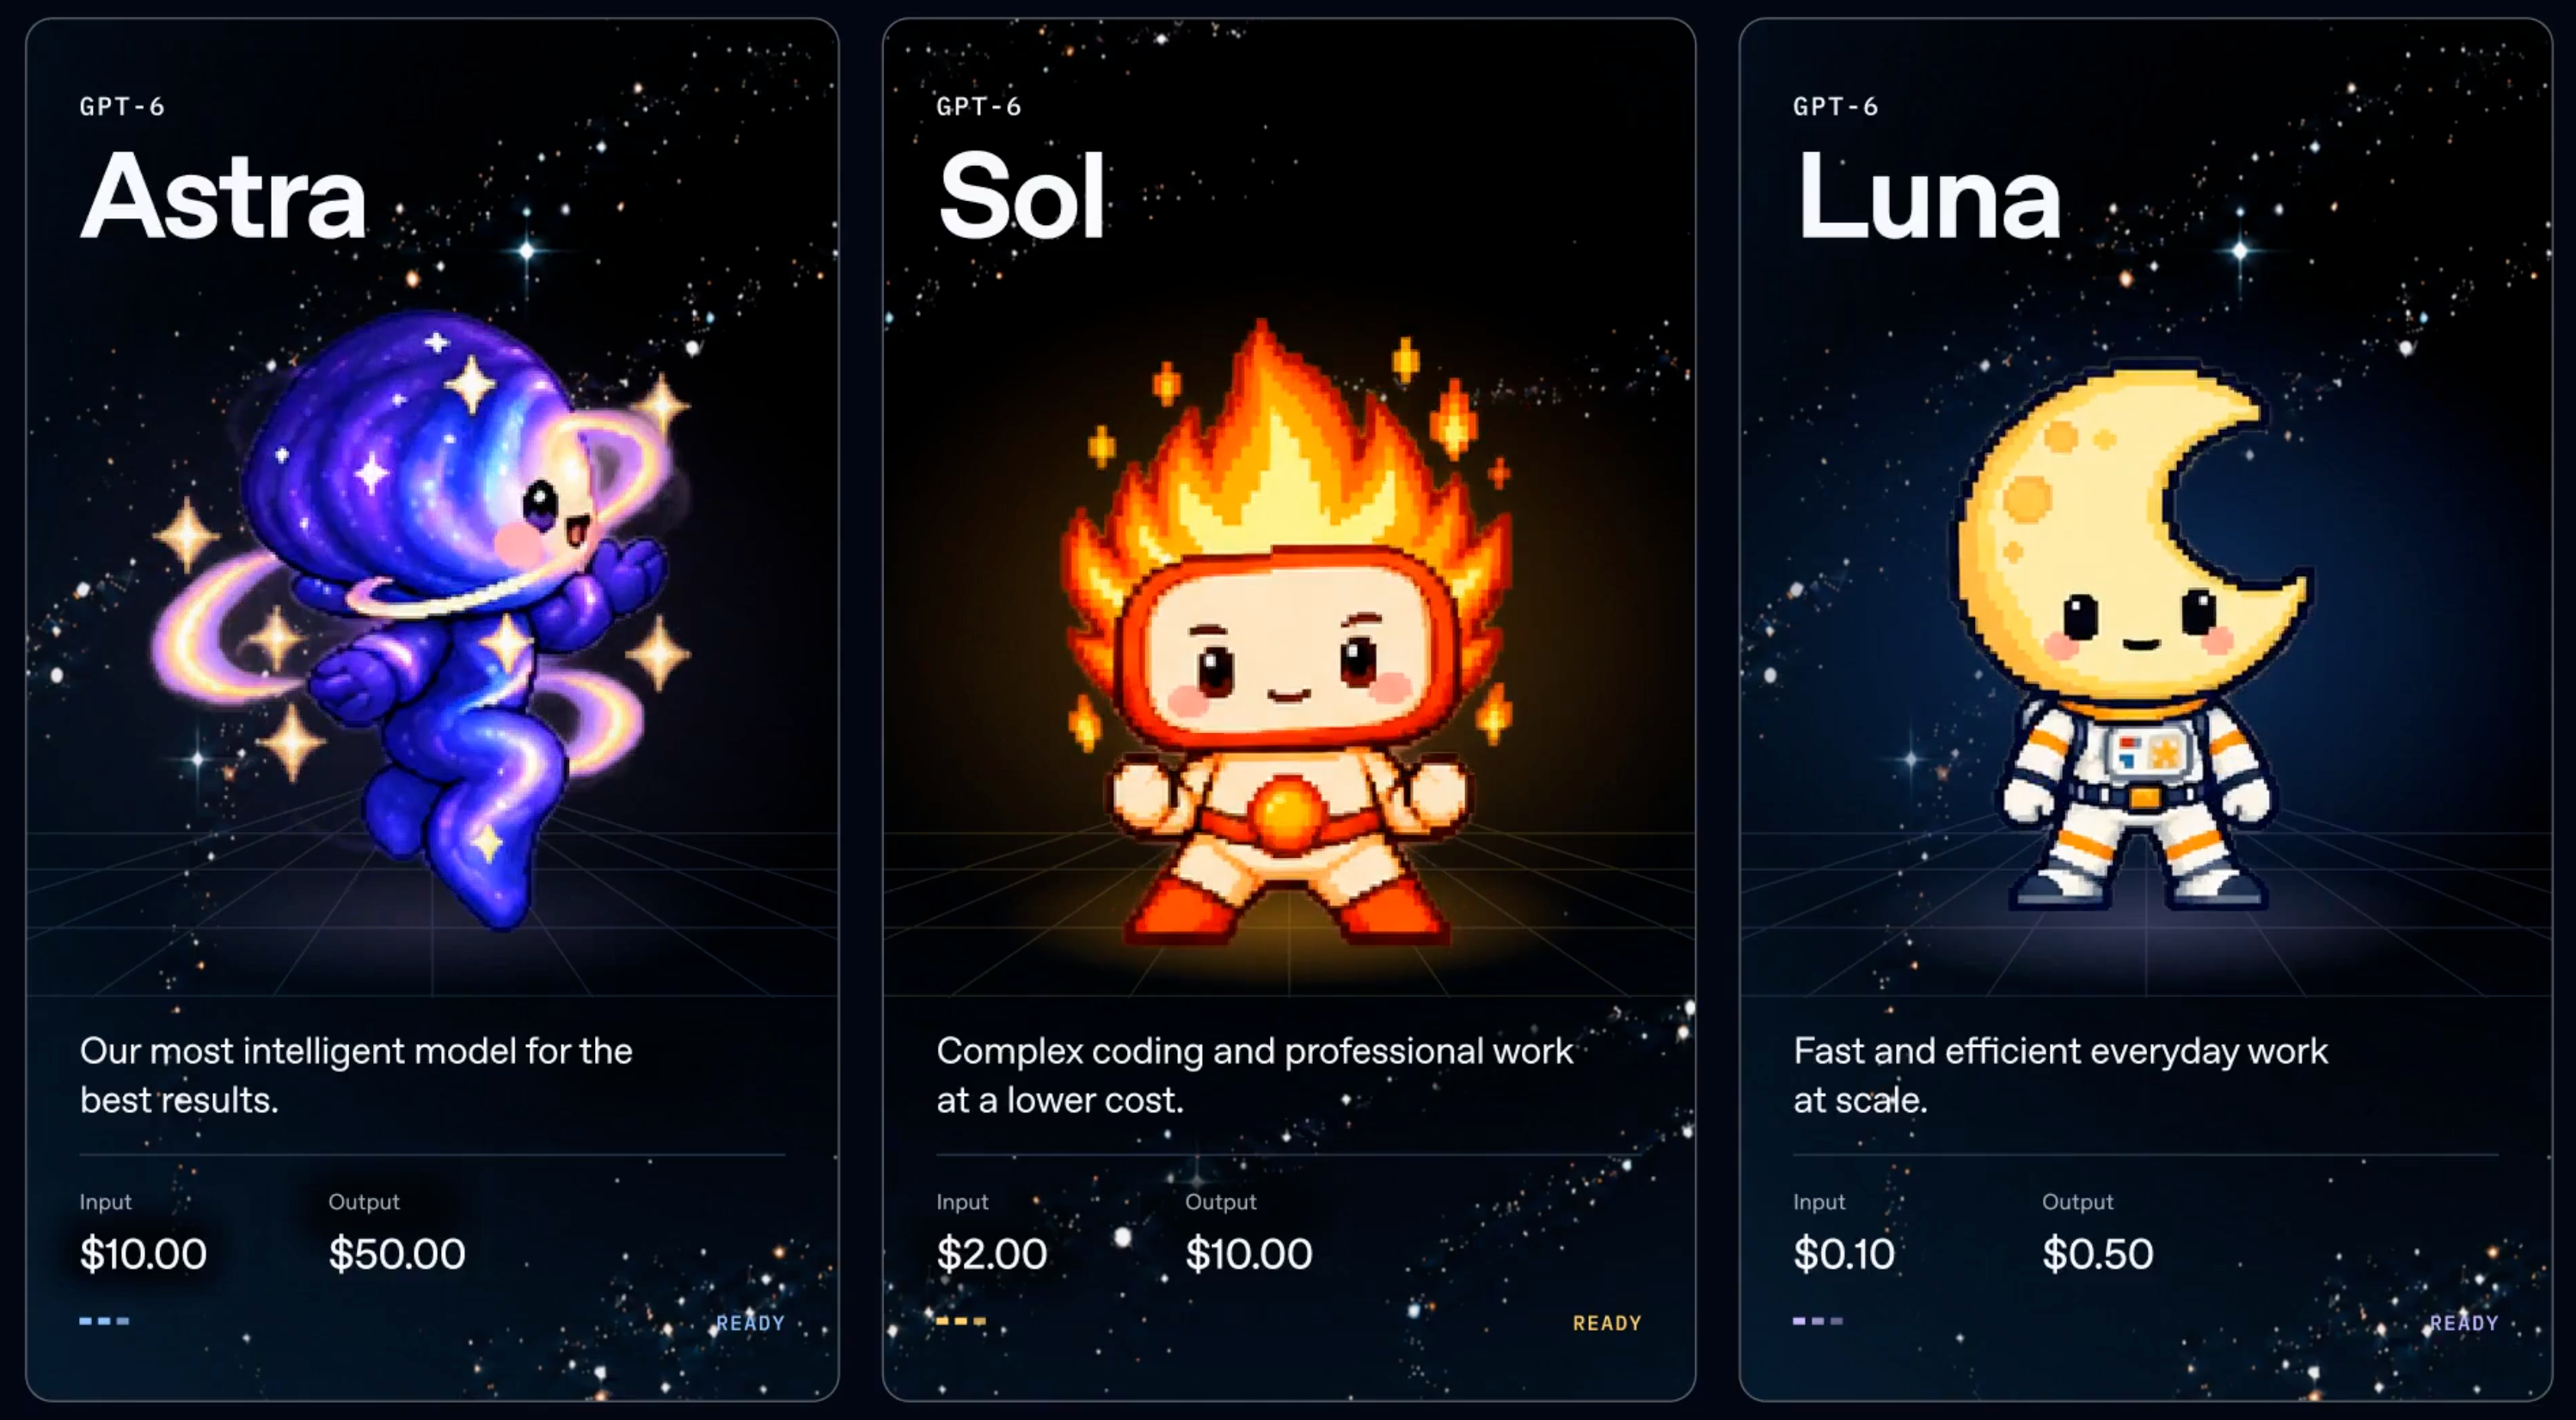
請求書の金額は、最も動かしやすく、最も見る価値のない数字です。Crewの定常タスクを100万トークンあたり入力0.10ドル/出力0.50ドルのGPT-6 Lunaにルーティングすれば、モデル利用料の項目は1日もしないうちに激減します。2週間経っても請求額は低いままで、ダッシュボードにはかつてないほど多くの完了した実行(Run)が並んでいます。しかし、先週の火曜日にできた4つの変更は、誰かに承認されるのを今も待ち続けています。
何かが故障したわけではありません。注視していた費目から、誰も価格をつけていない費目へとコストを付け替えただけなのです。
「承認された変更あたりのコスト(Cost per accepted change)」とは、人間が1つの変更を承認・適用するに至るまでに費やされた、すべての試行にかかる金銭と人間の時間の総計です。これには、失敗した実行、マージされなかった成果物、そしてその両方を判断するために誰かが費やした時間もすべて含まれます。どのベンダーもこれを公表していませんし、どのベンチマークも測定していません。しかし、チームが実際にリリースしたものと連動して動く数字は、これだけなのです。
TL;DR
より安価なモデルを導入すると、1回の試行コストは下がりますが、レビュアーの注意力という形で支払われる3つの要素が増加します。「リリースされた変更あたりの試行回数」「試行あたりの出力データ量」、そして「リリースされた変更あたりの意思決定数」です。2026年9月22日に注意力のコストが下がったわけではありません。格安プランのモデルは、試行が合格したかどうかを機械が判定できる場所では純粋に安くなりますが、人間が判断しなければならない場所では静かに高くつきます。エージェントは調査、実行、テスト、レポートを担当し、人間は方針を定め、権限を与え、結果を承認します。解決策はルーティングを変更することではなく、まずコストの計算方法を見直すことです。Runtimeごとに承認された変更あたりの試行回数と人間の所要時間を測定し、「人間の判断待ち」のタスクを金曜日に感じる漠然としたストレスではなく、計測可能な状態として可視化しましょう。
3つの単位、そしてあなたのチームに関係する唯一の単位
| 単位 | 誰が使うか | 何がわかるか | 何が見落とされているか |
|---|---|---|---|
| 100万トークンあたり | ベンダーの料金ページ | 入力と出力の単価 | タスク全体で何トークン消費するか |
| 完了したタスクあたり | ベンチマークの比較表 | スコアリングされた1回の試行コスト | 失敗した試行、自社コードベースの事情、レビュー工数 |
| 承認された変更あたり | あなたのチーム | 1つの変更をリリースするまでのエンドツーエンドのコスト | 見落としはない(だからこそ、どのベンダーも公表しない) |
両研究所は2026年9月22日にモデルをリリースし、どちらも中央の列の基準で数値を公表しました。それらの比較表を、あたかも右端の列であるかのように受け取ってはいけません。
格安モデルのコストとベンチマークスコア
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| 100万トークンあたりの入力 / 出力 | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| キャッシュ入力 | 読み取り90%オフ | 読み取り90%オフ | 読み取り $0.20、書き込み $5 |
| コンテキスト | 1M | 872k | 1M |
| DeepSWE 1.1(最大推論時) | 66.6% | 68.8% | ローンチ資料に記載なし |
| Artificial Analysis インデックス | 37 | 48 | 58(212モデル中1位) |
AnthropicはOpus 5.5のAutomationBenchスコアを40.0%と報告しています。OpenAIは、Sol(超高推論設定)のAutomationBench 1.0.6におけるスコアを33.2%、タスクあたり0.27ドルと公表しています。2つのラボ、2つのテストハーネス、そして公表された1タスクあたりのコスト。この2つは直接比較できるものではありません。そして直接比較できないことこそが本質なのです。どのベンダーの比較表を見ても、「承認された変更あたりのコスト」を導き出すことはできません。
隠れた変数1:承認された変更あたりの試行回数
OpenAIによると、DeepSWE 1.1における最大推論時のスコアはLunaが66.6%、Solが68.8%です。単純計算すると、Lunaによる試行のおよそ3回に1回は合格基準を満たさない結果に終わるということです。当然ながら実際のコードベースはDeepSWEとは異なり、成功率も変わってきます。しかし本質的な構造は同じです。格安モデルのスコアが数ポイント低いということは、1回ごとの精度がわずかに落ちるだけにとどまりません。もう一度やり直さなければならないアウトプットを渡される確率が数ポイント高くなることを意味します。
そのやり直しにかかる金銭的なコスト自体は、依然として微々たるものです。OpenAIの報告によれば、同一ベンチマークにおいて最大推論のLunaはClaude Opus 5よりタスクあたり93%安価です。試行回数が2倍になったとしても、計算上は約86%安いままです。モデルの利用料明細が問題になることは決してありません。
しかし、失敗した試行はそれ以外のあらゆる場所でコストを発生させます。失敗した試行であっても、ブランチや変更サマリーが生成され、人間による意思決定を必要とします。失敗した実行は、コストゼロの無では決してありません。最終的に何の変更にも結びつかない、単なる「レビュー工数」なのです。
隠れた変数2:格安モデルは「長く考える」ことで精度を出している
Lunaの優れたスコアがどこから生まれているのかをよく見てみましょう。66.6%という数値は「最大推論(max reasoning)」時のものであり、OpenAIの技術資料には「高エフォート設定のLunaは、約100分の1のコストでGPT-5.6 Solに匹敵する」と記されています。つまり格安モデルは、より多くのエフォート(思考量)を投じることで許容できる品質に達しているのです。そしてそのエフォートは、出力トークン数の増大と実経過時間(ウォールクロックタイム)の長さとして跳ね返ってきます。
両ベンダーから中立な第三者機関であるArtificial Analysisの計測によると、最大推論バリアントにおいて、Lunaは出力速度が毎秒153.9トークンで最初のトークンが出力されるまでの時間(TTFT)が124.23秒、Solは毎秒115.2トークンでTTFTが102.15秒となっています。これらは第三者による測定であり、最大推論モデルに特化した数値であり、再測定によって変動するため、あくまで目安として捉えてください。
その結果として、請求書ではなくチームに直接降りかかる2つの影響があります。2分間何の応答もない実行は、ハングして止まっている実行と見分けがつかないため、誰かが見に行って確認しなければなりません。さらに、推論のトレースが長く差分(diff)が大きくなるほど、人間が承認するまでに1回の試行あたりで読まなければならない分量が増えます。読むための時間こそが希少なリソースであるにもかかわらず、それを大量に浪費するものを購入してしまっているのです。
隠れた変数3:差分ではなく「意思決定」の数
タスクが割り当てられてから変更が承認されるまでに発生する、人間の意思決定の数を数えてみてください。高性能なRuntimeであれば、通常のフローは「読んで、承認する」という1ステップです。一方、機械的に検証できない作業を安価なRuntimeで行うと分岐が発生し、そのすべての分岐で人間の判断が求められます。
- 実行が失敗した:同じRuntimeで再試行するか、より強力なモデルにエスカレーションするか?
- テストは通過したが、採用したくないアプローチを取っている:承認するか、差し戻すか?
- 3つの部分的な成果物が生成された:どれを本筋の変更として採用すべきか?
- 実行が途中で止まって質問してきた:誰が回答し、そのやり取りはどこに記録されるのか?
こうしたコストは、トークン課金の請求書には一切載りません。そのすべては、人間によるレビューを担当する人のカレンダーを埋め尽くすことになります。
実際の数値を当てはめて計算する
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
私たちの提示した数値ではなく、ご自身のチームの数値を当てはめてみてください。100万トークンあたり0.10ドルおよび0.50ドルという水準では、括弧内のモデルコストはほぼゼロに四捨五入できるほど小さいため、計算式全体は「レビュアーの所要時間 × 試行回数」に支配されます。より安価なRuntimeに乗り換えることは、もともと小さかった費目をさらに削り、そうではなかった大きな費目を何倍にも膨らませることを意味します。それでもなお割に合うトレードオフである場合もありますが、料金ページを眺めているだけでは決して評価できないトレードオフです。
格安モデルが真に安上がりになるケース
試行が合格したかどうかを機械が判定できる場合は、安価なRuntimeを活用してください。型チェック、単体テスト、ビルド、リントルール、スキーマ検証など、人間が注意を払う前に合否の判定が下されるタスクであれば、試行回数の増加は人間の金曜日の時間を奪うことなく、テストハーネス側で吸収されます。これこそが稼働中のCrewがこなす作業ボリュームの大半であり、退屈な定常作業の8割をLunaにルーティングすることの正当な根拠となります。
承認に人間の「判断」が必要なタスクには、安価なRuntimeを使ってはいけません。アーキテクチャの意思決定、データ移行、セキュリティ関連の変更、「これで本当に正しいのか?」という問いにコマンドひとつで答えられないものすべてが該当します。そうした領域では、モデルの性能差がそのままレビュアーの時間消費に直結します。そこで最も安上がりな選択肢とは、「一度目を通すだけで済む試行」を購入することなのです。
エスカレーションのルールは属人的な好みに委ねず、明確に言語化して規定してください。単なる個人の好みは、いつだって「より安い価格」の引力に負けてしまうからです。モデルのルーティングとは、何よりもまず「機械的な検証可能性」を最優先とし、コストをその次として設計すべきルールなのです。
なぜどのベンダーもこの事実を語らないのか
両研究所は同日に互いを引き合いに出したベンチマークを公開しました。OpenAIが比較対象のベースラインとしたClaude Opus 5を、Anthropicはその数時間後にOpus 5.5へと置き換えました。どのベンダーにとっても、格安モデルは自社エコシステムへと誘い込むファネルの最上部に位置しています。「当社の廉価モデルを使うと、レビュアーによる確認の手間が1回分増えます」などと公表するベンダーは存在しません。そして、それを記載しないことが間違いというわけでもありません。その数字は、各社のコードベースやレビューを担当する人間によって大きく異なるからです。
Sharklyはモデルのトークンを販売していません。モデルの利用はチームがすでに使用しているツールに設定されたサブスクリプションやAPIキーを通じて行われるため、どのRuntimeを選択しても当社の利益には何の影響もありません。これこそが、私たちがこの議論を公平かつ誠実に主張できる唯一の立場であり、次に新しい格安モデルが登場してもワークフローを一から再構築することなく使い続けられる理由でもあります。
ダッシュボードに代わりに表示すべき指標
Runtimeごとの、承認された変更あたりの人間の所要時間(分)。モデルを切り替えた後にこの数値が増加した場合、その格安モデルは実質的により高くついていることになり、手元にはその明確な証拠(レシート)があることになります。「1回の実行あたりのコスト(ドル)」という指標は、2026年9月22日を境に重要性を持たなくなりました。
Runtimeごとの、承認された変更あたりの試行回数。この変数が他のすべての数値を左右しますが、ベンダーから提供されることはありません。各タスクにおいて、どの試行がどのRuntimeによって生成されたかを記録することで初めて算出できます。
「人間の判断待ち」を明確なステータスとして扱うこと。実行状況、ブロッカー、実行結果、そしてその後の議論をすべてタスクのタイムラインに集約することで、人間の対応が必要なキューが感覚値ではなく定量的にカウントできるようになります。そして、各実行には必ず裏付けとなるエビデンスを添付させるように義務付けます。
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
小規模な体制であれば、こうした仕組みは一切不要です。1人のエンジニアが2つのAgentを動かし、その日の午後にすべて目を通せているなら、そのまま続けてください。ステータス管理やキューの導入は、まだ直面していない課題に対する無駄なオーバーヘッドにすぎません。この計算や管理が重要になるのは、完了した実行がいくつ承認待ちになっているかを、誰も記憶だけで答えられなくなった瞬間からです。
安くならなかった唯一の要素
同日、2つのAI研究所が1回の試行にかかる単価を引き下げました。しかし、人間に代わって差分を読み取ってくれる機能を提供した研究所はひとつもなく、変更に対する最終的な責任は依然として人間に委ねられています。より安価なモデルを導入したからといって、ワークフロー全体が安くなるわけではありません。安くなったのは「1回の試行」だけであり、その試行が流れ込む先には、人間という最も高コストな工程が待ち構えているのです。
すでに複数のコーディングエージェントを運用しているなら、Sharklyを使うことで、どのRuntimeがどの試行を生成したか、どのようなエビデンスが添付されているか、そして現在どれだけの作業が人間の判断待ちになっているかを、一元的に把握できるようになります。