
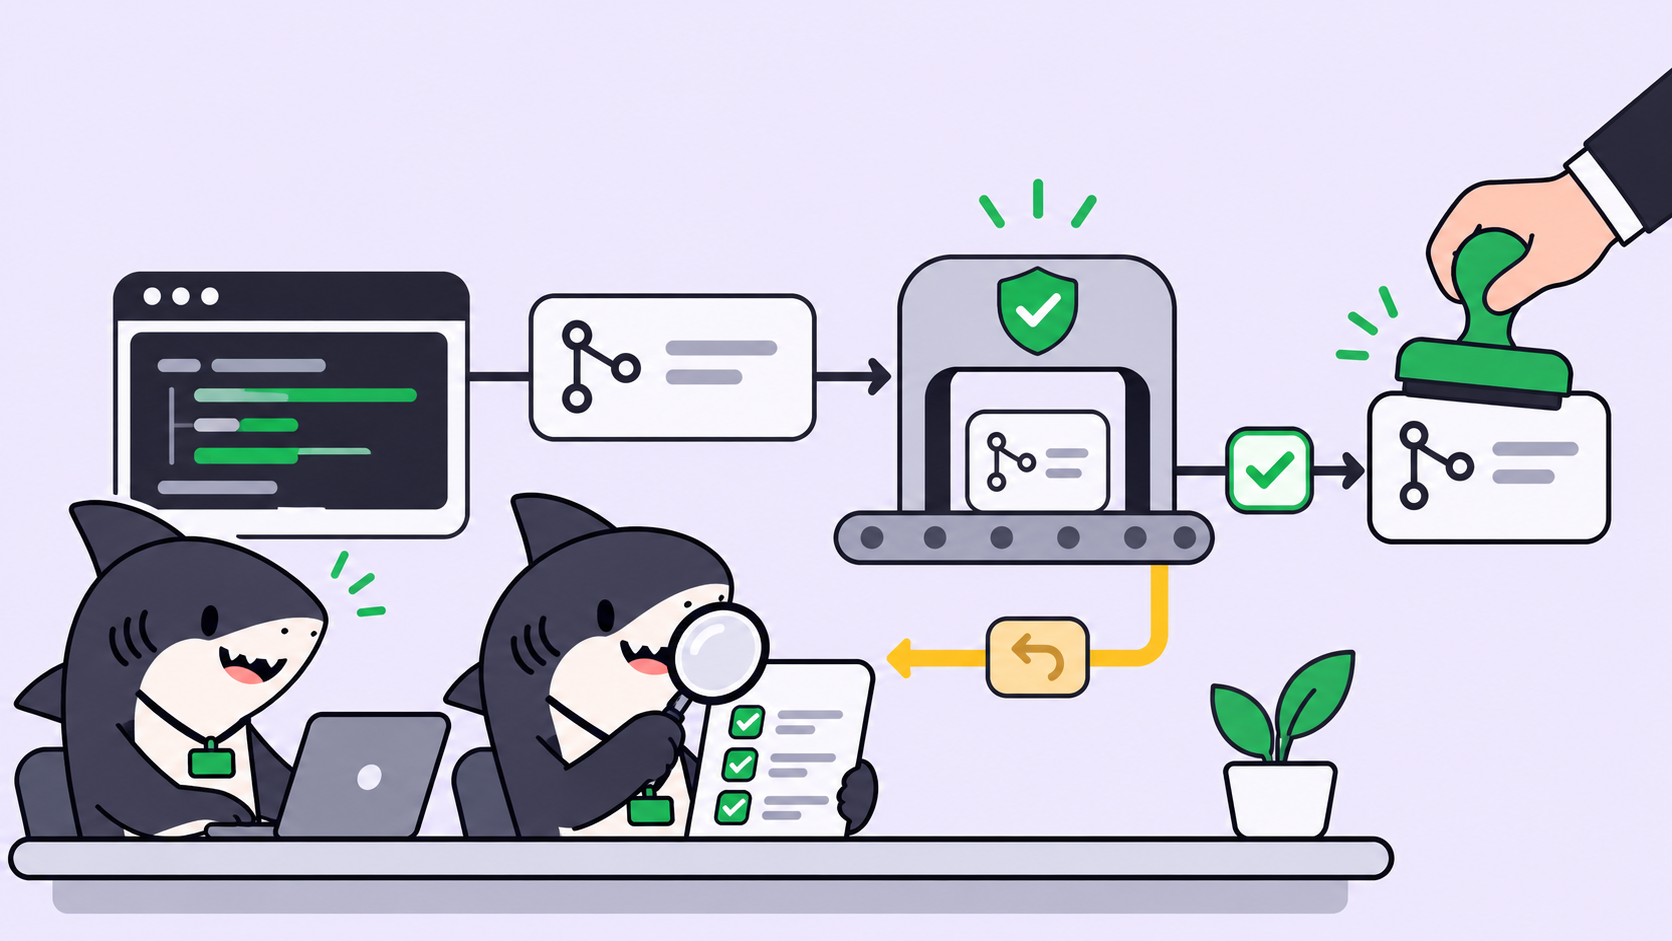
要点:AIエージェントにプルリクエスト(PR)をレビューさせるには、独自の指示、独立したチェックアウト環境、そして可能であれば異なるモデルを備えた「2人目のエージェント」にレビューを任せます。タスクがレビュー待ちステータスになったら自動で起動し、テストを実行させてPASSまたはCHANGES REQUIREDの判定を投稿させ、失敗した場合は作成元のエージェントへ差し戻します。最終的なマージは必ず人間が行います。
人間が確認する前に、AIエージェントにPRをレビューさせるべき理由
エージェントが作成したプルリクエストは、すべて同じデスク、つまりあなたの元に届きます。エージェントが1時間に1本のPRを出す程度なら問題ありません。しかし、5つのエージェントが並行して稼働し始めると、差分を読むスピードを上回る勢いでキューが積み上がり、一次レビューが最大のボトルネックになってしまいます。
レビュアーエージェントは、その一次レビューを引き受けてくれます。人間の判断を完全に置き換えるわけではありません。テストに失敗しているもの、スコープを逸脱しているもの、シークレット情報を漏洩させているようなPRをあらかじめ除外することで、人間が確認する価値のあるPRだけを手元に残します。Sharklyでは、追加のAgentを1つとAutomationを2つ設定するだけでこれを実現できます。本記事では、その具体的な手順を順を追って解説します。
自動レビューの限界について先に知りたい場合は、AIコードレビューエージェントが検証できること・できないことをご覧ください。本記事ではセットアップ方法を解説します。
単一のエージェントが自身のコードをレビューできない理由
コードを書いたエージェント自身が、そのコードに関する文脈やストーリーも作り出しています。そのため、自分の仕事を自分でチェックさせると、自身が導き出した論理を読み返してそのまま納得してしまいます。つまり、バグを生み出した盲点そのままでレビューを行うことになってしまうのです。
この問題が最も顕著に現れるのがテストです。作成元のビルダーエージェントは、テストを通せない場合にアサーションを勝手に緩めてタスク完了としてしまうことがあります。このパターンについてはテストをごまかすコーディングエージェントの見抜き方で解説しました。一方、結果に利害関係のない独立したレビュアーは、先入観なく差分を客観的に精査し、「この変更はタスクで求められた内容を過不足なく満たしているか?」という別の視点から問いかけることができます。
DeepSeek Harnessチームによるスーパーエージェントに関する設計エッセイでも、同様の役割分担が結論付けられています。同一のPRに紐づく複数のWorkerがイベントを共有し、エージェント間で競合を解決するというものです。これはリリースされた製品ではなくプロトタイプの設計ですが、その考え方は理にかなっています。レビュアーが独立した第三者であるほうが、レビューははるかにうまく機能するのです。
ステップ1:ビルダーとレビュアーを分離する
1つのエージェントに2つのモードを持たせるのではなく、2つの独立したAgentを作成します。それぞれに固有の指示、リポジトリ、実行ターゲットを設定します。
| Builder Agent | Reviewer Agent | |
|---|---|---|
| 役割 | タスクを実装し、PRを作成する | タスクの要件に照らしてPRを評価する |
| コードの記述 | あり | なし |
| プッシュ | フィーチャーブランチへプッシュ | 一切プッシュしない |
| ランタイム | 例: Claude Code | 理想的には別ランタイム(例: Codex) |
| 出力 | ブランチ、PR、要約コメント | 判定コメント |
SharklyのAgentには直接モデルを選択するピッカーはありません。その実行ターゲットはComputerとそのComputer上で検出されたRuntimeの組み合わせで構成されているため、「異なるモデルを使う」ということはレビュアーを別のRuntimeに紐付けることを意味します。別のRuntimeを採用することで、コード差分に対して異なる傾向や視点を持ち込むことができます。また、Sharklyはトークンを直接販売していないため、各実行はそのRuntimeに紐付いている既存のプランに基づいて課金されます。
レビュアーの作業ディレクトリはTemporaryモードに設定してください。Computersのドキュメントに記載されているとおり、これにより実行ごとに隔離されたディレクトリが割り当てられ、リポジトリの実行時にクリーンなGit worktreeを用意できます。レビュアーは独自のコピー環境でPRブランチをチェックアウトするため、ビルダーのファイルを上書きしてしまう心配がありません。複数のエージェントが1つのリポジトリを共有する際にこれがなぜ重要なのかについては、独立したworktree環境での並行エージェント運用で詳しく解説しています。
ステップ2:レビュアーへの指示を作成する
エージェントへの指示には、役割、チェック項目、報告フォーマットを定義します。タスク固有の詳細情報はタスク側に残しておきます。レビュアーへの指示は、簡潔でテスト検証しやすい内容にまとめましょう。
You are the code reviewer for this Space. You never push, merge or edit files.

1. Read the triggering task. If it is not a code task in this Space, reply "not mine" and stop.
2. Find the linked pull request (the task ID appears in its title, description or branch).
3. Check out the PR branch in your worktree. Run the test command from the repo README.
4. Compare the diff to the task's acceptance criteria.
5. Post one verdict comment on the task in the format below. Nothing else.
最初のステップは、見た目以上に重要です。現在の仕様では、ステータストリガーやコメントトリガーはOrganization全体を対象にマッチするため、指示の中でアクションを起こす前に自身の対象タスクであるかを確認する必要があります。この点はAutomationsのドキュメントでも明記されています。
ステップ3:トリガーを選択する
SharklyのAutomationは、指示、AgentまたはCrew、そして1つ以上のトリガーを組み合わせたものです。PRレビューには、主に2つのトリガーが適しています。
タスクのステータス変更:Spaceのワークフローに「In Review」などのステータスを追加します。ビルダーがPRを作成した後にタスクをそのステータスに移動させると、レビュアーが起動します。ステータストリガーによる実行ではそのタスク上に会話が作成されるため、判定結果やトークン消費量が作業内容に直接紐付いて記録されます。
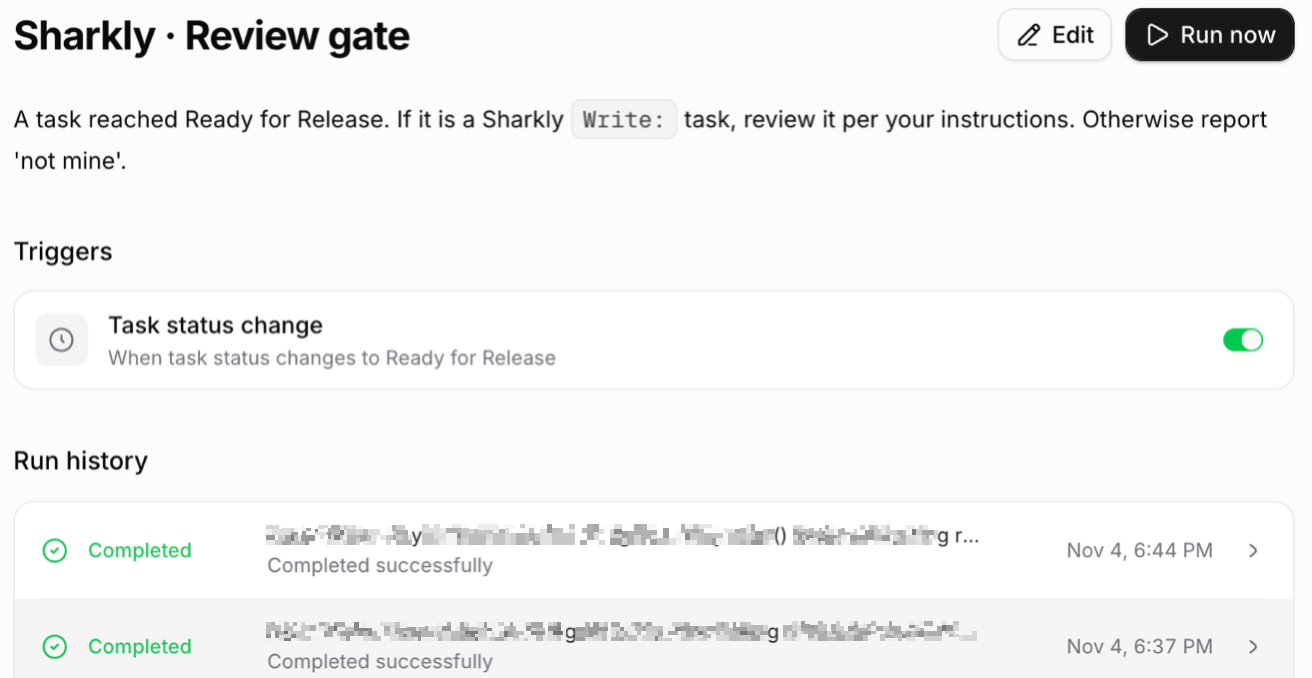
上のスクリーンショットは、当ブログが独自の下書き記事に対して実施している承認ゲートです。タスクが「Ready for Release」に達すると、レビュアーAgentが自動で作業を引き継ぎます。コードのレビューでも、まったく同じパターンを適用できます。
Webhook:タスクボードの外でPRが作成される場合は、GitHubのpull_request webhookをAutomationのWebhook URLに向けます。署名検証を有効にすると、SharklyはGitHubのX-Hub-Signature-256ヘッダーも受け付けるため、署名シークレットをGitHubのSecretフィールドに貼り付けます。Webhookによる実行はタスクに直接紐付かないため、レビュアーは代わりにGitHub CLIを使用してPR自体に判定結果を投稿します。
本格運用に入る前に、いずれの方法でもRun nowでテストを実行しておきましょう。
ステップ4:レビュアーにチェックリストを渡す
チェックリストのないレビュアーは長文の作文を書いてしまいますが、チェックリストがあれば具体的な指摘事項を整理して出力してくれます。次の5つのチェック項目で、エージェントが作成するPRの大半をカバーできます。
- テストが実行され、すべてパスしているか? ビルダーの報告を鵜呑みにせず、レビュアー自身でテストを実行します。
- スコープが守られているか? タスクの範囲外で変更されたファイルは、一見無害に見えても指摘対象とします。
- シークレットが漏洩していないか? 差分やログの中にトークン、APIキー、
.envの値が含まれていないか確認します。 - 呼び出し元に破壊的変更を与えていないか? 関数のシグネチャ変更、エンドポイントの削除、ロールバック処理のないマイグレーションなどがないかをチェックします。
- テストが弱体化されていないか? アサーションの削除、テストスキップの追加、期待値の緩和などが行われていないか確認します。
複数のレビュアーAgentで同じリストを共有する場合はSkillにまとめておくと、1箇所の編集で全員のチェックリストを更新できます。
ステップ5:判定フォーマットを固定する
人間が10秒で確認できる判定結果は、読み飛ばされてしまう長大なレビューよりもはるかに価値があります。以下のような固定フォーマットを使用しましょう。
VERDICT: CHANGES REQUIRED

Tests: 41 passed, 2 failed (test_refund_rounding, test_refund_zero)
Scope: OK, 3 files, all under billing/
Secrets: none found
Breaking changes: refund() now raises on amount=0; two callers in api/ not updated
Weakened tests: none

Required:
1. Handle amount=0 in refund() or update both callers.
2. Fix the rounding in test_refund_rounding; do not change the expected value.
PASSの場合も同じ項目を使用し、Requiredリストを空にしておきます。項目を固定化することで判定結果の集計も可能になり、どのチェックで不合格になりやすいかを把握してビルダーへの指示を改善していくことができます。
ステップ6:ビルダーへのフィードバックループを構築する
CHANGES REQUIREDの判定が出たら、人間が仲介することなくビルダーが自動で再起動するように設定しましょう。ビルダーAgentを割り当てた2つ目のAutomationを作成し、特定の特徴的なフレーズを検知するコメントトリガーを設定します。
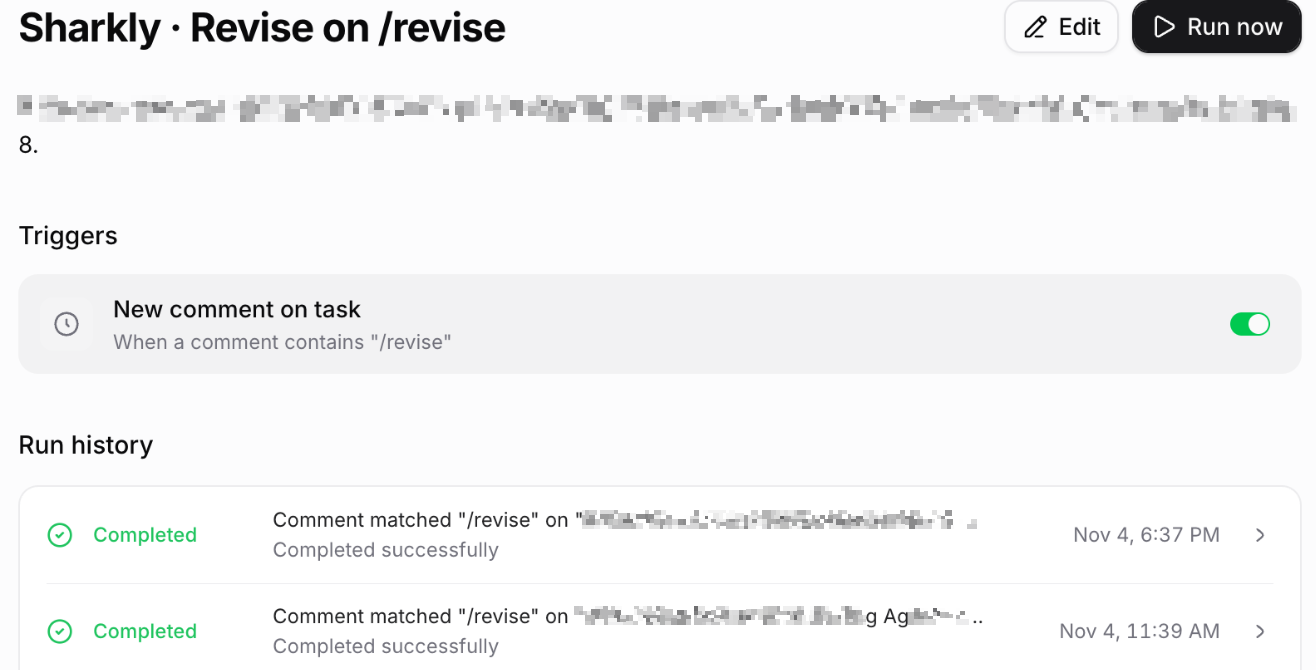
コメントのマッチングは大文字・小文字を区別せず、コメント内のどこかにそのフレーズが含まれていれば発火します。誤って手入力されることがないような固有のフレーズを選び、レビュアーにはCHANGES REQUIREDの行にのみそのフレーズを出力するよう指示します。ビルダーが返信でそのフレーズを引用してしまうと自分自身を再トリガーしてしまう恐れがあるため、ビルダー側にはそのフレーズを決して繰り返さないよう指示しておきます。
また、ループには上限を設けておきましょう。レビューと修正を2往復行ったら、レビュアーは直近の判定結果を添えてタスクを人間に引き継ぐようにします。
人間が引き続き担うべき責任
マージの権限と責任は、引き続き人間が担います。SharklyのGitHub連携では、PRタイトルに含まれるタスクIDによってPRとタスクが紐付けられますが、マージ操作によってタスクのステータスが自動変更されることはありません。エージェントがPASSと判定したからといって、勝手に本番環境へデプロイされることはないのです。
この安全策をGitHub側でも補強しておきましょう。保護されたブランチ(protected branches)を設定し、人間による承認を必須にしておくことで、自信満々なレビュアーエージェントが最終防衛ラインになってしまう事態を防ぎます。また、「これは適切な設計か?」「そもそもこの機能は本当に必要なのか?」といった、チェックリストでは判断できない意思決定も人間の役割です。手元に届くPRの優先順位付けについては、エージェントPRキューの優先順位付けや並行開発で人間のレビューがボトルネックになる理由をご覧ください。
まとめ
2人目のエージェントに一次レビューを任せることで、エージェントが生成したPRが未確認のまま山積みになるのを防ぐことができます。ビルダーとレビュアーを分離し、レビュアーには独立したworktreeとRuntimeを与え、ステータス変更またはWebhookをトリガーに起動して、5つの決まった項目を固定フォーマットで回答させましょう。問題があればコメントフレーズでビルダーに差し戻し、ループの上限を2往復に制限した上で、最終的なマージ権限は人間が保持します。
すでに10台のコーディングエージェントを同時に稼働させているなら、次に導入すべき仕組みはこれです。Sharklyの無料プランに登録し、まずはレビュアーAgentを作成してみましょう。
よくある質問(FAQ)
AIエージェントは自身が作成したプルリクエストをレビューできますか?
可能ですが、見逃しが多くなります。コードを作成したエージェント自身には、そのコードを生み出した前提や思い込みが刷り込まれているためです。独立した指示と、理想的には異なるRuntimeを備えた別のレビュアーを用意することで、そうしたバイアスなしに差分を客観的に検証できます。
レビュアーにはビルダーと異なるモデルを使うべきですか?
可能であればそのようにすることをおすすめします。SharklyではモデルはRuntimeに依存するため、ビルダーとは異なるRuntimeをレビュアーAgentに紐付けます(例: Claude Codeが作成したコードをCodexがレビューする構成など)。
AIコードレビュアーはまず何をチェックすべきですか?
まずはテストです。テストスイートをレビュアー自身に実行させ、成功・失敗の件数を報告させます。その上で、スコープの遵守、シークレットの有無、破壊的変更、テストの弱体化の順でチェックを行います。
レビュアーエージェントがPRを承認してマージすることは可能ですか?
マージ権限は与えないでください。ブランチ保護設定を利用して、マージ権限は常に人間に留めておきます。レビュアーはあくまで判定コメントを残す役割にとどめ、最終決定は人間が下します。
レビューのループが無限に続いてしまうのを防ぐにはどうすればよいですか?
レビュアーの指示文の中でレビュー回数を最大2往復までに制限し、ビルダーが返信で決して繰り返さないようなコメントフレーズを使用します。上限に達した後は、レビュアーがタスクを人間に引き継ぐように設定します。
Sharklyの外部で作成されたGitHubプルリクエストでも機能しますか?
機能します。GitHubのWebhookをAutomationのWebhookトリガーに接続してください。署名検証を有効にすれば、SharklyはGitHubの署名ヘッダーを受け付けます。


