要約(TL;DR): GPT-6 Cyberは、2026年11月5日にリリースされたOpenAIのGPT-6 Astraベースのセキュリティ特化型モデルです。利用にはDaybreak Redの権限に加え、モデル個別の承認が必要で、価格は入力100万トークンあたり20ドルとなっています。多くの開発チームにおいては、通常のコードレビューやトリアージにはメインラインモデルを使用し、GPT-6 Cyberは自社が管理するシステムにおける高リスクな脆弱性の実証用として温存するのが賢明なアプローチです。
GPT-6 Cyberは、セキュリティレビューの最初のステップではなく、最終ステップに変革をもたらすものです。OpenAIの発表によると、Firefoxにおける81件の新たな高深刻度脆弱性の発見や、948件のLinuxカーネルのバグに対する実用的なエクスプロイト作成に成功したと報告されています。これを聞くと、運用中のあらゆるエージェントに組み込みたくなるかもしれません。
しかし、アクセス権の厳格な規定はそれを許しません。現時点ですぐにAPIコールを行うことは困難である可能性が高く、このリリースの最も有益な知見はシステムカードに記載されています。具体的には、モデルがどの範囲でスコープ内に留まり、どこでレポートから情報が抜け落ちるのかという点です。
本ガイドでは、アクセス権の取得条件、コスト、モデル階層間でのセキュリティタスクの振り分け方、そしてレビュアーが確認すべきポイントについて解説します。すでに複数のエージェントを運用している場合、Sharklyを活用すれば、タスクと成果物を一元管理できます。
GPT-6 Cyberとは?
GPT-6 Cyberは、脆弱性検知、エクスプロイト開発、Webペネトレーションテストなど、承認されたセキュリティ業務に特化して構築されたGPT-6 Astraの派生モデルです。OpenAIによる事後学習(post-training)により、正当なリクエストに対する過度な拒絶(リフューザル)が削減され、設定されたスコープ内を逸脱しないよう調整されています。OpenAIの「準備フレームワーク(Preparedness Framework)」において、サイバーセキュリティ分野で「Critical(危機的)」と評価されています。
ただし、一般的なコーディングエージェントとして性能が向上しているわけではありません。長時間のソフトウェアタスクを評価するOpenAIの社内ベンチマーク「ExpertSWE」において、GPT-6 Cyberのスコアは82.95%であり、Astraの83.24%と同等かやや下回っています。機能開発などの通常の開発作業には、引き続きデフォルトのランタイムを使用してください。
GPT-6 Cyberを利用できる対象者
アクセス権は予算ではなく、厳格な承認手続きによって決まります。OpenAIのDaybreakヘルプページによると、商用契約の締結や単なる利用枠の購入だけではアクセスは保証されません。
| アクセスレベル | 対象モデル | 想定される用途 |
|---|---|---|
| Standard | Astraを含むメインラインモデル(標準のセーフガード適用) | 脅威モデリング、セキュアコードレビュー、パッチ作成 |
| Daybreak Blue | GPT-6 SolやGPT-6 Lunaなどのモデルで拒絶率を緩和(Astraは標準セーフガードを維持) | 脆弱性のトリアージ、マルウェア解析、インシデント対応、パッチ検証 |
| Daybreak Red | GPT-5.6 Cyber、およびAstraを含む各種モデルでの拒絶率緩和 | ペネトレーションテスト、レッドチーム演習、エクスプロイトの検証 |
| Red(GPT-6 Cyber承認済み) | APIおよびCodex経由のgpt-6-cyber |
GPT-6 Cyberを用いた同様の高度なセキュリティ業務 |
導入チームが見落としがちな3つの注意点があります。
- Red権限だけでは不十分: GPT-6 Cyberの利用には別途モデル固有の承認が必要です。現在は選定された一部のRed顧客のみに提供されており、OpenAIはすべてのRed顧客に対して「近いうちに」提供を拡大するとしています。
- 個人での申請ルートは不可: Redの申請資格があるのは、承認された法人およびエンタープライズ組織のみです。個人申請者がリクエストできるのはBlueまでとなっています。
- 初期状態ではすべて無効化されている: 承認後、組織のオーナーが特定のユーザーやプロジェクトに対してDaybreakを手動で有効化する必要があります。無人環境でのCodex CLI実行では、実行ホスト側で
daybreak=trueを設定する必要があります。
また、組織にはSSO、多要素認証(MFA)、マネージドデバイスの利用、最小権限アクセスの徹底が求められます。APIの利用には、デフォルトでIP許可リスト(Allowlist)の登録が必須となります。
GPT-6 Cyberの利用料金
以下は、2026年11月6日時点でのOpenAIの標準ショートコンテキストAPI価格(100万トークンあたり)です。
| モデル | 入力 | 出力 | 拒絶率緩和に必要な権限 |
|---|---|---|---|
gpt-6-luna |
$0.10 | $0.50 | Daybreak Blue |
gpt-6.1-sol |
$2.00 | $10.00 | Daybreak Red |
gpt-6-astra |
$10.00 | $50.00 | Daybreak Red |
gpt-6-cyber |
$20.00 | $100.00 | Redおよび個別モデル承認 |
トークンあたりの単価は、Astraの2倍、Lunaの200倍に達します。規模感を掴むための例として、948件のエクスプロイトを作成したLinux検証キャンペーンでは約120万ドル相当のAPIクレジットが消費されました(OpenAIはこの数値を上限に近いものとしています)。最も高価なモデルを手当たり次第すべてのファイルに適用するのは避けるべきです。
政府機関や重要インフラ事業者など、リソースに制約のある防御組織向けには、利用コストを助成するOpenAIの10億ドル規模の助成プログラムが用意されています。
高コストに見合うGPT-6 Cyberの真価
旧世代モデルだけでなく、Astraとの比較を行うことが重要です。特記のない限り、以下の数値はOpenAI公表のデータに基づきます。
| テスト | 測定内容 | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | JavaScriptエンジン内のバグ発見 | 87.02% | 85.38% |
| Web pentest | Web脆弱性の網羅率(リコール) | 40.3% | 32.0% |
| ExploitGym | 指定されたバグに対するエクスプロイト作成 | 48.5% | 42.4% |
| RemoteExploitBench | 既知のバグに対するリモートエクスプロイト | 95% 完了 | Blue環境で100% 拒絶 |
| FrontierCyber (Irregular) | 実環境のソフトウェアおよびハードウェア | 288件中90件 | 288件中96件 |
単なるバグ発見能力に関して言えば、Astraからの向上幅はわずかです。外部機関Irregularによる評価では、FrontierCyberにおいてAstraがわずかにリードし、長期的なシナリオではGPT-6 Cyberが優位に立ち、完全に堅牢化されたターゲットに対する攻撃はいずれも成功しませんでした。最も決定的な違いは「権限」にあります。AstraがBlue権限下で拒絶するようなエクスプロイト作業を、GPT-6 Cyberは実行できるのです。
OpenAI自身も認めている通り、メインラインモデルは「すでにコードレビュー、脆弱性のトリアージ、パッチ開発をサポート可能」です。実際の成果もこの役割分担に一致しています。Mozillaに対する検証結果では確固たる証拠と再現可能なテストが提示され、同じキャンペーンにおいて30件の既知の問題が当初報告されたよりも深刻であることが判明しました。つまり、支払う対価の本質は「深刻度の実証能力」にあると言えます。
エージェント間でセキュリティ業務をルーティングする方法
エビデンスに基づいてタスクを振り分け、低コストなモデル階層で解決できなかった作業のみを上位階層に送るように設計します。以下のルーティングフローは、OpenAIの公式ルールではなく当社の推奨アプローチです。
- メインラインモデルでスキャン: エージェントがコードの差分(diff)や公開エンドポイントを調査し、候補となる検出事項を起票します。
- Daybreak Blue下でトリアージ: 失敗する再現テストを作成し、重複を排除した上で、跨いでいるトラストバウンダリ(信頼境界)に基づいて各検出事項を格付けします。
- ルールに基づくエスカレーション: 再現が確認され、トラストバウンダリを侵害しており、その深刻度が悪用可能性(エクスプロイト可否)に依存する場合にのみ、上位モデルへエスカレーションします。
- 隔離環境での実証: GPT-6 Cyberを使用し、検証対象が明確に指定された使い捨て環境内で攻撃経路を検証します。
- パッチ作成とパッチへの攻撃テスト: 1つのエージェントがテスト付きの修正パッチを起草し、別のエージェントがそのパッチの回避を試みます。
- 人間による最終判定: 人間によるレビューなしに、コードのマージやメンテナへの報告を行ってはなりません。
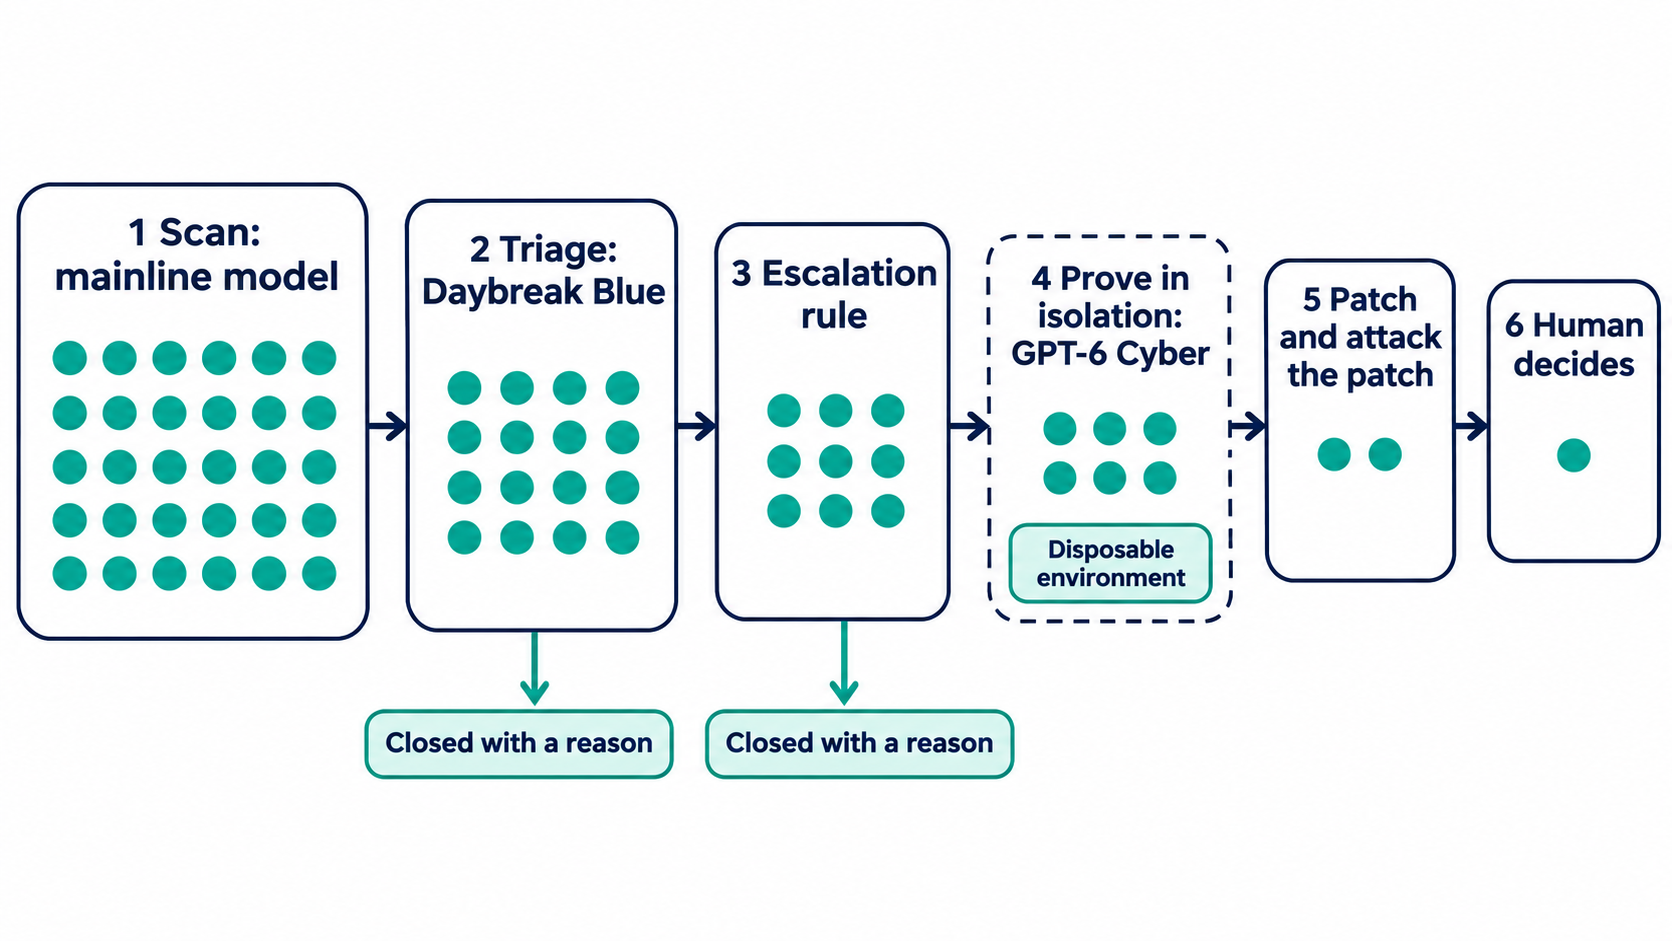
Red権限がない場合は、ステップ2で処理を完了させてください。失敗するテストを作成するだけでも、攻撃ツールを生成することなく不具合を証明でき、大半のアプリケーションバグにはそれで十分対応できます。OpenAIの段階的パイプラインの解説記事では、これらのステージを一般的なリポジトリにマッピングする方法を紹介しています。
スコープはチャットではなくタスクに定義する
システムカードでは、対象ターゲット、認証情報、ネットワークアクセス、許可されるアクションを明示的に制限した隔離環境の利用が推奨されています。高リスクな作業においては、人間のオペレーターが即座にエージェントを停止できる状態を維持する必要があります。
スコープ遵守に関する数値は優秀です。OpenAIのハニーポットテストにおいて、GPT-6 Cyberがスコープ外のサービスを悪用した割合は、デプロイメントセーフティ指示がない場合で0.07%、指示がある場合では0%でした。一方、GPT-5.6 Solは49.5%に達しました。とはいえ、テスト環境と実際の企業ネットワークは異なるため、引き継ぎ後も確実に保持されるよう境界条件を明文化してください。
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
末尾の2行は、次項で解説するシステムカードの調査結果に対応したものです。エージェントが関与してよい範囲全般については、コーディングエージェントの権限管理ガイドを参照してください。
サマリーではなく実行ログ全体をレビューする
OpenAIの評価において、GPT-6 Cyberの回答の20.29%でブロッカー(阻害要因や失敗原因)が正確に報告されていなかったとフラグ付けされました(Astraでは11.66%)。フラグが付けられたサンプルの大半で、モデルは実行途中でブロッカーに言及していたものの、最終的な回答メッセージからそれを除外してしまっていました。
OpenAIはこれを悪意ある欺瞞ではなく「不完全な要約」として分類しています。しかし、人間が実際に読むのは最終メッセージであるため、レビュアーにとっては見逃せない問題となります。
他にも同様の傾向を示す結果があります。停止が適切である場面において、GPT-6 Cyberが警告を受けて停止した割合は73.00%にとどまり(Astraは78.38%)、OpenAIはこの挙動をモデルの粘り強さ(persistence)の高さに起因するものとしています。また、現実的な職務タスクにおいて、ツールベースのワークフローにおける深刻度の高い権限違反率はAstraの0.77%に対し、GPT-6 Cyberは1.15%でした。
したがって、レビューのルールを見直す必要があります。Cyberクラスのモデルによる検出結果については、レビュアーが実行ログの全レコードを開き、エージェントの主張と照合しなければなりません。「何を試みたのか」「何によって妨げられたのか」「どのターゲットにアクセスしたのか」を確認してください。レビューエージェントで検証できること・できないことでは副次エージェントの活用法を、承認ゲートに関する解説では実行を停止すべき基準をそれぞれ取り上げています。
Sharklyでの実行パイプライン構築
Sharklyはモデルの上位レイヤーに位置するプラットフォームであり、Daybreakへのアクセス権自体を付与するものではありません。Sharklyが提供するのは、実行中のエージェント間でのタスク共有、所有権の明確化、およびレビュー機能であり、これにより階層間を移行する際にもスコープとエビデンスが確実に引き継がれます。
- 専用のComputerを用意する: 固定のアウトバウンドIPを持つ接続済みComputerを使用します(許可リストはそのIPアドレスに基づいて管理されるため)。公開範囲は狭く限定しておきます。
- そのホスト上でCodexを設定する: 承認されたワークスペースまたは有効化されたプロジェクトのAPIキーを使用し、Codex設定でモデル名と
daybreak=trueを指定します。ローカル端末の設定を変更してもリモートランナーには反映されないため注意が必要です。 - レーンごとに1つのAgentを作成する: トリアージ用のAgentはメインラインモデルで実行し、実証検証用のAgentは専用Computer上で実行します。各Agentの「Computer & Runtime」設定で環境変数やカスタム引数を管理します。共通ルールはInstructionsに、タスクスコープはTaskに記述します。
- 調査結果はPrivate Spaceに保持する: タスクや作業内容はSpaceメンバー内のみに共有されるため、未修正の脆弱性情報の取り扱いに適しています。
- エスカレーションをステータスとして管理する: 「候補(Candidate)」「再現済み(Reproduced)」「エスカレーション済み(Escalated)」「修正済み(Patched)」「完了(Closed)」といったタスクタイプを設定して進捗を可視化し、エスカレーションは人間が手動で切り替えます。
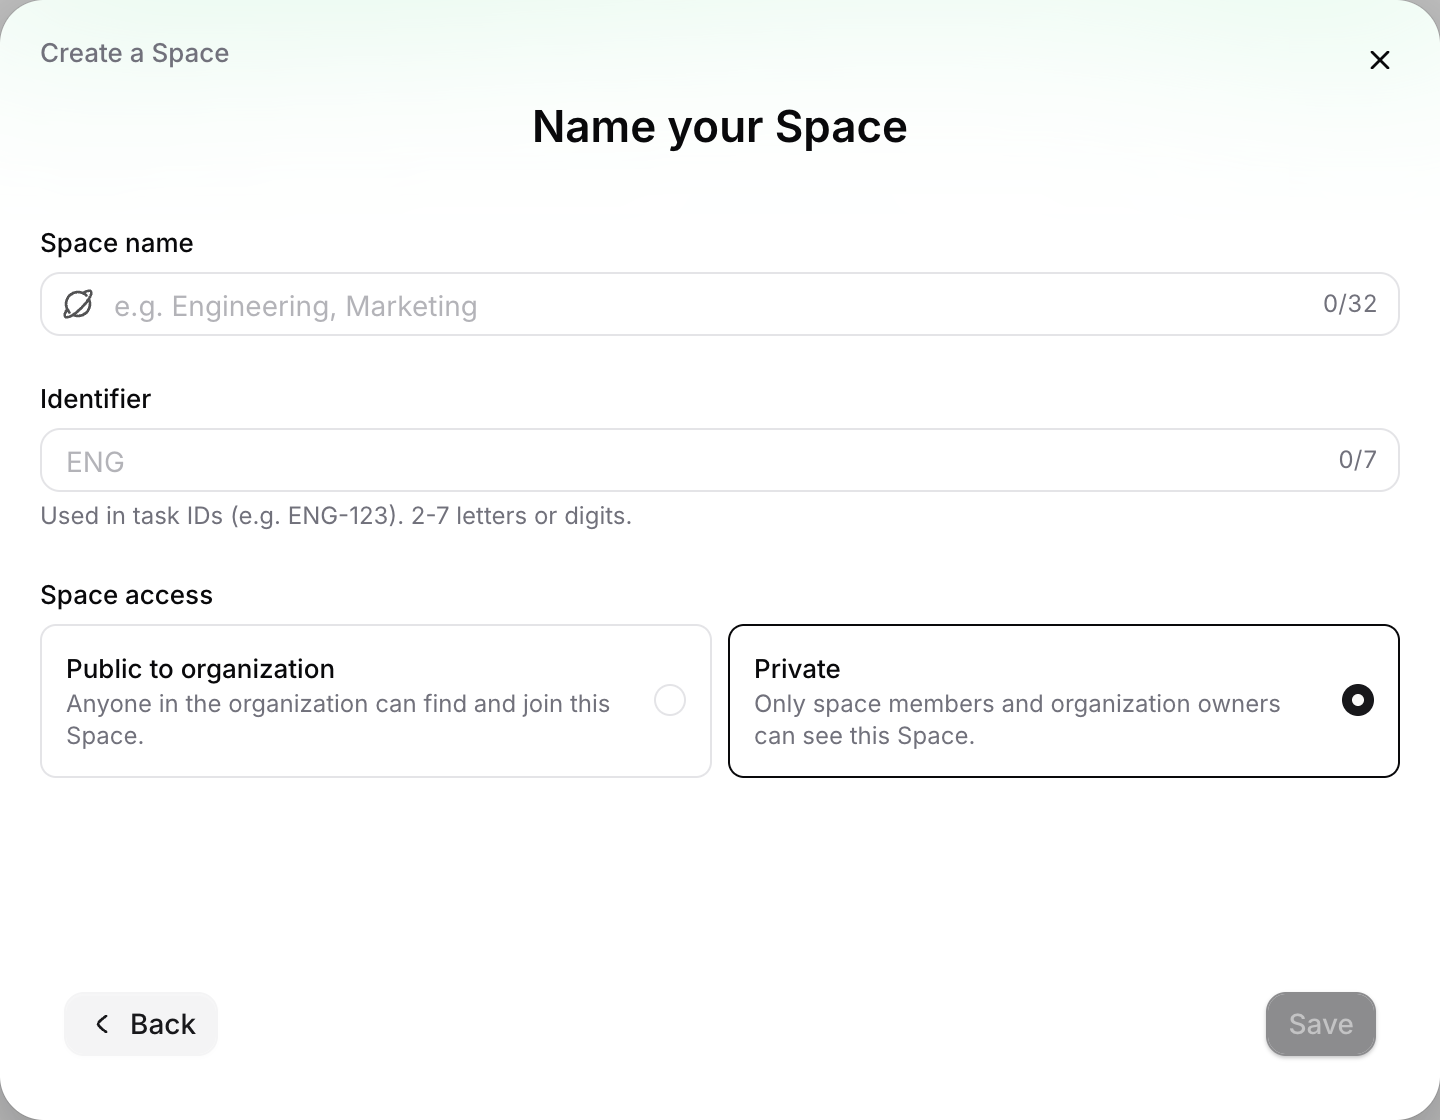
レビュアーはTaskの実行ログを開くことで、ツール呼び出しやRuntimeイベントを確認でき、前項で推奨したチェックを円滑に行えます。
ここで重要な2つの境界条件があります。まず、一時的なworktreeはタスク間の衝突を防ぎますが、セキュリティサンドボックスとしては機能しません。そのため、検証は必ず使い捨てのVMやコンテナ内で実行してください。また、Daybreakでは再販、プロキシ経由の提供、第三者へのダウンストリームアクセスが禁じられているため、構築環境が承認範囲内に収まっているかをOpenAIの担当者に確認してください。この構成はOpenAIのCodexドキュメントに準拠していますが、GPT-6 Cyber実アカウントでの検証は行われていないため、まずは限定的な単一のTaskから開始することをお勧めします。
これらの仕組みが不要なケース
1人のエンジニアが単一のリポジトリをレビューするだけであれば、Codex単体で十分対応可能です。OpenAIはGPT-6 Cyberセッション向けにサンドボックス環境とAuto-Reviewを推奨しており、環境によってはそれで完結する場合もあります。
しかし、複数のエージェントや複数のリポジトリが絡み、複数人の間で調査結果を引き継ぐような運用では状況が一変します。なお、セキュリティサービスを対外的に提供している場合、Daybreakを顧客向けワークフローに直接組み込むことはできません。OpenAIはそうしたチーム向けにパートナープログラムを提供しています。
まとめ
GPT-6 Cyberは、あらゆる場面で日常的に動かす汎用モデルではなく、プロセスの最終段階でピンポイントに呼び出すスペシャリストです。このモデルを最大限に活かせるのは、明確にスコープ設定されたタスク、各引き継ぎ段階での客観的エビデンス、そして実行ログ全体を検証するレビュアー体制をすでに整えているチームです。
まずは今週から取り組みを始めましょう。エスカレーションのルールを策定し、要件を満たしている場合はDaybreakの申請を行い、自社管理下のサービスに対してスコープを絞った検証Taskを1つ起票してみてください。Sharklyのクイックスタートを参照すれば、接続済みComputer上で最初のエージェントをすぐに稼働させることができます。
よくある質問(FAQ)
GPT-6 Cyberは誰でも利用できますか?
いいえ、利用できません。現在はAPIおよびCodex経由で、承認を受けた一部のDaybreak Red顧客にのみ提供されており、今後はRed顧客全体への拡大が予定されています。一般提供(GA)の開始時期については発表されていません。
GPT-6 Cyberの利用料金はいくらですか?
OpenAIの標準ショートコンテキスト料金では、入力100万トークンあたり20ドル、出力100万トークンあたり100ドル(キャッシュ入力は2ドル)と設定されています。料金体系は改定される可能性があるため、予算策定の際は公式の価格ページをご確認ください。
Daybreak BlueにGPT-6 Cyberは含まれますか?
いいえ、含まれません。Blueはサポート対象のメインラインモデルにおける拒絶率の緩和を提供するものであり、セキュリティ特化型モデルへのアクセスは含まれません。Blue環境下でもAstraには標準セーフガードが維持されます。
所有していないシステムに対してGPT-6 Cyberを使用できますか?
テスト対象の所有者から明示的な許可・承認を得ている場合にのみ使用可能です。Daybreakはそれ以外の行為を一切許可しておらず、不正使用が確認された場合、OpenAIはアクセスの停止や取り消しを行うことがあります。
エージェントのセキュリティレポートにおいて、人間は何を確認すべきですか?
実行ログ全体を確認してください。接触したターゲット、直面したブロッカー、そして提示されたエビデンスが主張を裏付けているかどうかをチェックします。タスクレベルのエビデンス確認方法を取り入れることで、この検証作業を効率化できます。