
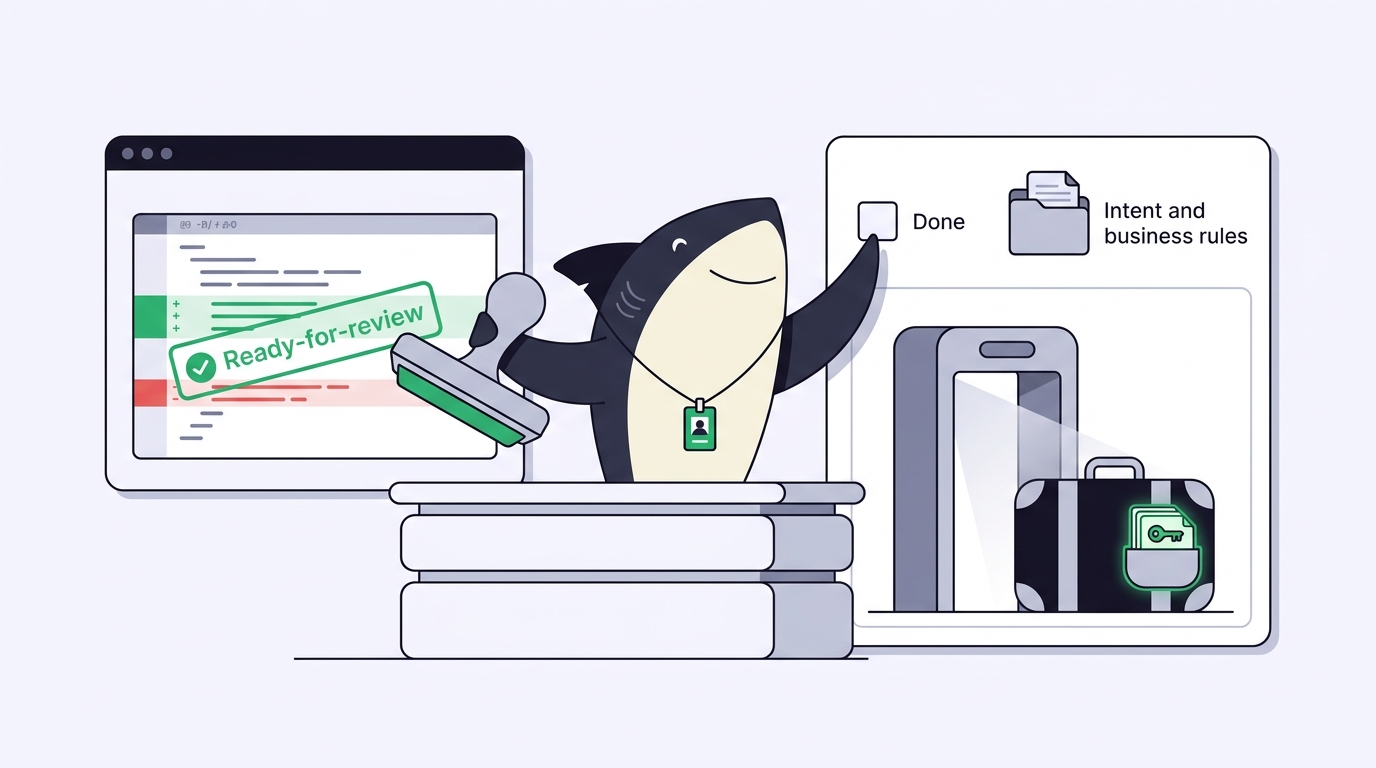
AIコードレビューエージェントをパイプラインに組み込んだところ、ちゃんと動いた。nullチェックの抜けを指摘し、未使用のimportを見つけ、命名について3件の簡潔なコメントを残した。あなたはマージした。それから2日後、そのエージェントが読み飛ばしてしまったバグをお客様が踏んだ。その変更は内部的にはきれいで、しかし間違ったことをしていた。レビューエージェントはコードを検証した。だが意図は検証できなかった。
このギャップこそが、AIコードレビューエージェントのすべてだ。彼らは特定の、チェック可能な種類の問題には強いが、diffの中では同じに見える別の種類の問題には盲目だ。彼らの承認をそのまま受け入れと見なせば、その盲目の部分を出荷してしまう。線がどこにあるかを知っていれば、高速な一次チェックとして活用でき、人間のレビュアーを、人にしかできない判断に集中させられる。
本記事ではその線を地図化する。AIコードレビューエージェントが検証できること、できないこと、そして両者を混同しないための運用モデルだ。Sharkly はこれから見ていくレイヤーであり、エージェントのレビューと人間の受け入れが、同じ Task 上の異なる2つのステータスとして扱われる共有ワークスペースだ。単なるハンコではない。あなたはすでにコーディングエージェントを持っている。ここでのポイントは、もう1つのエージェントでループが閉じたふりをせずに、その出力をレビューすることにある。
AIコードレビューエージェントが検証できること
AIコードレビューエージェントとは、diffを読み、それに対してチェックを実行し、人間のレビュアーがコメントを残すのと同じように指摘を報告するプログラムだ。その信頼できる領域は、注意深いレビュアーが変更とそのすぐ周辺を読むだけで確認できるものすべてだ:
- 機械的な正しさ:構文、型、明らかなnull処理と境界処理、未処理のPromise rejection、diff上で見えるリソースリーク。
- 局所的なロジック:オフバイワンエラー、反転した条件、デッドブランチ、設定前に読まれる変数。
- 規約:命名、フォーマット、importの衛生状態、新しい関数のそばにテストがあるかどうか。
- 既知のアンチパターン:文字列連結で組み立てられたSQL、平文でコミットされたシークレット、入力検証を欠いたpublicメソッド。
これらには共通する特徴が1つある。証拠がdiffの中に存在するのだ。エージェントはこれらを捕まえるのに、あなたのビジネスを知る必要はない。そして午後6時の疲れた人間より速く、一貫して捕まえる。これは本物の価値であり、チームがこうしたツールに手を伸ばす理由だ。Google のコードレビューガイドは、この機械的なチェックを前提条件として扱い、人間の注意力を設計に集中させられるようにしている。AIレビュアーは、そのチェックを毎回確実に通す、忍耐強い方法だ。
検証できないこと
境界線をはっきり述べよう。AIコードレビューエージェントは、その変更が正しい変更であることを検証できない。以下はすべて、diffには含まれないコンテキストを必要とする。
- 意図と仕様:コードが完璧でも、間違った問題を解決しているかもしれない。それを決めるのはチケットの受け入れ基準だけであり、エージェントはそれを視野に入れていることはほとんどない。
- ビジネス上の正しさ:割引ルール、税計算、権限境界が会社の実際のやり方と一致するかどうかは、lintルールではなく判断の問題だ。
- システム横断の挙動:あるファイルでは問題なく読める変更が、3つ先のサービスにある呼び出し元を壊すことがある。OWASP Top Ten には、リクエストパス全体を追わなければ現れないアクセス制御の不備のような失敗が溢れている。diffを追うだけでは見えない。
- テストが正直かどうか。エージェントはテストが存在し、通ることを確認できる。だが、そのテストが重要なことを検証しているか、あるいはコードを書いたエージェントが通るように形作ったテストも書いていないかは、教えてくれない。
最後の項目は、AIが書いたコードに固有の罠だ。同じ種類のシステムが変更とレビューの両方を生み出すとき、きれいなdiffとグリーンのチェックはどちらも真であり、どちらも的外れになり得る。したがって、レビューエージェントからの承認はシグナルであり、決定ではない。エージェントは報告し、人間が受け入れる。
ギャップを埋める運用モデル
解決策は、より優れたレビューエージェントではない。レビューエージェントの仕事と人間の仕事が異なる状態であり、どちらも省略されない運用モデルだ。
Sharkly はこうした状態を Task status として明示する。Task は In progress → Ready for review → Done と進む。ルールはシンプルで、かつ重要な土台となる。エージェントは作業を Ready for review に移し、人間が Done に移す。エージェントは、コードを書いたのであれレビューしたのであれ、自分の作業を承認済みにすることは決してできない。エージェントは調査し、実行し、テストし、報告する。人間は方向性を定め、権限を与え、結果を受け入れる。自動化は、チームの判断が必要なところで止まる。
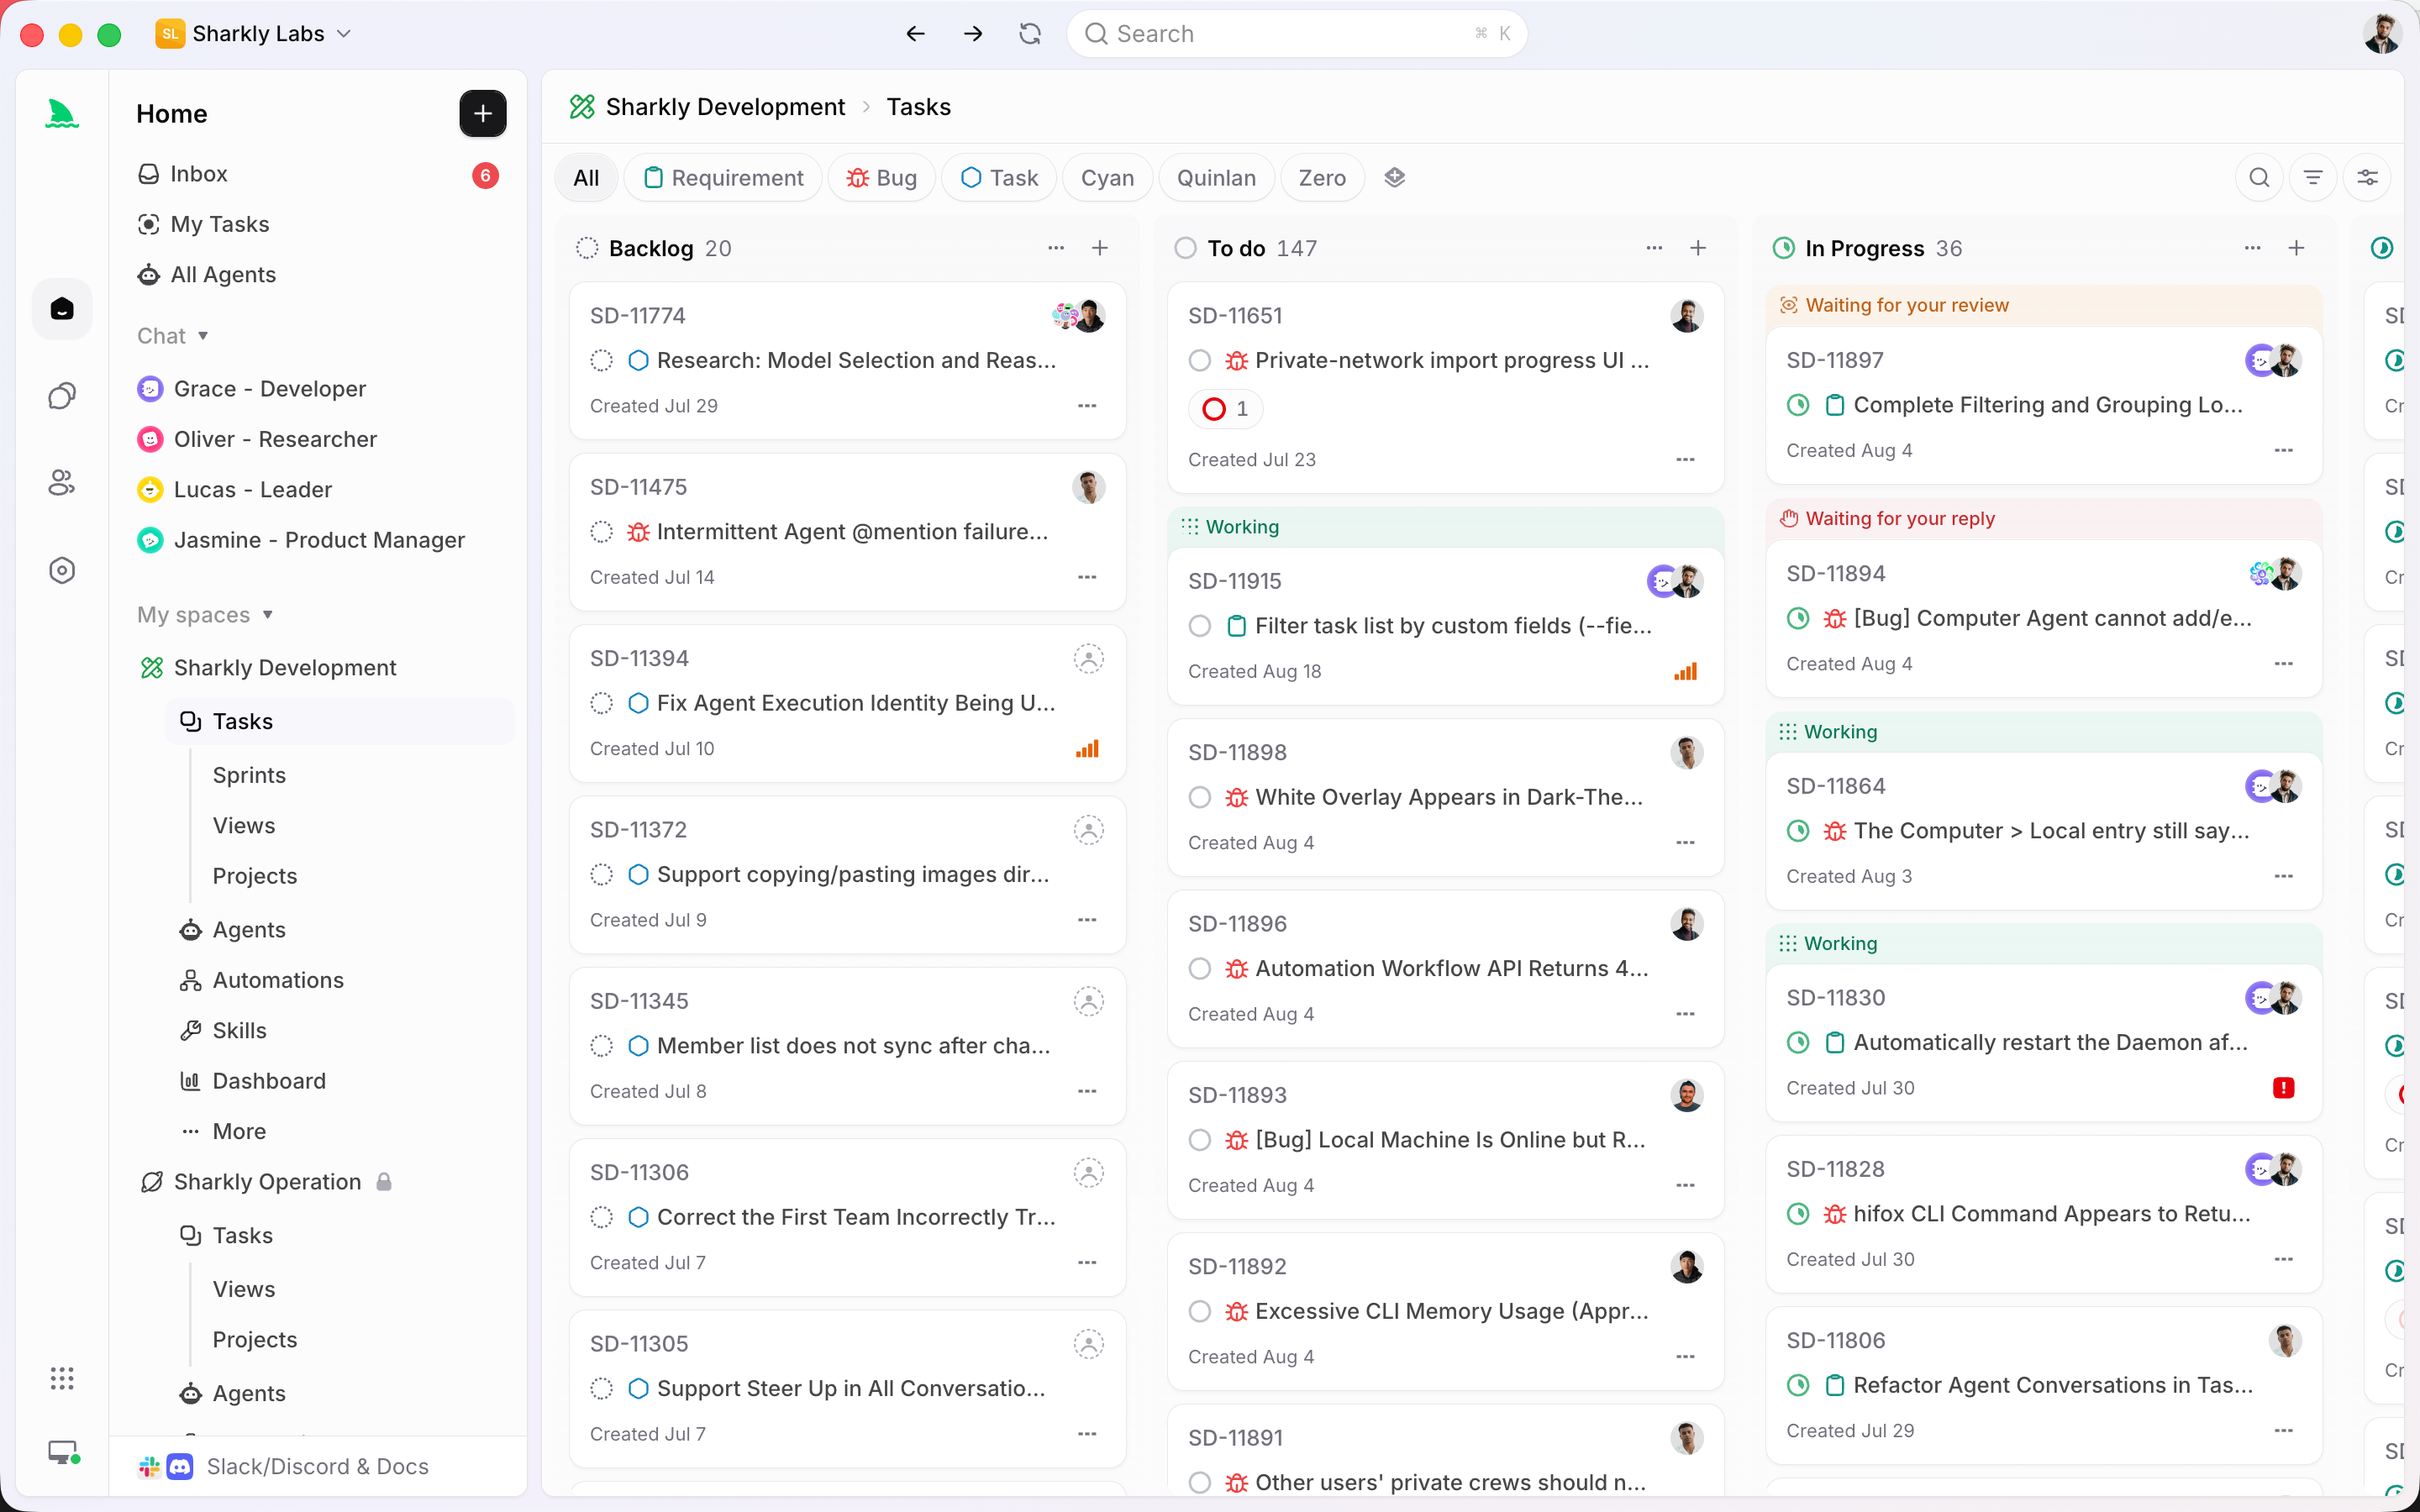
各役割には1つの仕事がある。コーディングエージェントは変更を生み出す。レビューエージェントは機械的なチェックを実行し、その指摘を添付する。人間のレビュアーはその指摘を読み、変更がチケットの意図に沿っているかを確認し、判断する。すべては Task に戻る。diff、レビューエージェントのコメント、テスト出力、人間の決定が、PRやチャットや誰かの記憶に散らばるのではなく、1つのタイムライン上に存在する。
変更が機械的で自己完結している場合——リファクタリング、依存関係の更新、スコープの明確なバグ修正——は、レビューエージェントを最初のゲートとして使い、ノイズを片付けさせて人間のチェックを高速化しよう。変更が金銭、認証、データマイグレーション、公開コントラクトに触れる場合は、それを唯一のゲートとして頼ってはいけない。そこでは人間が先に読み、エージェントのチェックは判決ではなくチェックリストだ。
実例:チケットからマージ済みPRまで
SH-312を例に取ろう:「チェックアウト時に期限切れのクーポンコードを拒否する」。人間が受け入れ基準を書き、Task を割り当てる。コーディングエージェントがそれを引き受け、分離されたworktreeで作業し、diffとパスするテストを Task に返し、Ready for review に移す。
次にレビューエージェントが動く。型を確認し、nullガードの欠落を1つ指摘し、テストが期限切れケースをカバーしていることに言及する。クリーンなチェックだ。昔の習慣なら、この承認でマージしてしまう。
しかし今回は、人間のレビュアーが Task を開き、意図に照らして読む。コードは書かれたとおり、期限切れのクーポンを拒否する。しかし受け入れ基準は、すでに引き換え済みのクーポンも拒否すべきことを暗に含んでいた。コーディングエージェントもレビューエージェントもそれを知らなかった。なぜならそれはレビュアーの頭とプロダクト仕様の中にあり、diffにはないからだ。レビュアーは変更を要求する。SH-312 は具体的なメモとともに In progress に戻り、エージェントが拡張し、その後にようやく人間が Done に移して pull request をマージする。
レビューエージェントはしっかり仕事をしたのに、それでもギャップを出荷してしまうところだった。運用モデルがそれを捕まえた。受け入れが、コンテキストを持つ人間による別個の行為だったからだ。これは task-level evidence でAI生成コードをレビューする 背景にあるのと同じ規律だ。レビューの単位は Task とその意図であり、孤立したdiffではない。
レビューゲートをどこに置くか
実用的な問いは、AIコードレビューエージェントを使うかどうかではない。そのチェックがどこで数えられ、どこで人間が先に読む必要があるかだ。通用するいくつかのルール:
- すべての変更で、スタイル、フォーマット、機械的バグはエージェントにゲートさせる。それが最も得意で、人間が疲れているときに最も苦手なチェックだ。
- 認証、課金、データマイグレーション、公開APIに触れるものには人間のゲートを必須にする。盲点はそこに集中する。
- ゲートは review capacity に合わせてサイズを決める。エージェントは人間が受け入れるより速く生産するので、人間のチェックはエージェントが盲目なところに使う。
- ゲートを習慣ではなくステータスにする。Done をブロックする文書化された approval gate は強制力があるが、「誰かが見るべき」という規範はそうではない。human in the loop を保つのは、そのループがワークフローが要求するステップであるときだけ機能する。
AIコードレビューエージェントは、人間のレビュアーの代替ではない。人間のチェックをより速く、より鋭くする最初のパスだ。すでに複数のコーディングエージェントを動かしていて、その出力を5つのPRタブではなく1か所でレビューし受け入れたいなら、それが Sharkly が解決しようとしている問題だ。共有 Task 上で エージェントの作業を割り当て、追跡し、レビューする。レビューエージェントの指摘と人間の決定がどちらも同じ記録に戻る。すでに使っているコーディングエージェントとレビューエージェントはそのままに、彼らのチェックがいつ十分かを決める レイヤーを追加 しよう。


