
Anthropicは、Claude Opus 5.5の実行コストがOpus 5より40%低いと発表している。あなたのチームの誰かは、もうあの当たり前の計算を済ませているはずだ。同じ予算でエージェントの実行回数はおよそ1.7倍、つまり出荷される成果もおよそ1.7倍になる、と。その計算は算術としては正しいが、運用としては間違っている。そしてそれに基づいて動いた週には、誰も読んでいない完了済みの実行結果でボードが埋め尽くされることになる。
エージェントをより多く並列で走らせるうえでの制約は、これまで一度もモデルの請求額ではなかった。それは、1人の人間がdiffを読み、エージェントが下した判断を理解し、それを承認する能力だった。値下げはその数字を何も変えない。変わるのは、その数字に仕事がどれだけ速く届くかだけだ。
TL;DR
レビュー上限(review ceiling)とは、チームが1日のうちに実際に読んで判断し、承認できる完了済みエージェント実行の数のことだ。これを決めるのはトークンではなく人間である。安価なモデルは、その上限に仕事が届く速度を上げるだけで、上限そのものには何も手を付けない。だから値下げで最初に見える効果は、リリースの加速ではなくキューの長期化だ。エージェントは調査し、実行し、テストし、報告する。人間は方向性を定め、権限を与え、結果を承認する。有効な対応は、予算ではなくレビュアーを基準に同時実行数を制限すること、そして1つのレビュー可能な結果へ収束するエージェント作業と、多数へファンアウトする作業を切り分けることだ。Sharklyは、リクエストからリリースまで、コンテキスト、進捗、ブロッカー、結果、人間によるレビューをTask上で可視化し続ける。それによって初めて、キューは数えられるものになる。
実際に安くなったもの
2026年9月22日、2つのラボが相次いで発表した。ここでは、あなたの請求書に関わる部分だけを挙げる。
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| API ID | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| 入力 100万トークンあたり | $5 | $4 | $2 | $0.10 |
| 出力 100万トークンあたり | $25 | $20 | $10 | $0.50 |
| キャッシュ入力 | n/a | 読み取り$0.20、書き込み$5 | 読み取り90%オフ | 読み取り90%オフ |
Anthropicは、Opus 5.5の実行コストがOpus 5より40%低く、出力は約30%高速だと述べている。上のリスト料金はOpus 5のトークン価格から20%引きであり、これは公表された2つの数字から当社が計算したもので、40%という主張とは別の話だ。OpenAIは、SolとLunaがそれぞれGPT-5.6のプロモーション価格より50%安いと述べている。そして「プロモーション」はOpenAI自身が使った言葉なので、この見出しの数字はリスト料金ではなく割引価格と比較したものになる。
完了タスクあたりのコストは、トークンあたりのコストよりも大きく動いた。AutomationBench 1.0.6では、OpenAIの報告によると、extra high reasoningのGPT-6 Solがタスクあたり$0.27で33.2%を記録し、max reasoningのClaude Opus 5はSolの11.1倍のコストで26.9%だった。DeepSWE 1.1では、OpenAIはmax reasoningのGPT-6 Lunaについて、Opus 5よりタスクあたり93%安く66.6%だとしている。
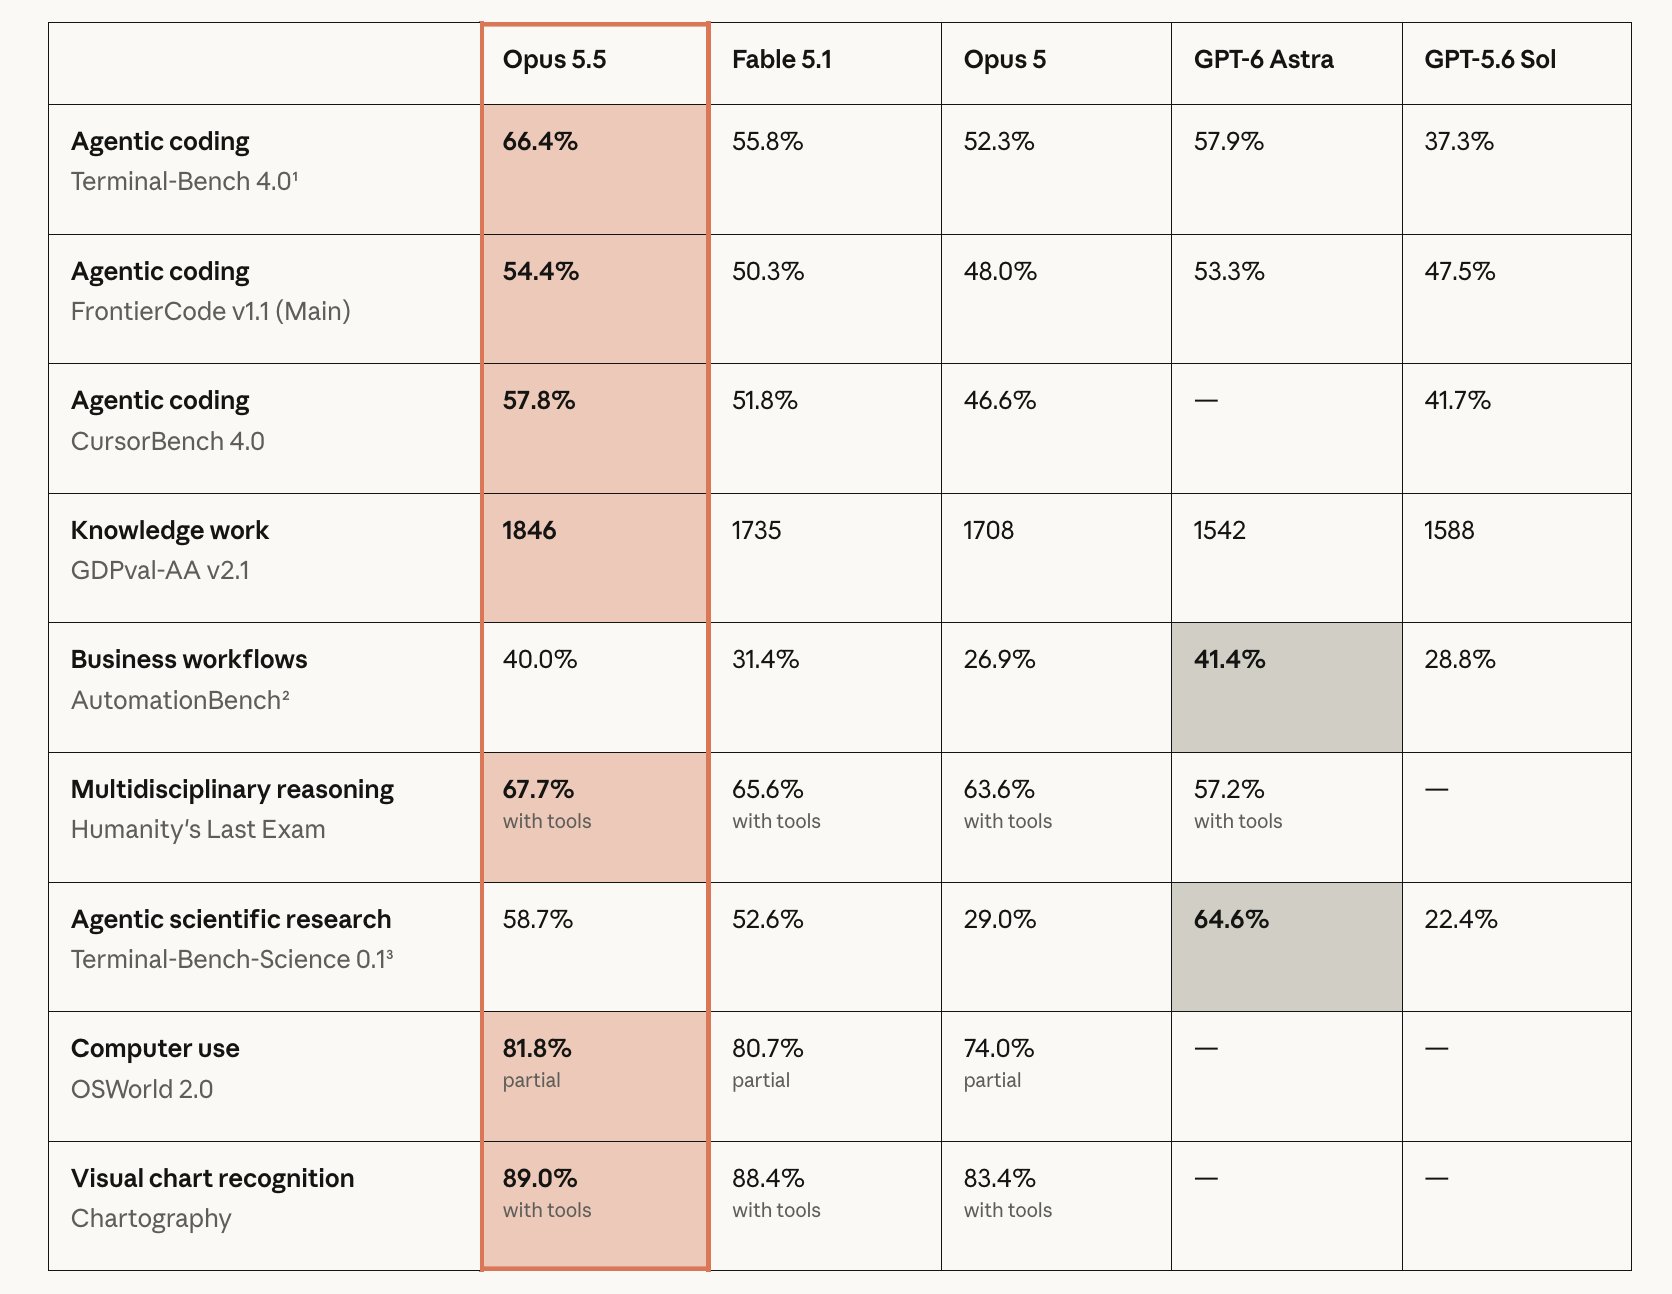
つまり、試行1回あたりの価格は、2社にまたがって、1日のうちに大きく下がった。あなたの1週間の中で、それ以外に変わったものは何もない。
今週みんながやったあの計算
支出を一定に保って割ってみる。実行コストが40%低ければ、同じ月額で買えるOpus 5.5の実行回数は、Opus 5の約1.67倍になる。さらに定型作業の半分をLunaに回せば、この倍率はもはや面白くもなんともない。100万トークンあたり$0.10と$0.50では、モデル費の行はもう予算を左右する項目ではないからだ。
次に2つ目の計算をしよう。これが出荷できるかどうかを決める計算だ。あなたのエンジニア1人が1日にきちんと読める完了済み実行の数を取る。流し読みではなく、緑のチェックマークで承認するのでもなく、diffを読み、エージェントが何をしようとしたのかを理解し、その責任を引き受けるという意味での数だ。その数字がいくつであれ、2026年9月21日も同じだったし、来四半期も同じだろう。レビュー容量の計算は、値下げの前からすでに芳しくない。そして値下げは、入力側だけを変える。
値下げはキャパシティの増加ではない。人間を依然として必要とするものを生成するコストが、どれだけ安くなったかという変化にすぎない。
露見する事実:あなたを止めていたのはコストではなかった
もしモデルコストが本当の制約だったなら、チームは動く中で最も安い構成を回していたはずだ。そうはなっていない。OpenAI自身の数字によれば、同社組織内の中央値の研究者はAPI価格で1日$600以上の推論を回しており、90パーセンタイルは1日$7,000に達する。同社が公表したベンチマーク表を見ると、チームはより低いスコアのために、タスクあたり11.1倍も高い構成を承知のうえで使っている。信頼できる結果は、二度確認しなければならない結果よりも価値があるからだ。
これが本当の制約の姿だ。人間は、単位あたりの人間の精査を減らせる出力に対して、何倍もの金額を払っている。そこで買われている希少資源は計算資源ではなく注意力であり、しかもそれは以前から高いプレミアム付きで買われていた。
つまり値下げは非対称に効く。生成する側を安くし、承認する側はまったく元のままに置き去りにする。
収束するファンアウトと、ボードに積み上がるファンアウト
安いモデルを、静かに高くつくものではなく本当に役立つものにするのは、この区別だ。そしてほとんどのチームがここを飛ばしてしまう。
収束する並列性がある。3つのエージェントが隔離されたworktreeで同じマイグレーションを試み、テストスイートとリーダーAgentが合格したものを選び、人間には1つの結果だけが届く。コストは3倍になったが、レビュー負荷は動かなかった。値下げが本当のスループットを買ってくれるのはここであり、新しい経済性に見合ってセットアップを変える価値があるのもここだ。
発散する並列性もある。10のエージェントが10の無関係なTaskを拾い、10のdiff、10の変更サマリー、10の承認判断を生み出す。コストは同じ10回分だ。レビュー負荷は、1人の注意力の単位の10倍になる。
| 収束するファンアウト | 発散するファンアウト | |
|---|---|---|
| 例 | 1つのマイグレーションを3回試行し、最良のものが採用される | 10のTask、10のAssignee、10のdiff |
| 安いモデルで得られるもの | 試行回数が増え、良いものが1つ出る確率が上がる | 完了したまま待機する作業が増える |
| 生み出されるレビュー項目 | 1 | 10 |
| 価格だけを根拠にスケールしても安全か | はい | いいえ |
安いモデルは、リトライに耐えられる範囲で、収束するファンアウトを広げるために使う。発散するファンアウトを、レビュアーの数を超えて広げるために使ってはならない。実行がどれほど手頃になってもだ。これが正直な意思決定のペアであり、その後半を無視すると、実際に金がかかる。
予算ではなく変えるべきもの
同時実行数の上限は、支出ではなくレビュアーを基準に設ける。そのルールはCrewが見える場所に書き留めておこう。人間の承認を待っているオープンなTaskの数は、シフト中のレビュアー数に、その1人が1シフトでこなすレビュー件数を掛けた数を超えてはならない。使うのはあなたの数字であって、私たちの数字ではない。上限に達したら、予算的には許されていてもエージェントは新しいTaskを取りに行かない。ここでは、書かれたルーティングルールのほうが好みより勝る。好みは、より安い価格の前で静かに負けてしまうからだ。
「人間待ち」を可視化された状態にする。完了した実行と、何かを尋ねるために止まった実行は、外から見ると同じに見える。そして記録がターミナルだけなら、どちらも見えない。実行、ブロッカー、結果、フォローアップの議論はTaskのタイムラインに戻ってくるべきだ。そうすればキューは、金曜日にふと感じるあの感覚ではなく、数えられるものになる。
値付けすべきはレビューであって、トークンではない。実行あたりのドルを報告するエージェント横断のコスト追跡は、もはや制約になっていない問いに答えている。ダッシュボードに載せる価値がある数字は、承認された変更あたりの人間の工数(分)だ。安いモデルに切り替えたあとでこの数字が増えたなら、その安いモデルのほうが高くついている。
節約分の一部はエビデンスに使う。型チェック、テスト結果、変更サマリー、既知の制限を添付する実行は、より多くのトークンを消費し、より少ない注意力で済む。Opus 5.5ではキャッシュ入力の読み取りが100万トークンあたり$0.20、GPT-6ではキャッシュ読み取りが90%オフなので、追加の検証パスはほぼ無料であり、本当に希少だった資源を取り戻してくれる。
これで今週はどうなるか
2つのラボが同じ日に試行1回の価格を引き下げ、そのうち1社は数時間後に置き換えられるモデルと比較してベンチマークを取っていた。どちらも、あなたの代わりにdiffを読んでくれるものは出荷していない。作業に対する人間のオーナーシップこそ、40%安くならなかった部分であり、何が本番に到達するかを決める部分だ。
すでに複数のコーディングエージェントを動かしているなら、今週やるべき有用な一手は、同時実行数の数字を上げることではない。自分のレビュー上限が実際いくつなのかを突き止め、それに合わせて同時実行数を設定することだ。Sharklyなら、実行、ブロッカー、結果、そして人間の承認を待つ作業のキューを、1か所で確認できる。


