
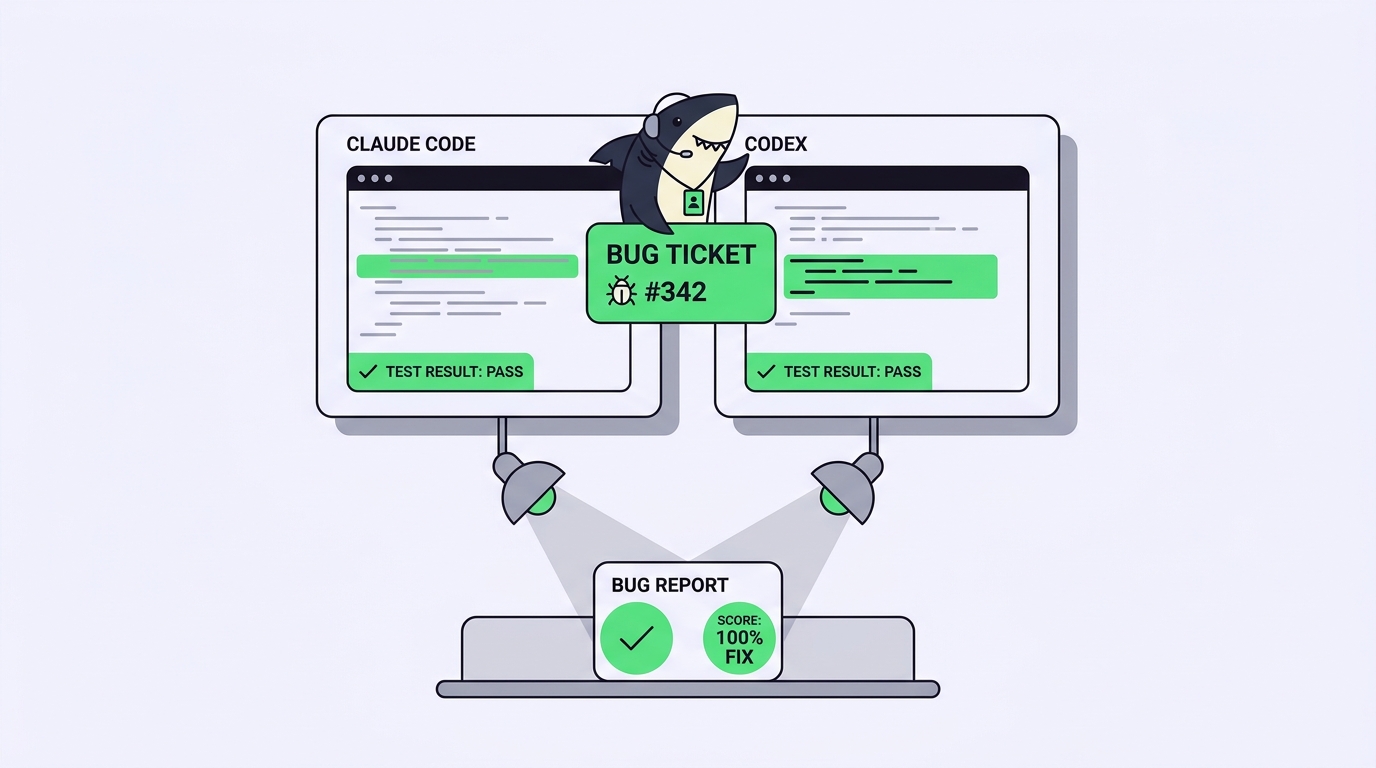
修正すべき本物のバグが1件あって、直せるエージェントが2つある。Claude CodeとCodexだ。タブはどちらが賢いかという意見で溢れているが、今日、このリポジトリのこのバグにどちらを向けるべきかは教えてくれない。公開ベンチマークの数値も同じだ。リーダーボードが測っているのは、調整済みハーネス上での固定されたオープンソース問題の集合にすぎない。あなたのバグはプライベートな問題だ。あなたの規約、あなたのフレーキーなテスト、1人しか理解していないモジュール。
「Claude CodeかCodexか」に誠実に答える方法は、同じバグを同じ条件で両方に実行させ、それぞれが返してくるものを読むことだ。簡単に聞こえるが、すぐにカオスになる。2つのエージェントが同じファイルを編集し、ターミナルが2つ、テスト出力も2つ、しかもそれらを並べて比較するきれいな方法がない。欲しいのはエージェント同士の比較なのに、目の前にある作業は両者を衝突させないことに変わってしまう。
その衝突を取り除くのがSharklyだ。SharklyはオールインワンのAgent指揮・管理プラットフォームだ。同じTaskを2つの異なるAgentに割り当てると、それぞれが接続されたComputer上の独立したworktreeで実行され、すべての実行がそのdiff、テスト結果、レビューを1か所に返す。SharklyはClaude CodeやCodexの代替ではなく、ベンチマークハーネスでもない。2つ目のターミナルを開かずに公平な真っ向勝負を可能にするレイヤーだ。このガイドでは、その手法、単一バグに対する採点ルーブリック、そしてどちらのエージェントがどこで勝ちやすいかを順に説明する。
まずは結論から
Claude CodeとCodexを公平に比較するには、両方に同一のバグ、同じ開始コミット、同じ受け入れテストを与え、それぞれを最良の設定で実行する。そして返ってきたものを採点する。修正は通るか、diffはスコープ内に収まっているか、その変更をレビューするのにどれだけ時間がかかるか。1つのバグで勝ったエージェントは、1つのバグで勝っただけだ。その判定を信じる前に、複数のバグでこの手法を回そう。
なぜ「どちらが優れているか」が間違った問いなのか
Claude CodeとCodexはどちらもターミナルファーストのコーディングエージェントだ。リポジトリを読み、ファイルを編集し、コマンドを実行し、結果を報告する。設定の仕方やプレッシャーのかかった状況での振る舞いには違いがあるが、通常のスプリントを埋めるような作業において、どちらかが普遍的に優れているわけではない。
単一のグローバルランキングは、あなたが気にしている部分を覆い隠してしまう。「どちらが優れているか」はすべてを1つの数値に押し込み、その数値はあなたのコードベースに触れた瞬間に通用しなくなる。「この種のバグにおいて、自分のリポジトリで、レビュー時にどちらが優れているか」なら答えを出せるし、努力に見合うのはこちらのバージョンだけだ。各エージェントにどのモデルを動かすかでまだ迷っているなら、モデルをエージェントの役割に合わせることのほうが、どんなリーダーボードよりも先に問うべき問いだ。
同じバグで両方を走らせる:信頼できる手法
公平な比較とは、エージェント以外のすべてを一定に保つことだ。それを実現する4つのルールがある。
- おもちゃのプロンプトではなく、実在するバグを1つ選ぶ。バックログから、実行できる受け入れテストがあり、数分で読めるdiffに収まる範囲の欠陥を選ぶ。トラッカーに書くように書き出す。たとえば
SH-312: fix the timezone drift in the invoice exportのようなタスクだ。「ToDoアプリを作る」では、あなたのコードについて何もわからない。 - 両方に同一の入力を与える。同じタスク記述、同じ開始コミット、同じ受け入れ基準。Claude CodeにCodexよりリッチなプロンプトを与えたら、測っているのはエージェントではなくあなたのプロンプトだ。
- それぞれを最高の状態で走らせる。Claude Codeには
CLAUDE.mdを、CodexにはAGENTS.mdと設定を与え、それぞれの公式ドキュメントが推奨する権限とモデルを与える。しっかり設定したエージェントと素のエージェントを比べるのは、どちらを設定する気になったかを測っているにすぎない。 - 2つの実行を分離する。各エージェントには専用の作業コピーが必要だ。1つのチェックアウトで2つのエージェントを動かせば互いを上書きし合い、2つのきれいな試行を読む代わりに、午後をマージの解消に費やすことになる。これが分離されたworktreeの目的だ。
2つの試行を走らせ、負けたブランチは捨てる。信頼できる修正と、そう判断した根拠が手元に残る。
単一のバグ修正のための採点ルーブリック
「テストが通ったか」は1ビットの情報にすぎない。実際の修正はそれだけで決まるものではないし、見る前にルーブリックを書き出しておけば比較が誠実に保たれる。
| 採点項目 | それが答える問い | なぜ重要か |
|---|---|---|
| 正しさ | 受け入れテストは通るか、他に壊れたものはないか | 最低ライン。「done」と表示するだけのエージェントは、何も合格していない。 |
| スコープの規律 | diffはバグに必要な箇所だけに触れているか | 無関係なファイルを4つも書き換える修正は、節約できる以上のレビューコストを生む。 |
| テストの質 | そのリグレッションを捕まえるテストを追加・更新したか | テストのない修正は、また同じ修正をすることになる。 |
| レビュー時間 | その変更を信頼できるようになるまでどれだけかかったか | 多くの場合これが本当のボトルネックで、自分の午後が溶けるまで無視されやすい。 |
| 誠実さ | エージェントは自身の限界や前提を申告したか | 信頼できる実行とは、検証していないことを教えてくれる実行だ。 |
同じバグで、同じ5項目で両方の試行を採点すれば、勝者は好みの問題ではなくなる。レビュー時間には特に重みを置くべきだ。2つのエージェントがどちらも20分で終わっても、それぞれ確認に1時間かかることがある。その1時間こそ、チームが吸収できるエージェント作業量の本当の限界であることが多い。
それぞれが勝ちやすい領域
ここに捏造した数字はない。ただ、注目すべきポイントを挙げる。Claude CodeはCLAUDE.mdによるプロジェクトメモリを頼りにし、複数ファイルにまたがる変更でリポジトリの規約内にとどまる傾向があり、これは複数モジュールにまたがるリファクタリングで効いてくる。Codexはサンドボックス化された設定駆動の環境を得意とし、新しいコードとそのテストをきれいに組み立てることが多く、これは範囲の限定された修正で効いてくる。リポジトリが大きくなるほどどちらも迷走しがちで、どちらも通らない変更を自信満々に差し出してくる。これらを確定事項として扱う前に、自分のバグで実行してみよう。
ここが、多くの比較が飛ばしてしまう正直な部分だ。エージェントを1つだけ使い、1つのターミナルで暮らしているなら、これを実行するのにプラットフォームは要らない。1つのworktreeで丁寧に調整したClaude Codeのセッション、あるいは1回のCodex実行で十分で、diffは自分で目視できる。状況が変わるのは、2つのエージェントを1つ以上のバグで比較し、その結果を他人が読める形で欲しいと思った瞬間だ。
Sharklyで真っ向勝負を実行する
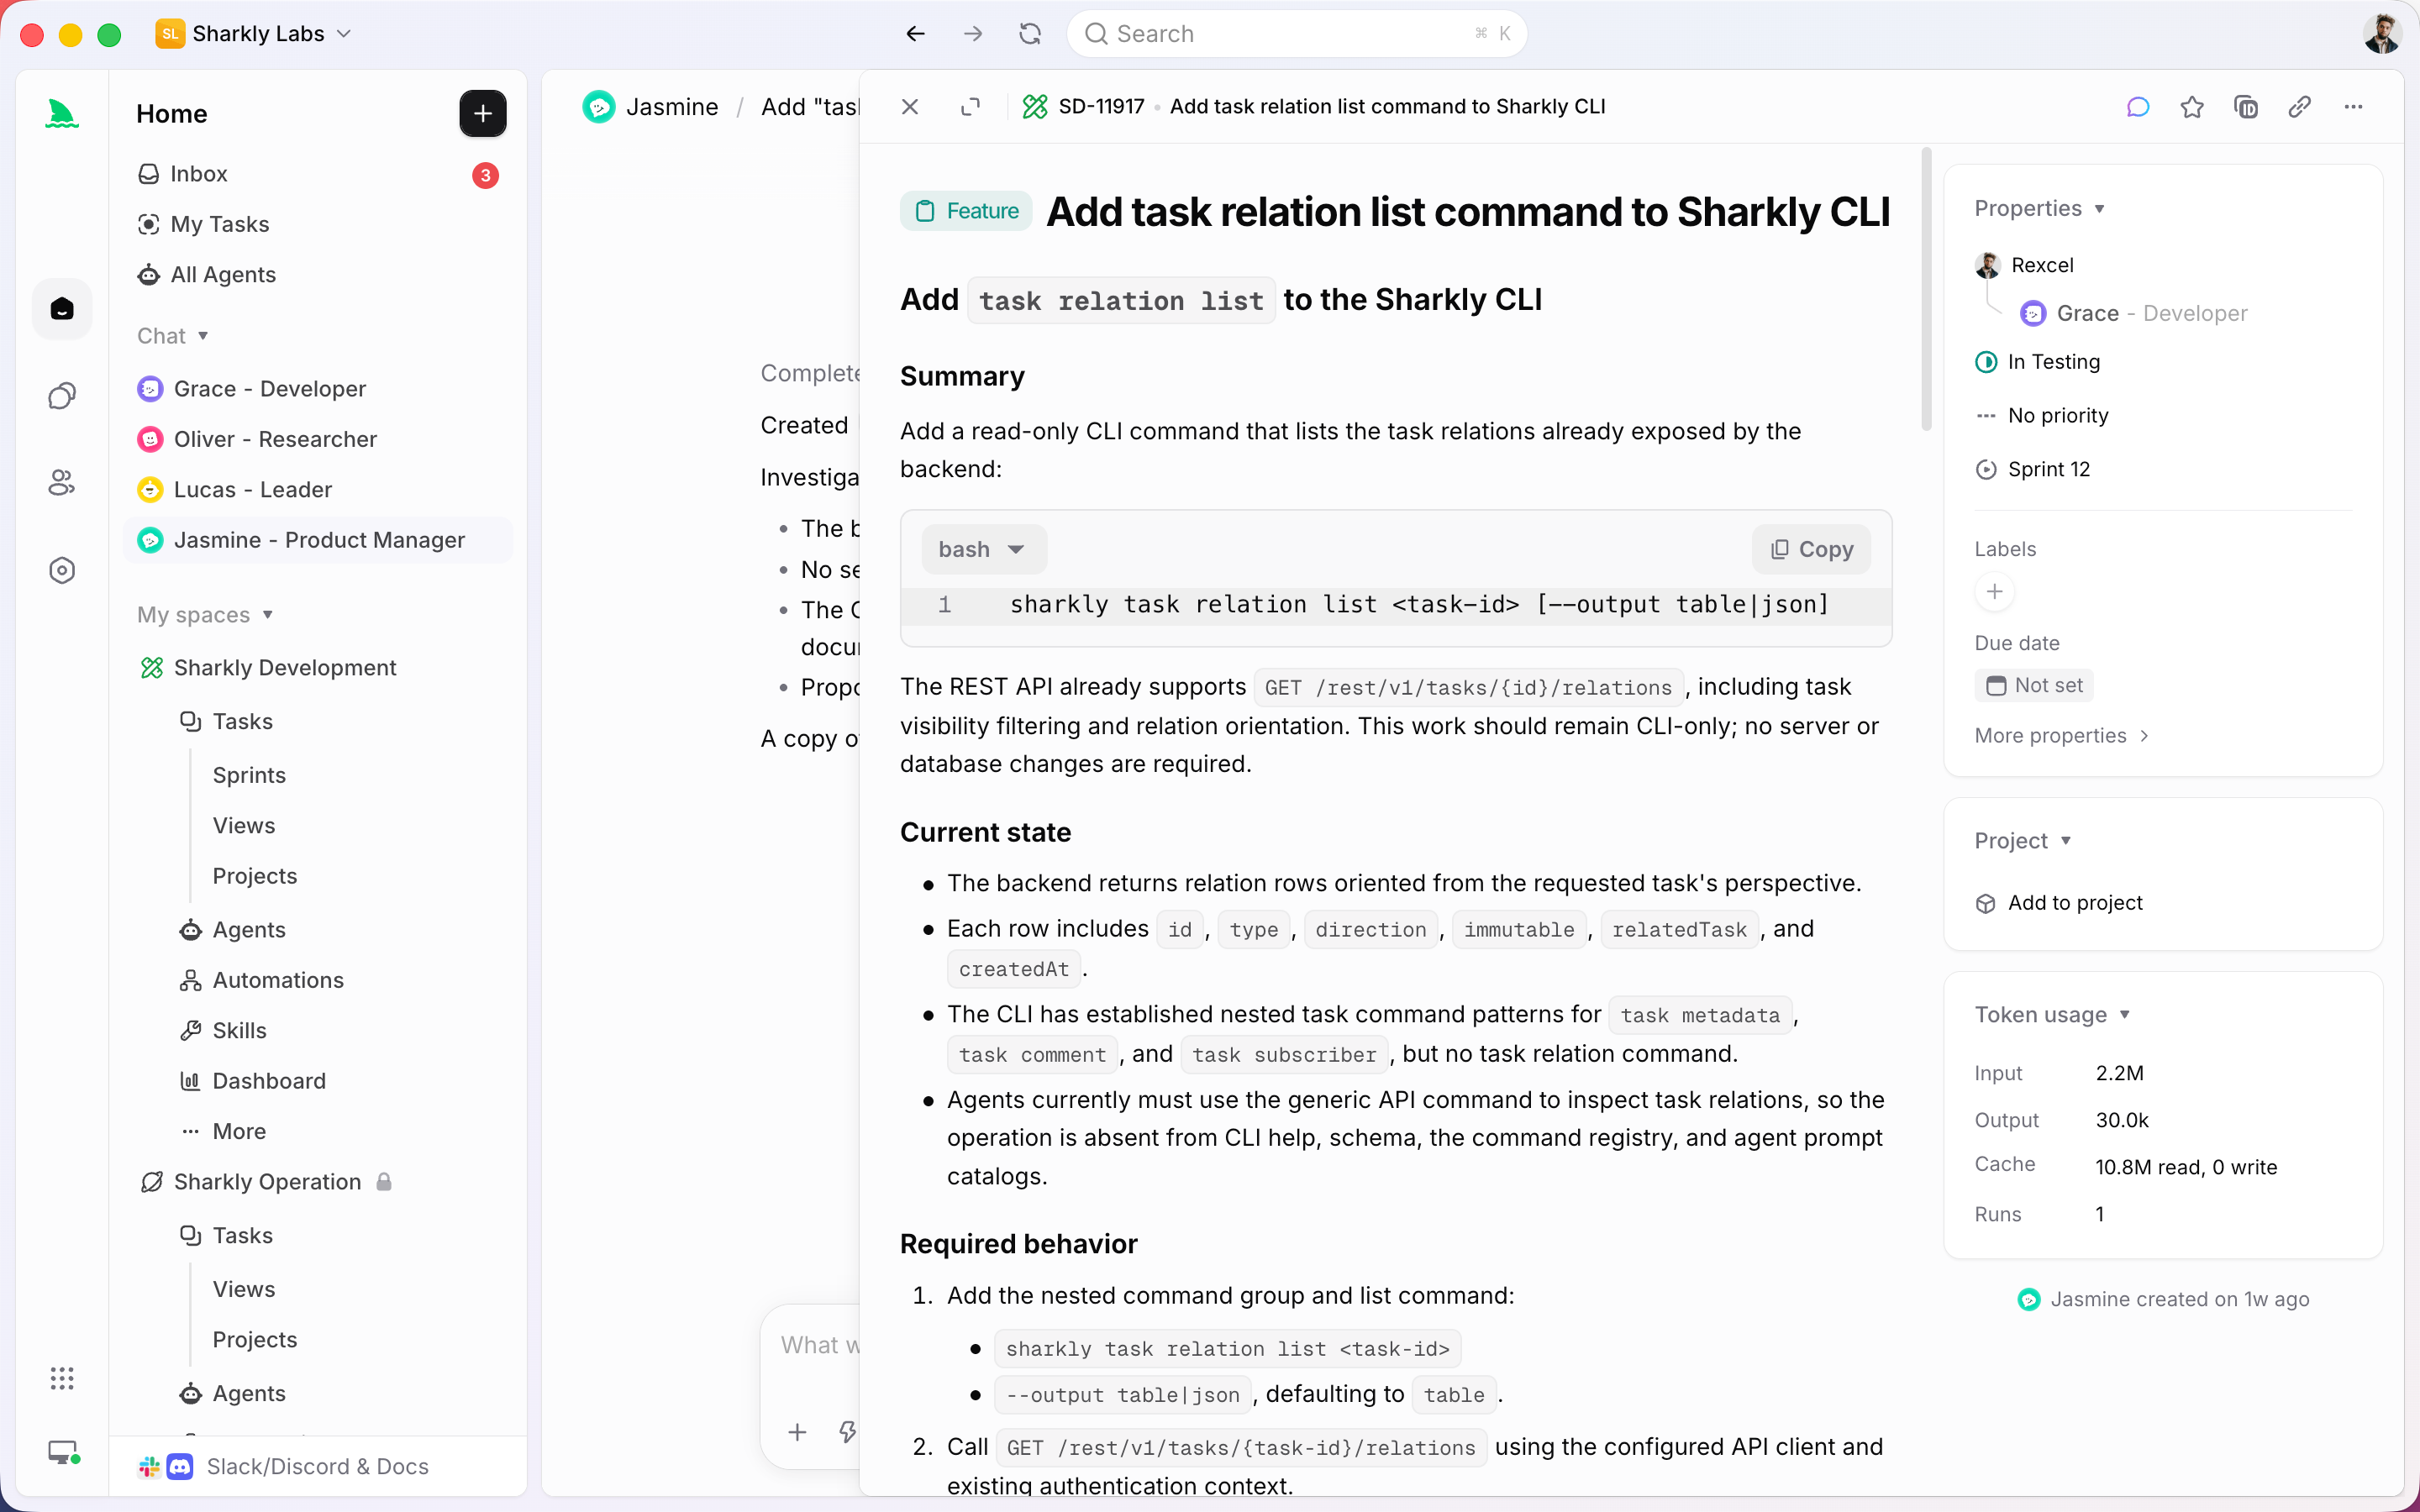
ここでSharklyの出番だ。バグに対して1つのTaskを作成し、それをClaude Code AgentとCodex Agentの両方に割り当てる。各Agentは接続されたComputer上のそれぞれのworktreeで実行されるので、2つの試行が同じファイルに触れることはない。実行、ブロッカー、結果、変更サマリーはTaskのタイムラインに返り、2つのdiffと2つのテスト実行を、どのターミナルがどちらだったかを思い出さずに1つのビューで見比べられる。
役割分担は明確なままだ。Agentは調査し、実行し、テストし、報告する。人は方向性を定め、結果を受け入れる。自動化はあなたの判断が必要なところで止まり、Sharklyはコンテキスト、進捗、ブロッカー、結果、人間のレビューをリクエストからリリースまで見える状態に保つ。意思決定をツールに丸投げするのではなく、両方の試行が並べられ、数分で判断できるようになるだけだ。一度きりのテストではなく、日常業務で両方のエージェントを使い続けたいなら、1つのコードベースでClaude CodeとCodexを一緒に動かすのが、同じワークフローを日常化したものだ。
チーム規模別にどちらを選ぶか
どちらが正しいかは、誰が選ぶのか、そしてその比較が何に耐えなければならないかで決まる。
| チーム規模 | 最も重視すべき点 | 選ぶべきもの |
|---|---|---|
| 個人開発者 | レビュー時間と自分のマシンでの実行 | 自分がより速くレビューできる方。読むのは自分だけだ |
| 小規模チーム | 並列実行と共有された可視性 | 両方。1つのTaskで割り当て、全員が同じ証拠を見られるようにする |
| プラットフォームチーム | 統合とプロバイダー中立性 | 両方を維持する。次の四半期にどのエージェントが首位になってもワークフローが生き残る必要がある |
最後の行こそが、お気に入りを選んで擁護するのではなく、比較を実行すべき本当の理由だ。今四半期の最良のエージェントが、次の四半期も最良とは限らないし、首位が変わるたびにプロセスを組み直すのはそれ自体が税金だ。自分のバグで、どんなエージェントでも動くワークフローの中で比較していれば、答えが変わったときに自由に乗り換えられる。
1つのエコシステムにコミットするのではなく、複数のコーディングエージェントを使い続けたいなら、それはまさにSharklyが設計された問題だ。Sharklyをダウンロードし、1台のComputerを接続し、同じ実在のバグを両方のエージェントに割り当ててみよう。返ってくる判定はあなたのコードベースに関するもので、あなたの1週間を予測できるのはそれだけだ。
FAQ
バグ修正においてClaude CodeとCodexはどちらが優れていますか?一般的に勝者は決まらない。同じバグで、それぞれ最良の設定にした場合、たいていはどちらかがわずかに勝り、どちらが勝つかはバグの種類とリポジトリの規模によって入れ替わる。バックログにある実在の欠陥で両方を実行し、正しさ、スコープ、テスト、レビュー時間を採点しよう。
Claude CodeとCodexを同じバグで同時に実行できますか?それぞれに専用の作業コピーがあれば可能だ。1つのチェックアウトに2つのエージェントを置くと互いを上書きする。それぞれに分離されたworktreeを与えるか、SharklyでTaskを両方に割り当て、各AgentをそれぞれのComputerで実行させよう。
ベンチマークのスコアは、どのエージェントを使うべきか教えてくれますか?それはどのエージェントをテストする価値があるかを教えてくれるだけで、あなたのリポジトリでどう振る舞うかではない。公開データセットに社内ライブラリ、lint設定、テストされていないモジュールが含まれることは決してない。リーダーボードはフィルターとして扱い、自分のコードで意味のある比較を実行しよう。
SharklyはClaude CodeやCodexを置き換えますか?いいえ。Sharklyは、チームがすでに動かしているコーディングエージェントの周りにある、割り当て・コンテキスト・レビューのレイヤーだ。実行するのはエージェントで、SharklyはTaskを管理し、実行を見える状態に保ち、受け入れの判断は人に委ねる。
決断する前に何個のバグを比較すべきですか?1つのバグは1つのバグについてしか教えてくれない。パターンを信じる前に、いくつかの欠陥タイプにわたってこの手法を回し、毎回ルーブリックを同一に保って結果を積み上げていこう。


