
要点:Anthropicの標準APIにおけるClaude Fable 5.2の料金は、入力トークン100万あたり8ドル、出力トークン100万あたり40ドルです。Fast modeはそれぞれ16ドル、80ドルとなります。ワークフロー全体の予算を組む際は、コンテキストの重複送信、思考(thinking)プロセス、リトライ、オーケストレーションを行うエージェント、ツール実行、そして人間のレビューまで含めて見積もる必要があります(料金は2026年11月10日時点)。
トークン単価で把握できるのは、あくまで1回のモデル呼び出しにかかるコストにすぎません。エンジニアリング予算で本当に把握すべきなのは、「最終的に承認された成果物1件あたりのコスト」です。例えば、移行作業で3回のリトライが発生し、別のエージェントによるレビューを経て、最終的に人間が修正を加えたとすれば、1つの成果物に対して複数の請求項目が積み重なることになります。
複数のコーディングエージェントを運用する場合、Sharklyを使えばエージェントのタスクと成果物を一元管理できます。まずは「何をもって完了(完了の定義)とするか」を明確にすることからコスト分析を始めましょう。モデルの比較はその次です。
Claude Fable 5.2の料金体系
Anthropicは入力トークンと出力トークンを別々に課金し、キャッシュ、バッチ処理、Fast modeそれぞれに個別の料金体系を設定しています。「1 MTok」は100万トークンを指します。以下の米ドル建て料金は、2026年11月10日確認時点の公式料金ドキュメントに基づいています。これらは月額固定制のコーディング用サブスクリプションではなく、API利用料金を示したものです。
| 請求カテゴリ | 入力(1 MTokあたり) | 出力(1 MTokあたり) |
|---|---|---|
| 標準API | $8 | $40 |
| Fast mode | $16 | $80 |
| Batch API | $4 | $20 |
| 標準キャッシュ書き込み(5分) | $10 | 該当なし |
| 標準キャッシュ書き込み(1時間) | $16 | 該当なし |
| 標準キャッシュヒット | $0.20 | 該当なし |
キャッシュの書き込みやヒットは入力トークンに対する料金カテゴリであり、出力に対する割引ではありません。Fast modeでのキャッシュ料金は、Fast modeの入力単価にキャッシュの倍率を適用して算出されます。バッチ処理(Batch API)では入力・出力ともに50%割引されますが、Fast modeとバッチ処理を併用することはできません。
Fableは最大100万トークンのフルコンテキストウィンドウを標準のトークン単価で提供しています。ただし、巨大なコンテキストを扱うとコストはかさみます。キャッシュされていない入力は呼び出しごとに累積していくためです。なお、パートナー企業が運営するクラウドプラットフォームでは価格設定が異なる場合があるため、チームへの請求元となるエンドポイントを必ず確認してください。
ワークフロー全体の予算をどう計算すべきか?
キャッシュを利用しない標準APIの呼び出しでは、入力トークン数に100万あたり8ドル、出力トークン数に100万あたり40ドルを掛け、それらを合算します。この計算を、各試行におけるすべての呼び出しに対して繰り返します。さらに、ツールやインフラの利用料金、そして人間のレビュー時間を加算することで、成果物納品までにかかる総コストを正確に見積もることができます。
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
ここでいう「出力」とは、必要に応じて生成される思考(thinking)トークンも含めた、請求対象となる総出力トークン数を指します。プロバイダーが報告するトークン消費量を、画面に表示された最終回答の長さだけで判断してはいけません。
例えば、上記と同じトークン消費量で20件のタスクを実行したと仮定しましょう。そのうち5件のタスクで、全く同じ条件でのリトライが1回ずつ発生したとします。さらに、オーケストレーション役のエージェントの総コストが2ドルかかり、1人のレビュアーが時給80ドルの社内コスト換算で15分間レビューを行ったと想定します。
| 想定コスト項目 | 計算内訳 | 費用 |
|---|---|---|
| 初回試行(20件) | 20 × $1.60 | $32 |
| 追加試行(リトライ5件) | 5 × $1.60 | $8 |
| コーディネーターエージェント | 想定モデル利用合計額 | $2 |
| 人間のレビュー | 0.25時間 × $80 | $20 |
| 合計 | ツール代、インフラ費、税別 | $62 |
20件すべてのタスクが承認された場合、この例での承認済みタスク1件あたりのコストは3.10ドルとなります。しかし、承認されたのが16件にとどまった場合、同じ62ドルの総費用でも承認済みタスク1件あたりは約3.88ドルに跳ね上がります。分母をどう置くかによって、意思決定は大きく左右されます。
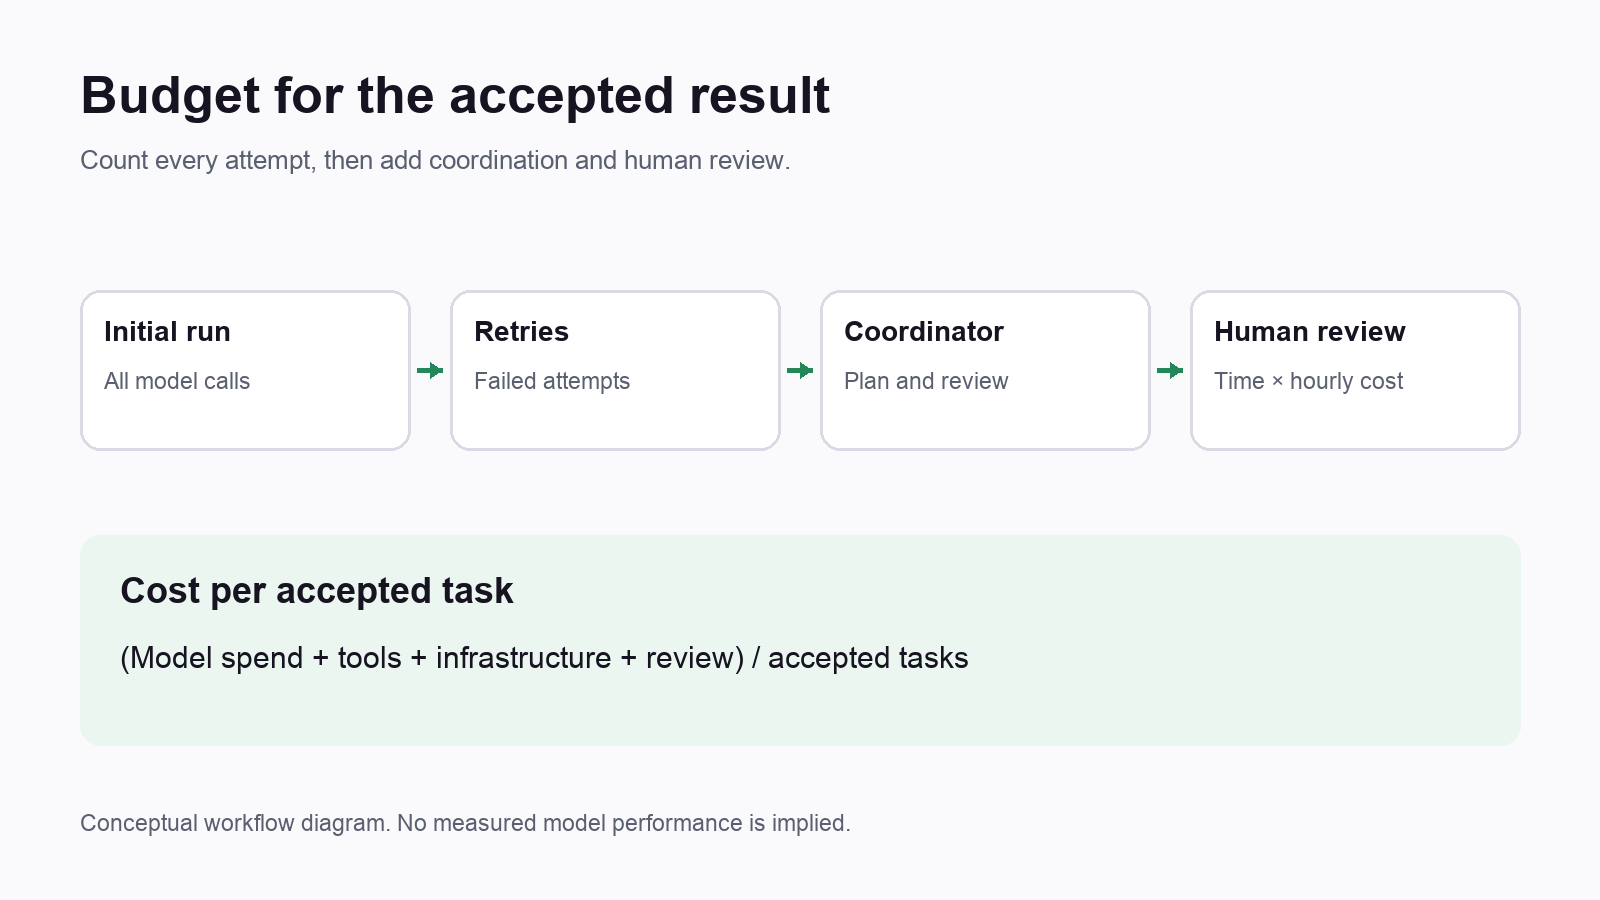
これらは試算用の前提条件であり、実際のFableの実測パフォーマンスではありません。自社のトークン消費量、リトライ回数、受入結果、レビュー時間に数値を置き換えて計算してください。承認された変更単位でエージェント運用のコストを評価する方法を解説したガイドでは、なぜこの比較指標が重要なのかを詳しく掘り下げています。
Fast modeとEffort設定が影響を与える異なるコスト要因
Fast modeは、生成時間を短縮するためにトークン単価が引き上げられます。一方、Effort(推論の度合い)設定は、思考プロセスやツール呼び出しを含め、モデルがどれだけ作業を行うかを制御します。これらはまったく別のコントロールとして捉える必要があります。生成速度が向上したからといってエンドツーエンドのワークフロー全体が短縮されるとは限りませんし、Effort設定を下げたからといって利用料金の上限が固定されるわけでもありません。
Anthropicのローンチ告知では、Fast modeによりトークン生成速度が最大2.5倍高速化されると説明されています。しかし、これはあくまでトークン生成に関するプロバイダー側の公表値であり、ビルド、テスト、ネットワーク呼び出し、人間のレビューまでもが2.5倍速く終わることを保証するものではありません。
消費トークン数が全く同じであっても、先ほどの1.60ドルの例はFast modeでは3.20ドルになります。待ち時間を削減する価値が割増料金を上回る場合にのみ、Fast modeを採用するとよいでしょう。生成レイテンシが全体の納期のボトルネックにならないバックグラウンド処理や無人ワークフローでは、標準モードを使用するのが賢明です。
Effortの公式ドキュメントによると、Fable 5.2ではLow、Medium、High、Xhigh、Maxの各設定が用意されています。APIでのデフォルト値はHighですが、ローンチ告知ではClaudeアプリやClaude CodeのデフォルトはMediumであると明記されています。比較検討を行う際は、対象のプロダクトと明示的な設定値を必ず記録しておきましょう。
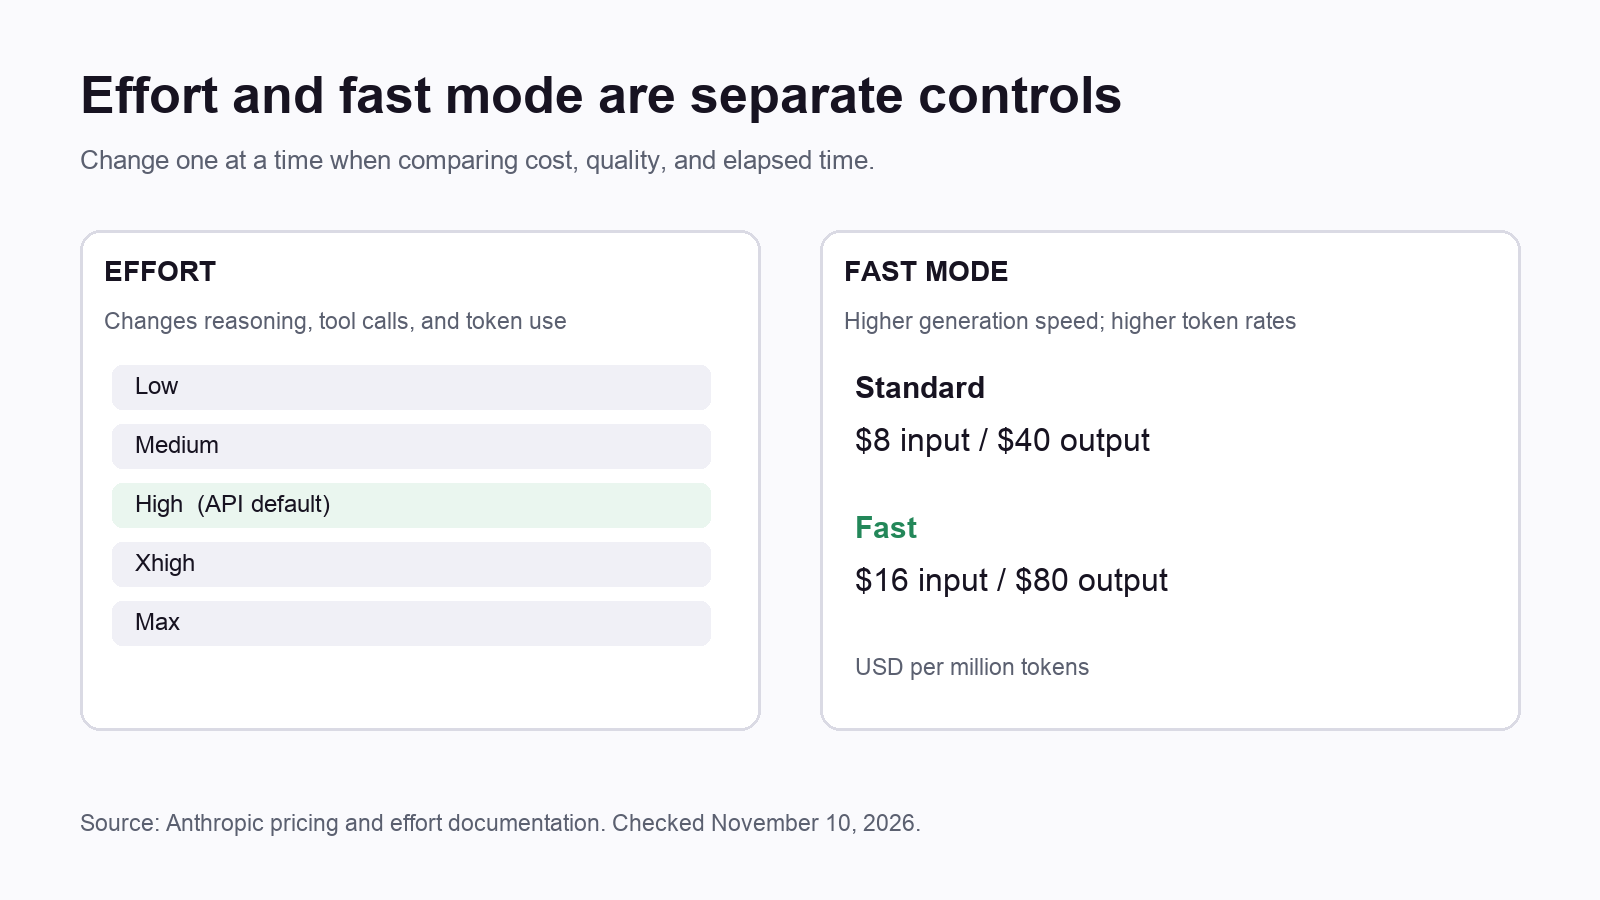
Anthropicは、APIワークロードをまずはHighで開始し、評価テストで品質が維持できるタスクではEffortを下げ、難易度の高いタスクで明確な改善が見られる場合はXhighへ引き上げる運用を推奨しています。Maxはトークンコストを度外視して能力を最優先する設定です。Effortはモデルの振る舞いを調整するシグナルに過ぎないため、実際の利用制限や支出上限はアプリケーションおよび運用プロセス側で制御する必要があります。
重複コンテキスト、リトライ、オーケストレーションを制御する
エージェントの数を増やす前に、次の6つの制御策を講じてください。
- すべての試行を測定する:失敗した試行や中断した試行の費用も、同一タスクの総コストに含めて計上します。
- 不変のコンテキストをキャッシュする:プロンプトキャッシュの対象となるワークロードでは、リポジトリの指示書や変更のないドキュメントを再利用します。
- リトライ回数に上限を設ける:再試行の上限を明確に定め、高コストな再試行を実行する前に原因分析を義務付けます。
- 難易度に応じてルーティングする:単なる抽出やフォーマット変換のステップまでFableに任せるのではなく、高度な推論が必要な未解決課題のみをエスカレーションします。
- オーケストレーションのコストも予算化する:ワーカーエージェントの呼び出しだけでなく、計画策定、タスク割り振りのディスパッチ、要約、レビュアーエージェントの呼び出しもカウントします。
- レビュー待ちタスクの流入量を制限する:人間のレビュアーが無理なく審査できる変更量に合わせて、完了タスクの受け入れペースを調整します。
ツールの定義やツールの実行結果は、モデルへの入力トークンを増加させます。また、Anthropicの料金ガイドにある通り、一部のサーバーサイドツールには別途料金が発生します。コマンド実行自体は低コストであっても、膨大なログを出力するコマンドは、その後の呼び出しにおけるコンテキスト費用を大きく膨らませる原因になります。
キャッシュの効果も検証が必要です。例えば10万トークンのプレフィックスがある場合、標準の5分間キャッシュ書き込みには1ドルかかります。その後のキャッシュヒットは0.02ドルで済み、キャッシュなしの入力(0.80ドル)と比べれば安価です。ただし、これらの数値には新規の入力トークンや出力トークンは含まれていません。コスト削減を見込む前に、実際のキャッシュヒット率と利用状況を必ず測定してください。
再現性の高いルーティングポリシーを設計するには、モデル概要を参考にしてください。AnthropicはほとんどのワークロードにOpus 5.5を、高度な推論や長期的な展望を要する作業にはFableを推奨しています。これは評価の出発点となる方針であって、自社のリポジトリにおいて特定のモデルが常に最適であることを保証するものではありません。
パイロット運用では何を測定すべきか?
異なる構成間を比較する際は、タスクのスコープと受入テストを同一に保ちます。所要時間を記録する際は、キュー待ち時間、モデルの生成時間、ツールの実行時間、人間のレビュー時間を分けて集計してください。そうしなければ、テストスイートの実行速度が遅いせいで生成高速化のメリットが見えなくなったり、簡単なタスクばかりが集まったことで高コストな設定が割安に見えたりしてしまいます。
キャッシュされた入力とキャッシュされていない入力は分けて記録しましょう。また、ファイルサイズからトークン数を推測するのではなく、各試行においてプロバイダーから返された実際の利用実績データを保存してください。Effort設定を変更した際は、初回レスポンスだけでなく、最終的な受入結果や手戻り工数も含めて比較します。初回実行時間が短くても、後から多大な修正コストが発生することがあるためです。
パイロット運用を開始する前に、試行回数の上限、利用額のしきい値、レビューのチェックポイントといった「停止条件」をあらかじめ設定してください。調査を延々と続けるモデルは、まだ承認できる段階にない進捗のまま予算を使い果たしてしまうおそれがあります。
予算を成果物に紐づけて管理する
Sharklyの公式製品説明にある通り、同プラットフォームはTasks、コーディングエージェント、接続されたComputers、そして人間のレビューを単一のワークスペースに統合します。APIアカウントやコーディング用サブスクリプションは各ツール側で設定したものをそのまま利用し、モデルの利用料金は各プロバイダーのアカウント側で直接管理されます。
この一元化された作業履歴を活用し、使用モデル、Effort設定、試行回数、エビデンス、レビュー結果を記録・レポートします。例えば移行作業であれば、コードの変更内容とともにテスト結果や既知の制限事項を提出するようAgentに指示します。人間はそれらを確認した上で成果物を承認するか、修正を依頼します。実践的なレビュー体制の構築方法については、タスクレベルのエビデンスを活用してAI生成コードをレビューする方法をご覧ください。
小規模なバグ修正であれば、1つのAgentを割り当てるだけで十分です。それぞれ異なる専門性や協調動作が必要なタスクにはCrew(チーム編成)を活用します。エージェントを増やすとAPI呼び出し回数やハンドオフ(作業の引き継ぎ)が増えるため、並列処理を標準運用にする前に必ず成果を測定してください。異種モデル混成Crew活用ガイドでは、こうした引き継ぎプロセスの詳細を解説しています。
まずは代表的な10個のタスクから始めましょう。構成ごとに総費用、経過時間、受入率、レビュアーの対応時間を記録します。SharklyでComputerを1台接続し、スコープを限定したTaskを1件割り当て、納品時にエビデンスを添付するよう指示してみてください。「承認された成果物1件あたりのコスト」を明確に説明できるようになってから、本格的な展開を進めましょう。
よくある質問(FAQ)
Claude Fable 5.2のFast modeは料金が2倍になりますか?
公表されている入力および出力のトークン単価は標準料金の2倍です。ただし、ワークフロー全体の総コストは、実際のトークン数、キャッシュ利用、ツール呼び出し、リトライ回数によっても変動します。
EffortをMediumに設定するとトークン単価は変わりますか?
Effortはモデルの振る舞いやトークン消費量を変化させるものであり、公表されている入力・出力トークン単価そのものがEffort別の料金体系に置き換わるわけではありません。
サブスクリプションの予算とAPIの予算は同じですか?
いいえ、異なります。本記事では従量課金制のAPI利用料を試算しています。連携しているコーディング用サブスクリプションの利用規約や上限枠については、別途ご確認ください。
バッチ処理を利用すれば請求額を抑えられますか?
Batch APIを利用すると、Fableのトークン単価は100万トークンあたり入力4ドル、出力20ドルになります。完了を急ぐ必要のないワークフローには非同期のバッチ処理を活用できますが、Fast modeとBatch APIは併用できません。
1回の呼び出しコストが低ければ、最終的な納品コストも安くなりますか?
リトライ、受入率、オーケストレーション、レビューを経てもそのコスト面での優位性が保たれる場合に限られます。同一の受入基準のもとで、承認されたタスク件数に対する総支出額を比較することが重要です。
関連リソース
ワークフロー設計に関する詳細は、コーディングエージェントのコスト管理および並列エージェント運用における人間のレビューキャパシティ設計をご覧ください。新たな予算計画にこれらの料金を適用する際は、リンク先のAnthropic公式の料金およびEffortドキュメントを必ず再確認してください。


