

GPT-6.2 Astra vs Fable 5.2は、見出しから受ける印象よりも僅差だ。どちらも入力100万トークンあたり$8、出力100万トークンあたり$40で提供されている。AnthropicはFable 5.2のエージェント型コーディングスコアを公開しているが、OpenAIはAstraのコーディングベンチマークを公開していない。キャッシュ料金、長文コンテキストの割増料金、そしてチーム独自の「受け入れられた変更率」が勝敗を決める。
OpenAIは2026年11月17日にGPT-6.2 Astraをリリースした。AnthropicがClaude Fable 5.2をリリースしてから8日後のことだ。どちらも長時間で難易度の高いエージェント作業を狙ったフロンティアモデルであり、コーディングエージェントを運用しているなら、同じ定価で2つのフラッグシップモデルを選べる状況になった。
リーダーボードでは答えは出ない。決め手になるのは皆さんの依存関係、テストスイート、そしてレビュアーだ。本記事では公開されている数値を比較し、請求額の差が生まれるポイントを明らかにしたうえで、自社リポジトリで実行できる一騎打ちのテスト方法を紹介する。すでにCodexとClaude Codeを併用しているなら、Sharklyで両方に同じタスクを割り当て、結果をまとめて管理できる。
GPT-6.2 Astra vs Fable 5.2:スペックを横並びで比較
GPT-6.2 AstraはGPT-6.2ファミリーのOpenAIフロンティアモデルで、GPT-6.2 Solは日常使い向けの低価格な兄弟モデルだ。Claude Fable 5.2はAnthropicの一般提供モデルの最上位で、Mythos 5.2は限定アクセス版として保留されている。以下は、2026年11月20日時点で各ベンダーが公開している情報だ。
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| リリース日 | 2026年11月17日 | 2026年11月9日 |
| APIモデルID | gpt-6.2-astra |
claude-fable-5-2 |
| 入力(100万トークンあたり) | $8 | $8 |
| 出力(100万トークンあたり) | $40 | $40 |
| キャッシュ入力(キャッシュヒット時) | $0.40 | $0.20 |
| キャッシュ書き込み | $10(30分) | $10(5分)、$16(1時間) |
| バッチ | 標準の50% | $4入力、$20出力 |
| 高速モード | 標準の2倍 | $16入力、$80出力 |
| コンテキストウィンドウ | 1,050,000トークン(最大入力922,000) | 標準料金で100万トークン |
| 最大出力 | 128,000トークン | 128,000トークン |
| 長文入力割増 | 入力272K超:入力・キャッシュ料率が2倍、出力は1.5倍 | 記載なし |
| 通常のコーディングエージェント | Codex | Claude Code |
出典:OpenAIのGPT-6.2 Astraモデルページ、Anthropicの料金ドキュメントおよびモデル概要。
エージェントにとって特に重要なのは2行だ。コーディングエージェントは毎ターン同じコンテキストを再送するため、請求額の大部分はキャッシュヒット時の料金で決まる。さらに、大規模リポジトリを読み込んだエージェントは入力272Kトークンを超えることがあり、その閾値でAstraの料率が変わる。
コーディングベンチマークが語ること、語らないこと
AnthropicのFable 5.2発表によれば、XhighエフォートでFrontierSWE v2は69.9%、FrontierCode 2.0は49.1%を記録している。同じ表のOpenAI比較欄は前世代のGPT-6 Astraと表記され、65.5%と42.8%となっている。
この表にGPT-6.2 Astraは含まれていない。OpenAIのモデルページにもSWE系のコーディングスコアは掲載されていない。Simon Willison氏のリリース記事は、「Astra 6.2は各種ベンチマークでFable 5.2ほど高いスコアを出していない」と述べ、また一部ユーザーがAstraのコミュニケーションスタイルを「紛らわしいと感じる」ことも指摘している。
つまり誠実に読み解くと、次の3点に集約される:
- Fable 5.2にはベンダーが実施したエージェント型コーディングスコアが公開されており、前世代のAstraを上回っている。
- GPT-6.2 Astraとの直接的なコーディング比較は、どのベンダーも公開していない。
- 上記の数値はすべて、各モデルのベンダー自身が独自のハーネスを用い、任意に選んだエフォートレベルで計測したものだ。
ベンチマークはあくまで候補を絞り込むためのフィルターとして扱うべきだ。本記事には、どちらのモデルについても独立系の検証結果は含まれていない。
請求額が変わるポイント
定価が同じでも請求額が同じになるとは限らない。差が生まれる仕組みは3つある。
キャッシュヒット
Fable 5.2はキャッシュヒット時に100万トークンあたり$0.20、Astraは$0.40だ。100,000トークンのキャッシュ済みプレフィックスを1セッションで50回再送するエージェントの場合、このプレフィックスのコストは新しい入力と出力を除いてFableなら$1.00、Astraなら$2.00になる。Simon Willison氏はそれでもAstraのキャッシュ料金を「長時間のエージェントセッションにとって朗報」と評している。キャッシュなしの$8と比べればはるかに安い。
長文コンテキスト
Astraはリクエストの入力が272Kトークンを超えると料率が引き上がる。Fableは100万トークンのコンテキスト全体が標準料金で提供される。エージェントが日常的にモノレポの半分を読み込むなら、契約前にこの閾値を織り込んだコスト試算をしておくべきだ。
エフォートとタスクあたりのトークン数
両モデルともエフォートレベルを指定でき、エフォートを上げるほど消費トークンが増える。Simon氏の非公式SVGテストは、1つのプロンプトでどれだけ差が出るかを示している。GPT-6.2 AstraはHighエフォートで11.55セント、Maxで88.71セントだった。これはおもちゃのプロンプトであってコーディングベンチマークではないが、7倍の差は、コストを比較する前にエフォートレベルを固定すべき理由を物語っている。
当社のFable 5.2料金の内訳ではリトライとレビュー時間まで含めて試算しており、GPT-6.2レート制限ガイドではAstraのエージェントが最初にぶつかる毎分トークン上限を解説している。
自社リポジトリでGPT-6.2 Astra vs Fable 5.2を比較する方法
自社コードでの一騎打ちは、どんな公開表よりも信頼できる。以下の方法は当社のより詳細なFable 5.2を自社コードベースで評価するガイドに沿いつつ、2モデル対決として実行するものだ。
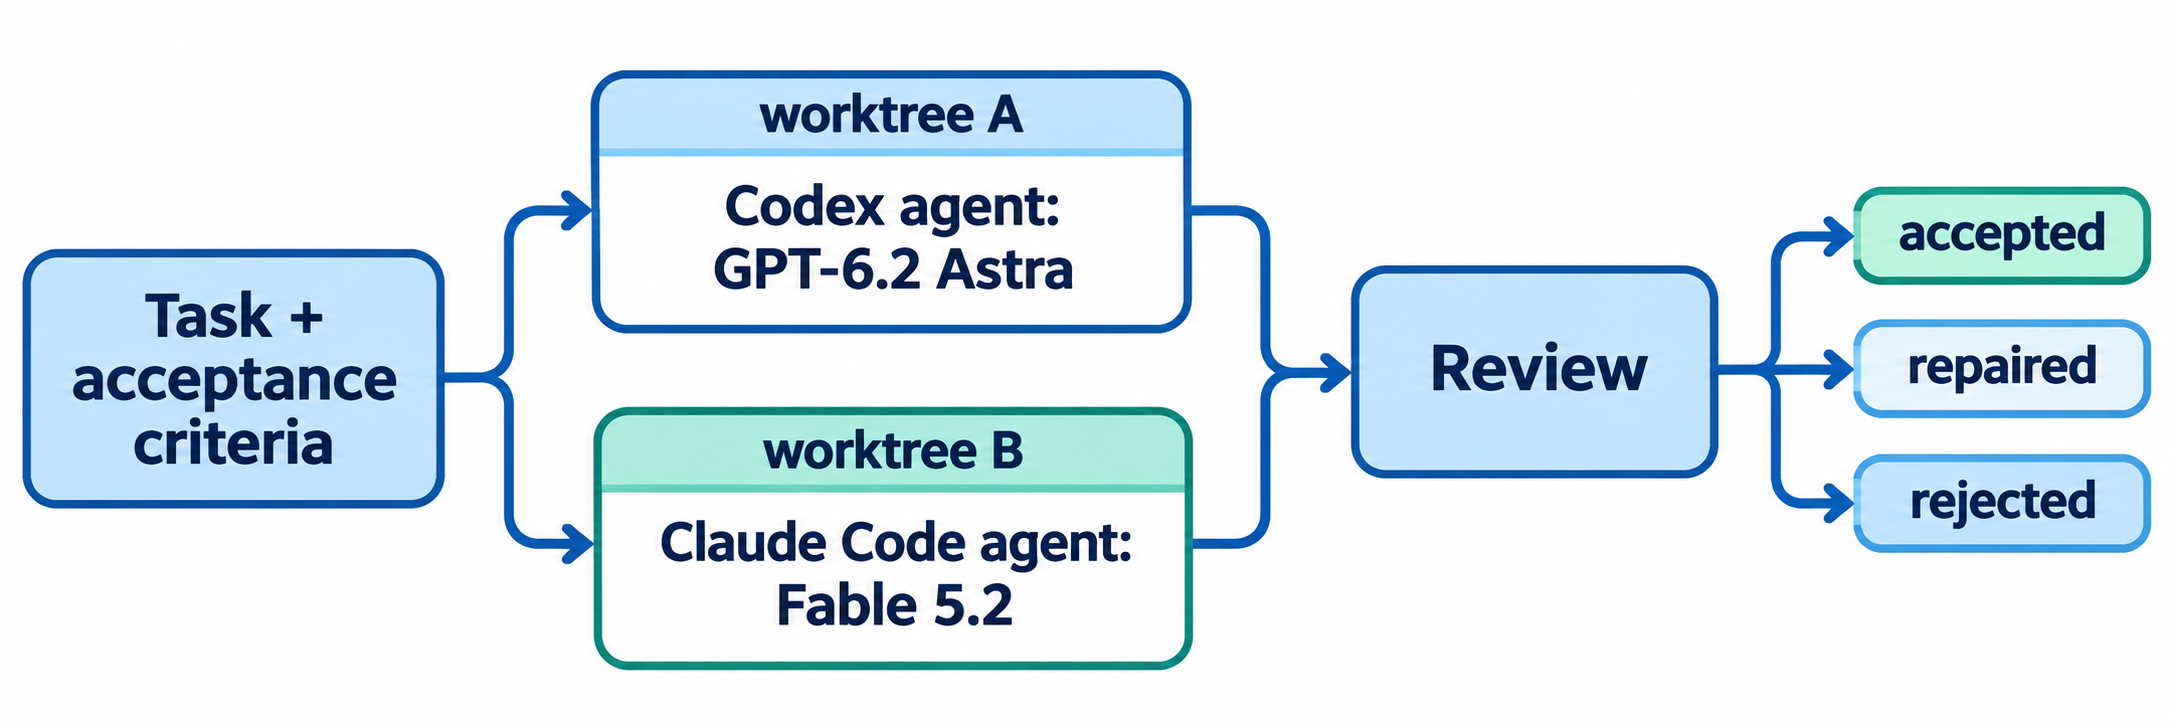
- 直近のタスクを10〜12件選ぶ:バグ修正、小規模な機能追加、リファクタリング、調査を1件ずつ。
- 受け入れ基準を最初に書く:どちらのエージェントも実行する前に基準を固め、結果に引っ張られないようにする。
- ハーネスを固定する:AstraはCodexで、FableはClaude Codeで最も力を発揮するため、比較は2つのワークフロー全体の比較になる。その点をレポートにも明記する。
- エフォートレベルを固定する:両方Highにするか、使用した設定を正確に記載する。
- すべての試行を分離する:試行ごとに新しいgitのworktreeで実行し、互いの編集を引き継がないようにする。
- 各タスクを両モデルで実行する:どちらを先に実行するかは交互に切り替える。
- 可能な範囲でブラインドレビューする:各結果を「受け入れ」「修正のうえ受け入れ」「却下」で評価する。
- 合計支出を受け入れられた変更数で割る:失敗した試行も含める。
判断を分けるのは「受け入れられた変更1件あたりのコスト」だ。トークン単価が20%安くても、タスクごとに追加の修正サイクルが1回多く必要なら、チームにとってはそのモデルのほうが高くつく。
Sharklyで両モデルをAgentとして実行する
Sharklyは既存のコーディングエージェントを置き換えるのではなく、そのまま実行する。SharklyのAgentは、接続したComputer上のCodexやClaude CodeなどのRuntimeを通じてTaskを実行する、構成済みのAIチームメイトだ。
一騎打ちの設定はAgentを2つ用意する:
- Astra Agent:
gpt-6.2-astra用に構成したCodex Runtime。 - Fable Agent:
claude-fable-5-2用に構成したClaude Code Runtime。
各Agentのデフォルトモデルは、Computer・Runtime・Working directoryの設定画面で、Runtimeが報告するモデルの中から選ぶ。最新のAgent設定はSharklyヘルプセンターを参照してほしい。
両Agentに同じ実行制限を設定し、片方だけ並列実行数やタイムバジェットが多くなることがないようにする。

作業ディレクトリのモードはTemporaryを使い、各Taskに分離されたディレクトリを割り当て、リポジトリ連携の実行では新しいworktreeが用意されるようにする。受け入れ基準はTaskの説明欄に記入する。各Agentはパッチとチェック結果を自身のTaskに報告するため、すべての試行がレビュアーの判定と並んで残る。
モデルの利用量は、お客様自身のサブスクリプションとAPIキーに帰属する。Sharklyはトークンを販売しておらず、モデルのクォータはチームが接続したツール・プラン・APIアカウントに依存する。
AstraかFableかを単純に選ぶ以外の選択肢
どちらか一方を勝者にしなければならないわけではない。
- タスク種別で使い分ける。自社のテストで勝ったカテゴリはFable 5.2、それ以外はAstraに任せる。
- 一方をリードに、もう一方を実務担当にする。フロンティアモデルが計画とレビューを担い、定型作業は安価なモデルが担う。これはGPT-6 AstraをCrewリーダーにする記事で示したパターンだ。
- 1ティア下げる。GPT-6.2 Solは入力$2、出力$10(100万トークンあたり)で提供されている。定常的なメンテナンスなら、4分の1の価格で基準を満たすかもしれない。
- 両方を生かしておく。ベンダー中立性こそが要点だ。唯一無二のベストモデルは長くは続かない――Argon、Astra、Opusの記事でも論じたとおりだ。
実際のユースケース
- 大規模マイグレーション。AnthropicはFable 5.2のエージェント群で本番サービスをPythonからRustへ移行したチームを報告している。こうした作業は、どちらのモデルに任せるにせよ、まず自社の一部分で検証すべきだ。
- 大規模リポジトリの調査。入力が272Kトークンを超えるとAstraの料金が切り替わる。実際のコンテキストサイズでコストモデルを回そう。
- 並列バグ処理キュー。小さな修正10件を両Agentに振り分ければ、1週間以内にモデルごとの「受け入れられた変更率」がわかる。
結論
GPT-6.2 AstraとFable 5.2は、紙の上ではトークン単価が同じだ。Fableは公開されているコーディングスコアが高く、キャッシュヒット時の料金も安い。Astraはコンテキストウィンドウがやや大きいが、入力272Kトークン超では料率が跳ね上がる。しかしどちらの事実も、自社リポジトリでより多くの受け入れコードを生み出すのはどちらかという問いには答えてくれない。
一騎打ちを実行しよう。1台のComputerをSharklyに接続し、GPT-6.2 AstraでCodex Agentを、Fable 5.2でClaude Code Agentを作成し、今週同じ5つのタスクを両方に割り当てる。「受け入れられた変更1件あたりのコスト」で勝ったモデルを残せばいい。
FAQ
GPT-6.2 AstraはClaude Fable 5.2より安いですか?
いいえ。どちらも入力100万トークンあたり$8、出力100万トークンあたり$40です。Fableのキャッシュヒットは$0.20対$0.40でFableが安く、Astraは入力272Kトークン超で料率が上がります。
コーディングにはGPT-6.2 AstraとFable 5.2のどちらが優れていますか?
AnthropicはFable 5.2について、前世代のGPT-6 Astraより高いエージェント型コーディングスコアを報告しています。Fable 5.2とGPT-6.2 Astraを直接比較した公開ベンチマークは存在しないため、自社のタスクで両方を検証してください。
GPT-6.2 AstraとFable 5.2のコンテキストウィンドウはどれくらいですか?
GPT-6.2 Astraは1,050,000トークン(入力上限922,000トークン)です。Fable 5.2は標準料金で100万トークンのコンテキストを提供します。どちらも最大出力は128,000トークンです。
GPT-6.2 AstraをClaude Codeで、あるいはFable 5.2をCodexで使えますか?
各モデルは通常、それぞれのベンダーのコーディングエージェントで実行します(AstraはCodex、FableはClaude Code)。両者を比較するということは、通常、モデルとハーネスを合わせたワークフロー全体を比較することを意味します。
2つのコーディングモデルを公平に比較するには?
同じタスク、事前に書き出した受け入れ基準、固定したエフォートレベル、分離されたworktreeを使います。「受け入れ」「修正のうえ受け入れ」「却下」で結果を評価し、合計支出を受け入れられた変更数で割ってください。
SharklyはAgentに使うモデルを選んでくれますか?
いいえ。各Agentのデフォルトモデルは、そのRuntimeが報告するモデルの中からユーザー自身が選択します。Sharklyがモデル間でタスクを自動的に振り分けることはありません。


