
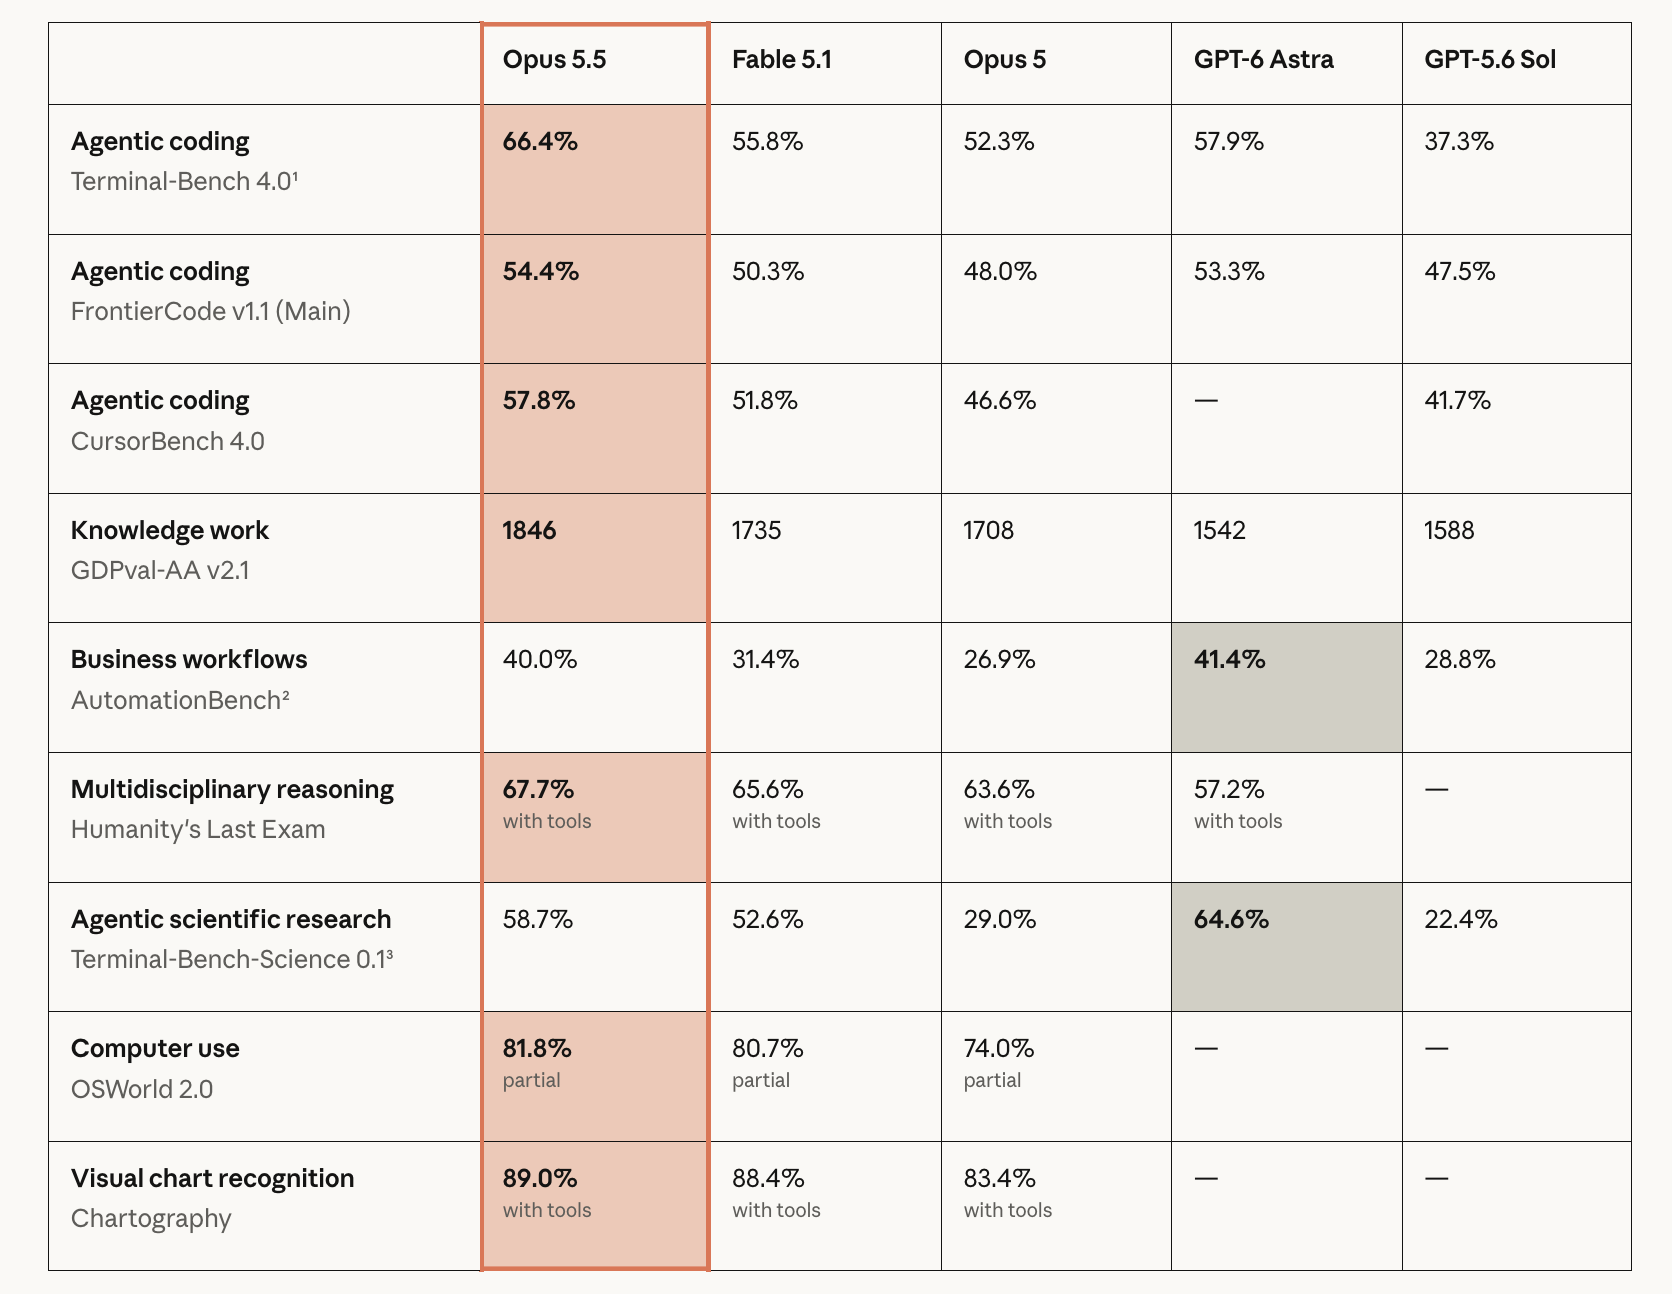
Anthropicは9月22日にClaude Opus 5.5をリリースした。すでに複数のコーディングエージェントを運用しているチームにとって重要なのは、ベンチマーク表に載っている数字ではない。重要なのは次の点だ。Anthropicによれば、Opus 5と比べて実行コストが40%低く、出力は約30%高速で、18時間以上タスクに集中し続ける。定価は100万入力トークンあたり4ドル、100万出力トークンあたり20ドルで、Opus 5の5ドルと25ドルから下がっている。
より安く、止まらずにより長く働くモデルは、あなたの1週間を楽にはしない。同じ人数のレビュアーの前に、完了した実行がより多く届くようになるだけだ。Opus 5.5をボードに載せるのは10分の作業だが、増えたスループットをボードでどう扱うかを決めるのが本当の仕事だ。このガイドでは、前半を最短の実用ルートでたどり、後半については正直に語る。つまり、1台のComputer上のClaude CodeにOpus 5.5を設定し、Agentを1つ作成し、実際のTaskを1つアサインする、というところまでだ。
TL;DR
接続済みのComputer上のClaude Codeでモデルとして claude-opus-5-5 を設定し、RuntimeがAvailableと表示されることを確認し、Opus 5.5が実際に稼働する時間に合わせたTask単位のタイムアウトを設定してAgentを作成し、作業ディレクトリはTemporaryのままにして、Taskを1つアサインする。Sharklyはモデル名を表示しない。表示されるのは、実行、ログ、質問、そしてTask上の結果だ。Agentは調査・実行・テスト・報告を行う。人間は方向性を示し、権限を与え、結果を受け入れる。
モデル設定はどこにあるのか
Sharklyはモデルを選ばない。Agentsのドキュメントにもそう明記されている。「AgentはRuntimeのデフォルトモデルに従います。特定のモデル名を約束したり表示したりすることはありません。モデルの変更は、Agent上ではなく、RuntimeまたはComputerのツール設定で行ってください。」
存在しないドロップダウンを探し始める前に、この境界ははっきりさせておく価値がある。役割は4つ、それぞれに仕事は1つだ。Agentは作業の扱い方を定義する。Computerはホストとローカルリソースを提供する。Runtimeは実際のエージェントセッションを実行し、ここではClaude Codeがそれにあたる。Taskはチーム共有の記録であり続ける。Opus 5.5は、あらゆるモデルと同じ経路でSharklyに届く。つまり、それを動かすツールを通り、そのツールを動かすホスト上で設定される。
ステップ1:Computer上のClaude CodeにOpus 5.5を設定する
実行に使うComputer上でClaude Codeを更新し、Opus 5.5にアクセスできるアカウントまたはAPIキーでサインインする。AnthropicはこのモデルをClaude Platform、Amazon Web Services、Google Cloud、Microsoft Azureで提供しているため、クラウドプロバイダーを利用しているチームはClaude Codeの接続先をそちらに向ける。そのホストの通常のターミナルで claude --model claude-opus-5-5 がセッションを開始できれば、Sharklyからも使える。
次に、このComputer上のすべての実行がそれを使うようにデフォルトを設定する:
// ~/.claude/settings.json
{
  "model": "claude-opus-5-5"
}
共有のComputerに展開する前に、正確な設定キーと最低限必要なClaude Codeのバージョンを、最新のClaude Code設定リファレンスで確認すること。[VERIFY]
Sharklyに戻り、Computerの詳細を開いて再スキャンまたは接続テストを実行する。Claude Code RuntimeがAvailableと表示されるはずだ。Computerがonlineとだけ表示されている場合は、そのローカルサービスがハートビートを送っているにすぎない。実行を開始できるかどうかを示すのは、Runtimeのケイパビリティステータスだ。
1台のComputer、2つのモデル階層。Agentにモデルピッカーはないが、通常の環境変数とシークレット環境変数、および追加のRuntime引数を持ち、それらはRuntimeの起動時に渡される。これにより、Computerには安価なデフォルトを残し、Opus 5.5は必要なAgentだけに適用できる。すべてのトリアージ実行にリーダー料金を払わずに済む。標準化する前に、まず1つのAgentで試してみること。[VERIFY]
ステップ2:Opus 5.5の挙動に合わせてAgentを設計する
Agentsを開き、New Agentを選択し、ComputerとClaude Code Runtimeを選ぶ。その後、前のモデルよりもこのモデルで重要になる3つの項目を設定する。
Task単位のタイムアウト。Anthropicによれば、Opus 5.5は18時間以上タスクに集中し続ける。20分の不具合修正に合わせて調整したタイムアウトでは、実行が途中で打ち切られ、わけのわからないログが残るだけだ。すべてのAgentで延ばすのではなく、必要なところだけ延ばす。マイグレーションや大規模なリファクタリングを担当するAgentには長いタイムアウトを、小さなフロントエンドの不具合修正を担当するAgentには短いものを。守備範囲の狭いAgentに長いタイムアウトを設定しても、失敗が遅くなるだけだ。
作業ディレクトリ。Temporaryモード。各Taskは分離されたディレクトリを割り当てられ、リポジトリに紐づく実行では新しいworktreeが用意されるため、同じリポジトリ上で2つのOpus 5.5実行が互いを上書きすることはない。一時ディレクトリの場合、デフォルトの同時実行数はComputerの上限の50%だ。Computerが実際の実行をいくつかこなすまでは、そのままにしておく。
出力サイズ。Opus 5.5は1回のレスポンスで最大128kトークンの出力をサポートする。何時間も働き、その長さで答えることを許された実行は、誰も注意深く読まないdiffを返してくる。モデルを忙しくさせるのではなく、結果をレビューできるようにTaskのスコープを定める。
指示は安定した短いものにする:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
ステップ3:Taskを1つアサインし、そこにCrewを向ける
受け入れ基準が明確なTaskを選ぶ。AgentをAssigneeとして選択し、TaskをBacklogから、カテゴリが作業可能(ready for work)のステータスへ移動する。BacklogのままアサインされたTaskは待機したままになる。実行はqueued、dispatched、runningと進み、Executionsタブでログがストリーミングされる。
最初のTaskには単一のAgentを使う。CrewはPeopleとAgentsからなる再利用可能なグループで、1人のリーダーAgentによって調整される。リーダーが目標を解釈し、複数のメンバーの結果を1つのTaskにまとめなければならないときに真価を発揮する。範囲の定まった変更であれば、1つのAgentが正解であり、可動部分はゼロのままだ。
Crewが本当に意味を持つ場面では、Opus 5.5は1つ前の価格帯だったときよりもリーダーとして正当化しやすい。リーダーは主に読み、計画し、割り当て、レビューする。価格表の最上位では最も正当化しづらかった形の仕事だ:
| Runtimeモデル | API ID | 100万トークンあたりの入力/出力 | Crewでの適した役割 |
|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | リーダー、レビュアー、長期マイグレーション |
| Claude Opus 5 | claude-opus-5 |
$5 / $25 | 置き換えられる以前のデフォルト |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | 定常的なメンバー向けの2つ目のRuntime |
Opus 5.5のキャッシュ済み入力の読み取りは100万トークンあたり0.20ドル、キャッシュ書き込みは5ドルだ。これが、同じリポジトリのプレフィックスを読み直す長いセッションが安く済むか高くつくかを左右する。レイテンシがコストより重要な場合には、8ドルと40ドルの高速モードもある。モデルの利用は各ツールで設定したサブスクリプションまたはAPIキーを通じて行われるため、これらの料金はSharklyではなく、利用中のプロバイダーの請求に計上される。
ボード上で実際に変わること
3つある。うちモデルに関係するのは1つだけだ。
実行は安くなるが、レビューは安くならない。トークン単価が20%下がり、Opus 5より実行コストが40%低いということは、同じ月額予算で先週より多くのエージェント実行を買えるということだ。しかしその一文のどこにも、レビュアーの工数は増えない。マルチエージェントチームの制約は、これまで一度もモデルコストではなかった。1人が1日に実際に受け入れられる完成済みのdiffが何本か、それだけだ。モデルが安くなれば、この制約はむしろきつくなる。モデルの選択ではなく、レビューキャパシティを基準に計画を立てよう。
長時間実行は、監督の意味を変える。1日の大半にわたってタスクを抱えるエージェントは、ターミナルを眺めていて監督できるものではない。一目でわかるステータス、流れ去らずに人に届く質問、そして結果が着地する場所が必要だ。Sharklyでは、質問はコメントとしてTaskに戻り、Taskはwaiting for human replyと表示され、それがあなたのInboxにルーティングされる。
境界回避の成功が減ったのは進歩であって、ガードレールではない。Anthropicは、境界回避の試みが成功した件数がOpus 5より85%少ないと報告している。これは行動面での確かな改善だが、権限システムではない。実行を縛るのは、Agentに紐づけられたリポジトリ、その環境変数、そして人間による受け入れのステップだ。モデルの改善は2層目として扱い、決して唯一の層にしてはならない。
実行が途中で止まったとき
早く終わった実行も、失われてはいない。実行ログを開き、タイトルと技術的な詳細を読み、より狭いスコープでTaskから再実行する。ディレクトリとTaskの記録は残るので、次の試行は記憶ではなく証拠から始められる。止まっても数分の損失で済むように、Taskは小さく保つ。
変えずに保っておく価値があるのは、この部分だ。今週モデルは変わったが、アサイン、コンテキスト、進捗、ブロッカー、結果、そして人間のレビューは、チームが見える場所にとどまっている。すでに複数のコーディングエージェントを動かしているなら、Computerを1台接続し、Agentを1つ作成し、退屈な作業をアサインしてみよう。


