
TL;DR: MIT CSAILのチームは、フロンティアモデルにQwen3.5-0.8Bの重みをPythonサンドボックス内で読み取り・編集させた。フォワードパスの厳格な予算と全ステップの完全なログ付きで。著者らはMATH-500が7.9%から48.1%に上昇したと報告している。コーディングエージェントにモデルの重みを編集させる場合も同じやり方が使える。ボード上の5つのタスク、各タスクに書き込まれた予算、評価を担う2人目のエージェント、そして編集済みファイルを承認する人間、という構成だ。
2026年11月2日、Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattabの各氏がSparks of Weight-Space Programmingを発表した。研究で使用されたモデルGPT-6 Astraは、重みテンソルを開き、それらに対してnumpyとPyTorchのコードを書き、仮説を立て、0.8Bパラメータモデル内の131,072個の数値を変更した。
セットアップを読むと見覚えがあるはずだ。サンドボックス、ツール予算、すべてのプロンプトと実行セルのログ。これはハーネスを備えたコーディングエージェントであり、そのハーネスこそが今日あなたのチームがそのまま真似できる部分である。
MITチームの成果を数字で見る
重み空間プログラミング(weight-space programming)とは、LLMがネットワークのパラメータをデータとして読み取り、勾配降下も学習実行も使わずに直接編集する手法である。MITの投稿はこれを小規模モデルで、厳しいツール制限のもと、全ターンをログに記録しながら報告している。
最大の成果はQwen3.5-0.8Bの編集である:
| 指標(著者らの数値) | ベースモデル | 編集後モデル |
|---|---|---|
| MATH-500 | 7.9% | 48.1% |
| GSM8K | 13.8% | 67.1% |
| IFEval | 21.0% | 62.3% |
| 32,768トークン制限に到達した実行 | 93.0% | 33.1% |
Astraは、モデルがトークンを使い果たすまでループし続ける癖を、レイヤー15と19のMLPが書き込んだある方向に突き止め、それを各レイヤーの64個の出力カラムから差し引いた。131,072個の重み、つまりモデルの0.016%である。公開されたチェックポイントはApache-2.0で、そのカードによればベースモデルと異なるのは2つのテンソルのみである:それら2レイヤーのdown_proj.weight行列だ。
なぜハーネスが結果を決めるのか
投稿に含まれる2つの発見は、見出しの数字よりもチームにとって重要である。
予算が結果を変えた。各フォワードパスは平均64シーケンスのバッチを処理した。10パスではMATH-500は12.3%に達した。25パスでは14.1%。50パスでは48.1%に達した。同じモデル、同じタスクでも、エージェントがアイデアをテストできる回数の上限が違うだけで結果が変わる。
ツールが結果を変えた。Gemma 3 270Mの2つの亜種の重みのみを与えられた場合、Astraは4回の試行すべてでどちらが追従的(sycophantic)かを判別できなかった。Astraが書いた最大16個のテキストのアテンション重みを返すツールを与えられると、3ペアすべてで追従的なモデルを正しく指摘した。
つまり2つのレバーがある:エージェントが何に使えるか、そして何を見られるか。どちらも実行開始前に文章化しておくべきものだ。
限界も明確である。AstraはGemma 3 270MのMATH-500を改善できなかった。ベースの6.8%に対し、最良の編集でも7.7%に達しただけだった。著者らはこれを、モデルに欠けていた能力を追加したのではなく、障害を取り除いた編集だと解釈している。著者ら自身がこの発見は初期段階のものであり、いくつかは単一実行にすぎないと述べている。自分の実験も修正策ではなく検証として計画しよう。
コーディングエージェントに安全にモデルの重みを編集させる方法
安全な重み空間実験には5つの特性がある:
- 元の重みはすべてのエージェントにとって読み取り専用である。
- フォワードパスの予算はタスク内の数値であり、サンドボックスによって強制される。
- 編集者が見る評価セットは、レビュアーが実行する回帰セットとは分離されている。
- 各実行のログは、それが属するステージに紐づけられたままである。
- サンドボックス外でファイルを読み込む前に、人間が編集済みファイルを承認する。
Sharklyはフォワードパスを数えたり、テンソルを検査したりしない。それはあなたのサンドボックススクリプトが行い、読み取りと編集はあなたのランタイム(Claude Code、Codex、またはすでに使っている別のエージェント)が行う。Sharklyは作業を保持する:各ステージの担当者は誰か、何に使えるか、何が返ってきたか、誰が承認したか。MITチーム自身のログリポジトリにはCodex設定とサンドボックススクリプトを含むharness/フォルダがあり、サンドボックス側の参考として有用だ。
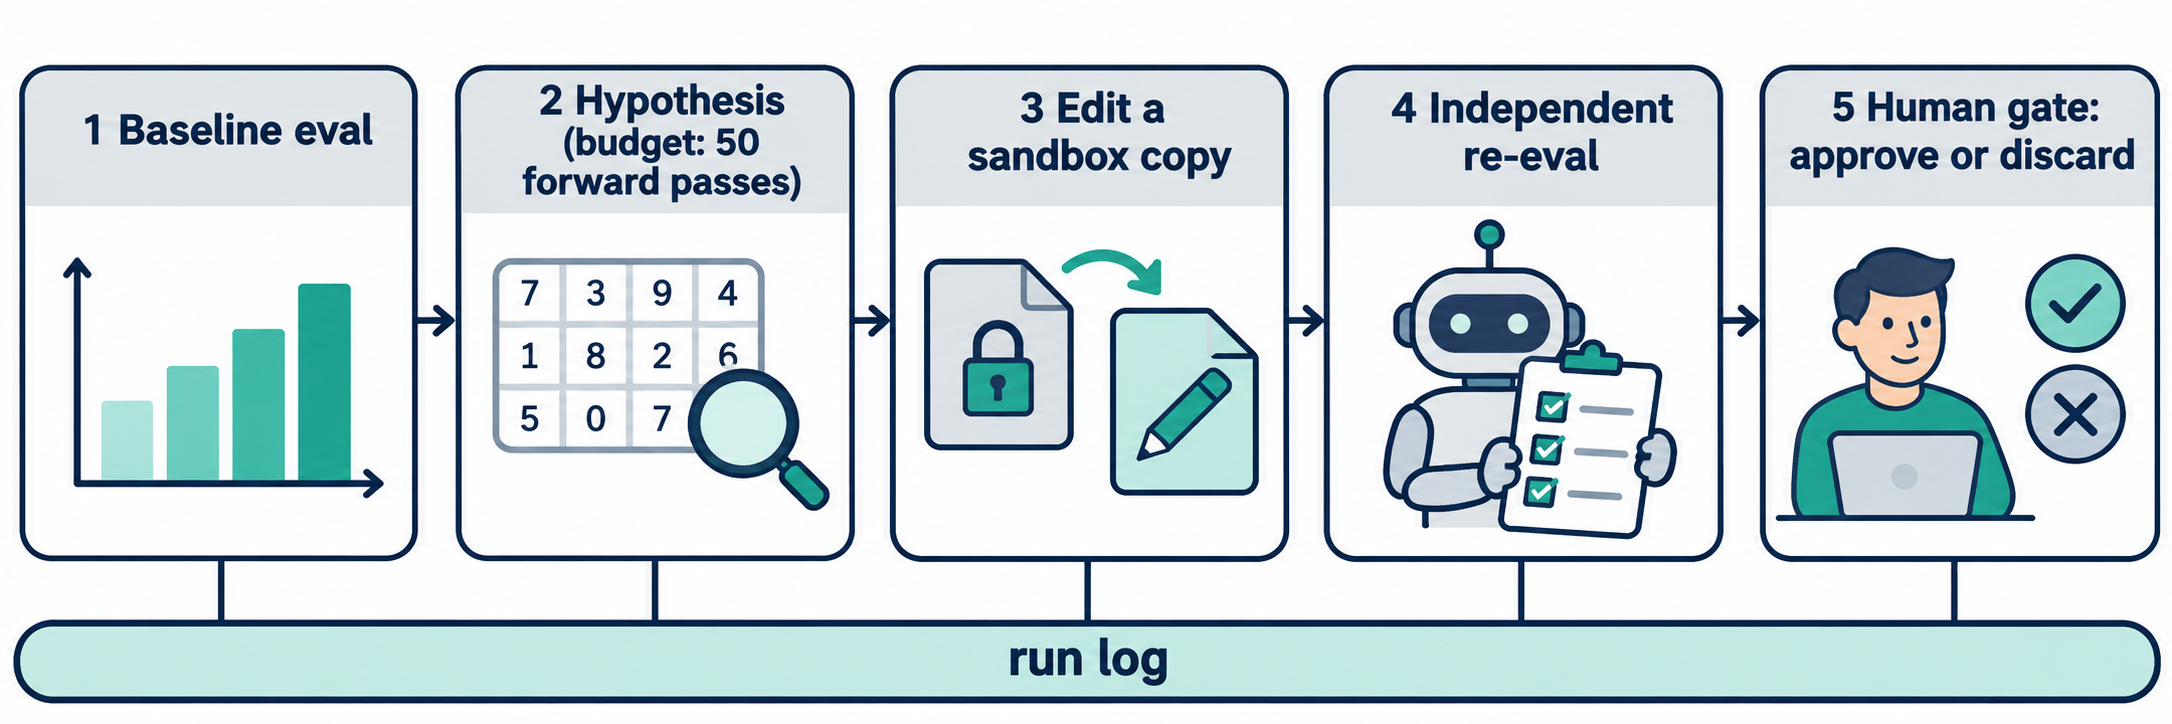
ステージ1:未編集モデルのベースライン評価
最初のタスクは、元のチェックポイントに対して評価を実行し、スコアとモデルが失敗する箇所を記録する。Qwen3.5-0.8Bでは、実行の93.0%がトークン制限に到達した。仮説タスクにはこの失敗の記述が必要である。
ステージ2:重みを読み、仮説を書く
これが予算付きのタスクだ。数値を本文中に、エージェントが読み違えられない形で書く:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
タスク内の予算は約束にすぎない。サンドボックスラッパー内の予算が保証である。両方を書き、ラッパーに使用済みパスを出力させてその数値が実行ログに残るようにしよう。
ステージ3:サンドボックスコピー内で編集する
編集エージェントはチェックポイントのコピーを変更し、差分を報告する。元のファイルへの書き込み権限は一切与えられない。Sharklyでは、各タスク実行に独自の分離ディレクトリが与えられ、リポジトリ作業では実行ごとに別のworktreeを使えるため、ステージ3がステージ1で測定したものに触れることはできない。
ステージ4:レビュアーエージェントによる独立した再評価
このステージは編集を行ったエージェントとは別のエージェントに割り当てる。レビュアーはステージ1の評価を再実行し、編集者が一度も見ていない回帰セットを追加する。Crewを運用している場合、リーダーが編集をあるメンバーに、再評価を別のメンバーに渡すことができる。このパターンはレビュアーを分離した混合モデルCrewと一致する:変更を書いたエージェントが、それを採点するエージェントではないのだ。
編集者は自分が見られた範囲に対して最適化したので、それらの問題でのみ現れる改善はほとんど証拠にならない。
ステージ5:差分に対する人間のゲート
最後のタスクは、3つの添付ファイルとともに人間に届く:変更されたテンソルのリスト、変更前後の表、そしてレビュアーの回帰結果である。このタスクが進むまで、サンドボックス外で編集済みチェックポイントを読み込むものは何もない。
次の短いスクリプトは最初の添付ファイルを生成する。2つのsafetensorsチェックポイントを比較し、変更されたすべてのテンソルを列挙する:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
公開されたチェックポイントでは、モデルカードによれば正確に2つのdown_proj.weightテンソルが確認できるはずだ。自分の編集が仮説で名指しされていないテンソルに触れているなら、それが破棄すべき理由である。
Sharklyでボードを運用する
1つの実験のためのボードは次のとおりだ。各行はそれぞれ担当者、ステータス、実行履歴を持つタスクである。
| タスク | 担当者 | 予算またはゲート | 完了条件 |
|---|---|---|---|
| 1. ベースライン評価 | 評価エージェント | 評価セットのみ | スコアと失敗メモが投稿される |
| 2. 重みからの仮説 | 編集エージェント | 50フォワードパス | 仮説が投稿され、使用パスがログに残る |
| 3. サンドボックス編集 | 編集エージェント | コピーのみ、原本は読み取り専用 | 差分と編集済みファイルがサンドボックス内に |
| 4. 再評価と回帰 | レビュアーエージェント | 保持された回帰セット | 変更前後の表が投稿される |
| 5. 承認または破棄 | 人間 | 人間のゲート | 決定がタスクに記録される |
ステージはblocks関係でリンクし、ボードに連鎖が表示されるようにしよう。Sharklyのタスク関係はその範囲について正直である:関係はカード上で依存関係と進捗を示すが、それ自体でタスクを動かしたり実行を開始したりはしない。前のステージが完了するまで各ステージをBacklogに置いておこう。エージェントに割り当てられたタスクはBacklogにある間は実行を開始しないので、そこから動かすことがトリガーとなる。
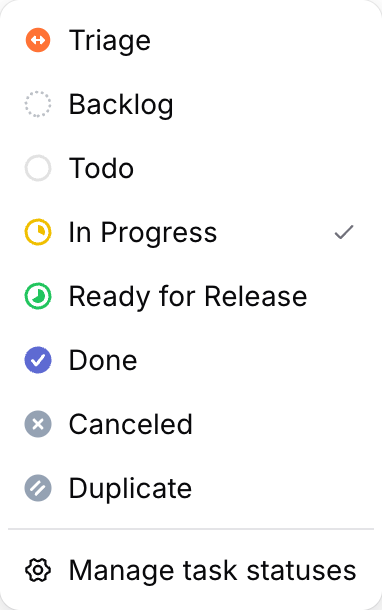
ステージ4が完了すると、エージェントはタスクを人間のレビュー待ちにでき、人間はInboxでそれを確認する。実行ログには各実行の開始、終了、ツール呼び出し、トリガーが記録される:これが監査証跡であり、それが属するステージに保持される。エージェントをどこで止めるかについては、コーディングエージェントの承認ゲートを参照されたい。
始める前の実務的な限界
- 小さく始める。研究ではCPUでテンソルアクセス可能な0.8Bと270Mのモデルを使用した。数分で評価できるモデルを選ぼう。
- 欠けた能力には改善を期待しない。Gemmaの結果が示すのは、編集はモデルの障害を取り除けるが、能力を教え込めるわけではないということだ。
- 1回の実行は逸話として扱う。編集を信頼する前に、新しいエージェントで実験を繰り返そう。
結論
MITの投稿から再利用できる教訓はハーネスである:文章化された予算、制限されたツール、完全なログ、そして他の誰かが検証できる結果。これらは、コードを編集するコーディングエージェントに対してすでに求めている統制と同じものだ。
試すには、SharklyのSpaceで5つのタスクを作成し、ステージ1〜4を接続したComputer上のエージェントに割り当て、ステージ5は自分用に取っておこう。Sharklyはsharkly.aiで無料で始められる。
FAQ
コーディングエージェントはモデルの重みを編集できるのか?
MIT CSAILの研究では、できる。GPT-6 AstraはPythonサンドボックス内でQwen3.5-0.8Bのテンソルを読み、131,072個の重みを変更した。著者らはMATH-500が7.9%から48.1%に上昇したと報告している。この研究は初期段階のもので、小規模モデルを対象とし、いくつかの結果は単一実行にすぎない。
重み空間プログラミングとは何か?
LLMがネットワークのパラメータをデータとして読み取り、学習なしで直接編集する手法である。コードでテンソルを分析し、仮説を立て、重みを変更し、限られた回数のフォワードパスで効果を測定する。
フォワードパスの予算が重要なのはなぜか?
著者らのQwenのアブレーションでは、10パスでMATH-500が12.3%、25パスで14.1%、50パスで48.1%に達した。予算はエージェントがテストできるアイデアの数を決める。タスクに書き込み、サンドボックスで強制しよう。
重みの編集でモデルに新しい能力を追加できるのか?
研究はノーを示唆している。Astraの最良の編集でもGemma 3 270MのMATH-500は6.8%から7.7%にしか動かなかった。著者らは、編集はQwenの障害を取り除いたのであり、能力を追加したのではないと結論づけている。
編集済みの重みが本番環境に到達するのを防ぐには?
原本を読み取り専用でマウントし、コピーを編集し、独立した再評価を実行し、サンドボックス外でファイルを読み込む前に人間がテンソル差分を承認することを必須にしよう。


