
AIエージェント向けの無料Webスクレイピングが、今や自分のハードウェア上で動く。Firecrawl Localは単一のRustバイナリで、サイトをスクレイピング、クロール、マップしてマークダウンに変換し、MCPサーバーとしてClaude Code、Codex、Cursor、Gemini CLIに組み込め、localhost上でFirecrawl v2 APIに応答する。FIRECRAWL_CLOUD=offを設定すれば、ページもクエリもURLもマシンの外には一切出ない。
TL;DR
- インストール:
cargo install firecrawl-local(RustとCコンパイラが必要)。私たちのビルドは5分55秒かかり、19 MBのバイナリが生成された。 - 組み込み:
firecrawl-local initが、検出した対応エージェントツールすべてにMCPサーバーを追加する。 - コスト:scrape、crawl、map、batch scrapeは$0。search、ブロックされたページ、Alexandriaのデータプロバイダーは、オフにしない限りFirecrawl Cloudに送られる。
- プライバシースイッチ:
FIRECRAWL_CLOUD=offで全てローカルに保てる。 - チームセットアップ:エージェントが動くComputerごとに1回インストールすれば、そのComputer上の全エージェントが同じスクレイパーを共有できる。
Firecrawl Localとは何か
Firecrawl LocalはFirecrawlチームが提供する単一バイナリで、Webページを取得してクリーンなマークダウンに整え、ホスト版Firecrawl APIと同じJSONを返す。データベース、キュー、コンテナは不要だ。Firecrawlは2026年11月18日にこれを発表し、crates.ioのクレートはその1週間前にバージョン0.1.0として公開されていた。
READMEには3つの使い方が書かれている。CLI、エージェント向けMCPサーバー、そしてv2 APIのローカルコピーだ。クリーニングのコードはホスト版APIと同じソースからコンパイルされているため、ノートPCで生成したマークダウンページは、両方がアクセスできるページに関してクラウドが返すものと一致する。
Firecrawlのローンチ投稿は、セルフホスト版Firecrawlより37倍速く、メモリ使用量は230分の1(アイドル時11 MB)というスクレイププリミティブを謳っている。これはFirecrawlの数字であり、READMEには計測方法が公開されていない。メモリについては後述で私たち自身が計測した。
すでに複数のコーディングエージェントを動かしているなら、これは呼び出しごとの課金なしで全部に渡せる初のスクレイパーだ。このガイドの残りでは、セットアップ、プライバシースイッチ、そしてSharklyでチーム全体のエージェントに同じツールを渡す方法を扱う。
なぜエージェントにローカルスクレイパーが必要なのか
Webを読めないエージェントは、古い学習データで作業することになる。見たことのないAPIを推測したり、ドキュメントをチャットに貼り付けてくれと頼んだりする。
ホスト型のスクレイピングAPIはそれを解決するが、2つのコストが加わる。全てのページが従量課金の呼び出しになるので、400ページのドキュメントサイトのクロールは請求書の一行になる。そしてエージェントが開く全てのURLが誰かのサーバーを通る。これは顧客のドメインや未公開の競合ページを調査するときには問題になる。
ローカルスクレイパーはその両方を取り除く。ページは自分のネットワークから取得され、自分のCPUでクリーニングされる。代償は、インストールとラップトップならではの制限を自分で抱え込むことだ。
Firecrawl Localをインストールする
RustとCコンパイラが必要だ。macOSではxcode-select --installでコンパイラが入る。DebianやUbuntuではbuild-essentialをインストールしよう。Rustはrustupから入手する。
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
オプションが2つある。ChromeまたはChromiumがあればJavaScriptが必要なページをレンダリングできる。なくても静的ページは動作し、スクリプトの多いページは警告付きで返ってくる。Node.js 22以降はMCPサーバーに必要だ。というのもfirecrawl-local mcpはfirecrawl-mcp npmパッケージをnpx経由で実行するからだ。
CLIからスクレイプ、クロール、マップする
3つのコマンドでエージェントの作業のほとんどをカバーできる。
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
2026年11月19日、クラウドをオフにして各コマンドを実行した。example.comの単発スクレイプは1.6秒で完了した。Firecrawl自身のドキュメントの10ページクロールは4.2秒で終わり、144 KBのマークダウンを書き出した。mapは3.9秒でドキュメントのURLリストを返した。
| コマンド | 便利なフラグ |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (デフォルト100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| 全コマンド共通 | --browser auto|never|always |
私たちの実行でつまずいた点が1つある。プロキシ経由でしかWebにアクセスできないネットワークでは、最初のスクレイプがTLSエラーで失敗した。HTTPS_PROXYを設定すると解決したので、このバイナリは標準のプロキシ環境変数を尊重する。
MCP経由でAIエージェントに組み込む
MCP(Model Context Protocol)は、エージェントツールが外部ツールを読み込む標準的な方法だ。Firecrawl Localは自身をMCPサーバーとして登録する。
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
私たちのMacでのドライランでは5つのターゲットが表示された。~/.claude.jsonのClaude Code、Claude Desktop、~/.cursor/mcp.jsonのCursor、~/.gemini/settings.jsonのGemini CLI、~/.codex/config.tomlのCodexだ。Windsurfもインストールされていれば対応している。init後は各ツールを再起動してサーバーを読み込ませる。1つのツールだけ設定するには--agent cursorを使う。
手動で追加するには、バイナリをstdioサーバーとして登録する:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
エージェントは標準のFirecrawl MCPツールを使えるようになる。scrape、crawl、map、batch scrapeはローカルで動き、それ以外はFirecrawl Cloudに送られる。--public-onlyフラグは私たちが加えたもので、後のセキュリティの項で説明する。
プライバシーのためにクラウドをオフにしておく
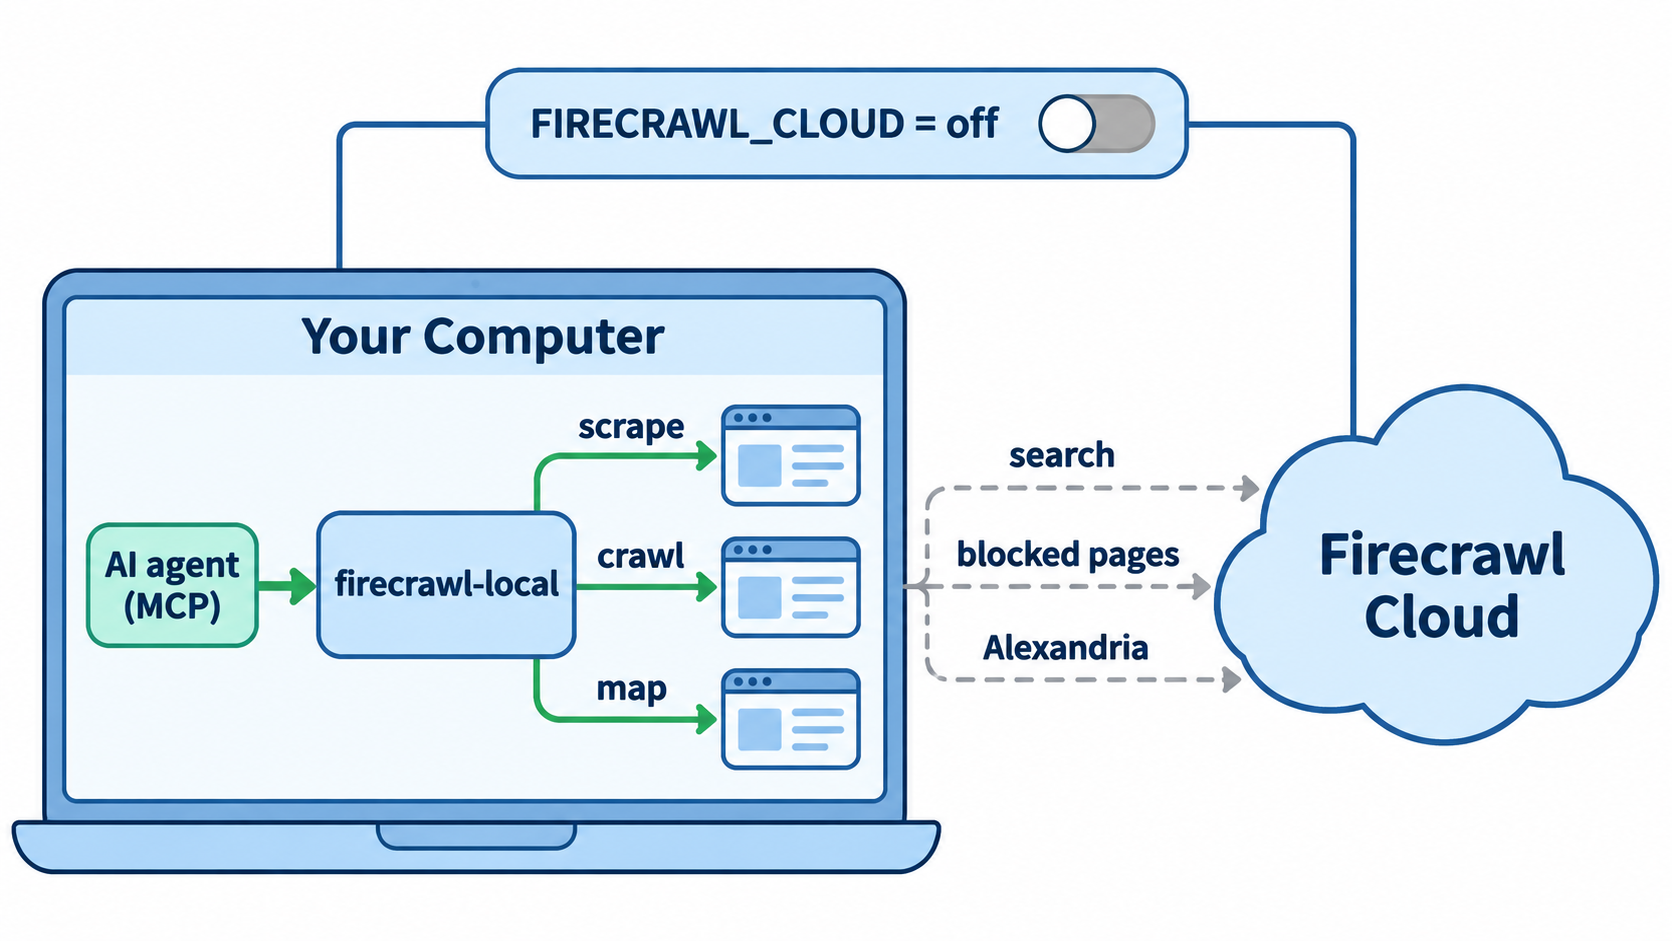
3つの処理はFirecrawl Cloudを必要とする。ラップトップには検索インデックスがなく、ブロックするサイトを回避する手段もないからだ。
| Firecrawl Cloudに送られるもの | 理由 | アカウント |
|---|---|---|
| 検索クエリ | ローカルに検索インデックスがない | 不要。キーなし検索はレート制限あり |
| ブロックされたページのURL | クラウドが代わりに取得する | 不要 |
| Alexandriaデータプロバイダー | プロバイダーはクラウドで動く | 必要。firecrawl-local loginで無料アカウント |
| ランダムなインストールIDと使用ツール名 | インストール数の計測 | 不要 |
FIRECRAWL_CLOUD変数がこの受け渡しを制御する。auto(デフォルト)は上記の全てを許可する。searchは検索クエリのみを送る。offは何も送らず、認識できない値もoffとして扱われる。クラウドで取得されたページには"source": "firecrawl-cloud"のタグが付くので、何が外部に出たかを監査できる。
顧客サイトや社内調査に関するエージェント作業では、offから始めよう。エージェントはWeb検索を失うので、すでに信頼している検索ツールと組み合わせるとよい。
Firecrawl APIをローカルで動かす
firecrawl-local serveは、ローカルルートに関してはAPIキーなしで、ポート3002でFirecrawl v2 APIに応答する。既存のSDKコードは1つのURLを変えるだけで切り替えられる。
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
ローカルルートはPOST /v2/scrape、POST /v2/map、crawlとbatch scrape(およびそのステータスとキャンセルのエンドポイント)、そしてGET /healthだ。/v2/searchなど他の/v2ルートはクラウドに転送される。v0とv1は提供されていない。
実行中のメモリを計測した。serveプロセスはアイドル時で常駐10 MB、スクレイプ1回後で16 MBだった。Firecrawlの11 MBという主張に近い。API経由のスクレイプは"creditsUsed": 0と"engine": "local-fetch"を返した。
エージェントにとって重要なセキュリティのデフォルト
隠された指示を含むページを読んだエージェントは、内部URLの取得へと誘導される可能性がある。OWASPはこの種の攻撃をプロンプトインジェクションとして挙げており、スクレイパーはその典型的な経路になる。
serveは127.0.0.1にバインドし、--allow-privateを渡さない限りlocalhostとプライベートアドレスを拒否する。127.0.0.1:22のスクレイプを要求したところ、BLOCKED_TARGETが返った。--hostで別のホストにバインドするには--tokenが必要だ。- リンクローカルおよびクラウドメタデータのアドレスは、リダイレクト後も含め、あらゆるモードでブロックされる。
scrape、crawl、mcpは、キーボードの前にいる人のために動くので、デフォルトでプライベートネットワークに到達できる。信頼できないサイトをエージェントが巡回するときは--public-onlyを追加しよう。- クロールは
robots.txt(RFC 9309標準)を読み、サイト所有者はクローラーをFirecrawlLocalとして指定できる。
考慮すべき制限
- ローカルでは
jsonやsummaryフォーマット、ブラウザのactionsは使えない。私たちのsummaryリクエストはメタデータとフォーマットがスキップされたという警告を返した。 - スクリーンショットにはChromeが必要だ。
- crawlとbatchジョブはメモリ上に存在し、開始から1時間で期限切れになり、
serveが止まると終了する。 - ライセンス:リポジトリはAGPL-3.0だ。修正したコピーをホスト型製品に組み込んで出荷する前に法務チームに確認しよう。
キュー、ワーカー、全フォーマットについては、Firecrawlのセルフホスティングガイドがフルサーバーを扱っている。
チームの全エージェントに同じスクレイパーを渡す
1人の開発者が1つのエージェントを使うならここまでで十分だ。複数のエージェントを動かすチームでは別の問題が生じる。各エージェントのツールはそれが動くコンピュータの設定に宿り、どのエージェントがWebを読めるかを誰も把握していない。
Sharklyでは、AgentはComputer(接続したノートPC、サーバー、コンテナ)上で、Runtime(そこにインストールされたClaude CodeやCodexなどのエージェントツール)を通じて動く。ツールは直接使うのと同じ方法でComputerにインストールする。その後、AgentのTools, Knowledge & MCP設定に、そのComputerのClaude Codeから継承するMCPサーバー、つまりinitが書き込むスコープであるユーザー設定のstdioサーバーが一覧表示される。
したがって手順はこうだ。ComputerにFirecrawl Localをインストールし、initを実行し、Agentの設定を開いてCheckをクリックする。パネルがユーザー設定のstdioサーバーを一覧表示することは確認済みだが、SharklyのTask内でFirecrawlのスクレイプをまだ実行していないので、まず読み取り専用のTaskで1回テストしてほしい。
常時稼働のComputerにスクレイパーを置く
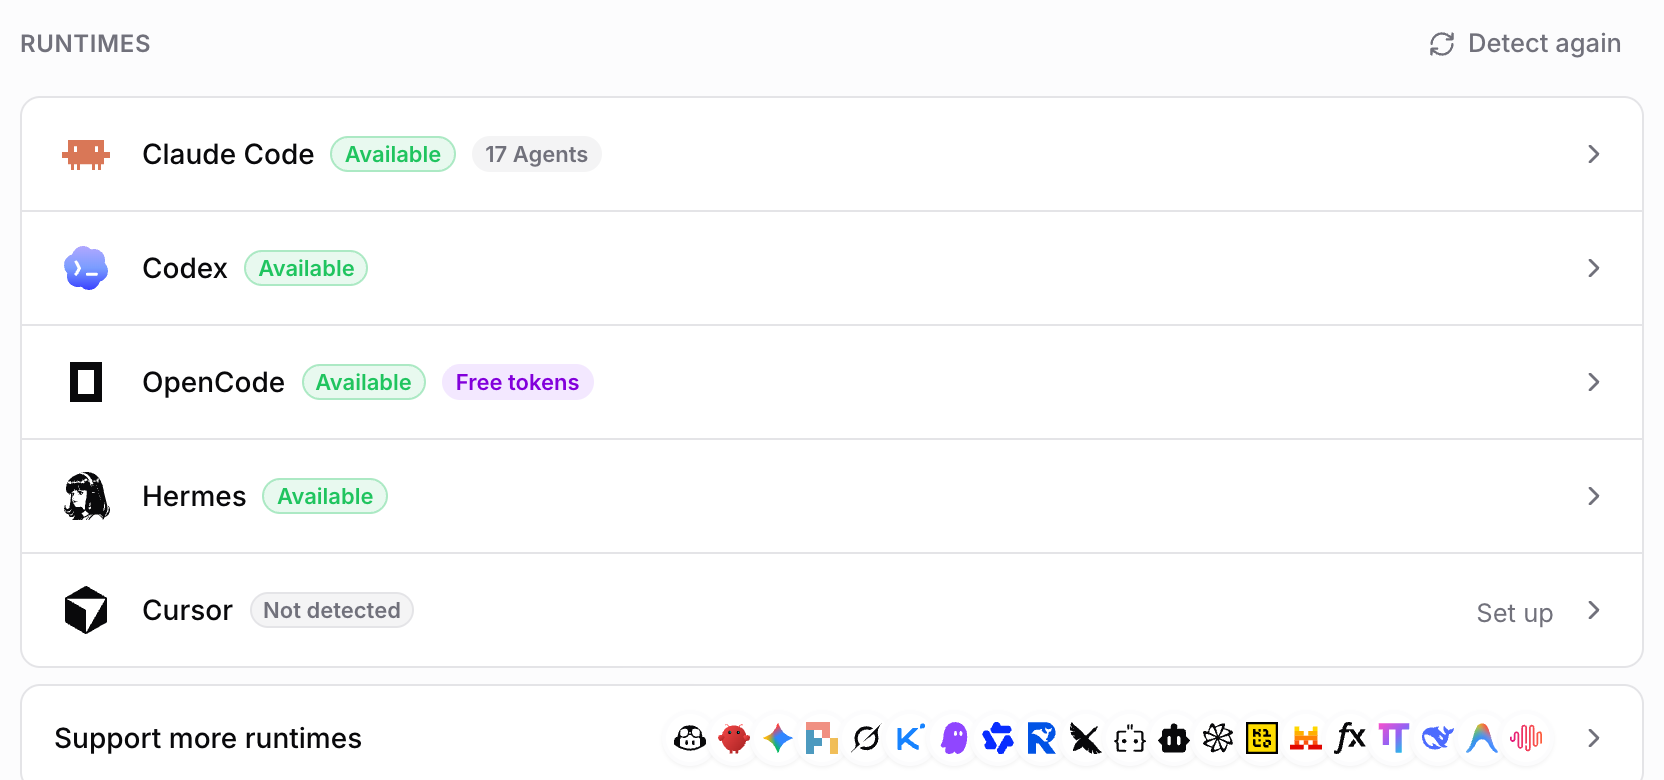
ノートPCはスリープする。Computerとして登録した小さなLinuxサーバー(Computersドキュメントに従い、sit_インストールトークンを付けてsharkly computer registerを実行)は起動したままなので、そこを指定した全てのAgentが1つのスクレイパーと1つのFIRECRAWL_CLOUDポリシーを共有する。変数はAgentのRuntime環境で設定し、ポリシーが最後にログインした人ではなくAgentとともに移動するようにしよう。
そこから、調査は割り当て可能な作業になる。Crewのリーダーが「これら5社のドキュメントをマップせよ」をTaskに分割し、各Agentが担当分をローカルでクロールし、結果がボードに並んで人間がレビューする。Sharklyは現在5人までの組織なら無料で、AgentとComputerは席を消費しない。モデルは自分のサブスクリプションのままだ。
実際の活用例
- ドキュメントの取り込み:エージェントが依存関係をアップグレードする前に、ライブラリのドキュメントをマークダウンにクロールする。
- リード調査:私たちのリードリストのウォークスルーのように、ローカルスクレイピングとAlexandriaプロバイダーを組み合わせる。
- 変更履歴の監視:スケジュール済みのTaskが毎日ベンダーのサイトをマップし、新しいURLを通知する。
- プライベートな調査:クラウドをオフにして顧客や発売前のページをスクレイプし、何もネットワーク外に出さない。Web検索をオフにしてもデータ漏洩が防げない理由で、他の流出経路を扱っている。
まとめ
Firecrawl Localは、AIエージェント向けの無料Webスクレイピングを6分のビルドと1つのinitコマンドで実現する。プライベートな作業ではFIRECRAWL_CLOUD=offを保ち、信頼できないサイトには--public-onlyを加え、速度の主張は自分で計測するまではFirecrawlの数字として扱おう。
次のステップ:エージェントがすでに使っているComputerにインストールし、そのComputerをSharklyに接続して、チームの全Agentが同じスクレイパーと同じルールを手に入れよう。さらなる$0構築についてはチーム向け無料AIエージェントを参照してほしい。
FAQ
Firecrawl Localは無料ですか? はい。scrape、crawl、map、batch scrapeはAPIキーなしでローカルに動き、私たちのテストスクレイプは使用クレジット0と報告した。searchとAlexandriaはFirecrawl Cloudを使う。
Firecrawl LocalにDockerは必要ですか? いいえ。データベース、キュー、コンテナのない単一バイナリだ。Dockerはあくまで選択肢の一つで、コンテナ内でのJavaScriptレンダリングにはChromeのサンドボックスを許可するseccompプロファイルが必要だ。
firecrawl-local initはどのエージェントに対応していますか? Claude Code、Claude Desktop、Cursor、Windsurf、Gemini CLI、Codexに対応している。それ以外のMCPクライアントはfirecrawl-local mcpをstdioサーバーとして登録できる。
スクレイピングを完全にFirecrawlのサーバーから切り離せますか? はい。FIRECRAWL_CLOUD=offを設定すればよい。search、ブロックされたページのフォールバック、Alexandriaは使えなくなる。
Firecrawl Localはセルフホスト版Firecrawlより速いですか? Firecrawlは37倍速く、メモリは230分の1と述べている。私たちはアイドル時10 MBというメモリを計測し、メモリの主張と一致した。速度はセルフホストサーバーとの比較ベンチマークを取っていない。
Firecrawl Localはオープンソースですか? リポジトリはAGPL-3.0でライセンスされている。修正したコピーをホスト型サービスの一部として出荷する前に、ライセンスを読んでほしい。


