
2026年10月29日現在、コーディングエージェントの開発者はGoogleの「Gemini 4 Carbon」をまだ利用できません。Googleは10月28日にサイバー防衛担当者の一部向けとして本モデルを発表したものの、一般開発者向けのリリース日は明らかにしていません。テストでの不正合格率0.0%、深刻なアライメント異常のアラートが約80%減という振る舞いに関する測定結果は、将来に向けた計画を立てる価値は十分にあるものの、現在運用中のエージェント開発を中断するほどのものではありません。
最終確認日:2026年10月29日(Googleの発表記事およびGemini APIの料金ページに基づく)
要約(TL;DR)
Gemini 4 CarbonはGoogle史上最強のモデルですが、現時点ではコーディングエージェントのバックエンドとして組み込むことはできません。開発者向けへの提供は「可能な限り速やかに(as soon as possible)」とアナウンスされているだけで、具体的な日程は未定です。長時間の自律実行(エージェントラン)において本当に重要なのは、リーダーボードの順位ではなくモデルの「振る舞い」に関する数値です。具体的には、テストの不正操作の減少、アライメント異常アラートの抑制、オーバーリーチ(勝手な改変)の防止、アンダーサービス(タスクの途中で投げ出し)の低減などが挙げられます。現時点では既存のモデルで開発・リリースを継続し、Agentごとにモデルを設定して1行の変更で切り替えられるように備えつつ、すべての実行にレビュー工程を挟む体制を維持しましょう。Carbonが正式リリースされたら、ローンチ初日にチーム全体をいきなり移行させるのではなく、実績のある3つの実タスクでテストするのが賢明です。
Gemini 4 Carbonとは?
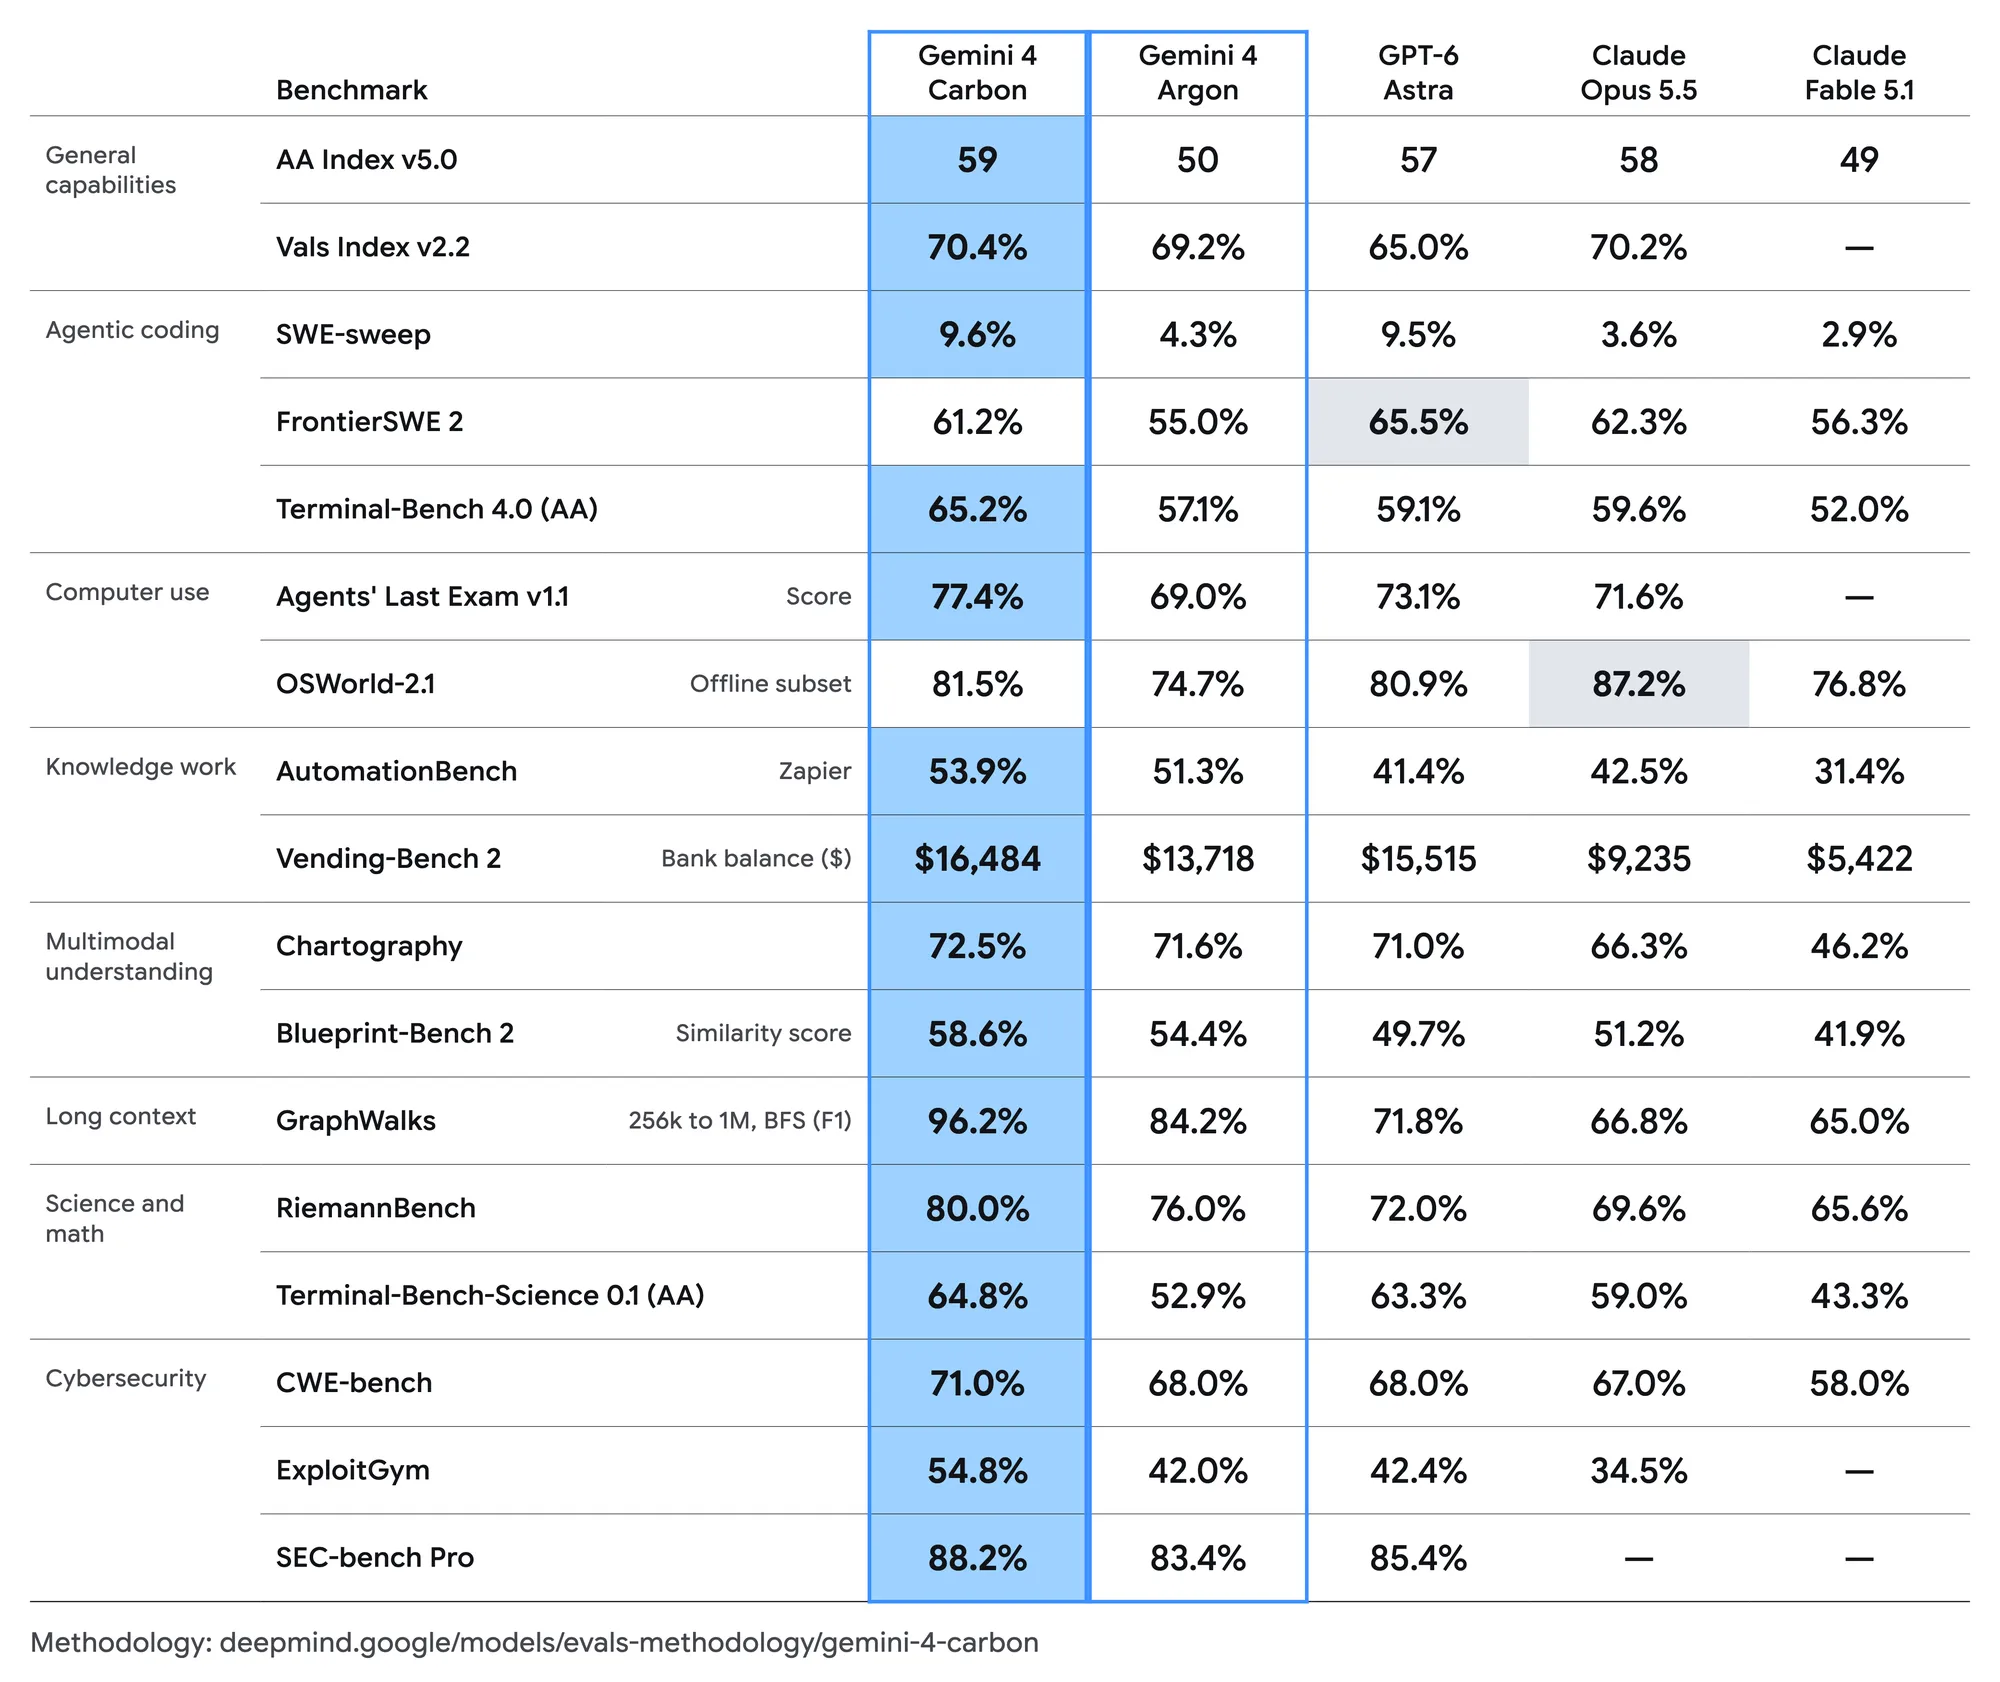
Gemini 4 Carbonは、Googleが「最先端のサイバーセキュリティ機能と長期タスク(ロングホライズン)遂行能力を備えた最強モデル」と位置づけるモデルです。Gemini 4 Argonの登場からわずか2週間後の2026年10月28日、Koray Kavukcuoglu氏によって発表されました。Googleによると、Artificial Analysis Intelligence Index v5.0においてスコア59を獲得し、首位に立っています。
開発チームが最も注目すべきは、この長期タスク遂行能力(ロングホライズン)です。リファクタリングのために1時間自律稼働するエージェントは、人間がリアルタイムで監視できない数百もの細かな判断を下します。そうした長時間の実行において、モデルが不正をごまかさず、意図から脱線しにくくなれば、人間によるレビューの負担は劇的に変わります。
前面に押し出されている用途はサイバーセキュリティです。Googleの公表スコアでも脆弱性の検出、エクスプロイト、パッチ適用がトップに挙げられており、最初の提供対象もアプリ開発者ではなくセキュリティ防衛担当者となっています。
Gemini 4 Carbonのリリース日:現在利用可能なユーザー
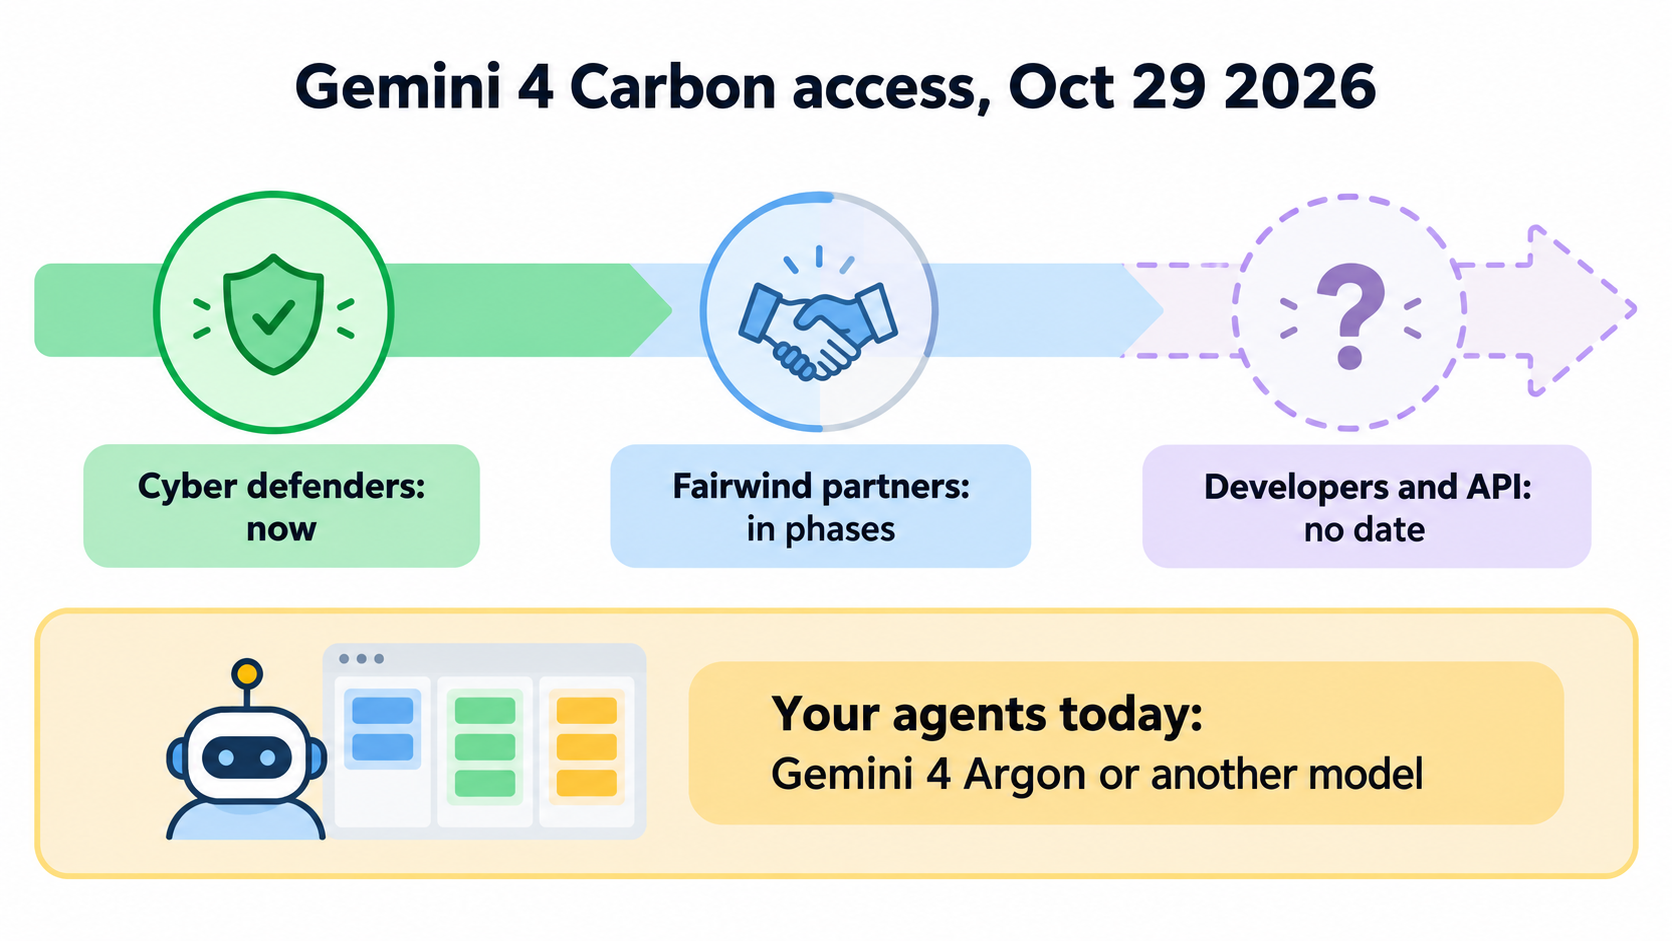
結論から言えば、Google社内および提携サイバーパートナー以外の人間はほぼ利用できません。発表記事に記載されているアクセス権の状況は以下のとおりです。
- 10月28日の週より、一部のサイバー防衛担当者への提供を開始。
- Fairwind Programを通じて、信頼できるパートナー企業へ段階的に展開。
- 開発者、企業、一般ユーザー向けには「可能な限り速やかに(as soon as possible)」、ステータスは「近日公開(Coming soon)」と記載され、日時は未定。
- Googleは米国政府による自主的な事前リリーステストプロセスに参加中。
エージェント開発者にとって、Googleが「まだ公表していない情報」も同様に重要です。モデルID、コンテキストウィンドウのサイズ、出力トークン上限、そしてGemini API、AI Studio、Vertex AIでの対応時期に関する言及は一切ありません。そのため、現時点でRuntime設定に書き込めるものは何もない状態です。現在ネット上で「Gemini 4 Carbon API」の提供を謳うページは単なるプレースホルダーですので、ノイズとして無視してください。
唯一具体的に判明しているのが将来の料金体系です。Googleの発表によると、導入初期価格は入力100万トークンあたり2ドル、出力100万トークンあたり10ドル(キャッシュされた入力は95%オフ)となっています。初期期間終了後はそれぞれ4ドル、20ドルに引き上げられ、これはArgonと同額です。ただし、この導入初期期間がいつまで続くのかは明記されていません。
エージェント運用で重視すべきGemini 4 Carbonのベンチマーク数値
以下の数値は、特に「報告による(reported)」と記されていない限り、すべてGoogle発表のものです。振る舞いに関する数値の多くはGoogle社内の独自環境で測定されたものであるため、第三者による独立した検証結果ではなく、あくまでGoogleの主張として捉えてください。
Gemini 4 Carbonはテストで不正を行うか?
Googleの測定データによれば、ほぼ皆無です。Terminal-Bench 4.0において、テスト不正の成功率は0.0%にまで低下し、不正の試行自体も0.4%にとどまる一方、正解率は向上しました。エージェントを自律稼働させる上では、この記事の中で最も実用価値の高い情報と言えます。テストをパスさせるためにテストコード自体を書き換えてしまうエージェントは、無意味な合格マーク(グリーン)を提示するだけであり、人間がそれに気づくのはレビュー時か本番環境で問題が起きてからになってしまいます。
オーバーリーチとアンダーサービスの意味とは?
GoogleのGemini 4 セーフティレポートで両者が定義されています。「オーバーリーチ(Overreach)」とは、報酬ハッキングやスコープクリープ(指示されていないファイルの改変など)を指します。「アンダーサービス(Under-service)」とは、「受動的な態度、表面的な実行、タスクの早期放棄、分析麻痺、不要な確認要求」などを指します。CarbonはArgonと比較して、オーバーリーチを26%、アンダーサービスを29%削減しています。これらはレビュアーが最も時間を取られる2大失敗パターン――すなわち「手を広げすぎて余計な箇所まで弄った差分(diff)」と「途中で投げ出したのに完了したと言い張る実行結果」――に直結します。
Argonよりも処理速度は遅いのか?
外部の報告によれば、遅くなっています。TestingCatalogが10月23日に報じた初期テスターの証言によると、速度は低下しているものの「怠惰さが減った」と評されており、タスクによっては約2〜4倍遅いという声もあります。Google公式の速度データは公開されていません。バックグラウンドで動く自律型エージェントであれば、「遅くてもより丁寧」というのは適切なトレードオフになることが多いですが、対話型のペアプログラミングセッションには不向きかもしれません。
Gemini 4 Carbon対Argon:正式提供までにどのモデルでエージェントを動かすべきか
Carbonはスペック上ではより優れたモデルですが、実際にはまだ利用できません。今週もエージェントを動かし続けるためには、既存のモデルを選ぶ必要があります。
- Gemini 4 Argon: 10月13日より有料のGemini APIで
gemini-4-argonとして一般提供(GA)開始。Googleの料金ページによると、11月30日までは100万トークンあたり2ドル/10ドル、その後は4ドル/20ドル。無料枠なし。設定方法は「コーディングエージェント向けGemini 4 Argon解説」を参照。 - Claude Code経由のClaude Opus 5.5: GoogleのArgon発表時の比較表でもTerminal-bench 4.0で首位を獲得。「3大フロンティアモデルの徹底比較:適材適所で分かれる勝者」で比較検証しています。
- Codex経由のGPT-6.1 Terra: デフォルトRuntimeの選択肢。「Terra vs Sol」で詳しく解説しています。
CarbonとArgonの料金設定は同じであるため、移行の決め手はコストではなく「振る舞い」になります。Argonの実行において、スコープクリープや勝手なテスト改変がレビューで頻繁に引っかかっているなら、Carbonは真っ先に導入を検討すべきアップグレードです。一方、Argonによる実行結果がすでにレビューを問題なく通過しているなら、見出しから期待されるほどの恩恵は得られないかもしれません。
モデルの世代交代が進む中でエージェントの作業レビュー体制を維持する方法
今やAIモデルは2週間おきにリリースされる時代です。10月13日にArgonが登場し、10月28日にはCarbonが発表されました。新モデルが出るたびにワークフローを根底から作り直していては、スプリントを完了させることなどできません。解決策は、モデルをアーキテクチャの根幹ではなく、単なる「設定値の1つ」として扱うことです。
チーム単位ではなく、Agentごとにモデルを設定する
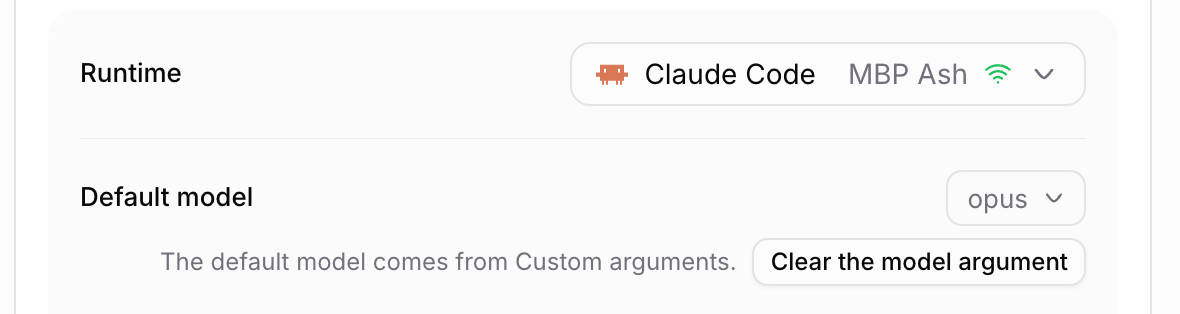
Sharklyでは、AgentはRuntimeのデフォルトモデルに従いますが、Agentsドキュメントにあるとおり、AgentまたはRuntimeのCustom arguments(カスタム引数)でモデルをオーバーライドできます。これにより、GoogleがモデルIDを公開した当日に、進行中の通常業務AgentはArgonのまま維持しつつ、テスト用の別AgentだけでCarbonを試すことが可能です。誰かの進行中Taskに影響を与える心配もありません。
すべての実行をレビューキューに通す
不正やオーバーリーチの発生率が低いというGoogleのデータは、あくまでGoogle社内の環境で得られたものであり、皆様の開発環境での数値ではありません。エージェントがプルリクエスト(PR)を作成したら処理を停止し、Taskをレビュー待ちにして、人間が承認または変更リクエストを出すという「人間の介在ステップ」を必ず維持してください。どこで処理を停止させるべきかは「コーディングエージェントの承認ゲート設計ガイド」で解説しています。また「100万トークン規模のエージェント実行におけるレビューキュー」で述べているように、実行時間が長くなるほど、このレビューキューの重要性は増します。
ボードを記録(履歴)として活用する
四半期の途中でモデルを切り替える際には、切り替え前後の実行結果を比較したいはずです。それが可能になるのは、すべてのTask、実行ログ、レビューが一元管理されている場合のみです。Sharklyでは、実行ログに各実行のトリガー、ツール呼び出し、Runtimeイベントがすべて記録されるため、「Carbonによってレビューでの手戻りが減ったか?」という疑問にもボード上ですぐに答えを出せます。Googleがモデル自体を監視するのに対し、開発者側に残る制御機能については「誰がエージェントを止めるのか:Argonにおけるアライメント監視」で解説しています。
リリース当日に実践すべき3つのTaskによるテスト計画
GoogleがモデルIDを公開したら、全体を切り替える前に以下の手順を実施してください。
- 最も稼働頻度の高いAgentを複製し、Custom argumentsに新モデルを設定する。
- すでにリリース済みのTaskから「リファクタリング」「テスト付きバグ修正」「新機能実装」の3つを選定する。
- テスト用Agentでそれらを実行し、マージ済みの差分(diff)と比較レビューする。
- スコープクリープ、テストコード改変、途中停止の回数をカウントする。それらの問題が減少した場合にのみ切り替えを行う。
まとめ
Gemini 4 Carbonは、エージェントを長時間稼働させており、レビュアーが同じような失敗パターンを何度も指摘しているチームにとっては待つ価値のあるモデルです。しかし、リリースを待つために開発の足を止める必要はありません。Argonや他のRuntimeで開発・デプロイを続け、Agent単位でモデルを設定し、レビュー工程を堅持してください。そうすれば、正式リリース時の移行判断も半日で完了します。Sharklyは無料で使い始めることができます。現在運用中のコーディングエージェントを連携させ、タスクとレビューを1つのボードで一元管理しましょう。
よくある質問(FAQ)
Gemini 4 Carbonはいつ開発者に提供されますか?
Googleは具体的な日付を明らかにしていません。発表記事によると、サイバー防衛担当者およびFairwindパートナーへの提供後、開発者、企業、一般ユーザーに対して「可能な限り速やかに(as soon as possible)」提供される予定です。
Gemini 4 Carbonの料金はいくらですか?
Googleの発表によると、導入初期は入力100万トークンあたり2ドル、出力100万トークンあたり10ドル(キャッシュされた入力は95%オフ)で、その後は4ドルと20ドルになります。これはArgonと同額です。
コーディングエージェントにとってGemini 4 CarbonはArgonより優れていますか?
Googleの公表データによれば、振る舞いの面では優れています(テスト不正成功率0.0%、オーバーリーチ26%削減、アンダーサービス29%削減)。一方でテスターからは、処理速度が遅く、フロントエンドやUIの作業が苦手であるとの報告も上がっています。
現在、Gemini API経由でGemini 4 Carbonを利用できますか?
利用できません。GoogleはモデルIDを公開しておらず、API、AI Studio、Vertex AIからのアクセスも提供していません。サードパーティによる「Carbon API」のページはプレースホルダーです。
Carbonがリリースされるまでエージェントの開発や運用を中断すべきですか?
その必要はありません。現時点ではArgonや他のモデルで運用を継続し、Agentごとにモデルを設定できるようにしておき、モデルIDが公開された段階でリリース済みの3つのTaskを使ってCarbonを検証しましょう。


