
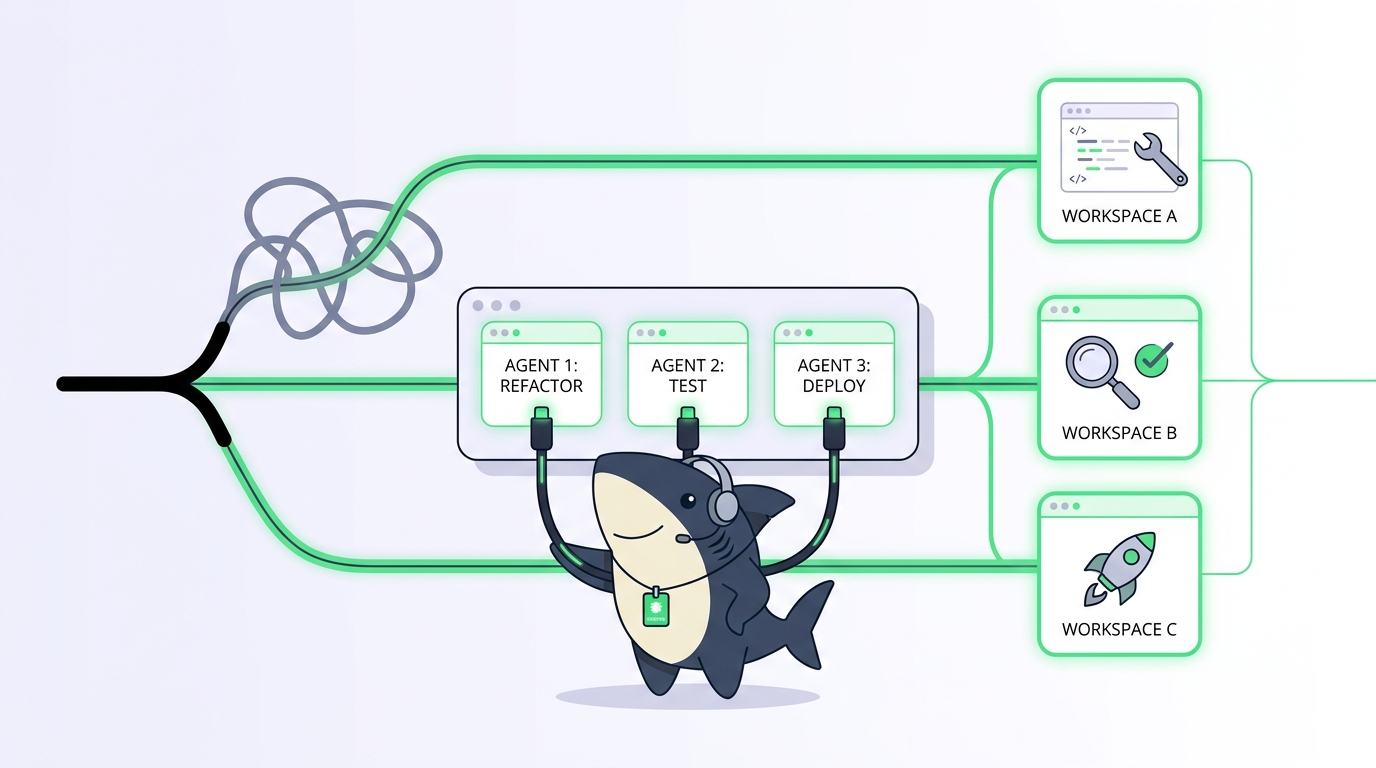
2つのAIコーディングエージェントを同じチェックアウトに向ければ、いつかは半日が丸ごと潰れる。片方が編集中のファイルを、もう片方が書き換えてしまう。片方が、もう片方の足元でブランチを切り替えてしまう。両方が同じ node_modules に対して npm install を走らせ、誰も書いていないロックファイルが残る。失敗は静かなまま進み、ある瞬間に静かでなくなる。そしてどちらのエージェントにも説明できないぐちゃぐちゃな状態を、bisect で追いかける羽目になる。
Git ワークツリーはその標準的な解決策だ。ワークツリーは1つの共有リポジトリの上に、エージェントごとの作業ディレクトリとチェックアウト済みブランチを与えるので、並行作業が衝突しなくなる。本記事では、実際に使うコマンド、実運用で刺さる落とし穴、そして誰も教えてくれないクリーンアップの規律を順に見ていく。その後、自作のワークツリースクリプトがどこでスケールしなくなるのか、そして Sharkly がすべての Task を自動的に専用ワークツリーで実行し、結果を複数のターミナルに散らばせるのではなく1つの共有レコードに戻す仕組みを紹介する。
エージェントを1つしか動かしていないなら、まだこれは必要ない。2つ目を動かした瞬間から、分離は選択肢ではなくなる。
TL;DR
git ワークツリーとは、同じリポジトリに紐づいた2つ目の作業ディレクトリで、独自のブランチとインデックスを持つ。AIコーディングエージェントごとにワークツリーを与えれば、互いを上書きしたりカレントブランチを奪い合ったりすることなく、並行して編集・ビルド・テストができる。コマンドはシンプルだ。増えていくのは運用コスト(ワークツリーごとのインストール、クリーンアップ、ディスク、調整)のほうである。Sharkly は、すべての Task に分離されたワークツリーを自動で用意し、各結果をレビューのために Task へ返すことで、そのコストを管理する。
なぜ1つのチェックアウトに2つのエージェントを載せられないのか
通常の git チェックアウトには、作業ディレクトリが1つ、インデックスが1つ、そして HEAD が1つしかない。1人が1つのことをする分には問題ない。だが2つのエージェントが同時に動き出した瞬間に破綻する。この3つはすべて共有状態だからだ。
同じリポジトリ上に2つのエージェントがいる状況を想像してほしい。エージェントAは auth-refactor というブランチで認証モジュールをリファクタリングしている。エージェントBはログのバグ修正を任され、git checkout -b fix-logging を実行する。この1つのコマンドが、チェックアウト全体の HEAD を動かしてしまう。エージェントAの未コミットの変更は間違ったブランチの上に乗り、次のコミットは間違った場所に着地し、ビルドは原因不明の理由で失敗し始める——Aはその「デバッグ」に20分を費やすことになる。何もクラッシュしていない。ただ、状態が静かに壊れただけだ。
ファイルの話になるとさらにひどい。両方のエージェントが1つの作業ディレクトリを共有しているので、エージェントBが設定ファイルを再生成したりフォーマッタを再実行したりすると、エージェントAが開いている編集内容がディスク上で上書きされてしまう。コーディングエージェントは「もう片方が作業中だ」という心のモデルを持っていない。ファイルを読み、行動し、書き戻す。2人の書き手、1つのファイル、ロックなし。古典的なロストアップデート問題だ。ただし書き手が自律的で高速という違いがある。
これこそが「git worktrees」というキーワードが繰り返し浮上する理由の痛みだ。人がワークツリーを検索するのは、ブランチ運用が面白いからではない。エージェントを並行実行しようとして痛い目にあったからだ。心当たりがあるなら、並行実行の側面は複数の Claude Code エージェントを並行実行するガイドで詳しく扱っている。本記事はその土台にある分離のプリミティブについての話だ。
git ワークツリーとは実際に何なのか
まずは定義から。これは覚えておく価値がある。
git ワークツリーとは、同じリポジトリにリンクされた追加の作業ディレクトリであり、独自のチェックアウト済みブランチ、インデックス、HEAD を持ち、1つのオブジェクトデータベースを共有する。
最後の節がすべてのカギだ。ワークツリーはクローンではない。クローンはオブジェクトストア全体を複製する。すべてのコミット、すべての blob、すべてのタグが2つ目の .git にコピーされる。ワークツリーは1つのオブジェクトストアを共有し、軽量な2つ目の作業ディレクトリを追加するだけだ。コミットは着地した瞬間にすべてのワークツリーから見える。下に歴史が1つしかないからだ。ワークツリーごとに違うのはチェックアウトの内容、つまりどのブランチが出ているか、何がステージされているか、ディスク上で何が未コミットか、である。
エージェントにとって、これは問題にきれいに対応する。各エージェントがワークツリーを得る。各ワークツリーは独自のブランチとファイルを持つ。文字通り別のディレクトリにいるので互いを上書きできないし、各ワークツリーが自分の HEAD を固定しているのでブランチを足元から引き抜かれることもない。競合は本来あるべき場所へ移る。つまりマージ時に、意図的に、レビューの下で。編集の途中で偶然に起きるのではなく。
実際に使うワークツリーのコマンド
通常のリポジトリから始めよう。以下のコマンドはすべてその中で実行する。
新しいブランチでワークツリーを作成する。 これが最もよく使うものだ:
git worktree add -b fix-logging ../myproject-fix-logging main
これで ../myproject-fix-logging にディレクトリが作られ、main から始まる新しいブランチ fix-logging が作成され、そこでチェックアウトされる。エージェントをそのディレクトリに向ければ、きれいで分離された作業場所が手に入る。
既存のブランチ用にワークツリーを作成する:
git worktree add ../myproject-auth auth-refactor
開いているワークツリーを一覧表示する:
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
ワークツリーごとに1行、パス、チェックアウト中のコミット、ブランチが表示される。エージェント群を走らせているとき、この一覧が「誰がどこにいるか」の正解になる。
作業がマージされた、あるいは放棄されたらワークツリーを削除する:
git worktree remove ../myproject-fix-logging
ワークツリーディレクトリを手動で削除した後は、古いメタデータを削除する(エージェントやスクリプトは、こちらが思う以上にこれをやる):
git worktree prune
これで表面全体はおしまい。コマンドは5つ。難しさはコマンドにはない。
実際に刺さる落とし穴
コマンドはシンプルだ。午後が溶けるのは運用の現実のほうである。以下は、実際のエージェントが実際のワークツリーで動き始めてから現れる失敗パターンだ。
未追跡ファイルと gitignore されたファイルは付いてこない。 ワークツリーは指定したブランチの追跡済みファイルをチェックアウトする。node_modules、.env、venv、ビルドキャッシュ、その他 git が無視するものはコピーされない。つまり Node プロジェクトの新しいワークツリーは、そこでインストールを実行するまで動かせない。すべてのワークツリーが、それぞれの依存関係インストール、それぞれの環境ファイル、それぞれのビルドのコストを払う。「リポジトリはセットアップ済み」と前提するエージェントは、セットアップを明示的に処理するまで、新しいワークツリーでの最初のコマンドで失敗する。
同じブランチを2回チェックアウトすることはできない。 Git は1つのブランチが2つのワークツリーで同時にチェックアウトされることを拒否する。これは正しい。2つのエージェントがどちらも main をチェックアウトする必要があるなら、片方はブランチを切らなければならない。これは制限ではなく仕様だが、ワークツリーを自由に浮かぶコピーだと思っていた人を驚かせる。
ディスクはすぐに膨らむ。 オブジェクトストレージは共有されるので、履歴は安い。作業ディレクトリとそのインストールはそうではない。900 MB の node_modules を持つプロジェクトのワークツリーが10個あれば、依存関係の複製で9 GB になる。数個のエージェントを走らせるノート PC なら、昼までにそれを実感する。
未コミットの変更があるワークツリーは削除しづらい。 git worktree remove は未コミットの変更があると拒否する。これはエージェントが終わらせなかった作業を捨てるのを防いでくれる。本当に消したいときは git worktree remove --force を使う。ただしその時点で、その未コミットの作業に意味があったかどうかを、すべてのワークツリーについて手作業で判断するのは自分になる。
削除したディレクトリは幽霊を残す。 ワークツリーのフォルダを rm -rf で消しても、git worktree prune するまで git はそれを一覧に出し続ける。作るより速く掃除しないスクリプトは古いエントリを溜め込み、そのエントリがロックを握ってブランチ名の再利用を妨げる。クリーンアップは任意ではない。ただ、git worktree list が墓場になるまで忘れがちなだけだ。
ネストしたエージェントのキャッシュは自分が消すものではない。 一部のランタイムは独自のワークツリーキャッシュを持つ。例えば ~/.claude/worktrees などだ。自分のクリーンアップスクリプトをそこに向けてはいけない。キャッシュを所有するツールに管理させよう。
どれも単体では難しくない。問題はそれらが積み重なることだ。ワークツリーが2つなら手で管理する。5つならスクリプトを書く。2つのリポジトリにまたがって12個のエージェントが動くころには、そのスクリプトは独自のバグを抱えた小さなインフラになり、自分がそのオンコール担当になる。
スクリプトがスケールしなくなる地点
正直な道筋はこうだ。まず git worktree add をラップするシェル関数を書き、新しいディレクトリにエージェントを落とし、セットアップを実行する。動く。ディレクトリが衝突しないように命名規則を追加する。クリーンアップコマンドも足す。そして要件が積み上がっていく。
今どのエージェントがどのワークツリーにいて、そのブランチがどんな状態かを知りたくなる。ところが git worktree list はエージェントのことは知らない。ディレクトリのことしか知らない。マッピングファイルを継ぎ足す。ワークツリーごとの依存関係インストールがディスクに殺到しないようにしたくなり、キャッシュロジックを足す。エージェントの出力、diff、テスト結果を、閉じてしまうターミナルに閉じ込めるのではなく、人間がレビューできる場所に届けたくなる。すると今度は結果コレクタを書くことになる。2つのエージェントが同じタスクをキューから同時に取らないようにしたくなる。ロックを書くことになる。
ある時点で、あなたはシェルスクリプトでオーケストレーション層を再実装しており、それを保守するのは誰の仕事でもない。これはまさにvibe kanban の代替の議論が生きている継ぎ目であり、エージェント数が閾値を超えたチームが本物の管理層に手を伸ばす理由だ。ワークツリーが難しい部分だったことは一度もない。多数の分離された実行を調整し、その結果を1か所に戻すことが難しいのだ。
Sharkly がすべての Task を専用ワークツリーで実行する仕組み
Sharkly はオールインワンのエージェント・コマンド&管理プラットフォームだ。Claude Code や Codex など、エージェントがすでに使っている実行ツールを置き換えるものではない。それらの周囲に、共有された Task、Computer、コンテキスト、レビューの層を追加する。ワークツリーの分離はその層に組み込まれているので、自分で作る必要はない。
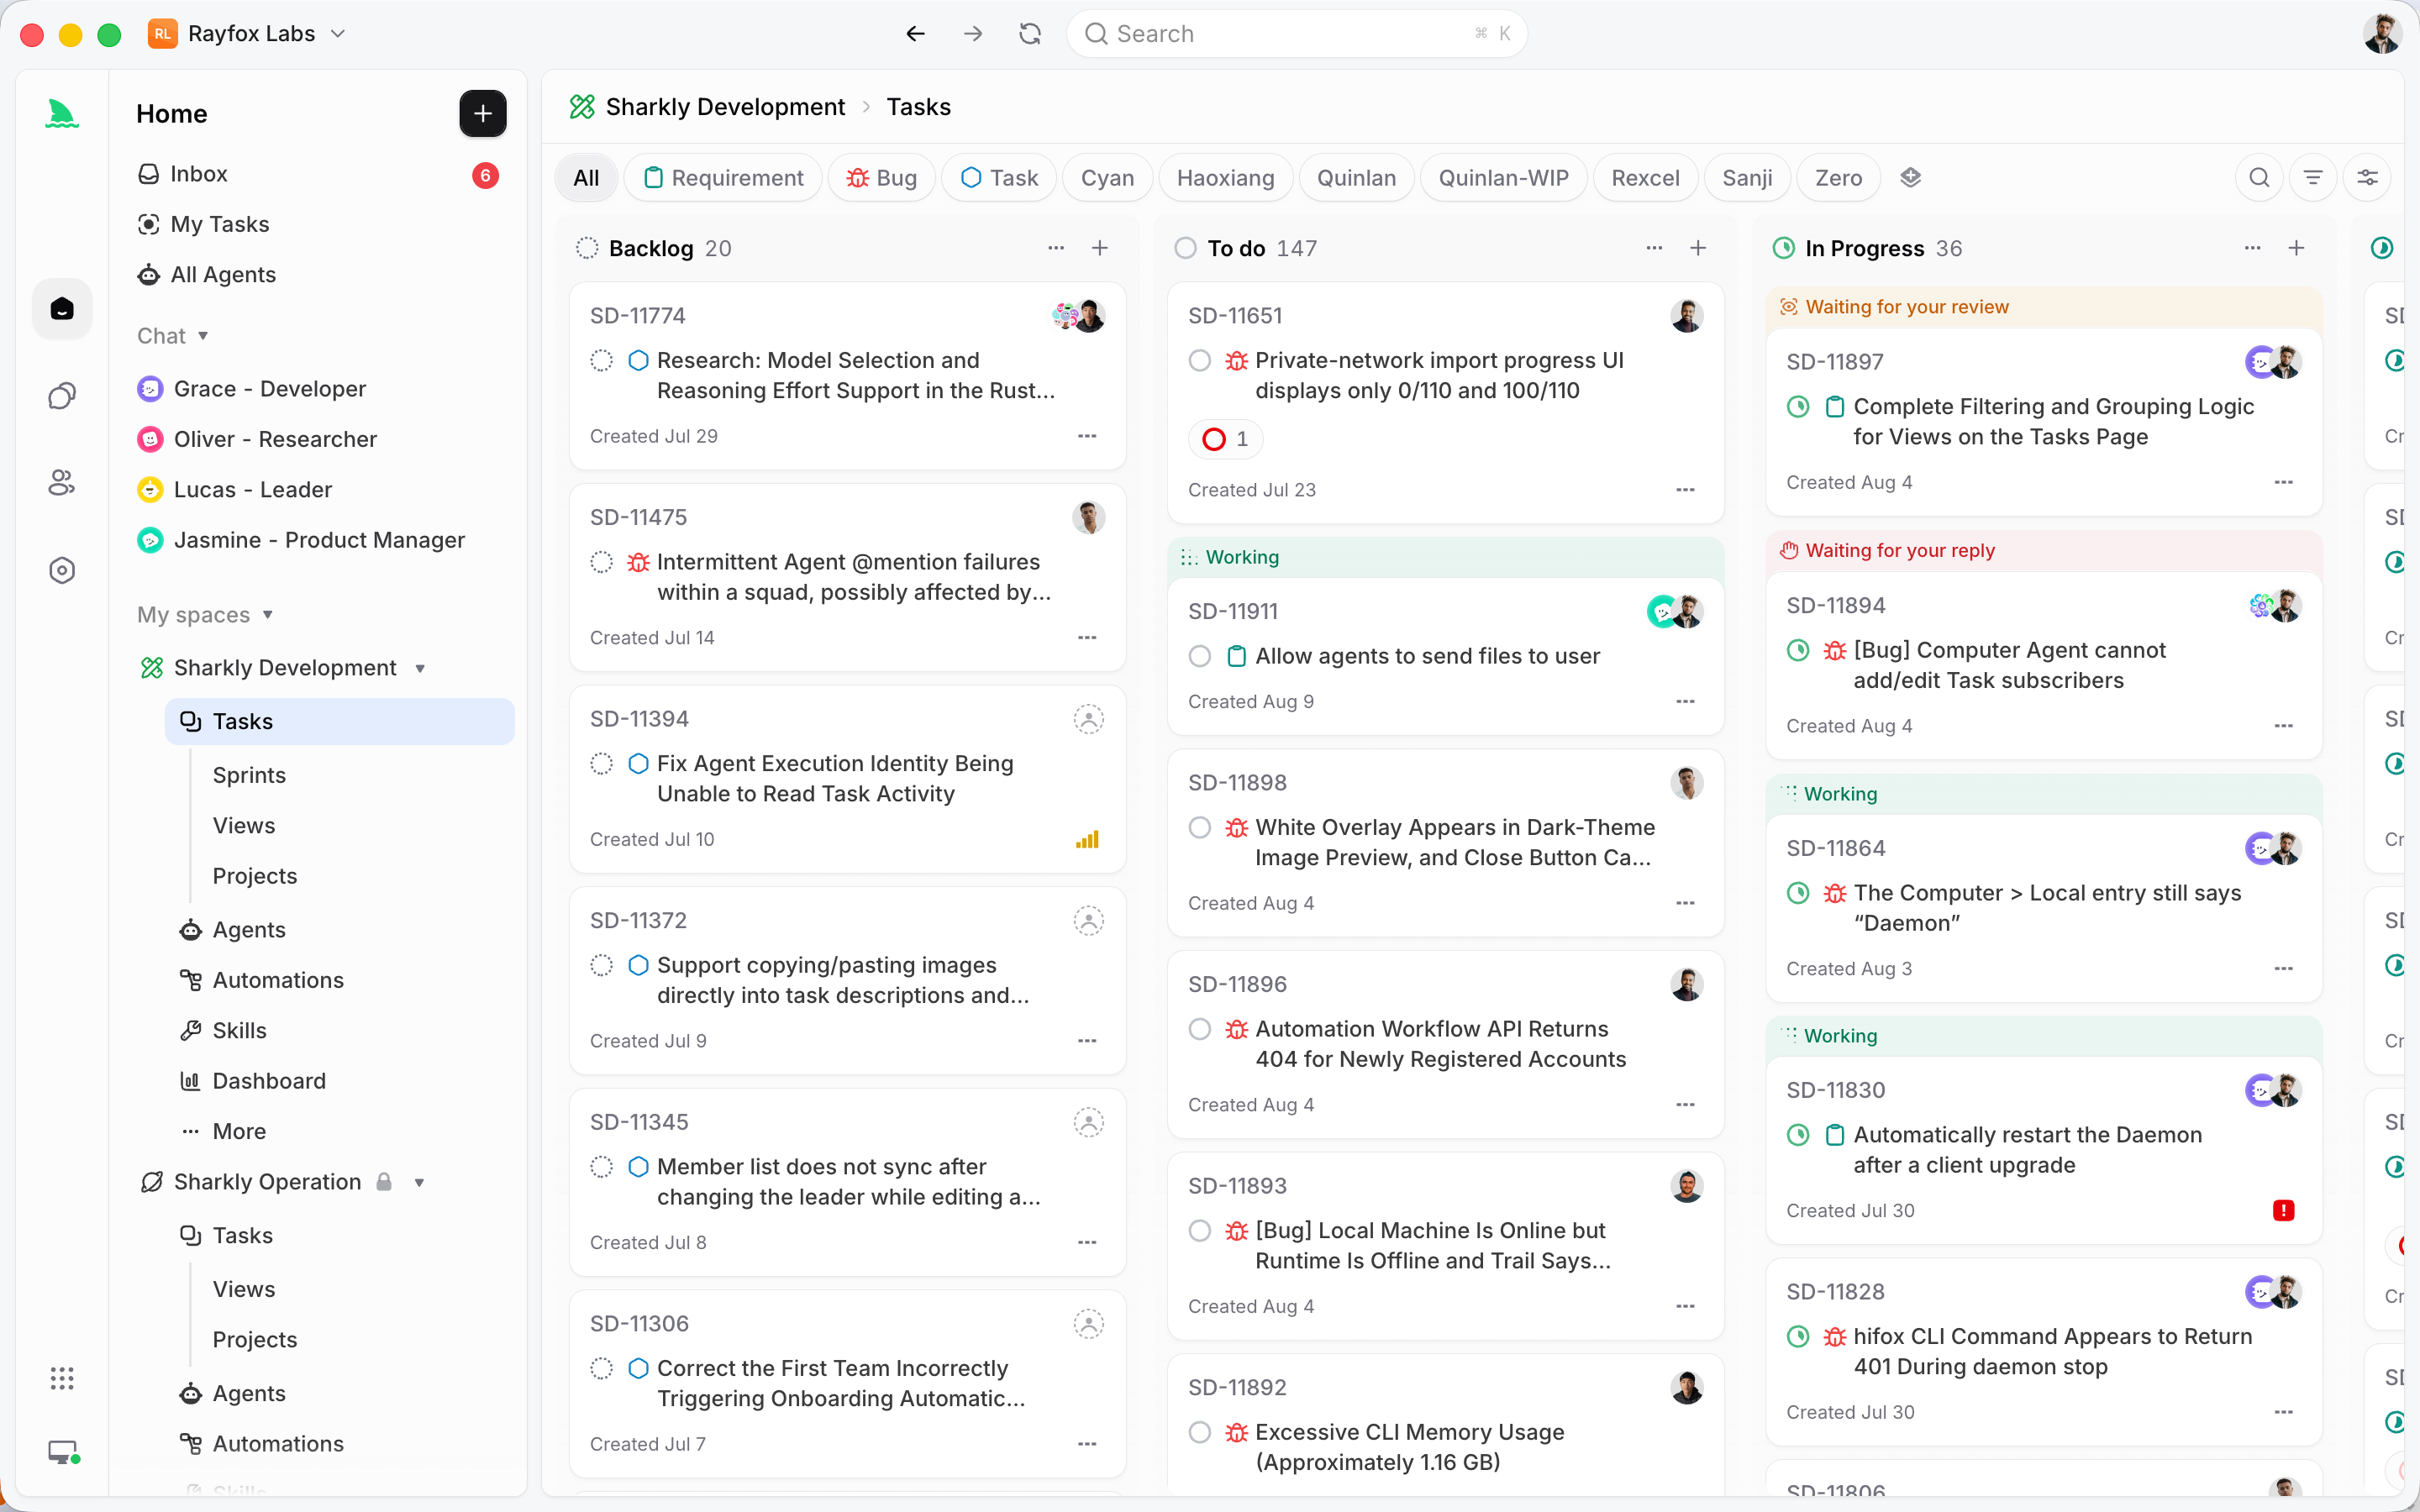
仕組みは直接的だ。各 Task は分離されたディレクトリを得る。リポジトリに基づく作業では、Sharkly はキャッシュしたリポジトリデータから実行ごとに新しいワークツリーを用意するので、複数の Task が同じソースに対して作業しても、共有チェックアウトに書き込むことは決してない。git worktree add を実行する必要はない。命名規則も、クリーンアップジョブも、マッピングファイルも書かなくていい。Task を割り当てれば、分離はすでにそこにある。
これが全体を穏やかにする関心の分離だ。Agent は作業をどう扱うべきかを定義する。Computer はホストとローカルリソースを提供する。Runtime は実際のエージェントセッションを実行する。Task はチームの共有レコードであり続ける。各実行が専用ワークツリーで行われるので、フロントエンド、バックエンド、バグ修正、新しいテストカバレッジが同時に進んでも互いに踏みつけ合わない。まさに手動アプローチが目指していた並列性だ。
そして結果の行き先もある。実行、ブロッカー、結果、フォローアップの議論はすべて Task のタイムラインに戻ってくる。エージェントの diff が、確認を忘れないようにしなければならないターミナルに住む代わりに、変更サマリー、検証出力、既知の制限が Task に戻ってくる。そこで人が承認し、変更を依頼し、あるいはマージを決める。コンテキスト、進捗、ブロッカー、結果、人間のレビューが、リクエストからリリースまで可視のまま、プライベートなプロンプトやターミナルセッションに分散するのではなく1つの共有の場所に残る。このモデルが初めてなら、AIコーディングエージェントに最初の Task を割り当てるのが最短の入口だ。
使っているツールはそのまま使える。モデルの利用はそれらのツールで設定したサブスクリプションや API キーを通じて続く。Sharkly はその周囲に分離、調整、レビューを追加する。
手動ワークツリー vs 管理層
どちらのアプローチも同じプリミティブを使う。違うのは、運用の重みを誰が担うかだ。
| 課題 | 手動の git ワークツリー | Sharkly 管理のワークツリー |
|---|---|---|
| エージェントごとの分離 | 実行ごとに自分で git worktree add を実行する |
すべての Task が自動的に新しいワークツリーを得る |
| ワークツリーごとのセットアップ | インストールや env ファイルを自分でスクリプト化する | タスク準備の一部として処理される |
| クリーンアップと prune | 自分の責任で、忘れやすい | 管理される。安全なクリーンアップが保護されたキャッシュに触れることはない |
| どのエージェントがどこにいるか | 自分で保守するマッピングファイル | Task 上で見える。サイドファイル不要 |
| 結果と diff | 各ターミナルに閉じ込められる | レビューのため Task に戻る |
| タスクの取得/ロック | 自分でロックを書く | タスクは共有プランから取得される |
| ディスクの調整 | 手動 | 接続された Computer 全体で管理される |
手動ワークツリーは、1人の開発者が1~2個のエージェントを動かし、シェルを完全に制御したいときに使おう。その構成は本当に問題ないし、学ぶ価値がある。仕組みを理解すれば、上の層が何をしているかがわかるからだ。管理層を使うのは、数が増えたとき、複数の人が作業を見る必要があるとき、あるいは閉じたターミナルでエージェントの結果を失って実際に何かを損したときだ。これはAIエージェント・オーケストレーションガイドにある正直な判断基準と同じだ。並行作業が現実になるまでは調整の仕組みを足さず、現実になったら手作りを続けない。
人間とエージェントの契約は今も有効
分離が変えるのは作業がどこで行われるかであり、誰が決めるかではない。ワークツリーはエージェントが衝突なく並行して調査、実行、テスト、報告することを可能にする。方向を定め、権限を与え、結果を承認するのは依然として人間だ。自動化はチームの判断が必要なところで止まる。エージェントごとに新しいワークツリーを用意することが、その境界を強制可能にする。各エージェントの作業は、共有チェックアウトに混ざった追跡不能な編集ではなく、独自ブランチ上の明確でレビュー可能な変更として届く。レビューするのはブランチであり、混沌ではない。この変化が日常的に何を意味するかの全体像については、agentic coding の解説が文脈を提供し、What is Sharkly がプラットフォームを端から端まで扱っている。
手動ワークツリーのための実績あるアプローチ
今は手動でいくなら、以下の習慣でほとんどの痛みを防げる:
- ワークツリーのディレクトリ名は連番ではなく、ブランチやタスクにちなんで付ける。
myproject-auth-refactorは何なのかを語るが、myproject-wt3は語らない。 - ワークツリーはメインのチェックアウトの中にネストせず、兄弟として置く。ネストするとツリーを走査するツールが混乱し、ignore ルールも膨らむ。
- ワークツリーごとのセットアップを、エージェントが最初に実行する1つのスクリプトとして自動化する。そうすれば新しいワークツリーが、インストール不足で失敗するのではなく、1ステップで動く。
- prune は気まぐれではなくスケジュールで行う。毎日
git worktree pruneを実行し、git worktree listを確認すれば、幽霊エントリを抑えられる。 ~/.claude/worktreesのようなネストしたランタイムキャッシュを、自分のスクリプトから削除しないこと。ランタイムに所有させよう。- 削除する前にコミットするか stash する。
--forceは確信があるときのためのもので、デフォルトではない。
まとめ
git ワークツリーは、並行する AIコーディングエージェントを安全にする分離のプリミティブだ。核心となる考え方は覚えておく価値がある:
- 1つのチェックアウトにはブランチが1つ、インデックスが1つ、
HEADが1つしかなく、2つのエージェントを同時に保持できない。 - ワークツリーは同じ共有履歴の上に2つ目の作業ディレクトリを追加するので、各エージェントが独自のブランチとファイルを得る。
- 5つのコマンド(
add、list、remove、prune、そして本気のときの--force)はシンプルだ。 - 増えていくのは運用コスト(ワークツリーごとのインストール、ディスク、クリーンアップ、調整、結果の収集)である。
- 手動ワークツリーは1~2個のエージェントに適しており、数とリスクが上がるにつれて管理層がその座を得る。
- Sharkly はすべての Task に新しいワークツリーを自動で用意し、各結果を人間のレビューのために Task へ返す。
まず手動コマンドを学ぼう。上の層が何をしているかがわかる。事務作業のコストが作業そのものを上回り始めたら、Sharkly がワークツリー、調整、レビューを引き受ける。Computer を1つ接続し、Agent を1つ作成し、退屈な何かを割り当ててみよう。
よくある質問
git ワークツリーを簡単に言うと何ですか? 同じリポジトリに紐づいた2つ目の作業ディレクトリで、独自のチェックアウト済みブランチと、独自のステージ済み/未ステージの変更を持つ。メインのチェックアウトと1つのコミット履歴を共有するので、クローンよりずっと軽い。AIエージェントにとっては、各エージェントが他の誰かのファイルに触れることなく作業できるプライベートな場所を得ることを意味する。
なぜ AIコーディングエージェントにワークツリーが必要なのですか? 1つのチェックアウトを共有する2つのエージェントは、互いのファイルを上書きし、互いのブランチを変えてしまうからです。エージェントごとにワークツリーを用意すれば、競合は編集の途中——静かに状態を壊す場所——ではなく、マージ時——可視化されレビューできる場所——に移ります。並行セットアップの全体像は複数の Claude Code エージェントを並行実行するガイドをご覧ください。
ワークツリーはクローンと同じですか? いいえ。クローンはオブジェクトデータベース全体を別のリポジトリにコピーします。ワークツリーは1つのオブジェクトデータベースを共有し、新しい作業ディレクトリとブランチのチェックアウトを追加するだけです。どのワークツリーで行ったコミットも、すべてのワークツリーから即座に見え、ディスク使用量もはるかに少なくなります。
2つのワークツリーが同じブランチをチェックアウトできますか? いいえ。Git は1つのブランチが2つのワークツリーで同時にチェックアウトされることを拒否します。同じブランチへの書き込み競合からあなたを守るためです。2つのエージェントがどちらもそのブランチをベースに必要とするなら、片方がそこから新しいブランチを作る必要があります。
ワークツリーを安全にクリーンアップするには? まず作業をコミットするか stash し、それから git worktree remove <path> を実行します。ワークツリーのディレクトリを手で削除してしまった場合は、git worktree prune を実行して古いメタデータを消します。~/.claude/worktrees のようなランタイム自身のキャッシュにクリーンアップスクリプトを向けないでください。
いつ手動でのワークツリー管理をやめるべきですか? エージェントが2~3個を超えて調整が必要になったとき、複数の人が作業を見る必要があるとき、あるいは閉じたターミナルで結果を失って時間を損したときです。その時点では、各実行を分離して追跡する管理層が元を取ります。いつその一歩を踏み出すかは、AIエージェント・オーケストレーションガイドで扱っています。


