要約: AIエージェントに「声」を与えるには、OpenAIのGPT-Live-1.1を音声フロントエンドとしてその手前に置き、実際の作業はすでに運用しているエージェントに任せます。GPT-Liveは話しながら聞き取りができ、デリゲーションを通じて推論やツール呼び出しをバックエンドに委譲します。クライアントデリゲーションモードでは、アプリが各ハンドオフを受け取り、Sharkly AutomationをWebhook経由で起動し、その結果を音声で返します。
GPT-Live-1.1とは?
GPT-Live-1.1は、OpenAIの多言語会話向け全二重音声モデルです。話しながら聞き取れるため、人は同僚を遮るのと同じように割り込むことができます。v1/live/sessionsエンドポイント上で動作し、関数呼び出しとストリーミングをサポートし、推論やツールの使用をバックエンドのエージェントに委譲できます。
OpenAIのGPT-Live-1.1モデルページによると、GPT-Live-1よりも正確に音声を文字起こしでき、言語が変わってもアクセントや声の一貫性が保たれます。入出力は音声とテキストで、画像は直接受け付けません。
エージェントチームにとって重要なのはデリゲーションです。音声モデルは会話するために作られており、20分かかるリファクタリングを実行するためのものではありません。その作業を別の何かに委譲し、待っている間も会話を続けます。
すでにチームが共有ボードでコーディングエージェントに作業を割り当てているなら、Sharklyがその「別の何か」になれます。このガイドの残りでは、その接続方法を説明します。
なぜ音声エージェントにはバックエンドチームが必要なのか
音声インターフェースには厳しいレイテンシの制約があります。人は1秒程度以内に応答があることを期待し、それを超える沈黙は壊れていると感じます。しかし、実際のエージェント作業はその時間には収まりません。リポジトリの読み込み、テストの実行、キューのトリアージには数分かかります。
そのため、すべて自分でやろうとする音声エージェントは、2つのうちどちらかの形で失敗します。速いけれど浅い答えを返すか、考え込んで沈黙するかです。会議に向かいながら「昨晩のエージェント実行は通ったのか?」と知りたいとき、どちらも役に立ちません。
解決策は、テキストですでに使っているかもしれない分割です。会話を処理する高速なフロントエンドと、作業を行う低速なバックエンドです。GPT-Liveはこの分割をAPIに組み込んでいます。エージェント間・エージェントと人間のハンドオフに関する記事をお読みであれば、これはマイクを付けた同じパターンだと分かるでしょう。
GPT-Liveのデリゲーションの仕組み
GPT-Liveには2つのデリゲーションモードがあり、セッション作成時に選択します。モードを切り替えるには、新しいセッションを開始します。
| Responsesデリゲーション | クライアントデリゲーション | |
|---|---|---|
| バックエンドを実行するのは誰か | OpenAI(Responses API経由) | あなたのアプリケーション |
| 設定 | delegation.type: "responses" に加えて model、instructions、tools |
delegation.type: "client" |
| バックエンドモデル | 設定したモデル(例:gpt-6-luna) |
呼び出せるものなら何でも |
| 結果の返し方 | 自動で処理される | session.commentary.append または session.thinking.append |
| 向いているケース | OpenAIが実行できるルックアップやツール呼び出し | 自社システム内にある作業 |
Responsesデリゲーションは最短経路です。バックエンドモデルを指定すると、OpenAIがリストしたツールとともにそのモデルを実行します。デリゲーションガイドでは、まずgpt-6-lunaから始め、より複雑なバックエンドタスクにはgpt-6-solを試すことが提案されています。
クライアントデリゲーションは、すでに運用しているエージェント向けの経路です。音声モデルが助けを必要だと判断すると、アプリはデリゲーションIDを含むsession.delegation.createdイベントを受け取ります。このイベントにはユーザーの発言が含まれないため、アプリはトランスクリプトイベントと自身の状態からリクエストを再構築します。作業が完了したら、同じデリゲーションIDで結果を送り返すと、GPT-Liveがそれを音声で言い換えて伝えます。
パターン:GPT-Liveが話し、エージェントチームが働く
Sharklyの上に音声フロントエンドを構築する場合の構成は次のとおりです。Sharklyはコーディングエージェント(Claude Code、Codex、Gemini CLIなど)の上位層として、作業の割り当て、接続されたコンピュータでの実行、レビューを担います。音声モデルはリポジトリに直接触れることはありません。作業を依頼するだけで、ボードがそれを記録します。
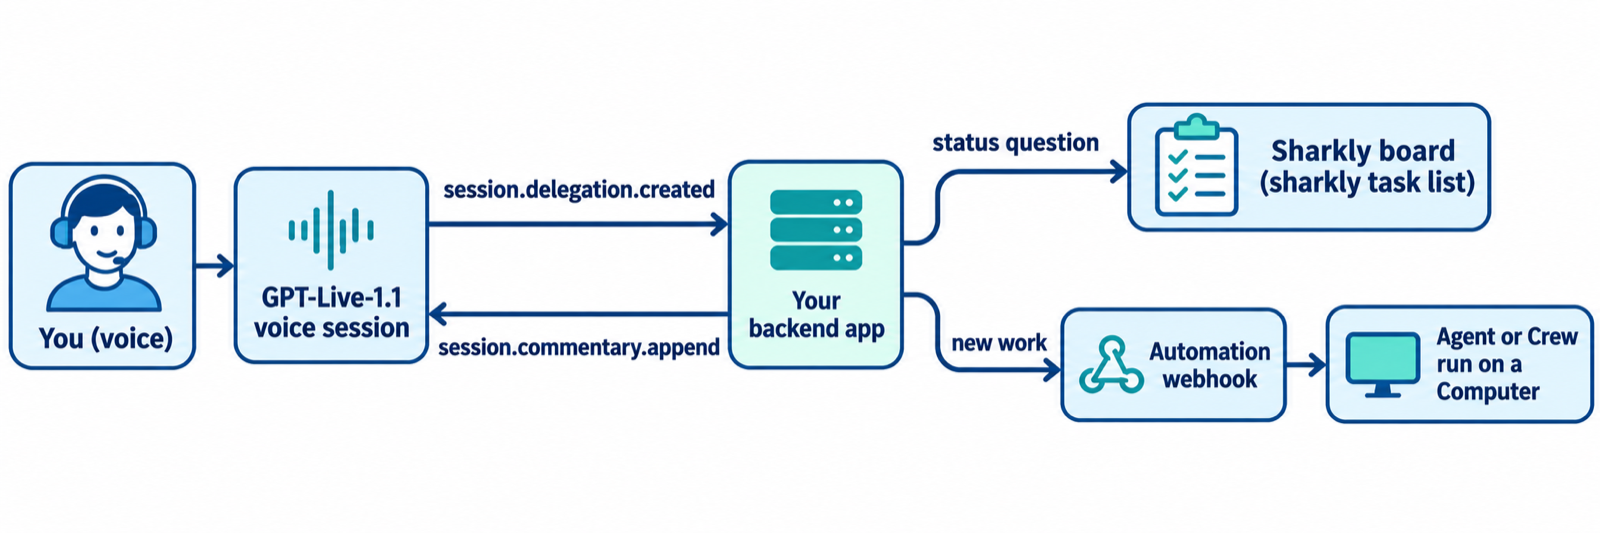
3種類のリクエストを用意すれば、エージェントチームへの音声エージェントへの依頼のほとんどをカバーできます:
- ステータス確認(「夜間テストは通った?」)。バックエンドが
sharklyCLIでボードを読み取り、数秒で答えます。 - 新しい作業(「不安定なログインテストをエージェントに見させよう」)。バックエンドがSharkly AutomationのWebhookを呼び出し、AgentまたはCrewが実行を開始します。
- 意思決定(「マージして」)。バックエンドは拒否し、どこでレビューすべきかを伝えます。音声は変更の承認に適した場所ではありません。
この3つ目のルールは、どちらかの製品の制限ではなく設計上の選択です。口頭での「はい」は聞き間違えやすく、監査も困難です。承認は証拠がある場所に留めるべきで、その詳細はhuman-in-the-loopなコーディングエージェントのガイドで解説しています。
AIエージェントに声を与える:ステップバイステップのセットアップ
ステップ1:AutomationとそのWebhookトリガーを作成する
SharklyにおけるAutomationとは、繰り返し可能なAgentやCrewの作業(指示、担当者、トリガー、実行履歴)をSpace単位で定義したものです。Webhookトリガーを作成すると、外部サービスからのPOSTリクエストを受け付ける秘密のURLが生成されます。Automationsドキュメントには、完全なURLはトリガーの作成時または再生成時に一度だけ表示されるため、すぐにシークレットとして保存するよう記載されています。
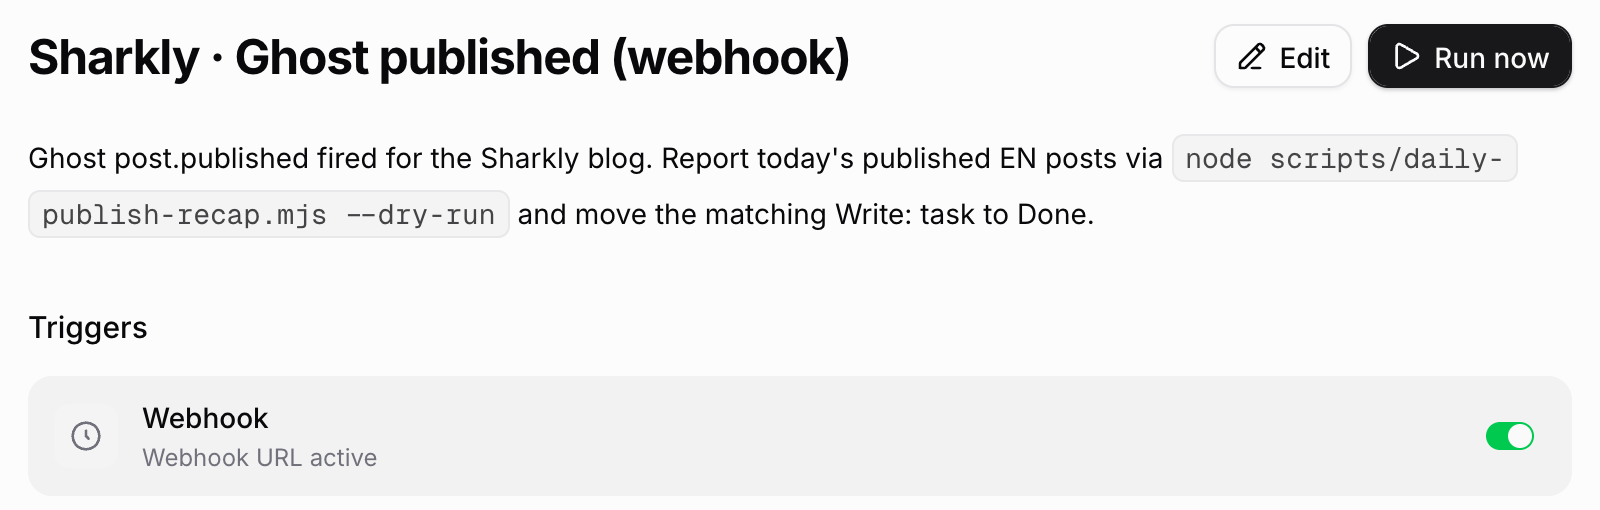
指示は、トリガーペイロードからリクエストを読み取り、その結果をタスクコメントとして記録するように書きます。何を変更してよいか、いつ人の判断が必要かを明示します。その後、音声トラフィックを接続する前にRun nowでAgentとそのコンピュータをテストします。SharklyのAutomationsに関するウォークスルーでは、その他のトリガー種別も紹介しています。
ステップ2:クライアントモードでGPT-Liveセッションを作成する
セッション設定では音声モデルを指定し、クライアントデリゲーションを有効にします。acknowledgement_delay_msの設定により、GPT-Liveが汎用の応答を話す前に、アプリが独自の更新を送る時間を確保できます。
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAIはブラウザ、モバイル、サーバーアプリでの音声にWebRTCを推奨しており、WebSocketsもサポートされた代替手段です。接続のセットアップについてはGPT-Liveスタートガイドを参照してください。
ステップ3:各デリゲーションをSharklyへルーティングする
session.delegation.createdが届いたら、デリゲーションIDを保存し、トランスクリプトからリクエストを再構築して、どの経路で処理するかを判断します。次のNodeのスケッチでは、新しい作業はAutomationのWebhookに送り、ステータス確認はボードから回答します。
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
音声での返答が何を約束しているかに注目してください。作業が完了したのではなく、「実行を開始した」ことしか言っていません。OpenAIのガイドも予約について同じことを指摘しています。結果は、アクションが成功した後にのみ送るべきです。
ステップ4:結果は耳ではなくボードで確認する
エージェントの実行には数分かかり、作業が終わる前に音声セッションが終わることもあります。だからこそ、記録はボードにあります。Agentはタスクに結果を投稿し、実行履歴にはトリガーペイロードと出力が表示され、人がそこでレビューします。次に「あの不安定なテストどうなった?」と尋ねれば、ステータス経路がその結果を読み上げてくれます。
事前に計画すべきコストと制限
| 項目 | GPT-Live-1.1(OpenAIドキュメント、2026-11-20) |
|---|---|
| エンドポイント | v1/live/sessions |
| アクティブセッション | 1分あたり$0.05 |
| スタンバイ | 1分あたり$0.02(推論が一時停止中のWebRTCセッション) |
| 課金 | 時間に応じて。OpenAIの料金ページではGPT-Liveは秒単位で課金 |
| 同時セッション数 | GPT-Live-1とは別の制限。組織の制限ページを参照 |
| バックエンド呼び出し | 設定したモデルの通常料金で課金 |
バックエンド呼び出しを除けば、10分のスタンドアップチェックインはアクティブレートで$0.50の音声コストがかかります。参考までに、GPT-Live-1モデルページでは、Build・Launch・Growティアで同時セッション数が50、300、500と記載され、Freeティアでは利用できません。GPT-Live-1.1には独自の制限があります。
Sharkly側のエージェント実行は、各ランタイムに紐づくClaude Code、Codex、またはAPIプランに対して課金されます。Sharklyはトークンを販売していません。ステータス確認を安価なバックエンドモデルにルーティングするなら、SharklyでGPT-6 Lunaエージェントを実行するに関するノートがそのまま役立ちます。
初日から追加すべきガードレール
- 割り込んでも作業はキャンセルされない。 OpenAIのガイドによれば、会話に割り込んでもバックエンドの作業は止まりません。「やっぱりやめて」と言われても、バックエンドがそれを処理しない限り実行は続きます。
- Webhook URLはパスワードとして扱う。 Sharklyのドキュメントでは、デフォルトでベアラーシークレットとして扱うよう説明されています。署名シークレットを追加し、漏洩した場合はURLを再生成してください。
- Automationの範囲を限定する。 Sharklyドキュメントの助言どおり、観測可能で元に戻せる作業から始め、範囲を広げる前に複数回の実行をレビューしましょう。
- CrewのデリゲーションはSharkly内に留める。 1つのリクエストに複数のエージェントが必要な場合は、WebhookをSharkly Crewに向け、リーダーに作業を分割させましょう。
音声フロントエンドが不適切なツールである場合
リクエストの内容を理解するためにdiff、ログ、スクリーンショットが必要な場合は、音声を使うのをやめましょう。音声では失敗したテストを見せられません。署名が必要なものにも音声は不向きです。承認、デプロイ、アクセス変更は、証拠のあるタスク上で行うべきです。
音声が力を発揮するのは、素早いステータス確認、明確に定義された実行の開始、手がふさがっている瞬間です。エージェントボードの「リモコン」と考えてください。ボードの代替ではありません。
まとめ
GPT-Live-1.1は、音声エージェントの中で自分で構築するのが難しい部分、つまり割り込み可能な全二重会話を担います。それ以外のすべてはデリゲーションでバックエンドに委ねられます。既存のエージェントチームをそのバックエンドに置けば、実行状況を口頭で尋ねたり新しい実行を開始したりでき、すべての結果は人がレビューするボードに残ります。
次のステップ:SharklyでWebhookトリガー付きのAutomationを1つ作成し、Run nowでテストした後、クライアントモードのGPT-Liveセッションから接続します。Sharklyドキュメントでは、Agents、Computers、Automationsについて詳しく解説しています。
FAQ
AIエージェントに声を与えるには?
GPT-Live-1.1のような音声モデルをエージェントの手前に置き、デリゲーションさせます。音声モデルが聞き取りと発話を担当し、バックエンドがエージェントを実行して、音声モデルが読み上げる短い結果を返します。
GPT-Live-1.1はAPIで利用できますか?
はい。OpenAIはgpt-live-1.1をv1/live/sessionsエンドポイント、関数呼び出し、ストリーミング対応で公開しています。v1/realtimeやv1/responsesは直接サポートしていません。
GPT-Live-1.1の料金は?
OpenAIによると、アクティブセッションは1分あたり$0.05、スタンバイは1分あたり$0.02です。デリゲーション経由のバックエンドモデルの呼び出しは、それぞれの通常料金で別途課金されます。
Responsesデリゲーションとクライアントデリゲーションの違いは?
Responsesデリゲーションでは、OpenAIが設定したバックエンドモデルを実行します。クライアントデリゲーションでは、アプリが各リクエストを受け取り、session.commentary.appendやsession.thinking.appendで結果を返します。
GPT-Live-1.1はコーディングエージェントを直接実行できますか?
いいえ。デリゲーションします。バックエンドが何を実行するかを判断します。たとえば、Sharkly AutomationのWebhookを呼び出して、接続されたコンピュータ上でAgentやCrewの実行を開始します。
タスクの途中で音声エージェントに割り込むとどうなりますか?
会話は停止しますが、バックエンドの作業は止まりません。キャンセルはバックエンドで処理してください。たとえば実行を一時停止する、タスクにコメントするなどです。