

要約: GPT-6.2 の料金は、Astra が入力100万トークンあたり8ドル、出力100万トークンあたり40ドル、Sol がそれぞれ2ドルと10ドルです。キャッシュ済み入力の読み取りは0.40ドルと0.10ドル。プロンプトキャッシュが機能した場合、20ターンのエージェントタスクの試算例では、Astra で約3.23ドル、Sol で約0.81ドルとなり、キャッシュなしの場合はその4倍かかります。
OpenAI は2026年11月17日に GPT-6.2 Astra と GPT-6.2 Sol をリリースしました。Astra は最も難しい作業を担うフロンティアモデルです。Sol は日常業務向けのモデルで、モデルページには「大規模なエージェント運用のために構築された」と記載されています。
100万トークンあたりの料金だけでは、エージェントチームが実際にいくら支払うのかはわかりません。エージェントは毎ターンコンテキストを再送するため、請求額はキャッシュ、コンテキスト長、同時に実行するエージェントの数によって変わります。このガイドでは、GPT-6.2 の料金表をタスクごと・月ごとの金額に換算し、コストを予測可能に保つための上限設定についても解説します。すでにコーディングエージェントを並列で運用しているなら、エージェントごとに上限を設定できるのが Sharkly です。
GPT-6.2 Astra と Sol の料金
以下は、Astra のモデルページと Sol のモデルページに掲載されている標準 API 料金表です(2026年11月20日時点で確認)。すべての価格は100万トークンあたりの金額です。
| 100万トークンあたりの価格 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 入力 | $8.00 | $2.00 |
| キャッシュ済み入力(読み取り) | $0.40 | $0.10 |
| キャッシュ書き込み(30分保持) | $10.00 | $2.50 |
| キャッシュ書き込み(12時間保持) | $20.00 | $5.00 |
| 出力 | $40.00 | $10.00 |
| コンテキストウィンドウ | 1,050,000 | 1,050,000 |
Sol はすべての項目で Astra のちょうど4分の1の価格です。両モデルはコンテキストウィンドウもレート制限も共通しているため、請求額を分けるのは価格です。
合計額を左右する料金ルール
モデルページに記載されている5つのルールが、基本料金よりもエージェントの請求額に大きな影響を与えます:
- 長文コンテキストの追加料金。 入力トークンが272K を超えるリクエストは、リクエスト全体に対して入力とキャッシュが2倍、出力が1.5倍の料金になります。
- キャッシュ書き込みは追加料金。 プレフィックスをキャッシュに書き込む場合、30分保持は通常入力の1.25倍、12時間保持は2.5倍かかります。
- キャッシュ読み取りは低価格。 GPT-6.2 では、OpenAI のプロンプトキャッシングガイドによると、キャッシュ読み取りは通常入力の0.05倍です。
- Batch は標準料金の50%。
- 高速処理は割高。 Fast モードは標準レートの2倍です。Ultrafast は2027年2月28日まで3倍、2027年3月1日からは6倍です。
GPT-6.2 は Flex 処理をサポートしていません。その代わりとなるのが割引適用のバックグラウンド補完ウィンドウで、後述します。
GPT-6.2 でのエージェントタスク1件あたりのコスト
ここでは試算用のコーディングタスクを1件考えます:20ターン、1ターンあたり入力60,000トークン、出力2,000トークン。タスク全体では入力120万トークン、出力40,000トークンになります。実際の数値は異なるはずなので、ご自身の値に置き換えてください。
| シナリオ | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| キャッシュヒットなし | $11.20 | $2.80 |
| キャッシュヒット率90% | $3.23 | $0.81 |
| キャッシュヒット率90%+8時間バックグラウンドウィンドウ | $1.94 | $0.49 |
キャッシュありの行は、入力の90%がキャッシュから読み取られ、残りの10%が30分保持のキャッシュ書き込みとして課金される場合の計算です。これは悲観的なケースなので、実際のキャッシュありの実行ではこれらの数値以下に収まるはずです。
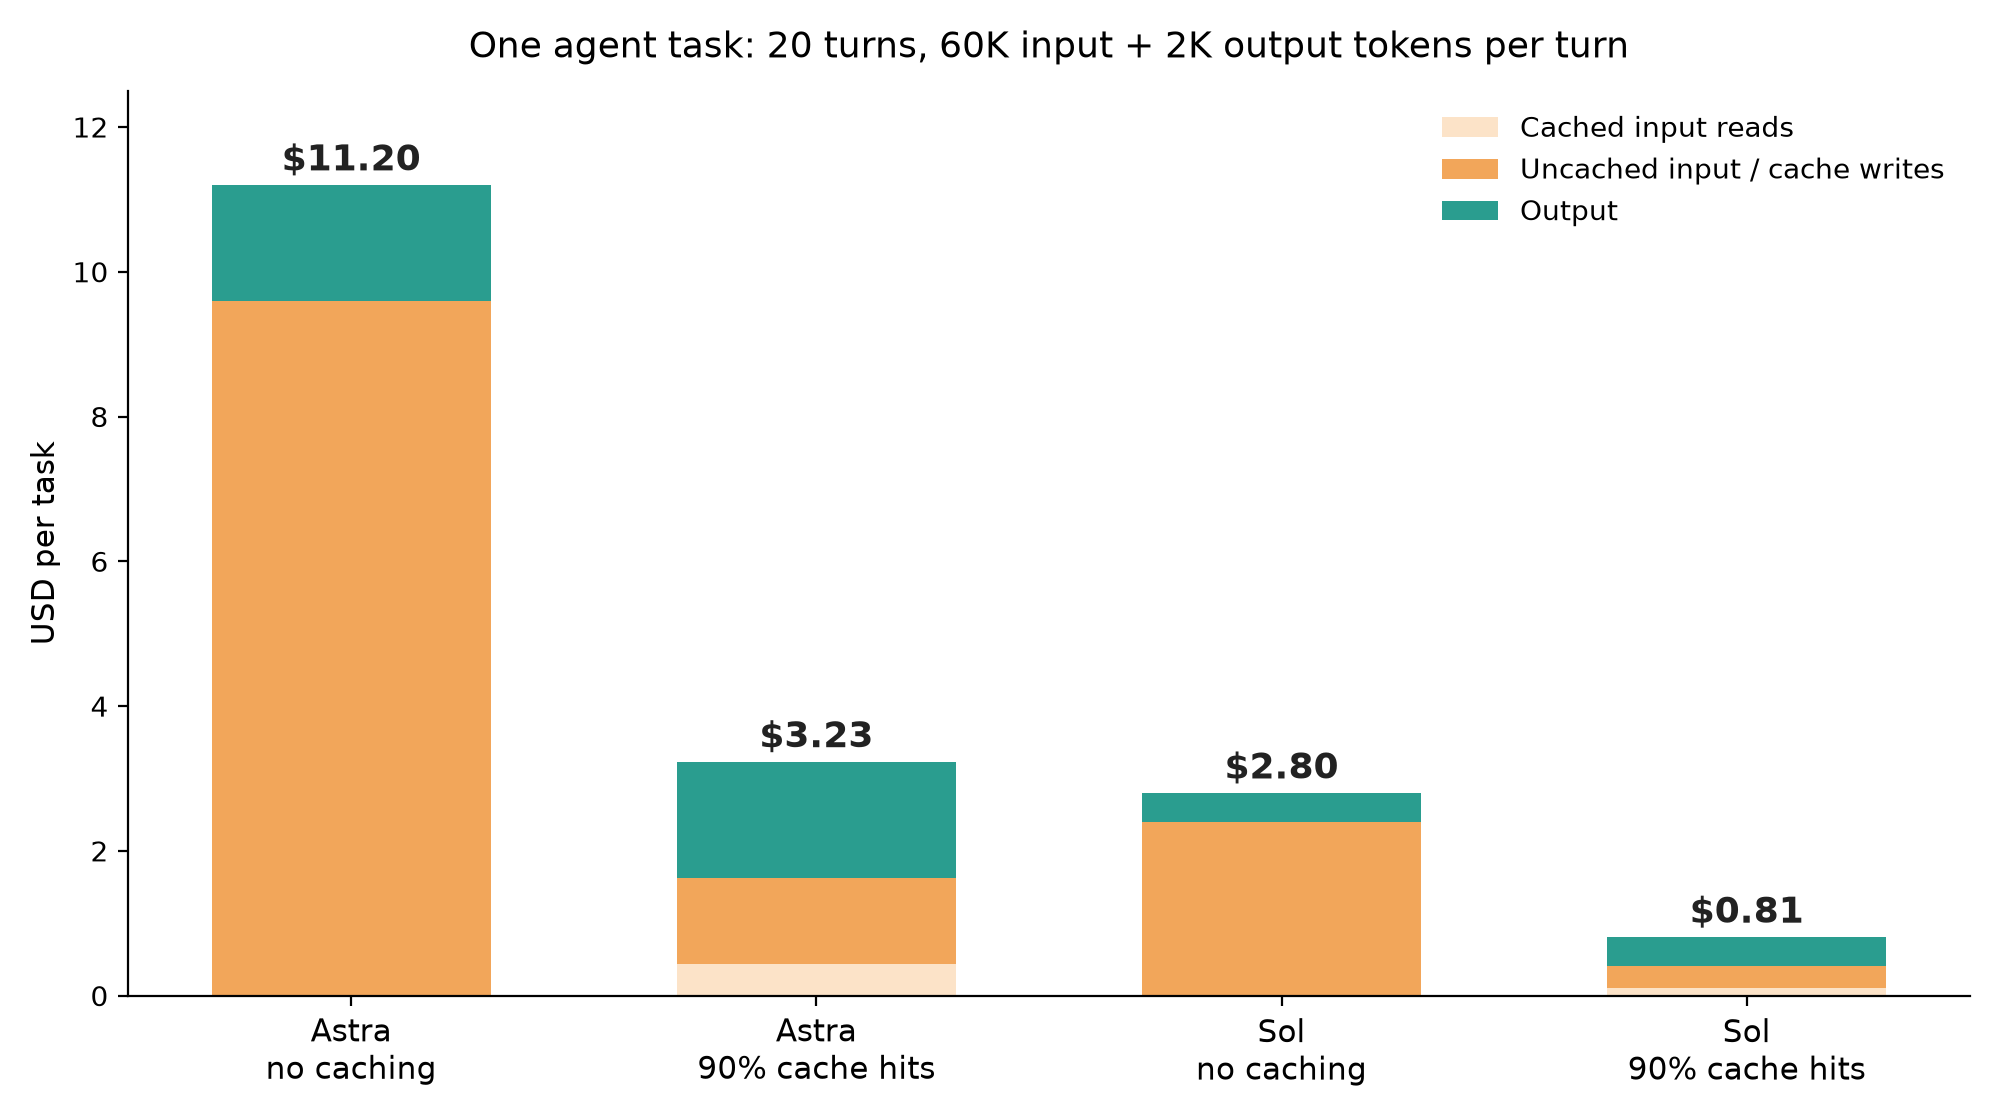
注目すべき数字が2つあります。まず、キャッシュによって両モデルともタスクコストが約71%削減されます。そして、キャッシュが機能した Astra のタスクは、キャッシュなしの Sol のタスクとほぼ同額です。キャッシュが壊れた安いモデルは、キャッシュが正常に動作している高いモデルとほぼ同じコストになるのです。
長文コンテキスト追加料金が効いてくるポイント
リポジトリの半分を読み込むようなコーディングエージェントは、1ターンで272K を超える入力トークンに達することがあります。出力2,000トークン、キャッシュなしという同じ条件の Sol の2ターンを比較してみましょう:
- 入力270,000トークン: 入力0.54ドル+出力0.02ドル、合計0.56ドル。
- 入力300,000トークン: 入力1.20ドル+出力0.03ドル、合計1.23ドル。
コンテキストが11%大きくなっただけで、コストは2倍以上になります。エージェントのハーネスがコンテキストを圧縮する場合は、272K 未満に保ちましょう。同じ考え方は、安いモデルがかえって高くつく理由に関する記事でも扱っています。重要なのはトークン単価ではなく、変更1件あたりのコストです。
エージェントチームの GPT-6.2 月額コスト
次に、キャッシュありの数値を規模拡大してみます。5人のエージェントがそれぞれ1日8件のタスクを22営業日で完了するとします。月に880件のタスクです。
| チーム構成 | 月間タスク数 | 月間モデルコスト |
|---|---|---|
| 5エージェントすべて Astra | 880 | $2,842 |
| リーダー1名 Astra+エージェント4名 Sol | 176 + 704 | $1,139 |
| 5エージェントすべて Sol | 880 | $713 |
混合構成は全員 Astra に比べて60%のコスト削減になります。フロンティアモデルは計画や難しいレビューに担当させ、定型作業は Sol に任せるのです。リーダー役についてはGPT-6 Astra をクルーのリーダーにするで、同じ考え方に基づく同じ予算でエージェントを増やす GPT-6 Sol の活用についても解説しています。
価格は一つの上限にすぎません。低い使用ティアでは、金銭よりもトークン毎分制限の方が先にエージェントチームの足かせになります。これについてはGPT-6.2 レート制限ガイドでティアごとに詳しく説明しています。
Codex プランと API キーの比較
エージェントが ChatGPT プランで Codex を実行している場合、トークン単位では支払いません。使用枠を消費します。Codex の料金ページによると、5時間のウィンドウあたり、GPT-6.2 Astra は Plus と Standard Business で6〜50件のローカルメッセージ、Sol は17〜180件と見積もられています。長いセッションは使用枠を早く消費するため、上記のトークン計算はどのタスクが先に枠を使い切るかの予測として依然有用です。
両モデルのセットアップについては、GPT-6.2 Codex ガイドを参照してください。
エージェントチームの GPT-6.2 コスト削減方法
以下の順序は、削減効果の大きいものから並べています:
- キャッシュを確実に機能させる。 安定した指示を入力の冒頭の
developerメッセージに置き、以前のターンを書き換えないこと。プレフィックスが変わるとキャッシュミスになります。 - デフォルトは Sol。 Astra への昇格は、タスクが複数のサービスにまたがるときや、Sol が同じ種類のタスクに2回連続で失敗したときだけにします。
- リクエストあたりの入力トークンを272K 未満に抑える。
- 自前のハーネスから API を呼ぶ場合は、大量処理をバックグラウンドウィンドウに投入する。
- Batch は評価やオフライン処理に使用し、対話型エージェントには決して使わない。
- Fast と Ultrafast は誰かが結果を待っている場合を除きオフのままにする。
Flex に代わる割引バックグラウンドウィンドウ
OpenAI のバックグラウンドモードガイドでは、Responses API 向けに2つの割引補完ウィンドウが GPT-6.2 のパブリックベータとして紹介されています:標準より30%安い 2h と、40%安い 8h です。これらは Batch のレート制限を共有し、リアルタイムのトークン制限とは別物です。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
後からレスポンス ID をポーリングするか、ウェブフックを使います。これはテスト生成、依存関係のアップデート、ドキュメント整備など、朝までに誰も結果を必要としない作業に向いています。
Sharkly でエージェントごとの GPT-6.2 支出を管理する
Sharkly はトークンを再販しません。各実行は Runtime に紐づけられた Codex プランまたは API キーに対して課金されるため、OpenAI の請求書が唯一の信頼できる情報源のままです。Sharkly が提供するのは、その請求書にどれだけの作業を流すかをコントロールする仕組みです。
各エージェントには、その Runtime が報告するモデルを一覧表示する デフォルトモデルの行があります。定型作業のエージェントは Sol に、リーダーエージェントは Astra に設定しましょう。特定のタスクでより高性能なモデルが必要な場合は、Sharkly のドキュメントに記載されているタスクごとのオーバーライドが使えます:担当者ピッカーでエージェントにカーソルを合わせ、その実行のみに適用するモデルを選択してください。
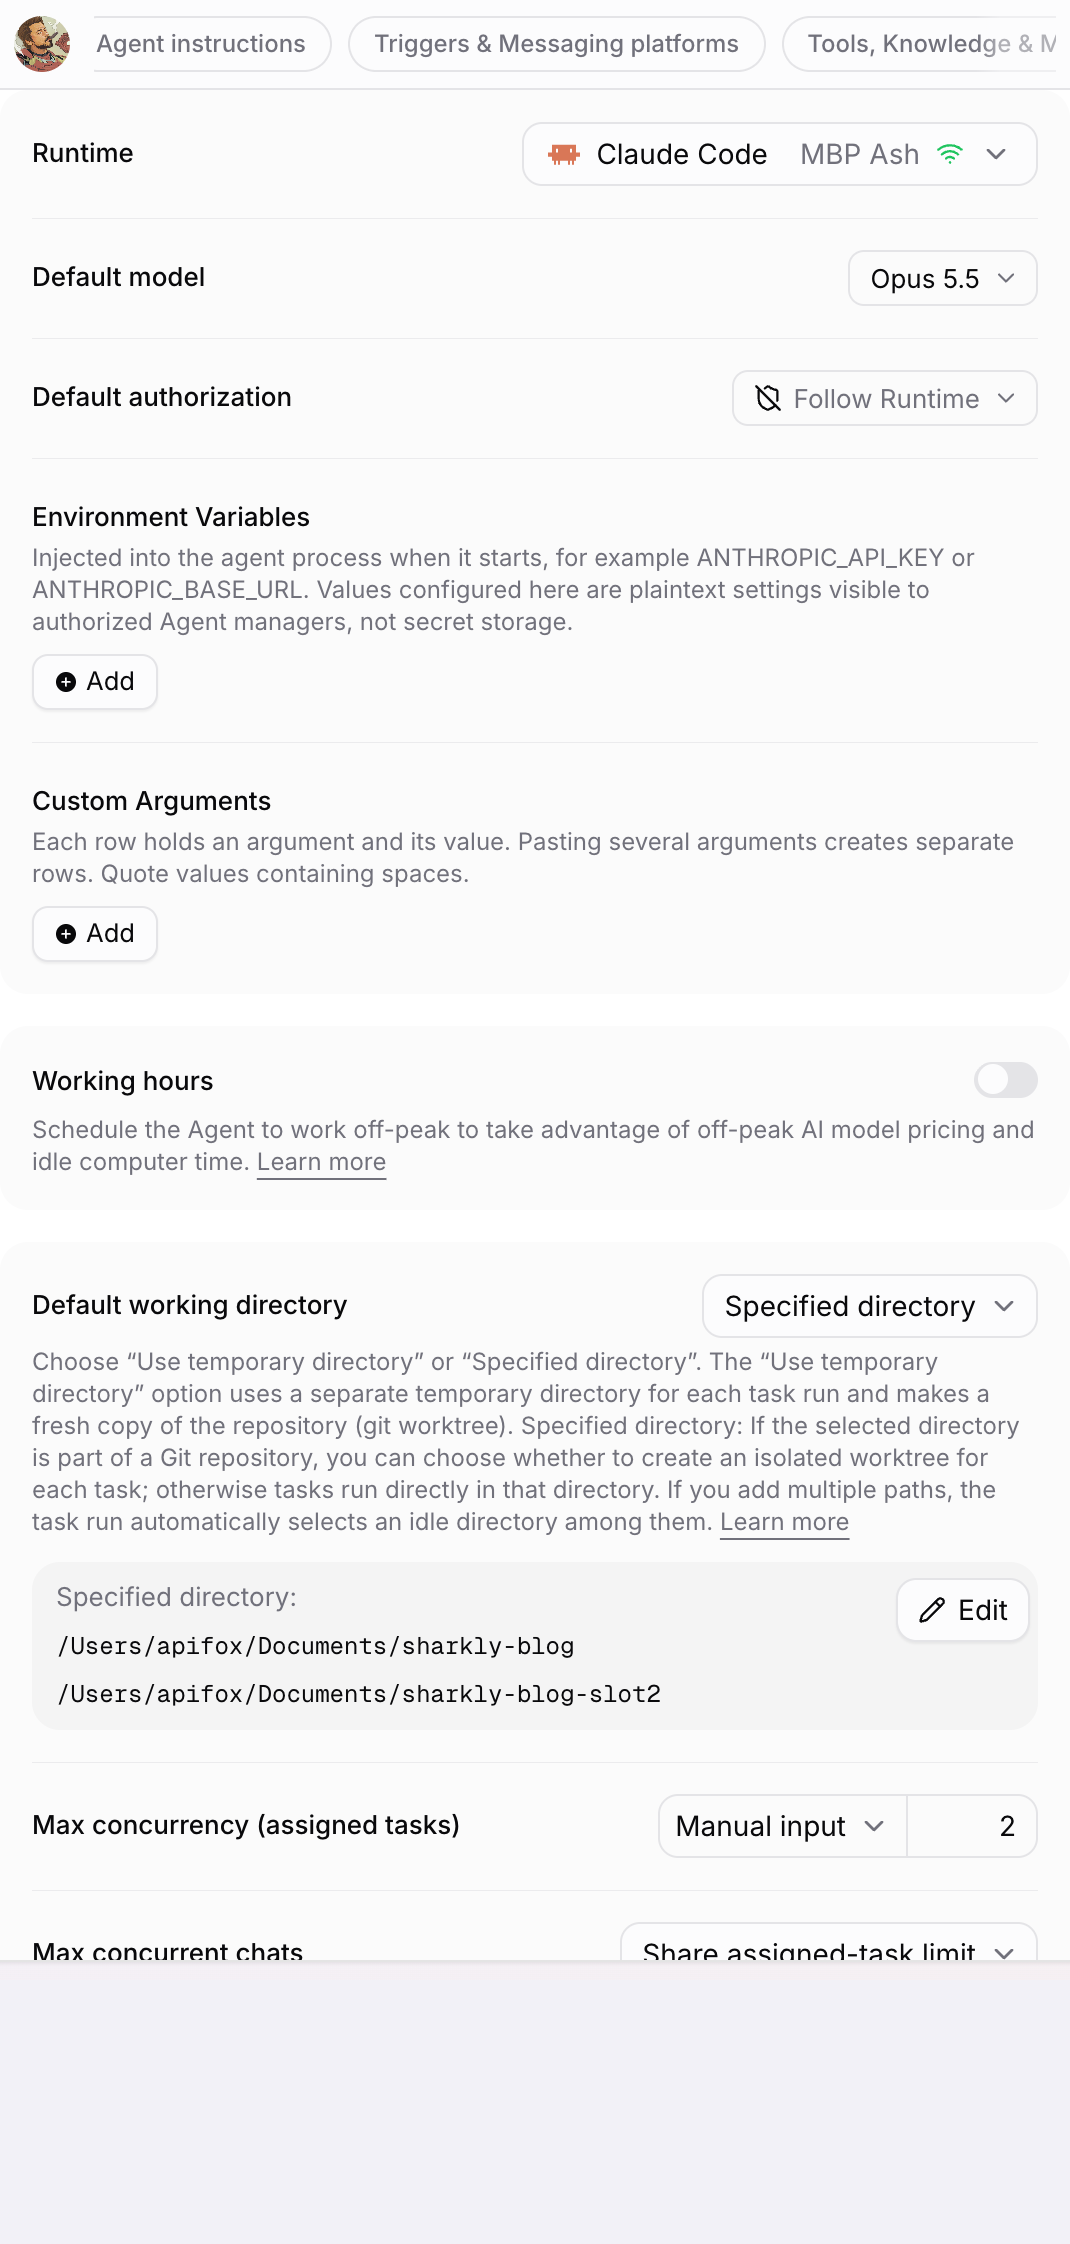
同じパネルには環境変数もあり、エージェントプロセスの起動時に注入されます。エージェントグループごとに、それぞれ独自の OpenAI プロジェクトの API キーを割り当てれば、OpenAI の使用状況ページでグループ別に支出を分割表示できます。稼働時間を使えば、エージェントをオフピークの時間帯にスケジュールでき、大量タスクは夜間に実行し、日中の処理能力は待っている人向けに確保できます。
支出には上限も必要です。最大同時実行数はエージェントが同時に実行できるタスク数を制限し、最大実行時間は無限ループに陥った実行を停止させ、キューのタイムアウトは待ちすぎた作業を破棄します。
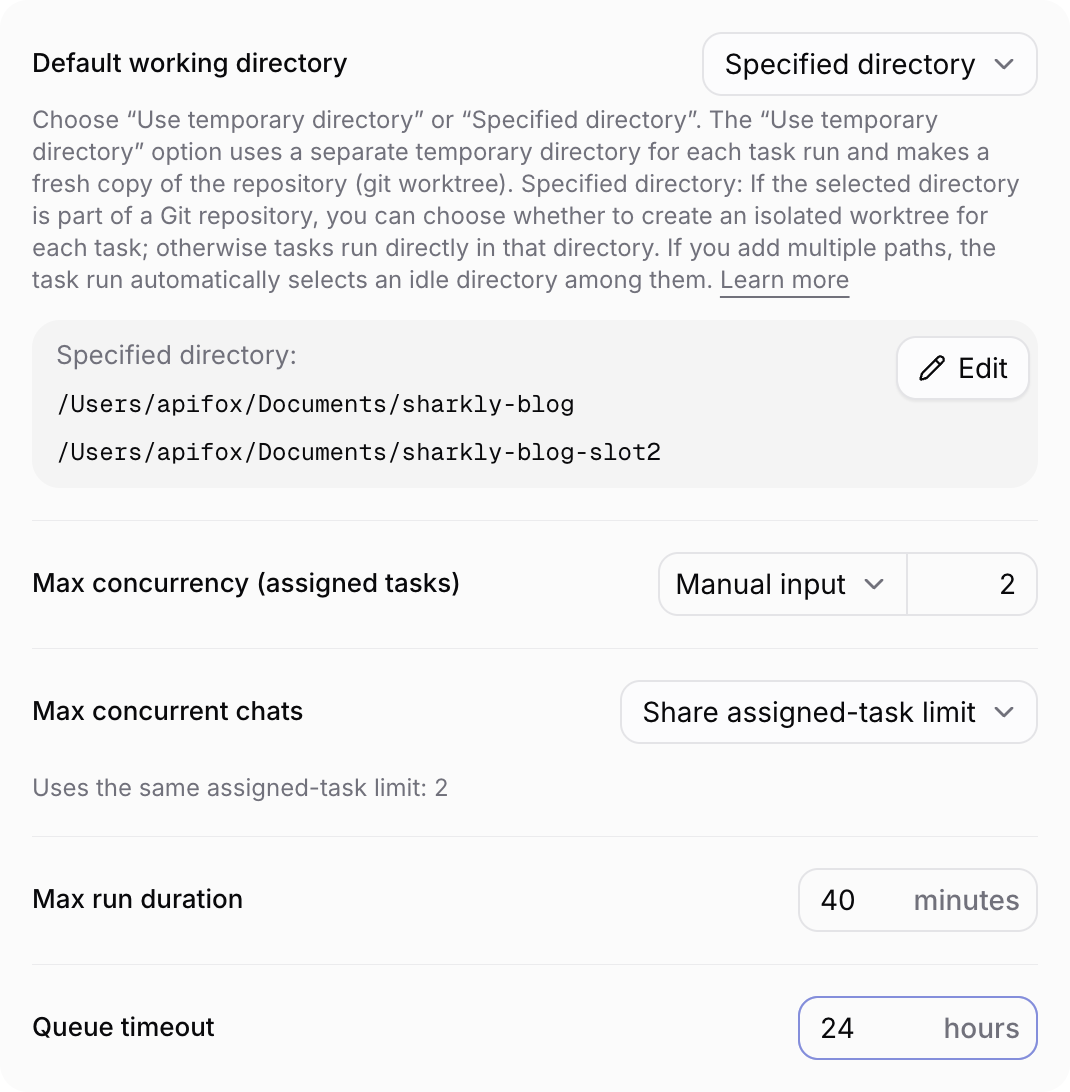
Sol エージェントに40分の実行時間上限を設ければ、最悪のケースに上限が設定されます。各エージェントの実行リストには各実行が消費したトークンが表示されるため、他の3倍のトークンを消費するタスクの種類を見つけられます。そのタスクには、より具体的な説明か、より安価なモデルが必要です。
まとめ
GPT-6.2 の料金体系はシンプルに見えます。すべての項目で Astra は Sol の4倍です。しかしエージェントの請求額はそう単純ではありません。キャッシュはタスクコストを約71%動かし、272K のしきい値は1ターンのコストを倍増させることがあり、同時実行数はそのすべてを掛け算します。実際のタスクを1件計測し、キャッシュヒット率を上げ、定型作業は Sol に任せ、同時実行に上限を設けましょう。
まず1台のエージェントで試してみてください。Computer を接続し、GPT-6.2 Sol で Codex エージェントを作成し、最大同時実行数を2、最大実行時間を40分に設定して、定型タスクを1件割り当てます。そして実行のトークン消費を確認しましょう。チームを並列で運用する詳細については、10個の AI コーディングエージェントを同時に実行する方法をご覧ください。
FAQ
GPT-6.2 の料金はいくらですか?
GPT-6.2 Astra は入力100万トークンあたり8ドル、出力100万トークンあたり40ドルです。GPT-6.2 Sol は2ドルと10ドルです。キャッシュ済み入力の読み取りは、Astra で0.40ドル、Sol で0.10ドルです。
GPT-6.2 Sol は Astra より安いですか?
はい。Sol は入力、出力、キャッシュ読み取り、キャッシュ書き込みのすべてで Astra の4分の1の価格です。両モデルとも105万トークンのコンテキストウィンドウと同じレート制限を共有しています。
GPT-6.2 の長文コンテキスト料金とは何ですか?
入力トークンが272K を超えるリクエストは、しきい値を超えたトークン部分だけでなく、リクエスト全体に対して入力とキャッシュが2倍、出力が1.5倍の料金になります。
GPT-6.2 は Flex 処理をサポートしていますか?
いいえ。OpenAI は長時間実行の作業について、代わりに割引適用のバックグラウンド補完ウィンドウを案内しています:標準より30%オフの 2h と40%オフの 8h で、パブリックベータとして提供されています。
GPT-6.2 Batch の料金はいくらですか?
Batch は両モデルとも標準料金の50%です。評価やオフライン処理には向いていますが、対話型エージェントには適していません。
Sharkly は GPT-6.2 のトークンに対して課金しますか?
いいえ。Sharkly は既にお使いのコーディングエージェントを実行するものであり、モデルの使用料はご自身の Codex プランまたは API キーに対して課金されます。Sharkly は各エージェントがどのモデルを使うか、そして同時にいくつのタスクを実行するかをコントロールします。


