
GPT-6.1 TerraとGPT-6.1 Solの比較は、ひとつのトレードオフに集約されます。TerraはトークンあたりのコストがSolのちょうど半分で、OpenAIによると3倍以上高速に動作します。一方で、サードパーティのコーディングエージェントベンチマークでは、Terraのスコア48に対してSolは54を記録しています。OpenAIは10月26日に、SolとGPT-6 Lunaの間の新たな中間層モデルとして、Terra(gpt-6.1-terra)をリリースしました。
コーディングエージェントを1つだけ運用しているなら、信頼できるモデルを選べば十分でしょう。しかし、十数個も運用する場合は、例外よりもデフォルト設定のほうがはるかに重要になります。エージェントが実行するステップの大半が、デフォルト設定に従って課金されるためです。本記事では、SharklyのCrew向けルーティングルールを紹介します。メンバーにはTerraをデフォルトとして割り当て、リーダーと難易度の高いタスク(ハードテール)にはSolを適用する構成とともに、各組み合わせにおけるエージェント1,000ステップあたりのコストを解説します。
要約(TL;DR)
日常的なコーディング、ドキュメント作成、コンピューター操作を行うCrewメンバーのデフォルト実行モデルにはGPT-6.1 Terraを設定しましょう。一方、Crewリーダーや、Terraで2回失敗したタスクにはGPT-6.1 Solを割り当てます。本稿で想定したステップ構成の試算では、エージェント1,000ステップあたりのコストは、すべてSolにした場合で26.55ドル、すべてTerraにした場合で13.28ドル、Solリーダーの下でTerraメンバーを運用した場合で14.60ドルとなります。Terraを優先し、必要に応じてSolへエスカレーションするルールを採用すれば、タスクの半数がエスカレーションしない限り、すべてSolで運用するよりも低コストに抑えられます。
GPT-6.1 TerraとGPT-6.1 Solの概要比較
| GPT-6.1 Terra | GPT-6.1 Sol | |
|---|---|---|
| API id | gpt-6.1-terra |
gpt-6.1-sol |
| 100万トークンあたりの入力 / キャッシュ / 出力 | $1 / $0.05 / $5 | $2 / $0.10 / $10 |
| Coding Agent Index(Artificial Analysis) | 48 | 54 |
| 処理速度(OpenAI公表値) | 平均3倍以上高速 | ベースライン |
| 最小effortレベル | none |
low |
| OpenAIによる位置づけ | コンピューター操作、文章作成、視覚理解 | 最も複雑なコーディング |
どの価格設定を見ても、きれいに半額となっています。そのためコスト面での判断はシンプルであり、真の焦点は品質に移ります。すなわち、Terraのコーディングスコアの低さが、どの程度の頻度でタスクの再実行につながるのかという点です。
長時間のループを繰り返すエージェントの場合、Terraの料金体系に関するいくつかの詳細を押さえておく必要があります。BatchおよびFlexは定価の半額、Fastモードは2倍の料金になります。また、入力トークンが27万2,000(272K)を超えるリクエストの場合、リクエスト全体に対して入力およびキャッシュの料金が2倍、出力料金が1.5倍で請求されます。料金体系の詳細はOpenAIの料金ページをご覧ください。
デフォルトランタイムが左右するもの
デフォルトランタイムモデルとは、個別の実行時にモデルが明示的に指定されなかった場合にエージェントが使用するモデルのことです。Crewにおいては、この設定が大半のステップのコスト、キューに入ったタスクの待ち時間、そして1日あたりにレビュー待ちとなる成果物の数を左右します。
ここで言うエージェントステップとは、エージェントループ内での1回のモデル呼び出しを指します。具体的には、コンテキストを読み込み、思考し、ツール呼び出しや編集を出力する一連の処理です。1つのタスクで数十ステップを要することもあります。タスクの長さは状況によって大きく変動しますが、1ステップあたりの規模感はほぼ一定であるため、ランタイムを比較する際はタスク単位よりもステップ単位で計算するほうが実用的です。
エージェント1,000ステップあたりのコスト
モデルの組み合わせを比較するために、標準的な1ステップの条件を設定します。入力トークン3万(30K)、そのうち85%がプロンプトキャッシュにヒットし、推論(reasoning)を含む出力トークンが1,500という想定です。長時間のループ処理では、毎ステップ同じリポジトリのコンテキストを再送信するため、セッションが温まれば高いキャッシュヒット率になるのが一般的です。
APIキーによる通常従量課金の場合、上記の1ステップにかかるコストはTerraで0.0133ドル、Solで0.0266ドルとなります。これを1,000ステップに換算すると以下のようになります。
| Crewの構成 | Solのステップ比率 | 1,000ステップあたりのコスト |
|---|---|---|
| すべてSol | 100% | $26.55 |
| メンバー:Terra / リーダー:Sol | 10% | $14.60 |
| メンバー:Terra / リーダーおよびハードテール:Sol | 25% | $16.59 |
| すべてTerra | 0% | $13.28 |
| すべてTerra(高effort設定・出力3,000トークン) | 0% | $20.78 |
ここから2つの注目すべき点が読み取れます。第1に、リーダーをSolに変更しても、すべてTerraで構成した場合に比べて1,000ステップあたり約1.30ドルの増加にとどまる点です。リーダーの役割は計画立案と委任であるため、全体のステップ数に占める割合が小さいからです。第2に、Terraのeffort設定を引き上げても、デフォルト設定のSolよりコストが低く抑えられる点です。Terraで出力トークン数を2倍に増やしても、モデルを切り替えるより安く済みます。
なお、これらの数値にはキャッシュ書き込み料金は含まれていません。ComputerがAPIキーではなくChatGPTプランでログインしている場合、コスト削減は金額ではなく、プラン上限に達するまでに実行できる回数の増加として現れます。OpenAIによると、Terraは「ChatGPT WorkおよびCodexにおいて、すべてのPlus、Pro、Enterprise、Eduユーザーが利用可能」であり、FreeプランおよびGoプランには含まれていません。
Sharkly Crewにおけるルーティングルール
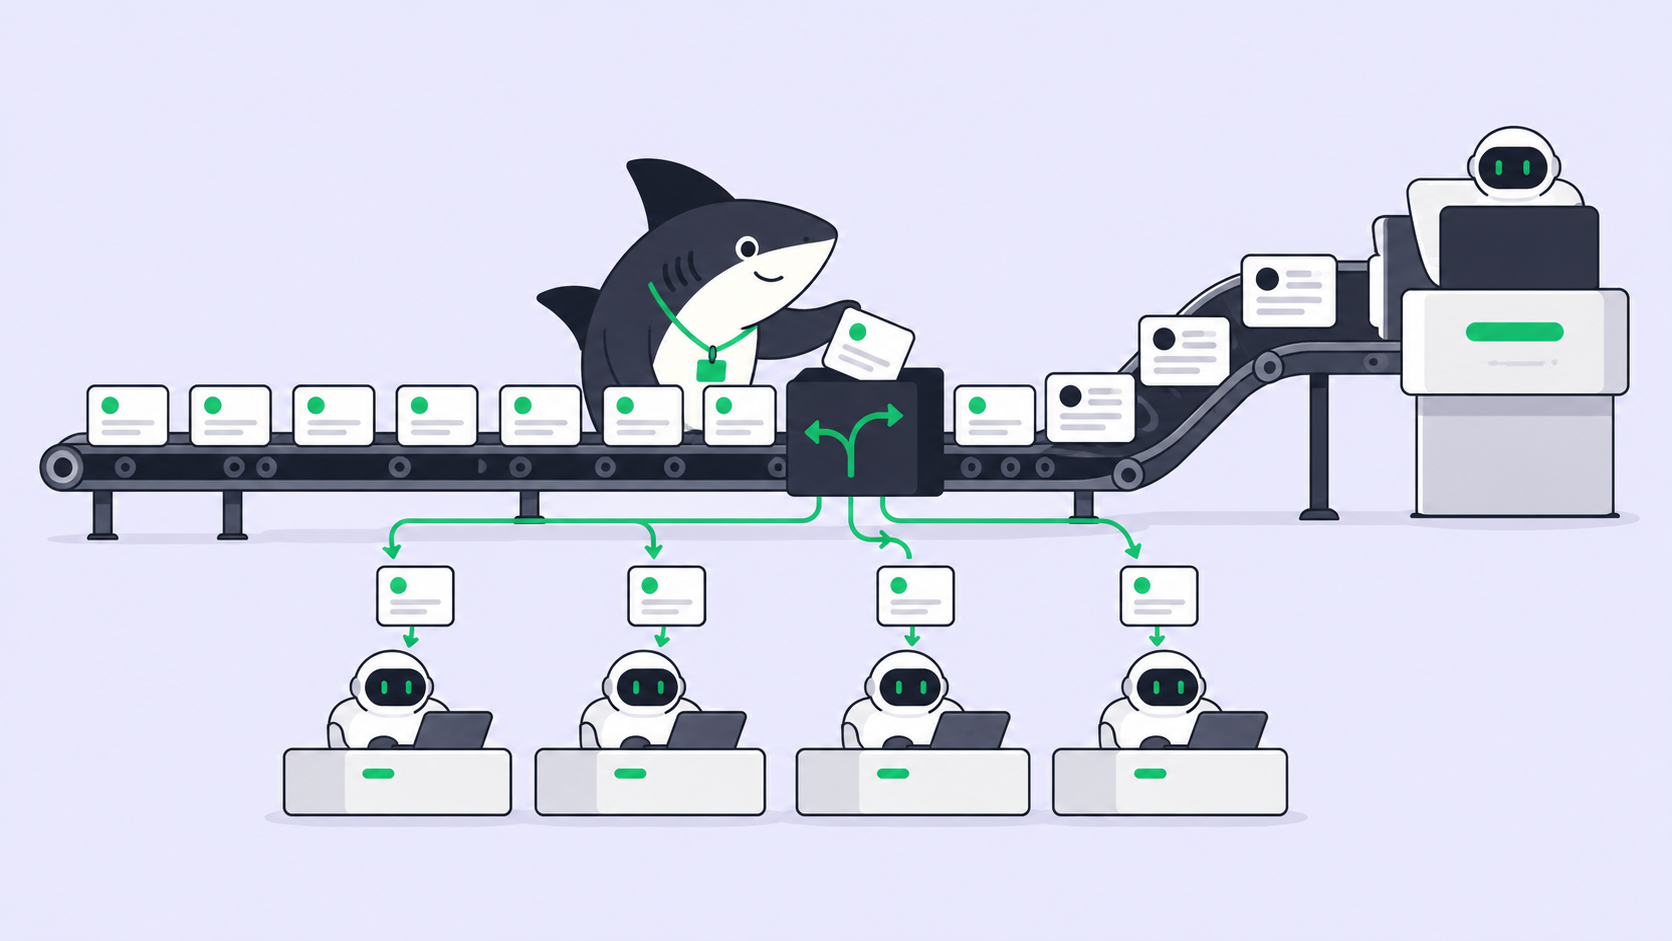
SharklyにおけるCrewとは、1つのリーダーAgentによって統括される、人間とAgentの再利用可能なグループです。実行はリーダー主導(リーダーファースト)で行われます。リーダーがTaskとCrewの指示を読み取り、自ら作業を処理するか、特定の部分についてAgentメンバーを指名(メンション)して割り当てます。この構造は、2つのランタイムの使い分けと非常に相性が良い設計です。
- リーダーにはGPT-6.1 Solを割り当てる:リーダーは曖昧なゴールを解釈し、次に誰が動くべきかを判断します。計画を誤るとメンバー全員があやまった方向に進んでしまうため、この役割にはより高性能なモデルを割り当てます。リーダー枠のアップグレードが低コストで済む理由については、こちらのCrewリーダー向けガイドをご覧ください。
- メンバーにはGPT-6.1 Terra(effortは
medium)を割り当てる:日常的なコーディング、リファクタリング、テスト作成、ドキュメント更新、PRの説明文作成、コンピューター操作などのタスクは、まずここから開始します。 - 2回失敗したらエスカレーションする:Terraのメンバーがタスクに2回失敗した場合、人間がSolバージョンのAgentへ再割り当てを行います。Agent自身の判断や直感で勝手にエスカレーションさせないでください。エスカレーションの決定はTask上で追跡可能にしておく必要があります。
- タスクのタイプごとにエスカレーションを追跡する:サービス間マイグレーションのように、特定のカテゴリのタスクで毎回エスカレーションが発生する場合は、最初からそのカテゴリをSolにルーティングします。
- トリアージはLunaに任せる:ラベリングや一次振り分けなどの作業は、さらに1段階下のモデルへ移行できます。この領域の詳細については、GPT-6 Lunaガイドをご覧ください。
これは運用開始のためのベースルールであり、固定されたベンチマーク結果ではありません。まずは1スプリント運用してみて、実際のエスカレーション率を参考にしながら境界線を調整してください。
「Terra優先」の費用対効果が崩れる分岐点
エスカレーションにはコストが伴います。Terraでの試行失敗は、Solによる実行が始まる前に追加コストとなって積み重なるためです。Terraの試行で、Solでの完全な1回分の実行と同じステップ数を消費してしまう最悪のケースを想定して計算してみましょう。Solの実行コストをSとすると、Terraでの試行コストは0.5Sとなります。タスクのうちエスカレーションする割合をfと置くと、タスク1件あたりの期待コストは「0.5S + f × S」です。
この値がすべてSolで実行した場合と等しくなるのは、fが0.5に達したときです。つまり、タスクの半分がエスカレーションするまでは、Terra優先のほうが安く済みます。同様の計算は実行ステップが長引くケースにも当てはまり、完了までにSolの2倍以上のステップ数を要するようにならない限り、タスク単位でTerraのほうが低コストを維持できます。
金銭面での損益分岐点はかなり先にあるため、実際のボトルネックとなるのは人間の時間です。試行が失敗するたびに、誰かが差分(diff)を確認し、ログを読み、再割り当てを行う手間が発生します。特定のタスクタイプにおいてエスカレーション率が20%を超えるようであれば、トークンの試算上はTerraが有利であっても、そのタスクタイプはSolへ移行すべきです。
また、処理速度も計算に影響します。3倍以上高速に完了するモデルを使えば、それだけ早くComputerが解放されるため、キューに入ったタスクの開始が早まり、タスクごとのタイムアウト内に完了できる実行数も増えます。
Sharklyでの設定手順
Sharkly自体がトークンを販売しているわけではありません。実行にかかる料金は、各Computer上のRuntimeに設定済みのCodexプランまたはAPIキーに対して課金されます。そのため、まずはその環境でTerraが動作することを確認してください(Codex CLI 0.159.0以降であることを確認したうえで、ターミナルでcodex -m gpt-6.1-terraを実行します)。
SharklyのAgentsドキュメントによると、Agentは「デフォルトでRuntimeのモデルに従う」とされており、Modelの行からRuntimeが提供するカタログ内の別のモデルを選択できます。また、AgentまたはRuntimeのCustom arguments(カスタム引数)でモデルを指定することも可能です。
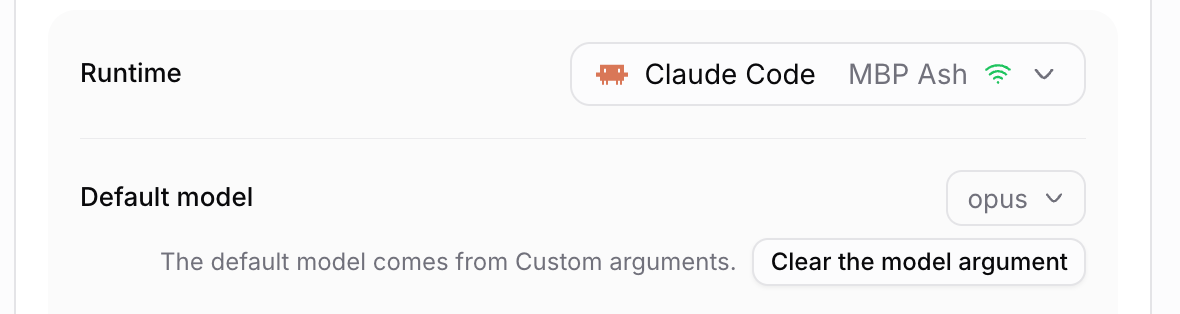
設定を直接編集するのではなく、バリアント(派生設定)を作成してルールを構築することをおすすめします。3つの設定例は以下のとおりです。
Agent "Codex, routine"   Custom arguments: --model gpt-6.1-terra   effort: medium
Agent "Codex, hard tail" Custom arguments: --model gpt-6.1-sol     effort: medium
Crew leader              Custom arguments: --model gpt-6.1-sol
ドキュメントでは、Agentのバリアントを作成する理由として「別のデフォルトモデルを使用するため」が挙げられています。バリアントを作成すると、元の指示(instruction)やリポジトリ設定を維持したまま、モデルのみを上書きできます。2つのバリアントを用意しておくことで、どのレーンで実行されたかが各Taskに明示され、ボードの可読性も保たれます。単発のテストであれば、Assigneeピッカーにある実行ごとのモデル選択機能を使えば、その実行に限りAgentのデフォルト設定を上書きできます。
Sharklyでは、どちらのモデルで実行されたかにかかわらず、コンテキスト、進捗状況、ブロッカー、結果、そして人間のレビュー内容がTask上に集約されます。これによって、エスカレーション率を正確に計測できるようになります。
デフォルトを低コスト化しても変わらない課題
Terraはコード変更を生成するコストを下げてくれますが、それを受け入れる(レビュー・マージする)コストまでは下げてくれません。半額で3倍の速度で処理が進むということは、金曜日の時点で人間のレビュー待ちとなる差分がそれだけ増える可能性があることを意味します。メンバーを追加する前にレビュー待ちキューの状況を確認してください。この問題については、「人間のレビューこそがボトルネック」に関する記事で詳しく解説しています。
また、最も難易度の高いタスクが自動的に解決されるわけでもありません。OpenAI自身も、極めて複雑なコーディングにはSolまたはGPT-6 Astraを推奨しており、Coding Agent Indexでの6ポイントの差もそれを裏付けています。前述のルーティングルールは、そうしたタスクを設計段階からSolで処理するようにしています。
まとめ
Terraをデフォルトとし、Solを例外とする運用を基本にしましょう。今回のステップ試算では、リーダーや難度の高いタスク(ハードテール)に高性能モデルを残したままでも、すべてSolで運用する場合と比べて請求額をほぼ半減できます。タスクタイプを移行すべきかどうかの判断は、トークンの価格ではなく、実際のエスカレーション率を指標にしてください。
次のステップとして、まずはCodex AgentのTerraバリアントを1つ作成し、SolリーダーのCrewに組み込んで1スプリント運用してみてください。料金ページにあるとおり、Sharklyは現在、最大5人の組織まで無料で利用できます。
よくある質問(FAQ)
コーディングにおいてGPT-6.1 TerraはGPT-6.1 Solより優れていますか?
いいえ、そうではありません。Artificial AnalysisのCoding Agent IndexではSolが54、Terraが48となっています。Terraの強みは価格と処理速度にあるため、最も難易度の高いタスクよりも、日常的なコーディング業務に適しています。
GPT-6.1 TerraはGPT-6.1 Solと比べてどのくらい安いですか?
すべての項目でちょうど半額です。100万トークンあたり、入力は2ドルに対し1ドル、キャッシュは0.10ドルに対し0.05ドル、出力は10ドルに対し5ドルとなっています。
CrewリーダーもTerraで実行すべきですか?
まずはSolで開始することをおすすめします。リーダーが消費するステップ数は全体のわずかであるため、アップグレードに伴う追加コストは少なくて済みます。また、リーダーが計画を誤るとメンバー全員の作業が狂ってしまうためです。
Solでeffort設定にnoneを使用できますか?
いいえ、使用できません。GPT-6.1 Solではnoneが廃止され、最小レベルはlowとなっています。Terraでは再びnoneが利用可能になりました。
GPT-6.1 Terraは無料で使えますか?
いいえ、無料ではありません。APIの無料枠はなく、ChatGPTのFreeプランおよびGoプランにも含まれていません。プラン利用とトークン従量課金の違いについては、APIキーなしでGPT-6.1 Solを実行する方法に関する記事で解説しています。
Agentの設定を変更せずに、特定のTaskだけSolに切り替えるにはどうすればよいですか?
Assigneeピッカーにある実行ごとのモデル選択機能を使用してください。その実行に限り、Agentのデフォルト設定が上書きされます。


